Google BigQuery vs Amazon Redshift 2026: เปรียบเทียบ Data Warehouse และคำถามสัมภาษณ์ Data Analyst
การเปรียบเทียบอย่างครอบคลุมระหว่าง Google BigQuery และ Amazon Redshift ครอบคลุมสถาปัตยกรรม ราคา ประสิทธิภาพ และคำถามสัมภาษณ์ที่พบบ่อยสำหรับตำแหน่ง Data Analyst ปี 2026
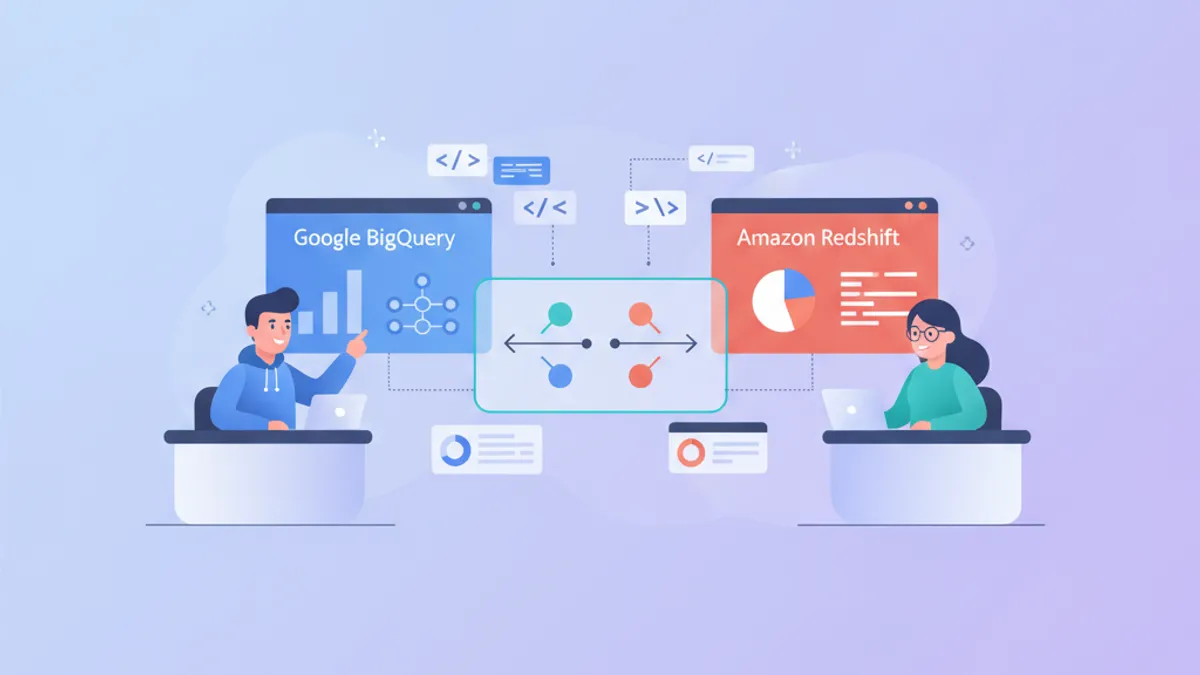
Google BigQuery และ Amazon Redshift ครองตลาด cloud data warehouse ในปี 2026 โดยแต่ละแพลตฟอร์มมีข้อได้เปรียบที่แตกต่างกันสำหรับ workload data analytics การเปรียบเทียบนี้ครอบคลุมความแตกต่างด้านสถาปัตยกรรม โมเดลราคา ลักษณะประสิทธิภาพ และคำถามสัมภาษณ์ที่ผู้สมัคร data analyst มักพบ
เลือก BigQuery สำหรับความเรียบง่ายแบบ serverless ราคา pay-per-query และการรวมกับ GCP อย่างแน่นหนา เลือก Redshift สำหรับต้นทุนที่คาดการณ์ได้ในระดับใหญ่ pipeline ETL ที่ซับซ้อน และการรวมกับระบบนิเวศ AWS อย่างลึกซึ้ง
ความแตกต่างด้านสถาปัตยกรรมระหว่าง BigQuery และ Redshift
BigQuery ใช้สถาปัตยกรรม serverless แบบ multi-tenant ที่ storage และ compute แยกออกจากกันอย่างสมบูรณ์ Query ทำงานบน resource ที่จัดสรรแบบไดนามิกโดยไม่ต้องจัดการ cluster เลย Google จัดการการ scaling infrastructure, patching และ optimization ทั้งหมดโดยอัตโนมัติ
Redshift ทำงานบนโมเดล provisioned cluster ด้วย node เฉพาะ Storage และ compute เชื่อมต่อกันอย่างแน่นหนาภายใน node แม้ว่า Redshift Serverless จะเสนอทางเลือกแบบ consumption-based ในปัจจุบัน Node type RA3 ได้แนะนำการแยก managed storage ทำให้สามารถ scaling compute และ storage ได้อย่างอิสระ
| ด้าน | BigQuery | Redshift |
|---|---|---|
| Deployment | Serverless เต็มรูปแบบ | Provisioned clusters หรือ Serverless |
| Storage-Compute | แยกออกจากกันอย่างสมบูรณ์ | Coupled (RA3 แยก managed storage) |
| Scaling | อัตโนมัติ | Manual resize หรือ Concurrency Scaling |
| Maintenance | ไม่ต้องการ | ต้องการ maintenance windows |
| Cold Start | ไม่มี | เวลา resume cluster หากถูก pause |
ความแตกต่างด้านสถาปัตยกรรมนี้ส่งผลกระทบอย่างมากต่อ overhead ในการดำเนินงาน BigQuery ไม่ต้องการ capacity planning ในขณะที่ Redshift ต้องการการตัดสินใจเกี่ยวกับ cluster sizing และการจัดตาราง maintenance อย่างต่อเนื่อง
โมเดลราคา: Pay-per-Query vs Provisioned Capacity
BigQuery คิดค่าบริการ $6.25 ต่อ TB ที่ถูก scan ในโหมด on-demand ณ ปี 2026 ราคา reserved capacity (flat-rate) เสนอต้นทุนรายเดือนที่คาดการณ์ได้สำหรับ workload ที่สม่ำเสมอ ค่า storage คือ $0.02/GB/เดือน สำหรับข้อมูล active และ $0.01/GB/เดือน สำหรับ long-term storage หลังจาก 90 วัน
-- BigQuery: ตรวจสอบค่าใช้จ่าย query ก่อนการ execute
SELECT
  total_bytes_billed / POW(10, 12) AS tb_billed,
  (total_bytes_billed / POW(10, 12)) * 6.25 AS estimated_cost_usd
FROM `region-us`.INFORMATION_SCHEMA.JOBS_BY_PROJECT
WHERE job_id = 'your-job-id';
ราคา Redshift ขึ้นอยู่กับประเภทและจำนวน node Node DC2 (dense compute) เริ่มต้นที่ $0.25/ชั่วโมง ในขณะที่ node RA3 พร้อม managed storage เริ่มต้นที่ $1.086/ชั่วโมง Redshift Serverless คิดค่าบริการตาม Redshift Processing Units (RPU) ที่ใช้
กลยุทธ์การเพิ่มประสิทธิภาพต้นทุนแตกต่างกันอย่างมาก BigQuery ให้รางวัลการเพิ่มประสิทธิภาพ query ผ่าน partitioning และ clustering เนื่องจากการ scan ข้อมูลน้อยลงจะลดต้นทุนโดยตรง การเพิ่มประสิทธิภาพ Redshift มุ่งเน้นที่ right-sizing cluster และใช้ประโยชน์จาก reserved instances สำหรับ workload ที่คาดการณ์ได้
ความแตกต่างของ SQL Syntax และ Function
ทั้งสองแพลตฟอร์มรองรับ ANSI SQL แต่มีความแตกต่างของ syntax สำหรับฟีเจอร์ขั้นสูง การทำความเข้าใจความแตกต่างเหล่านี้สำคัญสำหรับคำถามสัมภาษณ์ SQL และโปรเจกต์ migration
-- BigQuery: Date functions ใช้ EXTRACT และ DATE_TRUNC
SELECT
  DATE_TRUNC(order_date, MONTH) AS order_month,
  EXTRACT(DAYOFWEEK FROM order_date) AS day_of_week,
  COUNT(*) AS order_count
FROM `project.dataset.orders`
WHERE order_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 1 YEAR)
GROUP BY 1, 2;

-- Redshift: คล้ายกันแต่ใช้ DATE_TRUNC กับ string argument
SELECT
  DATE_TRUNC('month', order_date) AS order_month,
  EXTRACT(DOW FROM order_date) AS day_of_week,
  COUNT(*) AS order_count
FROM orders
WHERE order_date >= DATEADD(year, -1, CURRENT_DATE)
GROUP BY 1, 2;
การจัดการ array และ struct แสดงความแตกต่างที่สำคัญ BigQuery รองรับ nested และ repeated fields แบบ native ด้วย operation UNNEST Redshift จัดการ semi-structured data ผ่าน SUPER type และ PartiQL syntax ที่เปิดตัวในเวอร์ชันล่าสุด
-- BigQuery: ทำงานกับ nested arrays
SELECT
  user_id,
  event.name AS event_name,
  event.timestamp AS event_time
FROM `analytics.events`,
UNNEST(events) AS event
WHERE DATE(event.timestamp) = CURRENT_DATE();

-- Redshift: SUPER type กับ PartiQL
SELECT
  user_id,
  e.name AS event_name,
  e.timestamp AS event_time
FROM events_table AS t, t.events AS e
WHERE DATE(e.timestamp) = CURRENT_DATE;
ลักษณะประสิทธิภาพและการเพิ่มประสิทธิภาพ Query
BigQuery โดดเด่นใน analytical query แบบ ad-hoc บน dataset ขนาดใหญ่โดยไม่ต้อง tuning โมเดลการทำงานแบบ slot-based กระจายงานโดยอัตโนมัติ ประสิทธิภาพยังคงสม่ำเสมอโดยไม่คำนึงถึงจำนวน concurrent users เนื่องจากแต่ละ query ได้รับ resource เฉพาะจาก slot pool
Redshift ให้ประสิทธิภาพที่เหนือกว่าสำหรับ query ที่คาดการณ์ได้และทำซ้ำเมื่อได้รับการ tune อย่างถูกต้อง Distribution keys, sort keys และ materialized views ส่งผลกระทบอย่างมากต่อความเร็ว query Query planner สร้าง execution plan ที่ optimize แล้วตาม table statistics
-- Redshift: กำหนด distribution และ sort keys
CREATE TABLE sales_fact (
  sale_id BIGINT,
  customer_id BIGINT,
  product_id BIGINT,
  sale_date DATE,
  amount DECIMAL(10, 2)
)
DISTKEY(customer_id)
SORTKEY(sale_date);

-- Redshift: Materialized view สำหรับ dashboard query
CREATE MATERIALIZED VIEW daily_sales_summary AS
SELECT
  sale_date,
  COUNT(*) AS transaction_count,
  SUM(amount) AS total_revenue
FROM sales_fact
GROUP BY sale_date;
การเพิ่มประสิทธิภาพ BigQuery อาศัย partitioning และ clustering Partitioning ลดข้อมูลที่ถูก scan ตามช่วงวันที่หรือ integer Clustering จัดเรียงข้อมูลภายใน partition เพื่อ filter query ที่เร็วขึ้น
-- BigQuery: ตาราง partitioned และ clustered
CREATE TABLE `project.dataset.sales_fact`
PARTITION BY DATE(sale_date)
CLUSTER BY customer_id, product_id
AS SELECT * FROM `project.dataset.raw_sales`;
สำหรับกลยุทธ์ performance tuning ในหัวข้อที่เกี่ยวข้อง คู่มือ window functions และ CTE ครอบคลุมเทคนิคการเพิ่มประสิทธิภาพ query ขั้นสูง
พร้อมที่จะพิชิตการสัมภาษณ์ Data Analytics แล้วหรือยังครับ?
ฝึกฝนด้วยตัวจำลองแบบโต้ตอบ, flashcards และแบบทดสอบเทคนิคครับ
Data Loading และการรวม ETL
BigQuery รองรับ streaming inserts สำหรับข้อมูล real-time ด้วยค่าใช้จ่าย $0.05 ต่อ GB, batch loading จาก Cloud Storage ฟรี และ native connectors สำหรับ Dataflow และ Pub/Sub BigQuery Data Transfer Service ทำการ import ตามกำหนดเวลาจากแอปพลิเคชัน SaaS โดยอัตโนมัติ
-- BigQuery: Loading data จาก Cloud Storage
LOAD DATA INTO `project.dataset.events`
FROM FILES (
  format = 'PARQUET',
  uris = ['gs://bucket/events/*.parquet']
);
Redshift รวมกับ S3 อย่างแน่นหนาผ่านคำสั่ง COPY ซึ่งทำการ parallelize data loading ข้าม cluster nodes AWS Glue ให้ managed ETL ในขณะที่ Redshift Spectrum query ข้อมูล S3 โดยตรงโดยไม่ต้อง loading
-- Redshift: คำสั่ง COPY พร้อมการตั้งค่าที่เหมาะสม
COPY events
FROM 's3://bucket/events/'
IAM_ROLE 'arn:aws:iam::123456789:role/RedshiftS3Access'
FORMAT AS PARQUET
COMPUPDATE ON
STATUPDATE ON;
ทั้งสองแพลตฟอร์มรองรับรูปแบบตาราง Apache Iceberg สำหรับ data lake ภายนอกแล้ว BigQuery BigLake และ Redshift Spectrum ช่วยให้ analytics รวมข้าม data warehouse และ data lake storage
คำถามสัมภาษณ์: เปรียบเทียบ BigQuery vs Redshift
การสัมภาษณ์ data analyst มักทดสอบความเข้าใจเกี่ยวกับ tradeoff ของ cloud data warehouse คำถามเหล่านี้ปรากฏในบทบาทที่ต้องการความเชี่ยวชาญ cloud platform
คำถาม 1: เมื่อใดควรแนะนำ BigQuery แทน Redshift?
แนะนำ BigQuery เมื่อองค์กรต้องการการทำงานแบบ serverless โดยไม่ต้องจัดการ infrastructure, ราคา pay-per-query เหมาะกับ workload ที่คาดการณ์ไม่ได้หรือมีลักษณะ spiky, data platform ทำงานบน GCP อยู่แล้ว หรือทีมต้องการผลลัพธ์ query ทันทีบนข้อมูลระดับ petabyte โดยไม่มี delay จากการ provisioning cluster
คำถาม 2: การจัดสรร slot ทำงานอย่างไรใน BigQuery?
BigQuery จัดสรร slot (หน่วยความจุการประมวลผล) ให้กับ query แบบไดนามิก Query แบบ on-demand แชร์ pool 2,000 slot ต่อโปรเจกต์ แต่ละ slot แทน virtual CPU ประมาณหนึ่งตัวพร้อม streaming access ไปยัง Colossus (distributed storage) Query ที่ซับซ้อนที่ต้องการ parallelism มากขึ้นจะได้รับ slot มากขึ้นตามสัดส่วนจนกว่าจะหมดความจุที่มี
คำถาม 3: อธิบาย distribution styles ของ Redshift และเมื่อใดควรใช้แต่ละแบบ
Redshift เสนอ distribution styles สี่แบบ:
- KEY: กระจายแถวตาม hash ของคอลัมน์ที่ระบุ ใช้สำหรับตาราง fact ขนาดใหญ่ที่ถูก join บ่อยบนคอลัมน์นั้น
- EVEN: กระจายแถวแบบ round-robin ข้าม node ใช้สำหรับตารางที่ไม่มี pattern การ join ที่ชัดเจน
- ALL: คัดลอกทั้งตารางไปยังทุก node ใช้สำหรับตาราง dimension ขนาดเล็กที่ถูก join กับ fact ขนาดใหญ่
- AUTO: ให้ Redshift เลือกตามขนาดตารางและ query patterns
คำถาม 4: จะเพิ่มประสิทธิภาพต้นทุน query ใน BigQuery ได้อย่างไร?
เพิ่มประสิทธิภาพต้นทุน BigQuery โดยการ partition ตารางบนคอลัมน์วันที่ที่ถูก filter บ่อย, clustering บนคอลัมน์ filter ที่มี high-cardinality, หลีกเลี่ยง query SELECT *, ใช้ฟังก์ชัน approximate aggregation (APPROX_COUNT_DISTINCT) สำหรับการวิเคราะห์เชิงสำรวจ, materialize ผลลัพธ์ intermediate สำหรับการคำนวณที่ทำซ้ำ และตั้ง cost controls ด้วย custom quotas
คำถาม 5: มีเครื่องมือ monitoring อะไรบ้างสำหรับประสิทธิภาพ Redshift?
Redshift มี system tables และ views สำหรับ performance monitoring: STL_QUERY บันทึกรายละเอียดการทำงานของ query, STL_WLM_QUERY แสดงสถิติ workload management, SVL_QUERY_REPORT แสดง metrics ระดับ step และ CloudWatch metrics ติดตาม health ระดับ cluster ประสิทธิภาพ query อาจลดลงเมื่อ vacuum operations ค้างอยู่หรือเมื่อ table statistics ล้าสมัย
ความสามารถด้านความปลอดภัยและ Compliance
ทั้งสองแพลตฟอร์มรองรับ column-level encryption, VPC isolation และ audit logging BigQuery บังคับใช้ fine-grained access ผ่าน IAM และ column-level security policies Data masking และ row-level security ช่วยให้สถาปัตยกรรม multi-tenant เป็นไปได้
Redshift เสนอ control ที่คล้ายกันผ่านการรวม IAM, column-level access control และ dynamic data masking Cross-region snapshot replication รองรับข้อกำหนด disaster recovery
ทั้งสองแพลตฟอร์มรักษา certification compliance SOC 1/2/3, ISO 27001, HIPAA และ PCI DSS Feature parity มีอยู่สำหรับข้อกำหนดความปลอดภัยระดับ enterprise ส่วนใหญ่ ทำให้การเลือกขึ้นอยู่กับความสัมพันธ์กับ cloud provider ที่มีอยู่มากกว่าความสามารถด้านความปลอดภัย
ข้อพิจารณาการ Migration และแนวทาง Hybrid
การ migration ระหว่างแพลตฟอร์มต้องจัดการความแตกต่างของ SQL dialect, การ mapping data type และการเขียน ETL workflow ใหม่ BigQuery Migration Service ประเมิน Redshift workloads และทำ SQL translation โดยอัตโนมัติ AWS Database Migration Service จัดการทิศทางตรงกันข้าม
หลายองค์กรใช้กลยุทธ์ hybrid โดย query ข้ามทั้งสองแพลตฟอร์มผ่านความสามารถ federated query BigQuery Omni ทำงานบน infrastructure AWS ทำให้สามารถใช้ BigQuery SQL กับข้อมูล S3 ได้ Data sharing ของ Redshift รองรับ cross-account query federation ภายใน AWS
ทีม data analytics เลือกมากขึ้นตามการลงทุน cloud ที่มีอยู่มากกว่าความเหนือกว่าทางเทคนิค ทั้งสองแพลตฟอร์มยังคงเพิ่มฟีเจอร์ที่แก้ไขข้อจำกัดในอดีต ทำให้ช่องว่างด้านฟังก์ชันแคบลง
สรุป
- BigQuery เหมาะกับทีมที่ให้ความสำคัญกับความเรียบง่ายแบบ serverless และ workload ที่แปรผันด้วย billing pay-per-query
- Redshift เหมาะกับองค์กรที่มี query volume สูงที่คาดการณ์ได้ ซึ่ง provisioned capacity ให้ข้อได้เปรียบด้านต้นทุน
- ความแตกต่างของ SQL syntax ต้องให้ความสนใจระหว่างการวางแผน migration และการฝึกอบรมทีม
- แนวทางการเพิ่มประสิทธิภาพแตกต่างกันโดยพื้นฐาน: BigQuery เน้น partitioning และ clustering, Redshift ต้องการ distribution keys และ sort keys
- คำถามสัมภาษณ์มุ่งเน้นที่ tradeoff ด้านสถาปัตยกรรม กลยุทธ์การเพิ่มประสิทธิภาพต้นทุน และเทคนิค tuning เฉพาะแพลตฟอร์ม
- ความสามารถด้านความปลอดภัยและ compliance เทียบเท่ากัน; การรวมกับระบบนิเวศ cloud มักเป็นตัวขับเคลื่อนการเลือกแพลตฟอร์ม
เริ่มฝึกซ้อมเลย!
ทดสอบความรู้ของคุณด้วยตัวจำลองสัมภาษณ์และแบบทดสอบเทคนิคครับ
คุณหาบั๊กใน Data Analytics เจอไหม
โค้ดจริงหนึ่งชิ้น บั๊กที่ซ่อนอยู่หนึ่งจุด วันละหนึ่งครั้ง ลองได้โดยไม่ต้องมีบัญชี
เขียนโดย
Anthony Fillion-Mailletผู้ก่อตั้ง SharpSkill
เป็นนักพัฒนาฟูลสแตกมากว่า 10 ปี ดูแล SharpSkill และรับผิดชอบทุกสิ่งที่เผยแพร่ที่นี่
อัปเดตเมื่อ 31 กรกฎาคม 2569
แชร์
บทความที่เกี่ยวข้อง
งาน Data Analyst ปี 2026: แหล่งหางาน ช่วงเงินเดือน และการเตรียมตัวสัมภาษณ์
คู่มือฉบับสมบูรณ์สำหรับงาน data analyst ปี 2026: แพลตฟอร์มหางานที่ดีที่สุด ช่วงเงินเดือนตามระดับประสบการณ์ และเคล็ดลับการเตรียมตัวสัมภาษณ์เชิงเทคนิคเพื่อความสำเร็จในอาชีพ
Excel Power Query 2026: ETL สำหรับ Data Analyst และคำถามสัมภาษณ์
คู่มือฉบับสมบูรณ์ Power Query ใน Excel สำหรับ data analyst เรียนรู้การแปลงข้อมูล ETL, ภาษา M, query folding และการเตรียมตัวสัมภาษณ์ทางเทคนิค
คำถามสัมภาษณ์ Data Analyst 2026: คู่มือครบถ้วน SQL, Python และ Analytics
คู่มือครบถ้วนสำหรับคำถามสัมภาษณ์ data analyst 2026 ครอบคลุม SQL window functions, Python pandas, แนวคิดสถิติ และ business case study พร้อมตัวอย่างโค้ดจริง