Apache Flink 2026: การประมวลผล Stream, Event Time และคำถามสัมภาษณ์
คู่มือ Apache Flink 2.3 สำหรับการประมวลผล stream ด้วย event time semantics, watermark และ windowing พร้อมคำถามสัมภาษณ์และตัวอย่างโค้ด production
หลักสูตร Data Engineering ที่ครอบคลุมห่วงโซ่การผลิตข้อมูลทั้งหมด ตั้งแต่การตั้งค่าสภาพแวดล้อมด้วย Docker และ GCP ไปจนถึงการจัดการ pipeline ด้วย Airflow และ dbt ผ่านการสร้าง Data Warehouse ด้วย BigQuery และ PostgreSQL เรียนรู้การจัดการ data streaming ด้วย PySpark, Pub/Sub และ Apache Beam และการ deploy ไปยัง production ด้วย Kubernetes และ Terraform เชี่ยวชาญ CI/CD, การติดตาม และสถาปัตยกรรมข้อมูลสมัยใหม่
สภาพแวดล้อมการพัฒนา: Linux, Git, GitHub, VS Code, Python ขั้นสูง
CI/CD และคุณภาพโค้ด: Ruff, Pylint, Poetry, GitHub Actions
การทำ container ด้วย Docker และ Docker Compose
API ด้วย FastAPI: การออกแบบ, การ deploy, เอกสาร
Data Lake: การนำเข้า, การจัดเก็บ, การจัดระเบียบข้อมูลดิบ
Data Warehouse ด้วย BigQuery: schema, การแบ่งพาร์ทิชัน, การเพิ่มประสิทธิภาพ
PostgreSQL: การติดตั้ง, การจัดการ, การเปรียบเทียบกับโซลูชัน managed
การนำเข้าข้อมูลด้วย Fivetran และ Airbyte
การแปลงด้วย dbt: model, test, เอกสาร, ความเป็นโมดูล
การจัดการด้วย Apache Airflow: DAG, การตั้งเวลา, การติดตาม
Big Data ด้วย PySpark: การแปลงขนาดใหญ่
Data streaming: Google Pub/Sub, Apache Beam, Dataflow
Kubernetes: การ deploy container, การปรับขนาด, คลัสเตอร์ production
Infrastructure as Code ด้วย Terraform
ฐานข้อมูลขั้นสูง: GraphDB, Document DB, Wide Column DB
การบันทึก log, การติดตาม และความสามารถในการสังเกต pipeline
แนวคิดที่สำคัญที่สุดเพื่อเข้าใจเทคโนโลยีนี้และประสบความสำเร็จในการสัมภาษณ์
Linux และ Shell: คำสั่งพื้นฐาน, bash scripting, สิทธิ์, cron job
Git และ GitHub: การแตกสาขา, merge, rebase, pull request, workflow CI/CD
Python ขั้นสูง: OOP, decorator, generator, context manager, typing, async/await
CI/CD: linting (Ruff, Pylint), การจัดแพ็กเกจ (Poetry), test, GitHub Actions, pipeline
Docker: Dockerfile, image, container, volume, network, multi-stage build
Docker Compose: บริการหลาย container, การพึ่งพา, healthcheck, การจัดการในเครื่อง
FastAPI: route, โมเดล Pydantic, dependency, middleware, การ deploy
SQL ขั้นสูง: window function, CTE, คิวรีวิเคราะห์, การเพิ่มประสิทธิภาพ, index
BigQuery: สถาปัตยกรรม serverless, การแบ่งพาร์ทิชัน, คลัสเตอร์, ต้นทุน, UDF, คิวรีแบบ federated
PostgreSQL: การตั้งค่า, การจำลอง, index (B-tree, GIN, GiST), VACUUM, EXPLAIN ANALYZE
การสร้างโมเดลข้อมูล: star schema, ตาราง fact/dimension, normalization, SCD, data vault
ELT vs ETL vs ETLT: รูปแบบ, การแลกเปลี่ยน, ทางเลือกสถาปัตยกรรม
Fivetran และ Airbyte: connector, โหมดการซิงค์, CDC, การพัฒนา schema
dbt: model, source, ref, test, snapshot, model เพิ่มทีละส่วน, Jinja macro
Apache Airflow: DAG, operator, sensor, XCom, connection, pool, การพึ่งพางาน
PySpark: RDD vs DataFrame, การแปลง, action, การแบ่งพาร์ทิชัน, ตัวแปร broadcast
Streaming: Pub/Sub (topic, subscription), Apache Beam (PCollection, transform, windowing), Dataflow
Kubernetes: pod, deployment, service, ingress, ConfigMap, Secret, Helm, การปรับขนาด
Terraform: provider, resource, state, module, plan/apply, infrastructure as code
IAM และความปลอดภัย: หลักสิทธิ์น้อยที่สุด, service account, บทบาท GCP
ฐานข้อมูล NoSQL: GraphDB (Neo4j), Document DB (MongoDB, Firestore), Wide Column (Cassandra, Bigtable)
สถาปัตยกรรมข้อมูล: Data Lake vs Data Warehouse vs Data Lakehouse, Data Mesh, Data Contract
การติดตามและความสามารถในการสังเกต: logging, เมตริก, การแจ้งเตือน, SLA/SLO/SLI, การตรวจสอบคุณภาพข้อมูล
วันละหนึ่งโค้ด หาบั๊กให้เจอ หรือพิสูจน์ว่าไม่มีบั๊ก
ค้นพบบทความและคู่มือล่าสุดเกี่ยวกับ Data Engineering
คู่มือ Apache Flink 2.3 สำหรับการประมวลผล stream ด้วย event time semantics, watermark และ windowing พร้อมคำถามสัมภาษณ์และตัวอย่างโค้ด production
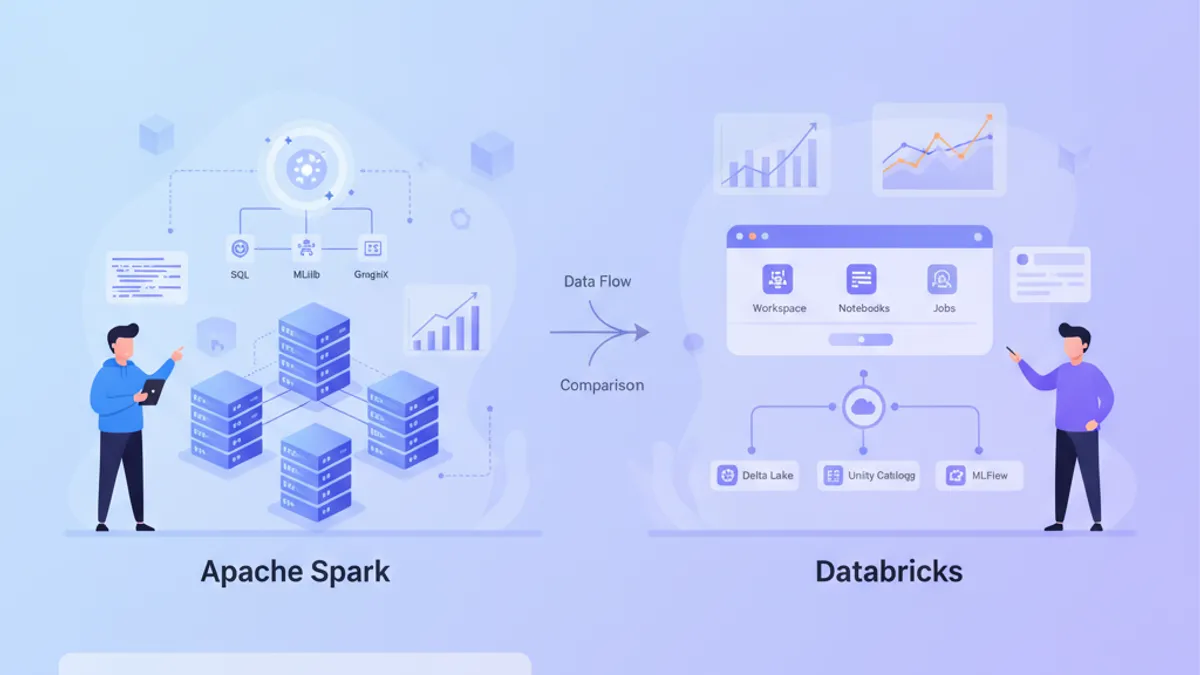
เปรียบเทียบเชิงลึก Apache Spark 4.2 vs Databricks สำหรับปี 2026 เรียนรู้ความแตกต่างด้านสถาปัตยกรรม การแลกเปลี่ยนด้านประสิทธิภาพ ฟีเจอร์ล่าสุด และเตรียมคำถามสัมภาษณ์ data engineering
คู่มือฉบับสมบูรณ์เปรียบเทียบ Delta Lake และ Apache Iceberg สำหรับสถาปัตยกรรม lakehouse รวมถึงตัวอย่างโค้ด แนวปฏิบัติที่ดี และคำถามสัมภาษณ์ data engineering 2026