งาน Freelance Data Scientist ปี 2026: แหล่งหาสัญญาจ้าง อัตราค่าจ้างรายวัน และการเตรียมตัว
คู่มือฉบับสมบูรณ์สำหรับ data scientist ที่ต้องการทำงานฟรีแลนซ์ในปี 2026: แพลตฟอร์มหาสัญญาจ้าง อัตราค่าจ้างรายวันเฉลี่ย และกลยุทธ์การเตรียมตัวสัมภาษณ์เทคนิค
หลักสูตร Data Science และ Machine Learning ที่ครอบคลุมด้วย Python เป็นภาษาหลัก ตั้งแต่การจัดการข้อมูลด้วย Pandas และ NumPy ไปจนถึงการสร้างโมเดล Deep Learning ด้วย TensorFlow/Keras ผ่าน ML คลาสสิกด้วย Scikit-Learn รวมถึงทักษะ MLOps เพื่อ deploy และดูแลรักษาโมเดลใน production ด้วย Docker, FastAPI และแพลตฟอร์ม cloud
Python สมัยใหม่ พร้อมการเขียนโปรแกรมเชิงวัตถุและแนวปฏิบัติที่ดี
การจัดการข้อมูลด้วย Pandas, NumPy และ SQL (BigQuery)
การแสดงผลด้วย Matplotlib, Seaborn และ Plotly
สถิติเชิงพรรณนาและเชิงอนุมานด้วย Statsmodel
Machine Learning ด้วย Scikit-Learn และ XGBoost (การถดถอย, การจำแนก, การจัดกลุ่ม)
Deep Learning ด้วย TensorFlow และ Keras (CNN, RNN, Transformer)
NLP และ GenAI ด้วย Hugging Face, LangChain และ LLM (GPT, Gemini)
MLOps ด้วย MLflow, Docker, FastAPI และ Streamlit
สภาพแวดล้อมการพัฒนา: Jupyter, Google Colab
การ deploy บน cloud ด้วย Google Compute, Cloud Storage และ GPU
แนวคิดที่สำคัญที่สุดเพื่อเข้าใจเทคโนโลยีนี้และประสบความสำเร็จในการสัมภาษณ์
Python: ประเภท, โครงสร้างข้อมูล, OOP, decorator, generator, context manager
NumPy: อาร์เรย์, broadcasting, indexing, การดำเนินการแบบ vector, พีชคณิตเชิงเส้น
Pandas: DataFrame, Series, indexing, groupby, merge, pivot, อนุกรมเวลา
SQL: SELECT, JOIN, GROUP BY, window function, CTE, การเพิ่มประสิทธิภาพคิวรี
การแสดงผล: Matplotlib (figure, axes, subplot), Seaborn (แผนภูมิสถิติ), Plotly (แบบโต้ตอบ)
สถิติ: การแจกแจง, การทดสอบสมมติฐาน, ช่วงความเชื่อมั่น, การถดถอย
Feature Engineering: การเข้ารหัส, การปรับสเกล, การเลือกฟีเจอร์, การสร้างฟีเจอร์
ML แบบมีผู้ดูแล: การถดถอยเชิงเส้น/โลจิสติก, ต้นไม้, Random Forest, XGBoost, เมตริก
ML แบบไม่มีผู้ดูแล: K-Means, การจัดกลุ่มแบบลำดับชั้น, PCA, t-SNE
ML Pipeline: การแบ่ง train/test, cross-validation, การปรับ hyperparameter, overfitting
Deep Learning: perceptron, backpropagation, ฟังก์ชันกระตุ้น, optimizer, ฟังก์ชันสูญเสีย
CNN: convolution, pooling, สถาปัตยกรรม (ResNet, VGG), transfer learning
RNN/LSTM: ลำดับ, vanishing gradient, กลไก attention, Transformer
NLP: tokenization, embedding, word2vec, BERT, การ fine-tune LLM
MLOps: การจัดการเวอร์ชัน (MLflow), การทำ container (Docker), API (FastAPI), การติดตาม
Cloud: Google Cloud (Compute, Storage, BigQuery), การเทรนด้วย GPU, Vertex AI
จริยธรรม AI: อคติ, ความสามารถในการอธิบาย (SHAP, LIME), ความเป็นธรรม, GDPR
วันละหนึ่งโค้ด หาบั๊กให้เจอ หรือพิสูจน์ว่าไม่มีบั๊ก
งานประจำและฟรีแลนซ์ พร้อมประเทศ remote และเงินเดือนเมื่อมีการเผยแพร่ อัปเดตทุกวัน สำหรับสมาชิกเท่านั้น
ค้นพบบทความและคู่มือล่าสุดเกี่ยวกับ Data Science & ML
คู่มือฉบับสมบูรณ์สำหรับ data scientist ที่ต้องการทำงานฟรีแลนซ์ในปี 2026: แพลตฟอร์มหาสัญญาจ้าง อัตราค่าจ้างรายวันเฉลี่ย และกลยุทธ์การเตรียมตัวสัมภาษณ์เทคนิค
งาน data scientist ยังคงเป็นตำแหน่งเทคนิคที่เป็นที่ต้องการมากที่สุดในปี 2026 บทความนี้แนะนำแหล่งหางาน ช่วงเงินเดือนปัจจุบัน และวิธีเตรียมตัวสัมภาษณ์อย่างมีประสิทธิภาพ
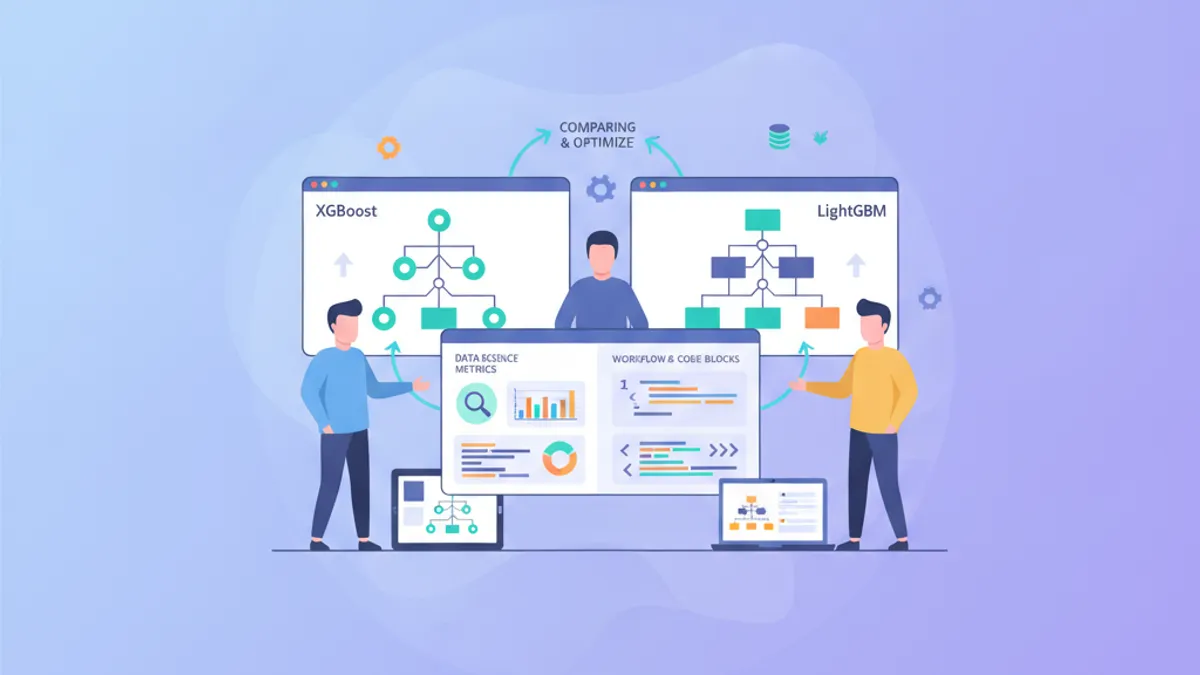
เชี่ยวชาญ XGBoost และ LightGBM สำหรับการสัมภาษณ์งาน data science เปรียบเทียบอัลกอริทึม gradient boosting เรียนรู้ hyperparameter tuning และฝึกคำถามสัมภาษณ์พร้อมตัวอย่างโค้ด