ETL vs ELT 2026: สถาปัตยกรรม Data Pipeline และคำถามสัมภาษณ์
เรียนรู้ความแตกต่างระหว่าง ETL กับ ELT สถาปัตยกรรม data pipeline สมัยใหม่ และคำถามสัมภาษณ์ data engineering ที่พบบ่อยในปี 2026
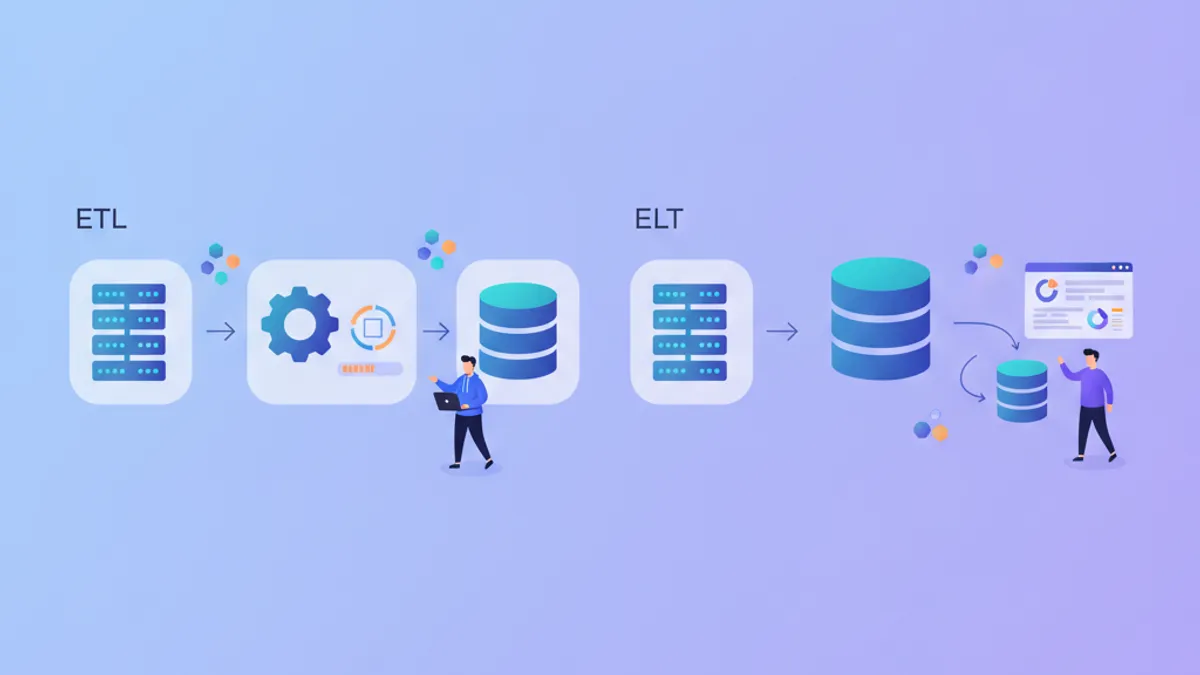
ETL และ ELT เป็นสองแนวทางพื้นฐานในการย้ายข้อมูลจากระบบต้นทางไปยังสภาพแวดล้อมการวิเคราะห์ การเลือกระหว่าง extract-transform-load (ETL) กับ extract-load-transform (ELT) ส่งผลต่อต้นทุนโครงสร้างพื้นฐาน ความสดใหม่ของข้อมูล และทักษะที่ต้องการจากทีมวิศวกร ความเข้าใจเชิงลึกในทั้งสองสถาปัตยกรรมมีความสำคัญสำหรับ data engineer ที่ทำงานกับ data pipeline สมัยใหม่
ETL แปลงข้อมูลก่อนโหลดเข้าระบบปลายทาง ต้องการทรัพยากรการประมวลผลแยกต่างหาก ELT โหลดข้อมูลดิบก่อน จากนั้นแปลงโดยใช้พลังการประมวลผลของ warehouse ปลายทาง data stack บน cloud ส่วนใหญ่ในปี 2026 เลือก ELT เพราะความสามารถในการประมวลผลสามารถปรับขนาดได้ตามความต้องการ
สถาปัตยกรรม ETL: แปลงก่อนโหลด
ETL เกิดขึ้นเมื่อ data warehouse มีความจุในการประมวลผลจำกัดและการจัดเก็บมีราคาแพง รูปแบบนี้สมเหตุสมผลในเวลานั้น: กรองและรวบรวมข้อมูลนอก warehouse โหลดเฉพาะสิ่งที่จำเป็นสำหรับการวิเคราะห์ Oracle Warehouse Builder, Informatica PowerCenter และ Talend สร้างเครื่องมือรอบโมเดลนี้
ขั้นตอนการแปลงใน ETL ทำงานบนเซิร์ฟเวอร์ตัวกลาง ข้อมูลย้ายจากแหล่งที่มาไปยังพื้นที่ staging ถูกทำความสะอาดและจัดรูปแบบใหม่ จากนั้นโหลดไปยังปลายทาง วิธีการนี้ลดภาระ warehouse แต่สร้างคอขวดที่ชั้นการแปลง
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL ทำงานได้ดีเมื่อตรรกะการแปลงมีเสถียรภาพและปริมาณข้อมูลคาดการณ์ได้ ข้อเสียปรากฏเมื่อความต้องการเปลี่ยนแปลง: การแก้ไขการแปลงหมายถึงการประมวลผลข้อมูลประวัติใหม่ตั้งแต่ต้น
สถาปัตยกรรม ELT: โหลดก่อน แปลงใน Warehouse
ELT ย้ายการแปลงไปใน data warehouse Snowflake, BigQuery, Databricks และ Redshift ให้การประมวลผลที่เกือบไม่จำกัดซึ่งปรับขนาดได้ตามความซับซ้อนของ query การโหลดข้อมูลดิบก่อนรักษาสถานะต้นทาง; การแปลงกลายเป็น model SQL ที่สามารถควบคุมเวอร์ชันและรันใหม่โดยไม่ต้องดึงข้อมูลใหม่
โปรเจกต์ dbt (data build tool) ทำให้ ELT เป็นที่นิยมโดยปฏิบัติต่อการแปลง SQL เป็นโค้ด แทนที่จะเป็นงาน ETL แบบ black-box การแปลงอยู่ใน version control เป็นคำสั่ง SELECT ที่อ้างอิงตารางดิบและสร้าง model ที่สืบทอด
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT รักษาข้อมูลดิบ ซึ่งช่วยให้ประมวลผลใหม่เมื่อตรรกะธุรกิจเปลี่ยนแปลง หากการคำนวณผิดเมื่อหกเดือนก่อน การแก้ไข model dbt และรัน full refresh จะแก้ไขข้อมูลประวัติ ด้วย ETL การแก้ไขเดียวกันต้องดึงข้อมูลใหม่จากแหล่งที่อาจไม่มีระเบียนเดิมอีกต่อไป
ตารางเปรียบเทียบ: การแลกเปลี่ยน ETL vs ELT
| ปัจจัย | ETL | ELT |
|---|---|---|
| ตำแหน่งการประมวลผล | เซิร์ฟเวอร์การแปลงแยกต่างหาก | Warehouse ปลายทาง |
| การเก็บข้อมูลดิบ | มักถูกทิ้งหลังการแปลง | รักษาไว้ใน landing zone |
| ต้นทุนการประมวลผลใหม่ | ดึงข้อมูลใหม่จากแหล่ง | รัน model SQL ใหม่ |
| ความยืดหยุ่นของ schema | คงที่ ณ เวลาแปลง | Schema-on-read เป็นไปได้ |
| ตัวอย่างเครื่องมือ | Informatica, Talent, SSIS | dbt, Dataform, SQLMesh |
| เหมาะสำหรับ | ความต้องการคงที่ ระบบ legacy | ความต้องการเปลี่ยนแปลง cloud warehouse |
| ความหน่วง | สูงกว่า (แปลงก่อนโหลด) | ต่ำกว่า (โหลดแล้วแปลง) |
| Data governance | ง่ายกว่า (ข้อมูลถูกกรองก่อน warehouse) | ต้องการการควบคุมระดับ warehouse |
พร้อมที่จะพิชิตการสัมภาษณ์ Data Engineering แล้วหรือยังครับ?
ฝึกฝนด้วยตัวจำลองแบบโต้ตอบ, flashcards และแบบทดสอบเทคนิคครับ
แนวทาง Hybrid: เมื่อ ETL และ ELT รวมกัน
Data stack สมัยใหม่แทบไม่ใช้ ETL หรือ ELT อย่างเดียว Apache Airflow จัดการ pipeline ที่ผสมทั้งสองรูปแบบ ข้อมูลที่อ่อนไหวอาจถูกทำให้ไม่ระบุตัวตนก่อนโหลด (ขั้นตอน ETL) ในขณะที่การรวบรวมทำงานใน warehouse (ELT)
Fivetran และ Airbyte ดึงและโหลดข้อมูลดิบโดยไม่มีการแปลง จากนั้น dbt แปลงภายใน warehouse แต่เครื่องมือเหล่านี้ยังสนับสนุนการแปลงเบาๆ ระหว่างการดึงข้อมูล: การเลือกคอลัมน์ การบังคับประเภทข้อมูล การ hash ฟิลด์ PII สิ่งนี้ทำให้ขอบเขต ETL/ELT เบลอ
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Pipeline ด้านบนดึงข้อมูลจาก Salesforce ด้วย Airbyte (ซึ่งสามารถ hash ที่อยู่อีเมลระหว่างการซิงค์) โหลดเข้า Snowflake จากนั้นรัน model dbt สำหรับการแปลงทางธุรกิจ ไม่ใช่ ETL แท้หรือ ELT แท้ แต่ใช้งานได้จริง
คำถามสัมภาษณ์: ETL vs ELT สำหรับ Data Engineer
การสัมภาษณ์ทางเทคนิคสำหรับตำแหน่ง data engineering ที่บริษัทที่ใช้ data stack สมัยใหม่ทดสอบความเข้าใจในสถาปัตยกรรม pipeline คำถามเหล่านี้ปรากฏบ่อย โดยอิงจากรูปแบบจากโมดูลเตรียมสัมภาษณ์ ETL/ELT
คำถาม 1: เมื่อใดควรเลือก ETL แทน ELT?
คำตอบที่ดีระบุสถานการณ์เฉพาะ:
- ข้อกำหนดด้านการปฏิบัติตามกฎระเบียบ: GDPR หรือ HIPAA กำหนดว่าข้อมูลบางอย่างจะต้องไม่ถึง warehouse ในรูปแบบดิบ PII ต้องถูกทำให้ไม่ระบุตัวตนหรือลบออกก่อนโหลด
- ข้อจำกัดของ warehouse legacy: ระบบ on-premises เช่น Teradata หรือการกำหนดค่า Redshift รุ่นเก่าที่มีการประมวลผลคงที่ได้รับประโยชน์จากการโหลดที่รวบรวมไว้ล่วงหน้า
- ต้นทุนเครือข่าย: การโหลด 10TB ทุกวันเข้า cloud warehouse แล้วทิ้ง 90% หลังการแปลง เป็นการสิ้นเปลืองแบนด์วิดท์ egress Pre-filtering มีความคุ้มค่ากว่า
คำตอบที่อ่อนพูดว่า "ETL ล้าสมัยแล้ว" หรือไม่ให้สถานการณ์ที่เป็นรูปธรรม ผู้สัมภาษณ์มองหาความละเอียดอ่อน
คำถาม 2: จัดการการเปลี่ยนแปลง Schema ใน Pipeline ELT อย่างไร?
คำถามนี้ทดสอบความเข้าใจเกี่ยวกับ raw data landing zone หัวข้อที่คาดหวัง:
- คอลัมน์ JSON หรือ semi-structured ที่ดูดซับฟิลด์ใหม่โดยไม่ต้อง migration schema
- Model staging ที่เลือกคอลัมน์อย่างชัดเจน แยก model downstream จากการเปลี่ยนแปลงแหล่ง
- Macro dbt หรือ assertion Dataform ที่ทำให้ build ล้มเหลวเมื่อคอลัมน์ที่คาดหวังหายไป
- การติดตาม schema drift โดยใช้เครื่องมือเช่น Monte Carlo หรือ Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
คำถาม 3: เปรียบเทียบการจัดการ ETL ด้วย Airflow vs การรัน dbt สำหรับ ELT
คำถามนี้ทดสอบความเข้าใจว่าเครื่องมือเหล่านี้แก้ปัญหาต่างกัน:
- Airflow จัดการ task: การดึงข้อมูล การเรียก API การถ่ายโอนไฟล์ การ train model มันจัดการ dependency ระหว่างงานที่ต่างกัน
- dbt แปลงข้อมูลภายใน warehouse มันจัดการ dependency ระหว่าง model SQL รันการทดสอบ สร้างเอกสาร
Pipeline ที่สมบูรณ์มักใช้ทั้งสอง: Airflow trigger การซิงค์ Airbyte รอให้เสร็จ จากนั้น trigger dbt run การรู้ว่าเมื่อใดควรใช้เครื่องมือใดแยกแยะผู้สมัคร senior
คำถาม 4: Pipeline ELT ประมวลผล 500M แถวต่อวันและนักวิเคราะห์รายงานว่า Query ช้า
คำถามปลายเปิดนี้ทดสอบการคิดวินิจฉัย:
- ตรวจสอบ materialization ของ model: model หนักยังเป็น view อยู่หรือไม่? Model incremental หรือ table อาจช่วยได้
- Partition และ cluster: สำหรับ BigQuery ตาราง fact ถูก partition ตามวันที่หรือไม่? สำหรับ Snowflake clustering ถูกปรับให้เหมาะสมกับรูปแบบ query ทั่วไปหรือไม่?
- Query pushdown: นักวิเคราะห์กำลัง query model staging แทน mart ที่รวบรวมไว้แล้วหรือไม่?
- ขนาด warehouse: การประมวลผลถูกปรับขนาดอย่างเหมาะสมในช่วงเวลา query หรือไม่?
- ข้อกำหนด freshness: การแปลงสามารถรันตอนกลางคืนแทนช่วงเวลาทำงานได้หรือไม่?
ไม่มีคำตอบที่ถูกต้องเพียงคำตอบเดียว ผู้สัมภาษณ์ประเมินการแก้ไขปัญหาอย่างเป็นระบบ
ภูมิทัศน์ของเครื่องมือในปี 2026
ตลาดการรวมข้อมูลได้รวมตัวกันรอบๆ รูปแบบไม่กี่รูปแบบ:
การดึงและโหลด: Fivetran, Airbyte, Stitch และ Meltano จัดการส่วน EL เครื่องมือเหล่านี้เชื่อมต่อกับแหล่งหลายร้อยแห่งและซิงค์ไปยัง cloud warehouse โดยไม่ต้องเขียนโค้ดเอง
การแปลง: dbt ครองการแปลงที่ใช้ SQL ทางเลือกอื่นรวมถึง Dataform (ปัจจุบันเป็นส่วนหนึ่งของ Google Cloud), SQLMesh (open source พร้อม virtual data environment) และ Coalesce (visual modeling)
การจัดการ: Airflow ยังคงเป็นค่าเริ่มต้นสำหรับ pipeline ที่ซับซ้อน Dagster และ Prefect เสนอทางเลือกพร้อมการพัฒนาในเครื่องที่ดีกว่าและมุมมองที่เน้น asset
คุณภาพ: Great Expectations, การทดสอบ dbt, Monte Carlo และ Soda ให้การตรวจสอบคุณภาพข้อมูล เครื่องมือเหล่านี้จับปัญหาระหว่างการดึงข้อมูลและการใช้งาน downstream
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
เริ่มฝึกซ้อมเลย!
ทดสอบความรู้ของคุณด้วยตัวจำลองสัมภาษณ์และแบบทดสอบเทคนิคครับ
การเลือกสถาปัตยกรรม Pipeline สำหรับโปรเจกต์ใหม่
สำหรับโปรเจกต์ greenfield ส่วนใหญ่ในปี 2026 ELT เป็นค่าเริ่มต้น ต้นทุนการประมวลผล cloud warehouse ถูกกว่าการดูแลเซิร์ฟเวอร์การแปลง การรักษาข้อมูลดิบช่วยให้แก้ไขย้อนหลังได้ การแปลงที่ใช้ SQL สามารถตรวจสอบและควบคุมเวอร์ชันได้
ETL ยังคงเหมาะสำหรับ:
- สภาพแวดล้อมที่มีกฎระเบียบต้องการการลดข้อมูลก่อนเข้า warehouse
- Streaming real-time ที่การแปลงต้องเกิดขึ้น ณ เวลา ingestion (Kafka Streams, Flink)
- สถานการณ์ edge computing ที่มีพื้นที่จัดเก็บ downstream จำกัด
- การรวม legacy ที่ระบบต้นทางควบคุมรูปแบบ export
คำตอบที่พร้อมสำหรับการสัมภาษณ์ยอมรับทั้งสองรูปแบบและอธิบายการแลกเปลี่ยนโดยไม่มีความชอบตามอุดมการณ์
สรุป: สถาปัตยกรรม Data Pipeline
- ETL แปลงข้อมูลก่อนโหลด ลดภาระ warehouse แต่สร้างความยากในการประมวลผลใหม่เมื่อตรรกะเปลี่ยน
- ELT โหลดข้อมูลดิบก่อน ช่วยให้การแปลงที่ใช้ SQL สามารถควบคุมเวอร์ชัน ทดสอบ และรันใหม่กับข้อมูลประวัติ
- Stack สมัยใหม่มักรวมทั้งสอง: การแปลงการดึงข้อมูลเบาๆ (hash PII, การบังคับประเภท) กับการรวบรวมที่ใช้ warehouse
- dbt กลายเป็นมาตรฐานสำหรับการแปลง ELT โดยปฏิบัติต่อ model SQL เป็นโค้ดที่สามารถทดสอบและจัดทำเอกสาร
- คำถามสัมภาษณ์ทดสอบการเลือกสถานการณ์ การจัดการ schema evolution และการแลกเปลี่ยนเครื่องมือ ไม่ใช่คำจำกัดความที่ท่องจำ
- การรักษาข้อมูลดิบใน pipeline ELT ช่วยให้แก้ไขการคำนวณประวัติโดยไม่ต้องดึงข้อมูลใหม่จากแหล่ง
คุณหาบั๊กใน Data Engineering เจอไหม
โค้ดจริงหนึ่งชิ้น บั๊กที่ซ่อนอยู่หนึ่งจุด วันละหนึ่งครั้ง ลองได้โดยไม่ต้องมีบัญชี
เขียนโดย
Anthony Fillion-Mailletผู้ก่อตั้ง SharpSkill
เป็นนักพัฒนาฟูลสแตกมากว่า 10 ปี ดูแล SharpSkill และรับผิดชอบทุกสิ่งที่เผยแพร่ที่นี่
อัปเดตเมื่อ 14 กันยายน 2569
แชร์
บทความที่เกี่ยวข้อง
Great Expectations 2026: การตรวจสอบคุณภาพข้อมูลและคำถามสัมภาษณ์
คู่มือฉบับสมบูรณ์เกี่ยวกับ framework Great Expectations 1.22 สำหรับการตรวจสอบคุณภาพข้อมูลใน pipeline Python รวมถึงการผสานกับ Airflow และคำถามสัมภาษณ์ data engineering
Apache Beam vs Spark 2026: เปรียบเทียบ Pipeline แบบรวมและคำถามสัมภาษณ์
คู่มือครบถ้วนเปรียบเทียบ Apache Beam 2.76 และ Spark 4.2 สำหรับ data engineering เรียนรู้ความแตกต่างด้านสถาปัตยกรรม windowing ประสิทธิภาพ และคำถามสัมภาษณ์ที่พบบ่อย
Apache Flink 2026: การประมวลผล Stream, Event Time และคำถามสัมภาษณ์
คู่มือ Apache Flink 2.3 สำหรับการประมวลผล stream ด้วย event time semantics, watermark และ windowing พร้อมคำถามสัมภาษณ์และตัวอย่างโค้ด production