Apache Spark 4.2 vs Databricks 2026: สถาปัตยกรรม ประสิทธิภาพ และคำถามสัมภาษณ์
เปรียบเทียบเชิงลึก Apache Spark 4.2 vs Databricks สำหรับปี 2026 เรียนรู้ความแตกต่างด้านสถาปัตยกรรม การแลกเปลี่ยนด้านประสิทธิภาพ ฟีเจอร์ล่าสุด และเตรียมคำถามสัมภาษณ์ data engineering
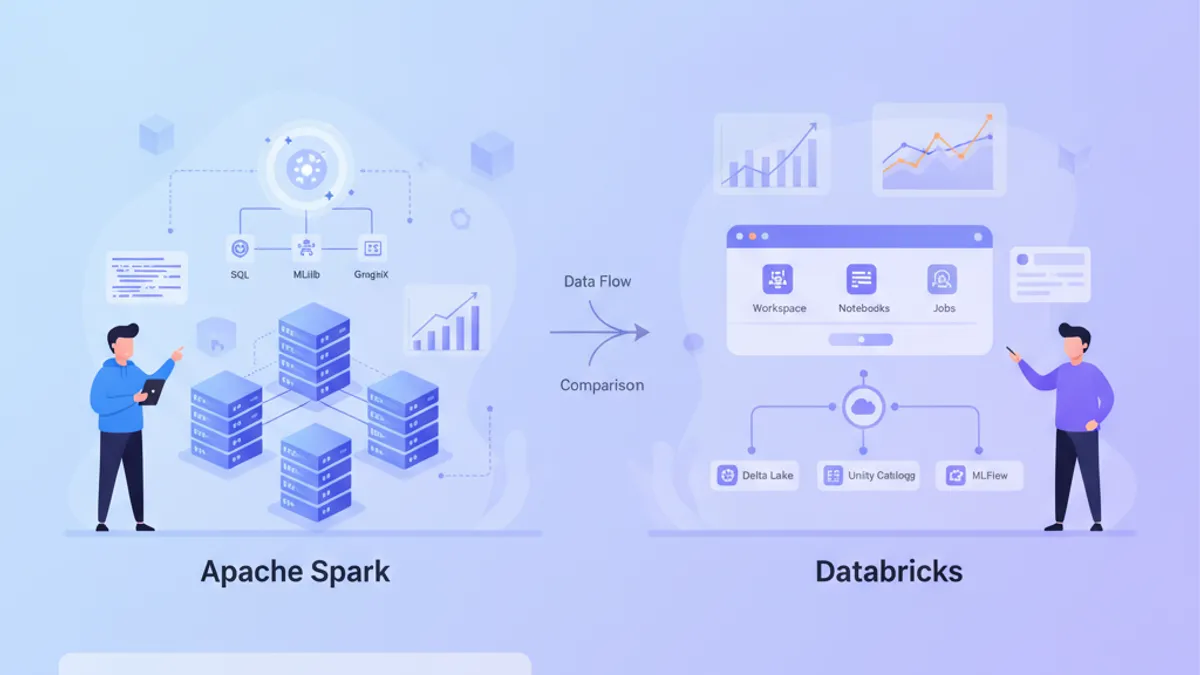
Apache Spark 4.2 และ Databricks เป็นตัวแทนของสองแนวทางในการประมวลผลข้อมูลแบบกระจายในปี 2026 Spark มอบความยืดหยุ่นสูงสุดในฐานะ framework โอเพ่นซอร์ส ในขณะที่ Databricks ห่อหุ้ม Spark ไว้ในแพลตฟอร์ม lakehouse ที่มีการจัดการพร้อมการปรับปรุงเฉพาะ การทำความเข้าใจความแตกต่างระหว่างทั้งสองตัวเลือกนี้มีความสำคัญอย่างยิ่งสำหรับการเตรียมสัมภาษณ์ data engineering และการตัดสินใจด้านสถาปัตยกรรม
Apache Spark คือ framework การประมวลผลแบบกระจาย Databricks คือแพลตฟอร์มเชิงพาณิชย์ที่สร้างบน Spark การเปรียบเทียบทั้งสองโดยตรงเหมือนกับการเปรียบเทียบ Linux กับ Red Hat Enterprise Linux: อันหนึ่งคือรากฐาน อีกอันคือเวอร์ชันที่ผลิตเป็นสินค้าพร้อมฟีเจอร์สำหรับองค์กร
Apache Spark 4.2: ฟีเจอร์ใหม่และสถาปัตยกรรม
Apache Spark 4.2 เปิดตัวเมื่อวันที่ 14 กรกฎาคม 2026 นำเสนอฟีเจอร์หลายอย่างที่เปลี่ยนแปลงวิธีการทำงานของ data pipeline การเพิ่มเติมที่สำคัญที่สุดมุ่งเป้าไปที่ change data capture การผสานรวม AI และ streaming workload
Auto CDC และ CHANGES Clause
Spark 4.2 ทำให้ change data capture เป็นฟีเจอร์ native ใน engine ก่อนหน้านี้ การติดตามการเปลี่ยนแปลงข้อมูลต้องใช้โซลูชันแบบกำหนดเองที่เกี่ยวข้องกับ timestamp การเปรียบเทียบ hash หรือเครื่องมือ CDC ภายนอก ฟีเจอร์ Auto CDC ใหม่จัดการสิ่งนี้โดยอัตโนมัติ
-- changes-query.sql
-- ค้นหาการเปลี่ยนแปลงในตาราง Delta ตั้งแต่เวอร์ชัน 10
SELECT * FROM orders CHANGES SINCE VERSION 10;

-- ติดตามการเปลี่ยนแปลงภายในช่วงเวลา
SELECT * FROM customers
CHANGES BETWEEN TIMESTAMP '2026-07-01' AND TIMESTAMP '2026-07-15';
CHANGES clause ส่งคืนแถวพร้อมคอลัมน์ metadata ที่ระบุว่าแต่ละแถวถูก insert update หรือ delete ซึ่งขจัดความจำเป็นในการดูแลโครงสร้างพื้นฐาน CDC แยกต่างหากสำหรับกรณีการใช้งานส่วนใหญ่
Metric Views: Semantic Layer แบบ Native
Metric Views สร้างคำจำกัดความทางธุรกิจที่มีการกำกับดูแลโดยตรงใน Spark SQL ทีมกำหนด metric ครั้งเดียว รับรองการคำนวณที่สอดคล้องกันทั่วทั้ง dashboard รายงาน และแอปพลิเคชัน AI
-- metric-views.sql
-- กำหนด metric view สำหรับการคำนวณรายได้
CREATE METRIC VIEW monthly_revenue AS
SELECT
    DATE_TRUNC('month', order_date) AS month,
    SUM(amount) AS total_revenue,
    COUNT(DISTINCT customer_id) AS unique_customers,
    SUM(amount) / COUNT(DISTINCT customer_id) AS revenue_per_customer
FROM orders
WHERE status = 'completed'
GROUP BY DATE_TRUNC('month', order_date);

-- ค้นหา metric view
SELECT * FROM monthly_revenue WHERE month >= '2026-01-01';
Metric Views บังคับใช้ความสอดคล้องในการคำนวณ เมื่อทีมการเงินค้นหา monthly_revenue พวกเขาจะได้ตัวเลขเดียวกับทีม data science ที่กำลังสร้างโมเดล ML
Real-Time Mode สำหรับ PySpark
Spark 4.2 แนะนำ Real-Time Mode ที่ทำให้ streaming workflow ใน PySpark ง่ายขึ้น ประกาศของ Databricks เน้นย้ำว่าสิ่งนี้ลดภาระการดำเนินงานของการจัดการ checkpoint และการกู้คืนจากความล้มเหลว
# streaming_pipeline.py
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, window

spark = SparkSession.builder.appName("RealTimeOrders").getOrCreate()

# เปิดใช้งาน Real-Time Mode สำหรับ streaming ที่ง่ายขึ้น
orders_stream = spark.readStream \
    .format("kafka") \
    .option("kafka.bootstrap.servers", "kafka:9092") \
    .option("subscribe", "orders") \
    .option("realtimeMode", "true") \
    .load()

# รวมคำสั่งซื้อใน window 5 นาที
aggregated = orders_stream \
    .withWatermark("event_time", "10 minutes") \
    .groupBy(window(col("event_time"), "5 minutes"), col("region")) \
    .agg({"amount": "sum", "order_id": "count"})

# เขียนไปยัง Delta Lake
aggregated.writeStream \
    .format("delta") \
    .outputMode("append") \
    .option("checkpointLocation", "/checkpoints/orders") \
    .toTable("order_aggregates")
Real-Time Mode จัดการ checkpoint ภายใน ลดโค้ด boilerplate และความซับซ้อนในการดำเนินงานสำหรับแอปพลิเคชัน streaming
สถาปัตยกรรมแพลตฟอร์ม Databricks ในปี 2026
Databricks ขยาย Spark ด้วยฟีเจอร์เฉพาะที่ตอบสนองความต้องการขององค์กร แพลตฟอร์มนี้รวม Delta Lake, Unity Catalog, Mosaic AI และ engine OLTP Lakebase ใหม่เข้าด้วยกันเป็น lakehouse แบบบูรณาการ
Unity Catalog: การกำกับดูแลแบบรวมศูนย์
Unity Catalog ให้การควบคุมการเข้าถึงแบบละเอียดทั่วทั้งทรัพย์สินข้อมูล ความปลอดภัยระดับคอลัมน์ ตัวกรองแถว และการปกปิดข้อมูลถูกนำไปใช้อย่างสอดคล้องกันทั่วทั้งคำสั่ง SQL, notebook และงาน training ML
-- unity-catalog-policies.sql
-- ให้สิทธิ์การอ่านสำหรับคอลัมน์เฉพาะ
GRANT SELECT (customer_id, order_date, product_id)
ON TABLE sales.orders
TO `analyst-team`;

-- สร้าง policy ความปลอดภัยระดับแถว
CREATE ROW FILTER policy_regional_access
ON sales.orders
AS (region STRING) -> region = current_user_region();

-- นำตัวกรองไปใช้
ALTER TABLE sales.orders SET ROW FILTER policy_regional_access ON (region);
ด้วย Spark ที่จัดการเอง ฟังก์ชันที่เทียบเท่าต้องการการผสานรวมกับ Apache Ranger สำหรับการควบคุมการเข้าถึง Apache Atlas สำหรับ metadata และโซลูชันแบบกำหนดเองสำหรับการติดตาม lineage
เศรษฐศาสตร์ของ Serverless Compute
Databricks serverless SQL ขจัดต้นทุน cluster ที่ไม่ได้ใช้งาน ตามการวิเคราะห์ราคาของ Flexera SQL Serverless มีราคา $0.70 ต่อ DBU บน AWS Premium แต่สำหรับ BI workload ที่มีลักษณะ bursty ต้นทุนรวมมักจะต่ำกว่า SQL Pro 20-35% เนื่องจากชั่วโมงที่ไม่ได้ใช้งานหายไป
| ประเภท Compute | อัตรา DBU (AWS Premium) | เหมาะสำหรับ |
|---|---|---|
| Jobs Classic | $0.15 | Batch ETL การประมวลผลข้ามคืน |
| Jobs Serverless | $0.28 | Workload ที่เปลี่ยนแปลง กำหนดการที่คาดเดาไม่ได้ |
| SQL Pro | $0.55 | คำสั่ง BI ที่ต่อเนื่อง รูปแบบที่คาดเดาได้ |
| SQL Serverless | $0.70 | คำสั่งแบบ bursty dashboard ตามความต้องการ |
| Model Serving | $0.08 | Endpoint สำหรับ ML inference |
การแลกเปลี่ยนนั้นตรงไปตรงมา: serverless ต้องการ premium DBU 20-40% เทียบกับ compute แบบ classic แต่ขจัดต้นทุนการเริ่มต้น cluster และการไม่ได้ใช้งานที่อาจครอบงำการใช้จ่ายทั้งหมดสำหรับ workload ที่เปลี่ยนแปลง
พร้อมที่จะพิชิตการสัมภาษณ์ Data Engineering แล้วหรือยังครับ?
ฝึกฝนด้วยตัวจำลองแบบโต้ตอบ, flashcards และแบบทดสอบเทคนิคครับ
การเปรียบเทียบสถาปัตยกรรมสำหรับการเตรียมสัมภาษณ์
การสัมภาษณ์ data engineering มักสำรวจการแลกเปลี่ยนระหว่าง Spark ที่จัดการเองและแพลตฟอร์มที่มีการจัดการเช่น Databricks การเปรียบเทียบต่อไปนี้ครอบคลุมหัวข้อสัมภาษณ์ที่พบบ่อยที่สุด
การจัดการ Cluster และการ Scaling
Spark ที่จัดการเอง ต้องการการกำหนดค่า cluster อย่างชัดเจน ทีมเลือกประเภท instance กำหนดค่านโยบาย autoscaling และจัดการการหยุดชะงักของ spot instance
# spark_cluster_config.py
from pyspark import SparkConf

conf = SparkConf() \
    .setAppName("ProductionETL") \
    .set("spark.executor.instances", "10") \
    .set("spark.executor.cores", "4") \
    .set("spark.executor.memory", "16g") \
    .set("spark.dynamicAllocation.enabled", "true") \
    .set("spark.dynamicAllocation.minExecutors", "2") \
    .set("spark.dynamicAllocation.maxExecutors", "50") \
    .set("spark.shuffle.service.enabled", "true")
Databricks ทำให้ความซับซ้อนส่วนใหญ่เป็นนามธรรม นโยบาย cluster บังคับใช้มาตรฐานขององค์กร และ instance ที่ปรับให้เหมาะสมกับ photon จะเลือกการกำหนดค่าที่เหมาะสมโดยอัตโนมัติ
Data Lineage และ Observability
Databricks Unity Catalog ติดตาม lineage โดยอัตโนมัติทั่วทั้งตาราง notebook และโมเดล ML ทุกการดำเนินการอ่านและเขียนสร้างร่องรอยที่ตรวจสอบได้
ด้วย Spark ที่จัดการเอง การติดตาม lineage ต้องการเครื่องมือเพิ่มเติม แนวทางทั่วไปรวมถึงการผสานรวมกับ Apache Atlas หรือการสร้างโซลูชันแบบกำหนดเองโดยใช้ Spark listener
# custom_lineage_listener.py
from pyspark import SparkContext
from pyspark.sql import SparkSession
from datetime import datetime

class LineageListener:
    def __init__(self, spark: SparkSession):
        self.spark = spark

    def track_read(self, table_name: str, query_id: str):
        # บันทึกการดำเนินการอ่านไปยัง lineage store
        lineage_record = {
            "operation": "read",
            "table": table_name,
            "query_id": query_id,
            "timestamp": datetime.now().isoformat(),
            "user": self.spark.sparkContext.sparkUser()
        }
        self._persist_lineage(lineage_record)

    def track_write(self, table_name: str, query_id: str, row_count: int):
        # บันทึกการดำเนินการเขียนพร้อมจำนวนแถวที่ได้รับผลกระทบ
        lineage_record = {
            "operation": "write",
            "table": table_name,
            "query_id": query_id,
            "rows_affected": row_count,
            "timestamp": datetime.now().isoformat()
        }
        self._persist_lineage(lineage_record)
ตัวเลือก Storage Layer
ทั้งสองแนวทางรองรับรูปแบบตารางแบบเปิด Delta Lake มาจาก Databricks แต่เป็นโอเพ่นซอร์สอย่างสมบูรณ์ Apache Iceberg ให้ทางเลือกพร้อมการสนับสนุนจากชุมชนที่แข็งแกร่ง
| ฟีเจอร์ | Delta Lake | Apache Iceberg |
|---|---|---|
| ACID Transactions | ใช่ | ใช่ |
| Time Travel | ใช่ | ใช่ |
| Schema Evolution | ใช่ | ใช่ |
| Partition Evolution | จำกัด | เต็มรูปแบบ |
| Hidden Partitioning | ไม่ | ใช่ |
| การผสานรวมหลัก | Databricks | หลาย engine |
สำหรับการวิเคราะห์เชิงลึกเกี่ยวกับรูปแบบเหล่านี้ ดูการเปรียบเทียบ Delta Lake vs Apache Iceberg
คำถามสัมภาษณ์ที่พบบ่อย
คำถามต่อไปนี้ปรากฏบ่อยในการสัมภาษณ์ data engineering แต่ละคำถามรวมถึงบริบทที่ผู้สัมภาษณ์ต้องการและกรอบการตอบที่มีโครงสร้าง
คำถามที่ 1: เมื่อไหร่ควรเลือก Spark ที่จัดการเองแทน Databricks?
สิ่งที่ผู้สัมภาษณ์ประเมิน: ความตระหนักด้านต้นทุน ความเป็นผู้ใหญ่ในการดำเนินงาน และความเข้าใจเกี่ยวกับข้อจำกัดขององค์กร
กรอบการตอบที่แข็งแกร่ง:
- ความสามารถในการคาดเดาต้นทุน: Spark ที่จัดการเองขจัดค่าใช้จ่ายต่อ DBU สำหรับองค์กรที่มี workload ที่สอดคล้องและคาดเดาได้ที่ทำงานตลอด 24 ชั่วโมง การใช้จ่ายเงินทุนบน reserved instance มักจะถูกกว่าการกำหนดราคาตามการใช้งาน
- อธิปไตยข้อมูล: บางอุตสาหกรรมต้องการให้ข้อมูลอยู่ในสถานที่หรือในเขตอำนาจศาลเฉพาะ การติดตั้งที่จัดการเองบนโครงสร้างพื้นฐานเฉพาะตอบสนองข้อกำหนดเหล่านี้
- ความเชี่ยวชาญที่มีอยู่: ทีมที่มีความสามารถในการดำเนินงาน Kubernetes และ Spark ที่แข็งแกร่งอาจชอบความยืดหยุ่นของการติดตั้งที่จัดการเอง
- Workload หลาย engine: องค์กรที่ใช้ Spark ร่วมกับ Presto, Flink หรือ engine แบบกำหนดเองได้รับประโยชน์จากการจัดการ cluster แบบรวมศูนย์ผ่าน YARN หรือ Kubernetes
คำถามที่ 2: Databricks ปรับปรุงประสิทธิภาพ Spark อย่างไร?
สิ่งที่ผู้สัมภาษณ์ประเมิน: ความเข้าใจเกี่ยวกับ Delta Engine, Photon และการปรับปรุงเฉพาะแพลตฟอร์ม
ประเด็นสำคัญที่ต้องครอบคลุม:
- Photon: Engine การทำงานแบบ vectorized ดั้งเดิม C++ ที่แทนที่ engine Spark SQL ที่ใช้ JVM สำหรับการดำเนินการที่รองรับ ให้การเร่งความเร็ว 2-8 เท่าสำหรับ workload ที่หนักด้าน scan และ aggregation
- Delta Cache: Layer การแคชที่ใช้ SSD ที่เร่งการอ่านซ้ำจาก cloud storage
- Adaptive Query Execution: เวอร์ชันที่ปรับปรุงของ AQE ของ Spark พร้อมการปรับปรุงเพิ่มเติมสำหรับการจัดการ data skew และการเลือกกลยุทธ์ join
- การปรับปรุง IO: การปรับปรุงการจัดวางข้อมูลอัตโนมัติ รวมถึง Z-ordering และ file compaction
คำถามที่ 3: อธิบายการแลกเปลี่ยนของ serverless compute
สิ่งที่ผู้สัมภาษณ์ประเมิน: ทักษะการสร้างแบบจำลองต้นทุนและความเข้าใจเกี่ยวกับลักษณะ workload
# cost_comparison.py
def estimate_monthly_cost(workload_type: str, daily_dbus: float, hours_active: float):
    """เปรียบเทียบต้นทุน serverless vs classic compute"""

    # อัตรา DBU (tier AWS Premium)
    rates = {
        "sql_classic": 0.55,
        "sql_serverless": 0.70,
        "jobs_classic": 0.15,
        "jobs_serverless": 0.28
    }

    # Cluster classic มีต้นทุนขณะไม่ได้ใช้งาน
    cluster_hours_per_day = 10  # Cluster ทำงาน 10 ชั่วโมงสำหรับงานจริง 4 ชั่วโมง
    serverless_hours = hours_active  # จ่ายเฉพาะ compute จริง

    classic_monthly = daily_dbus * cluster_hours_per_day * rates[f"{workload_type}_classic"] * 30
    serverless_monthly = daily_dbus * serverless_hours * rates[f"{workload_type}_serverless"] * 30

    return {
        "classic": classic_monthly,
        "serverless": serverless_monthly,
        "savings_percent": (classic_monthly - serverless_monthly) / classic_monthly * 100
    }
Serverless เหมาะสำหรับ workload ที่ bursty และคาดเดาไม่ได้ Classic compute ชนะสำหรับการประมวลผลที่ต่อเนื่องและคาดเดาได้ซึ่ง cluster ทำงานใกล้ความจุ
คำถามที่ 4: Auto CDC ของ Spark 4.2 เปรียบเทียบกับเครื่องมือ CDC แบบดั้งเดิมอย่างไร?
สิ่งที่ผู้สัมภาษณ์ประเมิน: ความเข้าใจเกี่ยวกับรูปแบบ change data capture และการแลกเปลี่ยนในการดำเนินงาน
ประเด็นเปรียบเทียบ:
การเปิดตัว Apache Spark 4.2 ฝัง CDC ไว้ใน query engine:
| ด้าน | Spark 4.2 Auto CDC | Debezium/Kafka | CDC Timestamp แบบกำหนดเอง |
|---|---|---|---|
| ความซับซ้อนในการติดตั้ง | ต่ำ | สูง | ปานกลาง |
| ความหน่วงแบบ Real-time | นาที | วินาที | นาทีถึงชั่วโมง |
| โหลดบน Database ต้นทาง | ไม่มี | การอ่าน log | ตาม query |
| การค้นหาประวัติ | ในตัว | ต้องการ retention | จำกัด |
| Schema Evolution | อัตโนมัติ | ต้องการการกำหนดค่า | ด้วยตนเอง |
Auto CDC ยอดเยี่ยมสำหรับ workload วิเคราะห์ที่ความหน่วงระดับนาทียอมรับได้ สำหรับข้อกำหนดต่ำกว่าวินาที Debezium กับ Kafka ยังคงเป็นแนวทางมาตรฐาน
กรอบการตัดสินใจเชิงปฏิบัติ
ใช้กรอบนี้เมื่อประเมิน Spark vs Databricks สำหรับองค์กรหรือโปรเจกต์เฉพาะ
เลือก Spark ที่จัดการเองเมื่อ:
- ทีมมีความเชี่ยวชาญ Spark และ Kubernetes ที่มีอยู่
- Workload คาดเดาได้และทำงานอย่างต่อเนื่อง
- ข้อมูลต้องอยู่ในสถานที่หรือในภูมิภาคเฉพาะ
- องค์กรดำเนินงานโครงสร้างพื้นฐานแพลตฟอร์มข้อมูลอยู่แล้ว
- ความอ่อนไหวด้านต้นทุนมากกว่าความสะดวกในการดำเนินงาน
เลือก Databricks เมื่อ:
- เวลาในการนำไปผลิตสำคัญกว่าต้นทุนต่อ query
- ทีมขาดความเชี่ยวชาญในการดำเนินงาน Spark เชิงลึก
- ข้อกำหนดด้าน governance และ compliance ต้องการร่องรอยการตรวจสอบ
- Workflow ML ต้องการ experiment tracking และ model serving แบบบูรณาการ
- BI workload ได้รับประโยชน์จาก serverless scaling
สำหรับการเตรียมสัมภาษณ์เกี่ยวกับการจัดการ pipeline Apache Airflow และรูปแบบ ETL โมดูลคำถามของ SharpSkill ให้การฝึกฝนที่มีโครงสร้าง
เริ่มฝึกซ้อมเลย!
ทดสอบความรู้ของคุณด้วยตัวจำลองสัมภาษณ์และแบบทดสอบเทคนิคครับ
บทสรุป
- Apache Spark 4.2 นำเสนอ Auto CDC, Metric Views และ Real-Time Mode เป็นฟีเจอร์ native ลดความต้องการเครื่องมือภายนอก
- Databricks เพิ่ม governance ของ Unity Catalog การเร่งความเร็วด้วย Photon และ serverless compute บนพื้นฐาน Spark
- Spark ที่จัดการเองให้ต้นทุนต่ำกว่าสำหรับ workload ที่คาดเดาได้และความยืดหยุ่นด้านสถาปัตยกรรมสูงสุด
- Databricks ลดภาระการดำเนินงานและเร่งเวลาในการนำไปผลิตสำหรับทีมที่ไม่มีความเชี่ยวชาญ Spark เชิงลึก
- ความสำเร็จในการสัมภาษณ์ต้องการความเข้าใจทั้งความแตกต่างทางเทคนิคและการแลกเปลี่ยนทางธุรกิจที่ขับเคลื่อนการเลือกแพลตฟอร์ม
- การเลือกที่ถูกต้องขึ้นอยู่กับความสามารถของทีม แบบจำลองต้นทุน ข้อกำหนด compliance และลักษณะ workload
คุณหาบั๊กใน Data Engineering เจอไหม
โค้ดจริงหนึ่งชิ้น บั๊กที่ซ่อนอยู่หนึ่งจุด วันละหนึ่งครั้ง ลองได้โดยไม่ต้องมีบัญชี
เขียนโดย
Anthony Fillion-Mailletผู้ก่อตั้ง SharpSkill
เป็นนักพัฒนาฟูลสแตกมากว่า 10 ปี ดูแล SharpSkill และรับผิดชอบทุกสิ่งที่เผยแพร่ที่นี่
อัปเดตเมื่อ 19 สิงหาคม 2569
แชร์
บทความที่เกี่ยวข้อง
ETL vs ELT 2026: สถาปัตยกรรม Data Pipeline และคำถามสัมภาษณ์
เรียนรู้ความแตกต่างระหว่าง ETL กับ ELT สถาปัตยกรรม data pipeline สมัยใหม่ และคำถามสัมภาษณ์ data engineering ที่พบบ่อยในปี 2026
Great Expectations 2026: การตรวจสอบคุณภาพข้อมูลและคำถามสัมภาษณ์
คู่มือฉบับสมบูรณ์เกี่ยวกับ framework Great Expectations 1.22 สำหรับการตรวจสอบคุณภาพข้อมูลใน pipeline Python รวมถึงการผสานกับ Airflow และคำถามสัมภาษณ์ data engineering
Apache Beam vs Spark 2026: เปรียบเทียบ Pipeline แบบรวมและคำถามสัมภาษณ์
คู่มือครบถ้วนเปรียบเทียบ Apache Beam 2.76 และ Spark 4.2 สำหรับ data engineering เรียนรู้ความแตกต่างด้านสถาปัตยกรรม windowing ประสิทธิภาพ และคำถามสัมภาษณ์ที่พบบ่อย