RAG และ LLM ในปี 2026: Retrieval-Augmented Generation สำหรับสัมภาษณ์ Data Science
อธิบาย Retrieval-Augmented Generation (RAG) สำหรับการสัมภาษณ์ data science ในปี 2026 ครอบคลุมฐานข้อมูลเวกเตอร์ กลยุทธ์ chunking โมเดล embedding agentic RAG Graph RAG การปฏิบัติตาม EU AI Act และสถาปัตยกรรมไปป์ไลน์ที่พร้อมใช้งานจริง
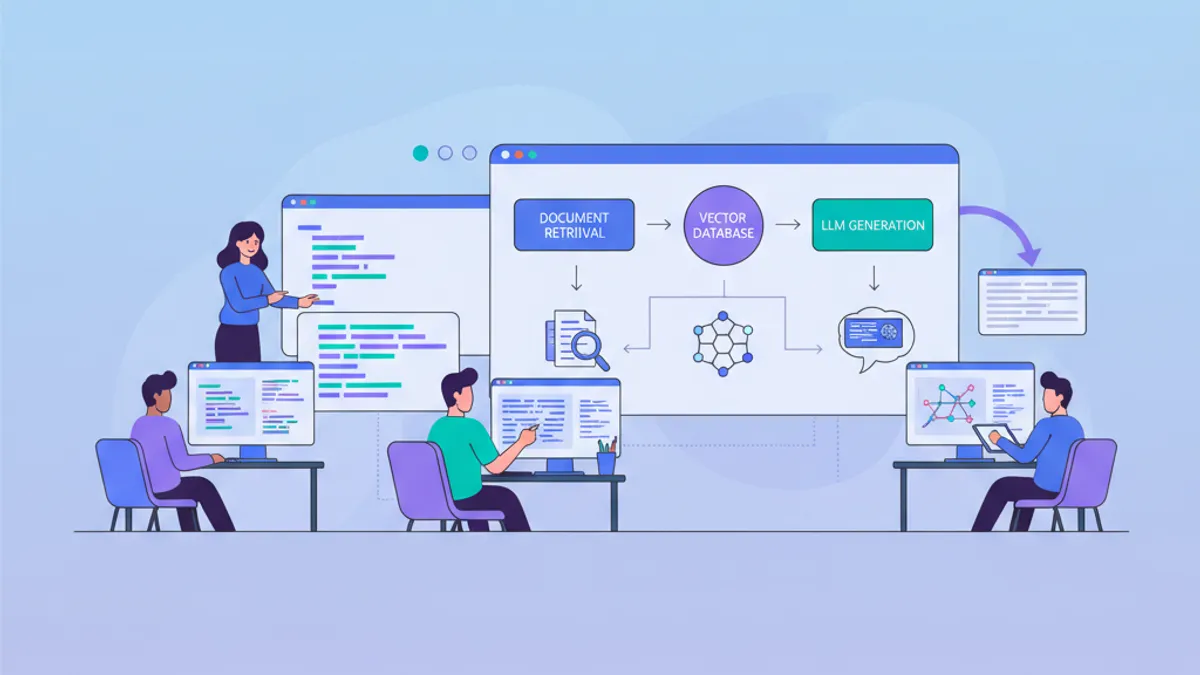
Retrieval-Augmented Generation (RAG) กลายเป็นสถาปัตยกรรมมาตรฐานสำหรับยึดผลลัพธ์ของ LLM ไว้กับข้อมูลที่เป็นข้อเท็จจริงและทันสมัย สำหรับการสัมภาษณ์งานสาย data science และวิศวกรรม AI ในปี 2026 คำถามเรื่อง RAG ปรากฏเคียงข้างหัวข้อ ML แบบดั้งเดิม โดยทดสอบทั้งการคิดเชิงออกแบบระบบและทักษะการลงมือพัฒนาจริง
Retrieval-Augmented Generation รวมระบบดึงข้อมูล (การค้นหาด้วยเวกเตอร์บนฐานความรู้) เข้ากับตัวสร้าง LLM เพื่อให้โมเดลตอบจากเอกสารจริงแทนการพึ่งพาข้อมูลฝึกที่จดจำไว้
ไปป์ไลน์ RAG ทำงานตั้งแต่ต้นจนจบอย่างไร
ระบบ RAG ทำงานสองเฟส: เฟสนำเข้าข้อมูล (ingestion) แบบออฟไลน์ ที่สร้างฐานความรู้ และ เฟสคิวรีแบบออนไลน์ ที่ดึงบริบทที่เกี่ยวข้องแล้วสร้างคำตอบ
ระหว่างการนำเข้า เอกสารดิบจะผ่านการทำความสะอาด การแบ่งชิ้น (chunking) และการฝัง (embedding) ก่อนจัดเก็บในฐานข้อมูลเวกเตอร์ ระหว่างการอนุมาน คิวรีของผู้ใช้จะเดินตามเส้นทางการฝังแบบเดียวกัน และการค้นหาเพื่อนบ้านใกล้สุดจะดึงชิ้นที่เกี่ยวข้องมากที่สุด ชิ้นเหล่านี้กลายเป็นส่วนหนึ่งของพรอมต์ LLM ยึดคำตอบที่สร้างขึ้นไว้กับเนื้อหาต้นทาง
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
ไปป์ไลน์นี้ครอบคลุมวงจรหลักของ RAG: แบ่งชิ้น ฝัง จัดเก็บ ดึง สร้าง พารามิเตอร์ search_type="mmr" รับประกันว่าชิ้นที่ดึงมานั้นทั้งเกี่ยวข้องและหลากหลาย ลดความซ้ำซ้อนในหน้าต่างบริบท
กลยุทธ์ Chunking ที่สำคัญจริง
Chunking กำหนดคุณภาพการดึงข้อมูลมากกว่าองค์ประกอบอื่นใด Chunking ที่ไม่ดีหมายความว่าตัวดึงข้อมูลคืนชิ้นส่วนที่ขาดบริบทหรือเจือจางสัญญาณด้วยเนื้อหาที่ไม่เกี่ยวข้อง
สามแนวทาง chunking ครองระบบใช้งานจริงในปี 2026:
Chunking ขนาดคงที่ แบ่งข้อความตามจำนวนโทเค็นที่กำหนด (โดยทั่วไป 256 ถึง 512 โทเค็น) พร้อมการซ้อนทับ (overlap) นำไปใช้ง่าย แต่ตัดประโยคและความคิดกลางคัน
Semantic chunking ตรวจจับขอบเขตหัวข้อด้วยการวัดความคล้ายของการฝังระหว่างประโยคที่ต่อเนื่องกัน เมื่อความคล้ายลดต่ำกว่าเกณฑ์ ชิ้นใหม่จะเริ่มขึ้น แต่ละชิ้นจึงบรรจุความคิดที่ครบถ้วนแทนการตัดข้อความแบบสุ่ม
Late chunking ใช้โมเดลทรานส์ฟอร์มเมอร์กับเอกสารทั้งฉบับก่อน สร้างการฝังโทเค็นเชิงบริบท แล้วจึงแบ่งเป็นชิ้น วิธีนี้รักษาความสัมพันธ์ระยะไกลที่ chunking แบบดั้งเดิมทำลายไป
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
ประเด็นสำคัญสำหรับการสัมภาษณ์: ขนาดชิ้นคือการแลกเปลี่ยนระหว่างความแม่นยำกับความครอบคลุม (precision-recall) ชิ้นเล็ก (100 โทเค็น) เพิ่มความแม่นยำในการดึงข้อมูลแต่ทำให้บริบทแตกกระจาย ชิ้นใหญ่ (1000 โทเค็น) รักษาบริบทแต่เจือจางความจำเพาะของการฝัง ระบบใช้งานจริงส่วนใหญ่ลงตัวที่ 256 ถึง 512 โทเค็น พร้อมการซ้อนทับ 10 ถึง 20%
ฐานข้อมูลเวกเตอร์และโมเดล Embedding ในการใช้งานจริง
ฐานข้อมูลเวกเตอร์จัดเก็บการฝังและรองรับการค้นหาเพื่อนบ้านใกล้สุดโดยประมาณ (ANN) ที่รวดเร็ว การเลือกชุดผสมระหว่างโมเดล embedding กับฐานข้อมูลเวกเตอร์ที่เหมาะสมส่งผลโดยตรงต่อความหน่วงและความแม่นยำในการดึงข้อมูล
โมเดล embedding ในปี 2026 รวมตัวอยู่ที่ตัวเลือกประสิทธิภาพสูงไม่กี่ตัว text-embedding-3-large ของ OpenAI (3072 มิติ) และทางเลือกโอเพนซอร์สอย่าง bge-m3 จาก BAAI หรือ embed-v4 จาก Cohere ให้การดึงข้อมูลหลายภาษาที่ทรงพลัง กระดานผู้นำ MTEB ยังคงเป็นเกณฑ์มาตรฐานในการเปรียบเทียบคุณภาพการฝัง ควรทราบว่า text-embedding-3-large รองรับ Matryoshka representation learning ซึ่งอนุญาตให้ตัดมิติ (เป็น 1024 หรือ 256) โดยสูญเสียคุณภาพน้อยมาก ช่วยลดต้นทุนการจัดเก็บได้อย่างมาก
ตลาดฐานข้อมูลเวกเตอร์ได้รวมตัวกันในปี 2026 สี่ผลิตภัณฑ์ครอบครองส่วนแบ่งหลักของภาระงาน RAG ในการใช้งานจริง:
| ฐานข้อมูล | การทำดัชนี | บริการจัดการ | จุดแข็ง |
|---|---|---|---|
| Pinecone | กรรมสิทธิ์ | ใช่ | ไม่ต้องดูแลระบบ, inference ในตัว, การค้นหาแบบไฮบริด |
| Weaviate | HNSW | ใช่/โฮสต์เอง | รวม BM25 + dense ในคิวรีเดียว |
| Qdrant | HNSW | ใช่/โฮสต์เอง | ประสิทธิภาพ Rust, กรอง payload, tier ฟรีดีที่สุด |
| pgvector | IVF, HNSW | โฮสต์เอง | การผสานกับ PostgreSQL สำหรับ stack ที่มีอยู่ |
สำหรับการอภิปรายในการสัมภาษณ์ ประเด็นสำคัญคือการเข้าใจอัลกอริทึม HNSW (Hierarchical Navigable Small World): มันสร้างกราฟหลายชั้นที่แต่ละโหนดเชื่อมกับเพื่อนบ้านใกล้สุด ทำให้ค้นหาได้ในระดับ O(log n) โดยแลกกับการใช้หน่วยความจำที่สูงขึ้น
จุดคุ้มทุนคือ 60 ถึง 80 ล้านคิวรีต่อเดือน เหนือจุดนี้ Qdrant หรือ Weaviate ที่โฮสต์เองบนโครงสร้างพื้นฐานต้นทุนคงที่จะถูกกว่า Pinecone Serverless อย่างสม่ำเสมอ 3x ถึง 10x
พร้อมที่จะพิชิตการสัมภาษณ์ Data Science & ML แล้วหรือยังครับ?
ฝึกฝนด้วยตัวจำลองแบบโต้ตอบ, flashcards และแบบทดสอบเทคนิคครับ
การดึงข้อมูลแบบไฮบริด: ผสานการค้นหาแบบหนาแน่นและแบบเบาบาง
การค้นหาด้วยเวกเตอร์ล้วนล้มเหลวกับการจับคู่คีย์เวิร์ดแบบตรงตัวและคำหายาก การค้นหาเชิงคำศัพท์ล้วน (BM25) พลาดความคล้ายเชิงความหมาย การดึงข้อมูลแบบไฮบริดผสานทั้งสองเข้าด้วยกัน และในปี 2026 นี่คือค่าเริ่มต้นสำหรับระบบ RAG ใช้งานจริง
รูปแบบมาตรฐานใช้ Reciprocal Rank Fusion (RRF) เพื่อรวมผลลัพธ์ที่จัดอันดับแล้วจากตัวดึงข้อมูลทั้งสอง:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
การดึงข้อมูลแบบไฮบริดแก้ปัญหา "คำศัพท์ไม่ตรงกัน" เมื่อผู้ใช้ถามเรื่อง "การยกเลิกการสมัครสมาชิก" แต่เอกสารที่เกี่ยวข้องใช้คำว่า "นโยบายการยุติบัญชี" BM25 จับการซ้อนทับของคำที่ตรงกันแบบเป๊ะ ขณะที่การค้นหาด้วยเวกเตอร์จับความสัมพันธ์เชิงความหมาย
Reranking: ตัวกรองขั้นที่สอง
การดึงข้อมูลคืนรายชื่อผู้สมัคร Reranking จัดเรียงพวกมันตามความเกี่ยวข้องที่แท้จริง ตัวจัดอันดับใหม่แบบ cross-encoder อย่าง Cohere Rerank หรือ bge-reranker-v2.5-gemma2-lightweight ให้คะแนนแต่ละคู่คิวรี-เอกสารร่วมกัน สร้างคะแนนความเกี่ยวข้องที่แม่นยำกว่าความคล้ายแบบ bi-encoder อย่างมาก
ไปป์ไลน์การดึงข้อมูลสองขั้น (recall ขั้นแรกแบบกว้างด้วย 50 ถึง 100 ผู้สมัครอันดับแรกผ่านเวกเตอร์ + BM25, แล้วจัดอันดับใหม่อย่างแม่นยำเป็น 5 ถึง 10 อันดับแรกสำหรับพรอมต์) เป็นมาตรฐานในการใช้งานจริง วิธีนี้คุมความหน่วงให้จัดการได้: ขั้นแรกใช้การค้นหา ANN ที่รวดเร็ว ขณะที่ cross-encoder ที่มีต้นทุนสูงประมวลผลเพียงชุดผู้สมัครเล็ก ๆ
Cross-encoder แม่นยำกว่า bi-encoder เพราะประมวลผลคิวรีและเอกสารร่วมกันผ่านทุกชั้นของทรานส์ฟอร์มเมอร์ ส่วน bi-encoder ฝังทั้งสองแยกกัน จึงสูญเสียสัญญาณปฏิสัมพันธ์ที่ละเอียดอ่อน ข้อแลกเปลี่ยนคือความเร็ว: cross-encoder ทำดัชนีล่วงหน้าไม่ได้
Adaptive RAG: กำหนดเส้นทางคิวรีไปยังไปป์ไลน์ที่เหมาะสม
ไม่ใช่ทุกคิวรีที่ต้องการความซับซ้อนการดึงข้อมูลเท่ากัน Adaptive RAG ฝึก classifier ขนาดเล็กเพื่อกำหนดเส้นทางแต่ละคำถามไปยังเส้นทางที่เหมาะสมที่สุด:
- ไม่มีการดึงข้อมูล สำหรับคิวรีข้อเท็จจริงง่าย ๆ ที่โมเดลรู้อยู่แล้ว
- การดึงข้อมูลขั้นเดียว สำหรับคิวรีระดับปานกลาง
- การดึงข้อมูลแบบวนซ้ำหลายขั้น สำหรับการให้เหตุผลซับซ้อน
รูปแบบนี้สร้างสมดุลระหว่างต้นทุนและความแม่นยำข้ามภาระงานที่หลากหลาย ระบบใช้งานจริงที่จัดการ 100,000 คิวรีต่อวันสามารถลดต้นทุนการอนุมานได้ 40% โดยกำหนดเส้นทางคำถามง่าย ๆ ออกจากไปป์ไลน์หลายขั้นที่มีราคาแพง
Classifier นั้นอาจเป็นโมเดลขนาดเล็กที่ fine-tune แล้วหรือ prompt แบบ zero-shot ที่ถามว่า: "คำถามนี้ต้องการความรู้ภายนอกเพื่อตอบอย่างแม่นยำหรือไม่?"
Speculative RAG: แลกการยึดโยงข้อมูลกับความเร็ว
Speculative RAG รันการดึงข้อมูลพร้อมกันกับการสร้างฉบับร่างที่รวดเร็ว หากฉบับร่างแสดงความมั่นใจสูง (วัดด้วย logprob) ขั้นตอนการดึงข้อมูลจะถูกข้ามไปเลย หากความมั่นใจต่ำ บริบทที่ดึงมาจะรวมกับฉบับร่างและการสร้างใหม่จะเกิดขึ้น
วิธีการนี้ลดความหน่วงเฉลี่ย 30 ถึง 40% สำหรับคิวรีที่มีความมั่นใจสูง เหมาะที่สุดสำหรับ chatbot แบบเรียลไทม์ คำแนะนำ autocomplete และระบบบริการลูกค้าที่เวลาตอบสนองสำคัญกว่าการอ้างอิงแหล่งข้อมูลอย่างละเอียดในทุกคิวรี
ข้อแลกเปลี่ยน: speculative RAG บางครั้งส่งคำตอบที่ไม่มีการยึดโยงข้อมูลเมื่อโมเดลมั่นใจเกินไป ระบบใช้งานจริงจับคู่กับการสอบเทียบความมั่นใจและทางเลือกสำรองไปยังการดึงข้อมูลเต็มรูปแบบเมื่อความไม่แน่นอนเกินเกณฑ์
Agentic RAG: ก้าวข้ามการดึงข้อมูลครั้งเดียวจบ
RAG แบบพื้นฐานดึงครั้งเดียวแล้วสร้าง Agentic RAG มอง LLM เป็นเอเจนต์ที่ใช้เหตุผล ตัดสินใจว่าเมื่อใดควรดึง ดึงอะไร และบริบทที่ดึงมาเพียงพอหรือไม่
ในปี 2026 agentic RAG เป็นรูปแบบหลักสำหรับคิวรีซับซ้อนที่ต้องใช้การให้เหตุผลหลายขั้น เอเจนต์สามารถ:
- ประเมินตนเอง: ประเมินว่าเอกสารที่ดึงมาตอบคำถามได้หรือไม่
- คิวรีใหม่: เรียบเรียงคิวรีค้นหาใหม่หากผลลัพธ์เริ่มต้นไม่เพียงพอ
- กำหนดเส้นทาง (routing): เลือกระหว่างแหล่งความรู้ต่าง ๆ (เวกเตอร์ DB, ฐานข้อมูล SQL, API)
- ตรวจสอบ: ตรวจสอบข้อเท็จจริงข้ามหลายข้อความที่ดึงมา
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
รูปแบบนี้ (ดึง ให้คะแนน เลือกเรียบเรียงใหม่และลองอีกครั้ง) รู้จักกันในชื่อ Corrective RAG (CRAG) ควรทราบว่า AgentExecutor ของ LangChain ถูก deprecated ตั้งแต่ปี 2026 แล้ว โปรเจกต์ใหม่ควรใช้ create_react_agent() สำหรับรูปแบบสำเร็จรูปหรือ StateGraph ของ LangGraph สำหรับการจัดการแบบกำหนดเอง สำหรับการครอบคลุมเชิงลึกเกี่ยวกับ รูปแบบ LangChain สำหรับ data scientist ดูบทความเฉพาะ
Graph RAG: การดึงความรู้แบบมีโครงสร้าง
Graph RAG สกัดเอนทิตีและความสัมพันธ์จากเอกสารลงในกราฟความรู้ แล้วคิวรีทั้งกราฟและที่จัดเก็บเวกเตอร์ สถาปัตยกรรมนี้ลดอาการหลอน (hallucination) ในคิวรีเชิงข้อเท็จจริงด้วยการยึดคำตอบไว้กับความสัมพันธ์ของเอนทิตีที่ชัดเจนแทนความคล้ายของข้อความที่ไร้โครงสร้าง
ไปป์ไลน์การนำเข้าสกัดทริปเปิล (ประธาน กริยา กรรม) จากแต่ละชิ้นเอกสาร ณ เวลาคิวรี ระบบระบุเอนทิตีที่เกี่ยวข้องในคำถาม ท่องกราฟความรู้เพื่อหาข้อเท็จจริงที่เชื่อมโยง และผสานบริบทที่ดึงจากกราฟกับข้อความที่ดึงด้วยเวกเตอร์
Graph RAG โดดเด่นในคำถามที่ต้องให้เหตุผลหลายขั้น (multi-hop) เช่น "ทีมใดเป็นผู้นำโครงการที่ใช้เฟรมเวิร์กที่กล่าวถึงในเอกสาร X?" คิวรีเหล่านี้ต้องการการเชื่อมโยงข้อเท็จจริงข้ามหลายเอกสาร สิ่งที่การค้นหาด้วยเวกเตอร์ล้วนทำได้ยากเพราะไม่มีชิ้นเดียวที่บรรจุคำตอบครบถ้วน
Graph RAG ปรับปรุงความแม่นยำเชิงข้อเท็จจริงอย่างมีนัยสำคัญ (ลดอาการหลอนได้สูงถึง 40% ในคิวรีที่มีเอนทิตีหนาแน่น) แต่ต้องอาศัยไปป์ไลน์การสกัดเอนทิตีที่สมบูรณ์ การสกัดที่มีสัญญาณรบกวนสร้างกราฟที่รบกวน ซึ่งอาจทำให้ผลลัพธ์แย่กว่า RAG แบบพื้นฐาน ควรทราบด้วยว่าโปรเจกต์ GraphRAG ของ Microsoft เข้าสู่โหมดบำรุงรักษาในปี 2026 มันจะได้รับการแก้ไขบั๊กแต่ไม่มีฟีเจอร์ใหม่
ตัวแปร LazyGraphRAG ของ Microsoft (เปิดตัวมิถุนายน 2025) ลดต้นทุนการทำดัชนีอย่างมากโดยเลื่อนการสรุปไปจนถึงเวลาคิวรี ทำให้เหมาะสำหรับการวิเคราะห์เชิงสำรวจหรือข้อมูล streaming ที่การสร้างกราฟล่วงหน้าไม่เหมาะ
การปฏิบัติตาม EU AI Act สำหรับระบบ RAG
EU AI Act มีผลบังคับใช้อย่างกว้างขวางในเดือนสิงหาคม 2026 ค่าปรับระดับสูงครั้งแรกภายใต้กฎหมายนี้ตกที่ chatbot RAG ของกลุ่มธนาคารยุโรปในปลายเดือนพฤษภาคม 2026 และบริษัทจัดการความมั่งคั่งแฟรงก์เฟิร์ตได้รับโทษปรับ 4.5 ล้านยูโรในเดือนเมษายน 2026 สำหรับระบบ RAG ที่ให้บริการลูกค้าแต่ไม่สามารถอธิบายที่มาของข้อมูล
สถาปัตยกรรม RAG ตอบสนองข้อกำหนดการปฏิบัติตามหลายประการโดยธรรมชาติ: ความสามารถในการติดตามแหล่งที่มา (ชิ้นมีการอ้างอิงเอกสาร) ความโปร่งใสของคำตอบ (สามารถแสดงการอ้างอิงได้) และความสามารถในการตรวจสอบ (บันทึกการดึงข้อมูลมีอยู่โดยการออกแบบ) อย่างไรก็ตาม การปฏิบัติตามอย่างเต็มรูปแบบต้องการมาตรการเพิ่มเติม:
การจำแนกความเสี่ยง: Chatbot สาธารณะอยู่ในความเสี่ยงจำกัด (ต้องการความโปร่งใส) ระบบ RAG ทางการแพทย์หรือกฎหมายเป็นความเสี่ยงสูงพร้อมภาระผูกพันด้านเอกสารและการกำกับดูแลที่เข้มงวดกว่า
การบันทึกการตรวจสอบ: บันทึกว่าคำถามใดเรียกชิ้นใดที่ถูกดึงมาและคำตอบใดถูกสร้าง บันทึกนี้เป็นพื้นฐานของความสามารถในการติดตามที่จำเป็น
การกำกับดูแลโดยมนุษย์: ระบบความเสี่ยงสูงต้องการการตรวจสอบโดยมนุษย์ในกรณีที่อ่อนไหว ความสามารถในการแก้ไขผลลัพธ์ และกลไกในการลบข้อมูลที่ทำดัชนีตามคำขอ
ที่ตั้งข้อมูล: โฮสต์การทำดัชนีใน EU และใช้ BYOK (Bring Your Own Key) เพื่อให้แน่ใจว่าข้อมูลไม่ผ่านบัญชีบุคคลที่สามนอกเขตอำนาจศาล
การไม่ปฏิบัติตามอาจมีค่าใช้จ่าย 7% ของรายได้ประจำปีทั่วโลก สำหรับการอภิปรายในการสัมภาษณ์ ประเด็นสำคัญคือความสามารถในการอ้างอิงโดยธรรมชาติของ RAG เป็นข้อได้เปรียบ แต่ไม่สามารถทดแทนชั้นการกำกับดูแลได้
การประเมินระบบ RAG: เมตริกที่สำคัญ
การประเมิน RAG แบ่งเป็นเมตริกการดึงข้อมูลและเมตริกการสร้าง ทั้งสองต้องวัดแยกกันเพื่อวินิจฉัยจุดล้มเหลว
เมตริกการดึงข้อมูล:
- Recall@k: เอกสารที่เกี่ยวข้องปรากฏในผลลัพธ์ k อันดับแรกหรือไม่?
- MRR (Mean Reciprocal Rank): ผลลัพธ์ที่เกี่ยวข้องชิ้นแรกถูกจัดอันดับสูงเพียงใด?
- NDCG: การจัดอันดับตรงกับลำดับความเกี่ยวข้องในอุดมคติหรือไม่?
เมตริกการสร้าง:
- Faithfulness (ความซื่อตรง): คำตอบใช้เฉพาะข้อมูลจากบริบทที่ดึงมาหรือไม่? (วัดอาการหลอน)
- ความเกี่ยวข้องของคำตอบ: คำตอบตอบคำถามต้นฉบับหรือไม่?
- ความแม่นยำของบริบท: ชิ้นที่ดึงมาถูกใช้ในคำตอบจริงหรือไม่?
เฟรมเวิร์กอย่าง Ragas และ DeepEval ทำให้การประเมินเหล่านี้เป็นอัตโนมัติโดยใช้รูปแบบ LLM-เป็น-ผู้ตัดสิน (LLM-as-judge) คำถามสัมภาษณ์ data science ยอดนิยม นับวันยิ่งรวมการออกแบบการประเมิน RAG เข้าไป ดังนั้นเตรียมอธิบายวิธีวัดว่าระบบ RAG ทำงานถูกต้องหรือไม่
โหมดความล้มเหลวในการใช้งานจริงและการดีบัก
ระบบ RAG ล้มเหลวในแบบที่คาดเดาได้ การรู้รูปแบบเหล่านี้จำเป็นทั้งต่อการสัมภาษณ์และการใช้งานจริง
มลพิษในหน้าต่างบริบท เกิดขึ้นเมื่อชิ้นที่ดึงมามากเกินไปเจือจางสัญญาณที่เกี่ยวข้อง LLM ได้รับ 10 ชิ้นแต่มีเพียง 2 ชิ้นที่มีข้อมูลที่มีประโยชน์ วิธีแก้: ใช้ตัวจัดอันดับใหม่เพื่อกรอง และลดค่า top-k จากตัวดึงข้อมูล
สิ่งแปลกปลอมจาก chunking เกิดเมื่อการแบ่งขนาดคงที่ตัดประโยค ตาราง หรือบล็อกโค้ดกลางองค์ประกอบ ชิ้นที่ดึงมาไม่สมบูรณ์ทางไวยากรณ์และไร้ประโยชน์เชิงความหมาย Semantic chunking หรือการแบ่งที่รับรู้โครงสร้างเอกสาร (เคารพหัวข้อ ย่อหน้า code fence) แก้ปัญหานี้ได้
การเลื่อนไหลของ embedding (embedding drift) เกิดเมื่อโมเดล embedding ถูกอัปเดตแต่ที่จัดเก็บเวกเตอร์ยังบรรจุการฝังจากโมเดลเก่า คิวรีที่เข้ารหัสด้วยโมเดลใหม่จึงค้นหาในปริภูมิเวกเตอร์ที่สร้างโดยโมเดลเก่า ทำให้คุณภาพการดึงข้อมูลลดลง ทางแก้: ฝังคลังข้อมูลทั้งหมดใหม่หลังเปลี่ยนโมเดลทุกครั้ง
ดัชนีที่ล้าสมัย ส่งมอบข้อมูลที่ตกยุคเพราะไปป์ไลน์การนำเข้าตามหลังการอัปเดตเอกสาร ในระบบ machine learning สิ่งนี้คล้ายกับความเบี่ยงเบนระหว่างการฝึกกับการให้บริการ (training-serving skew), ที่ระบบดึงข้อมูลเห็นการกระจายของข้อมูลที่ต่างจากที่มีอยู่จริงในการใช้งาน
แหล่งข้อมูล
- Turing Post: 20 Advanced RAG Types to Know in 2026 - อนุกรมวิธานที่ครอบคลุมของรูปแบบ RAG
- LangChain and LangGraph 1.0 Milestones - การ deprecate AgentExecutor, รูปแบบใหม่
- Microsoft GraphRAG GitHub - สถานะโหมดบำรุงรักษา
- IgnitionRAG EU AI Act Guide - ข้อกำหนดการปฏิบัติตามสำหรับระบบ RAG
- MarkTechPost: Best Vector Databases in 2026 - การรวมตัวของตลาดและราคา
เริ่มฝึกซ้อมเลย!
ทดสอบความรู้ของคุณด้วยตัวจำลองสัมภาษณ์และแบบทดสอบเทคนิคครับ
ประเด็นสำคัญเกี่ยวกับ RAG สำหรับการสัมภาษณ์ Data Science
- RAG ผสานการดึงข้อมูล (การค้นหาด้วยเวกเตอร์บนฐานความรู้) เข้ากับการสร้างของ LLM เพื่อให้คำตอบเชิงข้อเท็จจริงที่มีหลักฐานยึดโยงโดยไม่ต้องฝึกโมเดลใหม่
- กลยุทธ์ chunking มีผลต่อคุณภาพการดึงข้อมูลมากที่สุด; semantic chunking และ late chunking เหนือกว่าการแบ่งขนาดคงที่ในกรณีใช้งานส่วนใหญ่
- การดึงข้อมูลแบบไฮบริด (เวกเตอร์หนาแน่น + BM25 เบาบาง) พร้อม Reciprocal Rank Fusion เป็นค่าเริ่มต้นในการใช้งานจริง แก้ปัญหาคำศัพท์ไม่ตรงกันที่การค้นหาด้วยเวกเตอร์ล้วนจัดการไม่ได้
- ตัวจัดอันดับใหม่แบบ cross-encoder เพิ่มชั้นความแม่นยำหลังการดึงข้อมูลแบบกว้าง โดยประมวลผลเพียงชุดผู้สมัครเล็ก ๆ เพื่อคุมความหน่วงให้ยอมรับได้
- Adaptive RAG กำหนดเส้นทางคิวรีไปยังความซับซ้อนไปป์ไลน์ที่เหมาะสม ลดต้นทุน 40% บนภาระงานที่หลากหลาย
- Speculative RAG แลกการยึดโยงข้อมูลกับความเร็ว ลดความหน่วง 30 ถึง 40% บนคิวรีที่มีความมั่นใจสูง
- Agentic RAG (ดึง ให้คะแนน เรียบเรียงใหม่ ลองอีกครั้ง) และ Graph RAG (การสกัดความสัมพันธ์ของเอนทิตี) รับมือคิวรี multi-hop ซับซ้อนที่ RAG แบบพื้นฐานล้มเหลว
- การปฏิบัติตาม EU AI Act (สิงหาคม 2026) ต้องการการบันทึกการตรวจสอบ การกำกับดูแลโดยมนุษย์ และการจำแนกความเสี่ยงสำหรับระบบ RAG ในการใช้งานจริง
- การประเมินต้องแยกเมตริกการดึงข้อมูล (Recall@k, MRR) ออกจากเมตริกการสร้าง (faithfulness, ความเกี่ยวข้องของคำตอบ) เพื่อวินิจฉัยว่าไปป์ไลน์พังตรงไหน
- ความล้มเหลวในการใช้งานจริงที่พบบ่อยที่สุด (มลพิษในบริบท, สิ่งแปลกปลอมจาก chunking, การเลื่อนไหลของ embedding, ดัชนีล้าสมัย) ล้วนมีทางแก้ที่ตรงไปตรงมาเมื่อระบุได้
คุณหาบั๊กใน Data Science & ML เจอไหม
โค้ดจริงหนึ่งชิ้น บั๊กที่ซ่อนอยู่หนึ่งจุด วันละหนึ่งครั้ง ลองได้โดยไม่ต้องมีบัญชี

เขียนโดย
Anthony Fillion-Mailletผู้ก่อตั้ง SharpSkill
เป็นนักพัฒนาฟูลสแตกมากว่า 10 ปี ดูแล SharpSkill และรับผิดชอบทุกสิ่งที่เผยแพร่ที่นี่
อัปเดตเมื่อ 24 สิงหาคม 2569
แท็ก
แชร์
บทความที่เกี่ยวข้อง
Feature Engineering สำหรับ Machine Learning: เทคนิคและคำถามสัมภาษณ์ 2026
เรียนรู้เทคนิค feature engineering สำหรับ machine learning พร้อมตัวอย่าง Python จริง ครอบคลุม encoding, scaling, การคัดเลือก feature, pipeline scikit-learn และคำถามสัมภาษณ์ data science
งาน Freelance Data Scientist ปี 2026: แหล่งหาสัญญาจ้าง อัตราค่าจ้างรายวัน และการเตรียมตัว
คู่มือฉบับสมบูรณ์สำหรับ data scientist ที่ต้องการทำงานฟรีแลนซ์ในปี 2026: แพลตฟอร์มหาสัญญาจ้าง อัตราค่าจ้างรายวันเฉลี่ย และกลยุทธ์การเตรียมตัวสัมภาษณ์เทคนิค
งาน Data Scientist ปี 2026: แหล่งค้นหา ช่วงเงินเดือน และวิธีเตรียมตัว
งาน data scientist ยังคงเป็นตำแหน่งเทคนิคที่เป็นที่ต้องการมากที่สุดในปี 2026 บทความนี้แนะนำแหล่งหางาน ช่วงเงินเดือนปัจจุบัน และวิธีเตรียมตัวสัมภาษณ์อย่างมีประสิทธิภาพ