ETL vs ELT 2026: 데이터 파이프라인 아키텍처 심층 분석 및 면접 대비
ETL과 ELT의 차이점, 아키텍처, 사용 사례, 최신 도구, 데이터 엔지니어 면접 빈출 질문에 대해 알아봅니다.
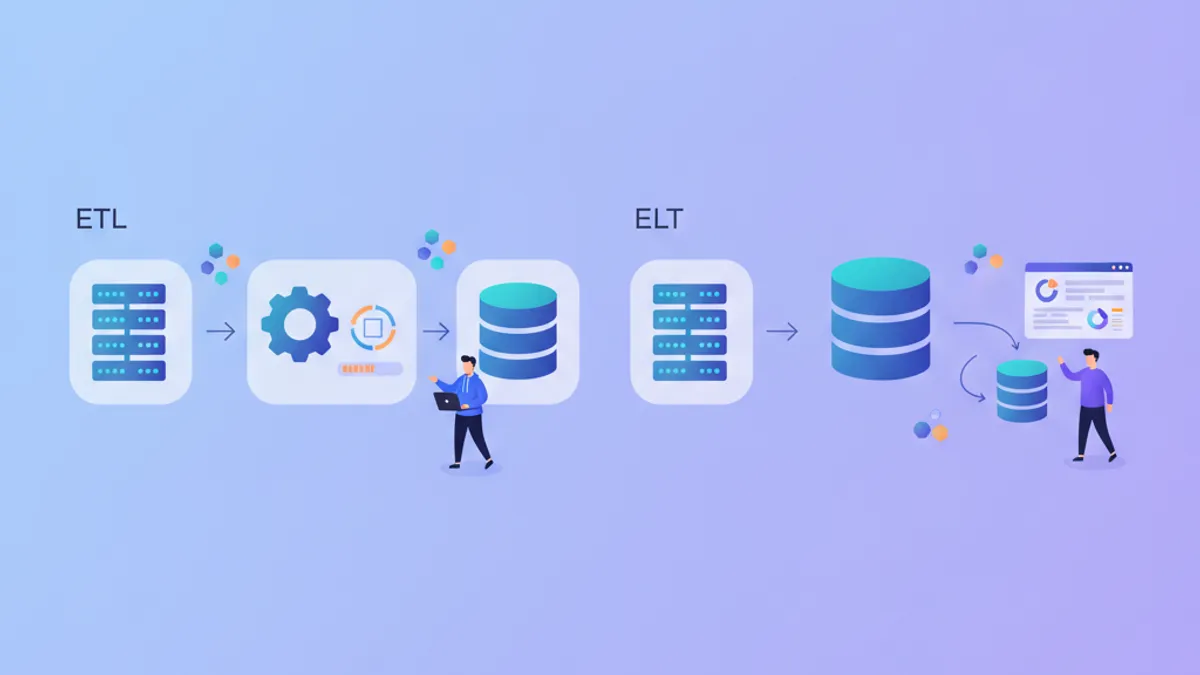
ETL vs ELT는 소스 시스템에서 분석 환경으로 데이터를 이동하는 방법을 정의합니다. 추출-변환-적재(ETL)와 추출-적재-변환(ELT) 중 어떤 것을 선택하느냐에 따라 인프라 비용, 데이터 신선도, 엔지니어링 팀에 필요한 기술이 달라집니다.
ETL은 대상 시스템에 적재하기 전에 데이터를 변환하므로 전용 컴퓨팅 리소스가 필요합니다. ELT는 원시 데이터를 먼저 적재한 후 대상 웨어하우스의 처리 능력을 사용하여 변환합니다. 2026년 대부분의 클라우드 네이티브 데이터 스택이 ELT를 선호하는 이유는 컴퓨팅이 온디맨드로 확장되기 때문입니다.
ETL 아키텍처: 적재 전 변환
ETL은 데이터 웨어하우스의 컴퓨팅 용량이 제한적이고 스토리지 비용이 높던 시절에 등장했습니다. 이 패턴은 합리적이었습니다. 웨어하우스 외부에서 데이터를 필터링하고 집계한 후, 분석에 필요한 것만 적재하는 방식입니다. Oracle Warehouse Builder, Informatica PowerCenter, Talend가 이 모델을 기반으로 도구를 구축했습니다.
ETL의 변환 단계는 중간 서버에서 실행됩니다. 데이터는 소스에서 스테이징 영역으로 이동하고, 정제 및 재구성된 후 대상에 적재됩니다. 이 접근 방식은 웨어하우스 부하를 줄이지만 변환 레이어에서 병목 현상을 만듭니다.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL은 변환 로직이 안정적이고 데이터 볼륨이 예측 가능할 때 잘 작동합니다. 단점은 요구 사항이 변경될 때 나타납니다. 변환을 수정한다는 것은 과거 데이터를 처음부터 재처리해야 함을 의미합니다.
ELT 아키텍처: 먼저 적재하고 웨어하우스에서 변환
ELT는 변환을 데이터 웨어하우스 내부로 이동시킵니다. Snowflake, BigQuery, Databricks, Redshift는 쿼리 복잡도에 따라 확장되는 거의 무제한의 컴퓨팅을 제공합니다. 원시 데이터를 먼저 적재하면 소스 상태가 보존되며, 변환은 버전 관리되고 재추출 없이 재실행할 수 있는 SQL 모델이 됩니다.
dbt(data build tool) 프로젝트는 SQL 변환을 코드로 취급하여 ELT를 대중화했습니다. 블랙박스 ETL 작업 대신, 변환은 원시 테이블을 참조하고 파생 모델을 구축하는 SELECT 문으로 버전 관리됩니다.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT는 원시 데이터를 보존하므로 비즈니스 로직이 변경될 때 재처리가 가능합니다. 6개월 전의 계산이 잘못되었다면, dbt 모델을 수정하고 전체 새로고침을 실행하면 과거 데이터가 수정됩니다. ETL의 경우, 동일한 수정을 위해 원본 레코드가 더 이상 존재하지 않을 수 있는 소스에서 재추출해야 합니다.
비교 표: ETL vs ELT 트레이드오프
| 요소 | ETL | ELT |
|---|---|---|
| 컴퓨팅 위치 | 전용 변환 서버 | 대상 웨어하우스 |
| 원시 데이터 보존 | 변환 후 폐기되는 경우가 많음 | 랜딩 존에 보존 |
| 재처리 비용 | 소스에서 재추출 | SQL 모델 재실행 |
| 스키마 유연성 | 변환 시점에 고정 | 스키마 온 리드 가능 |
| 도구 예시 | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| 적합한 경우 | 안정적인 요구사항, 레거시 시스템 | 변화하는 요구사항, 클라우드 웨어하우스 |
| 레이턴시 | 높음 (적재 전 변환) | 낮음 (적재 후 변환) |
| 데이터 거버넌스 | 용이함 (웨어하우스 전에 필터링) | 웨어하우스 수준 제어 필요 |
Data Engineering 면접 준비가 되셨나요?
인터랙티브 시뮬레이터, flashcards, 기술 테스트로 연습하세요.
하이브리드 접근 방식: ETL과 ELT의 결합
현대 데이터 스택은 순수 ETL이나 ELT를 사용하는 경우가 드뭅니다. Apache Airflow는 두 패턴을 결합한 파이프라인을 오케스트레이션합니다. 민감한 데이터는 적재 전에 익명화(ETL 단계)되고, 집계는 웨어하우스 내에서 실행(ELT)될 수 있습니다.
Fivetran과 Airbyte는 변환 없이 원시 데이터를 추출하고 적재한 후, dbt가 웨어하우스 내에서 변환을 수행합니다. 하지만 이러한 도구들은 추출 중 경량 변환도 지원합니다: 컬럼 선택, 데이터 타입 변환, PII 필드 해싱 등입니다. 이것이 ETL/ELT의 경계를 모호하게 만듭니다.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
위 파이프라인은 Airbyte로 Salesforce에서 추출하고(동기화 중 이메일 주소 해싱 가능), Snowflake에 적재한 후, 비즈니스 변환을 위해 dbt 모델을 실행합니다. 순수 ETL도 순수 ELT도 아니지만 실용적입니다.
면접 질문: 데이터 엔지니어를 위한 ETL vs ELT
현대 데이터 스택을 사용하는 기업의 데이터 엔지니어링 직무 기술 면접에서는 파이프라인 아키텍처에 대한 이해를 탐색합니다. ETL/ELT 면접 준비 모듈의 패턴을 기반으로, 이러한 질문이 자주 출제됩니다.
질문 1: ELT 대신 ETL을 선택하는 경우는 언제입니까?
우수한 답변은 구체적인 시나리오를 식별합니다:
- 규정 준수 요구사항: GDPR 또는 HIPAA에 의해 특정 데이터가 원시 형태로 웨어하우스에 도달해서는 안 된다고 규정됩니다. PII는 적재 전에 익명화하거나 제거해야 합니다.
- 레거시 웨어하우스 제약: 고정 컴퓨팅을 가진 Teradata나 오래된 Redshift 구성과 같은 온프레미스 시스템은 사전 집계된 적재의 이점을 얻습니다.
- 네트워크 비용: 매일 10TB를 클라우드 웨어하우스에 적재한 후 변환 후 90%를 폐기하는 것은 이그레스 대역폭 낭비입니다. 사전 필터링이 경제적으로 합리적입니다.
약한 답변은 "ETL은 구식"이라고 말하거나 구체적인 시나리오를 제시하지 못합니다. 면접관은 뉘앙스를 찾습니다.
질문 2: ELT 파이프라인에서 스키마 변경을 어떻게 처리합니까?
이것은 원시 데이터 랜딩 존에 대한 이해를 테스트합니다. 예상되는 주제:
- 스키마 마이그레이션 없이 새 필드를 흡수하는 JSON 또는 반정형 컬럼
- 컬럼을 명시적으로 선택하여 다운스트림 모델을 소스 변경으로부터 격리하는 스테이징 모델
- 예상 컬럼이 사라질 때 빌드를 실패시키는 dbt 매크로 또는 Dataform 어설션
- Monte Carlo나 Great Expectations와 같은 도구를 사용한 스키마 드리프트 모니터링
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
질문 3: Airflow로 ETL 오케스트레이션하는 것과 dbt로 ELT 실행하는 것을 비교해 주세요
이 질문은 이러한 도구들이 다른 문제를 해결한다는 이해를 탐색합니다:
- Airflow는 태스크를 오케스트레이션합니다: 추출, API 호출, 파일 전송, 모델 훈련. 이기종 작업 간의 종속성을 관리합니다.
- dbt는 웨어하우스 내에서 데이터를 변환합니다. SQL 모델 간의 종속성을 관리하고, 테스트를 실행하며, 문서를 생성합니다.
완전한 파이프라인은 종종 둘 다 사용합니다: Airflow가 Airbyte 동기화를 트리거하고, 완료를 기다린 후, dbt 실행을 트리거합니다. 어떤 도구를 언제 사용하는지 아는 것이 시니어 후보자를 구별합니다.
질문 4: ELT 파이프라인이 매일 5억 행을 처리하는데 분석가들이 쿼리 지연을 보고합니다
이 개방형 질문은 진단적 사고를 테스트합니다:
- 모델 구체화 확인: 무거운 모델이 아직 뷰입니까? 증분 모델이나 테이블이 도움이 될 수 있습니다.
- 파티션과 클러스터: BigQuery의 경우 팩트 테이블이 날짜로 파티션되어 있습니까? Snowflake의 경우 일반적인 쿼리 패턴에 최적화된 클러스터링입니까?
- 쿼리 푸시다운: 분석가들이 사전 집계된 마트 대신 스테이징 모델을 쿼리하고 있습니까?
- 웨어하우스 크기 조정: 쿼리 시간 동안 컴퓨팅이 적절하게 확장되고 있습니까?
- 신선도 요구사항: 변환을 업무 시간 대신 야간에 실행할 수 있습니까?
단일 정답은 없습니다. 면접관은 체계적인 문제 해결을 평가합니다.
2026년 도구 랜드스케이프
데이터 통합 시장은 몇 가지 패턴으로 통합되었습니다:
추출 및 적재: Fivetran, Airbyte, Stitch, Meltano가 EL 부분을 처리합니다. 이러한 도구는 수백 개의 소스에 연결하고 사용자 정의 코드 없이 클라우드 웨어하우스에 동기화합니다.
변환: dbt가 SQL 기반 변환을 지배합니다. 대안으로 Dataform(현재 Google Cloud의 일부), SQLMesh(가상 데이터 환경을 갖춘 오픈 소스), Coalesce(비주얼 모델링)가 있습니다.
오케스트레이션: Airflow는 복잡한 파이프라인의 기본으로 남아 있습니다. Dagster와 Prefect는 더 나은 로컬 개발과 자산 중심 뷰를 제공하는 대안입니다.
품질: Great Expectations, dbt 테스트, Monte Carlo, Soda가 데이터 품질 모니터링을 제공합니다. 이것들은 추출과 다운스트림 소비 사이의 문제를 감지합니다.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
연습을 시작하세요!
면접 시뮬레이터와 기술 테스트로 지식을 테스트하세요.
신규 프로젝트의 파이프라인 아키텍처 선택
2026년 대부분의 그린필드 프로젝트에서 ELT가 기본입니다. 클라우드 웨어하우스 컴퓨팅은 변환 서버 유지보다 비용이 적게 듭니다. 원시 데이터 보존은 소급 수정을 가능하게 합니다. SQL 기반 변환은 감사 가능하고 버전 관리됩니다.
ETL이 여전히 유효한 경우:
- 웨어하우스 진입 전 데이터 최소화를 요구하는 규제 환경
- 수집 시점에 변환이 필요한 실시간 스트리밍(Kafka Streams, Flink)
- 다운스트림 스토리지가 제한된 엣지 컴퓨팅 시나리오
- 소스 시스템이 내보내기 형식을 제어하는 레거시 통합
면접에 대비한 답변은 두 패턴을 모두 인정하고 이념적 편향 없이 트레이드오프를 설명합니다.
데이터 파이프라인 아키텍처 핵심 포인트
- ETL은 적재 전에 데이터를 변환하여 웨어하우스 부하를 줄이지만, 로직 변경 시 재처리 마찰을 발생시킵니다
- ELT는 원시 데이터를 먼저 적재하여 과거 데이터에 대해 버전 관리, 테스트, 재실행 가능한 SQL 기반 변환을 가능하게 합니다
- 현대 스택은 일반적으로 둘 다 결합합니다: 경량 추출 변환(PII 해싱, 타입 캐스팅)과 웨어하우스 기반 집계
- dbt는 ELT 변환의 표준이 되어 SQL 모델을 테스트 가능하고 문서화된 코드로 취급합니다
- 면접 질문은 정형화된 정의가 아닌 시나리오 선택, 스키마 진화 처리, 도구 트레이드오프를 탐색합니다
- ELT 파이프라인에서 원시 데이터 보존은 소스에서 재추출하지 않고도 과거 계산을 수정할 수 있게 합니다
Data Engineering 코드의 버그를 찾을 수 있나요
실제 코드 한 조각, 숨은 버그 하나, 하루 한 번. 계정 없이 바로 도전할 수 있습니다.
작성자
Anthony Fillion-MailletSharpSkill 창업자
10년 이상 풀스택 개발을 해왔습니다. SharpSkill을 운영하며 이곳에 게시되는 모든 내용에 책임을 집니다.
2026년 9월 14일 업데이트
태그
공유
관련 기사
2026 ETL vs ELT 완벽 비교: 데이터 파이프라인 아키텍처 설계 가이드
2026년 ETL과 ELT의 핵심 차이점, 비용 분석, 구현 패턴을 상세히 비교합니다. dbt, Airflow를 활용한 실전 데이터 파이프라인 설계 방법을 알아보세요.

dbt 2026 완벽 가이드: 데이터 변환, 테스트 전략, 면접 질문 총정리
dbt를 활용한 데이터 변환의 핵심 개념부터 실무까지, 레이어드 모델링, 인크리멘탈 전략, 테스트 방법론, 그리고 2026년 데이터 엔지니어링 면접에서 자주 출제되는 질문을 코드 예제와 함께 상세히 다룹니다.
Apache Spark와 Python으로 데이터 파이프라인 구축하기: 단계별 실전 가이드
PySpark을 활용한 실전 데이터 파이프라인 구축 튜토리얼입니다. DataFrame 연산, ETL 파이프라인 설계, Spark 4.0의 주요 기능을 프로덕션 수준의 코드 예제와 함께 설명합니다. 데이터 엔지니어 기술 면접 준비에도 도움이 됩니다.