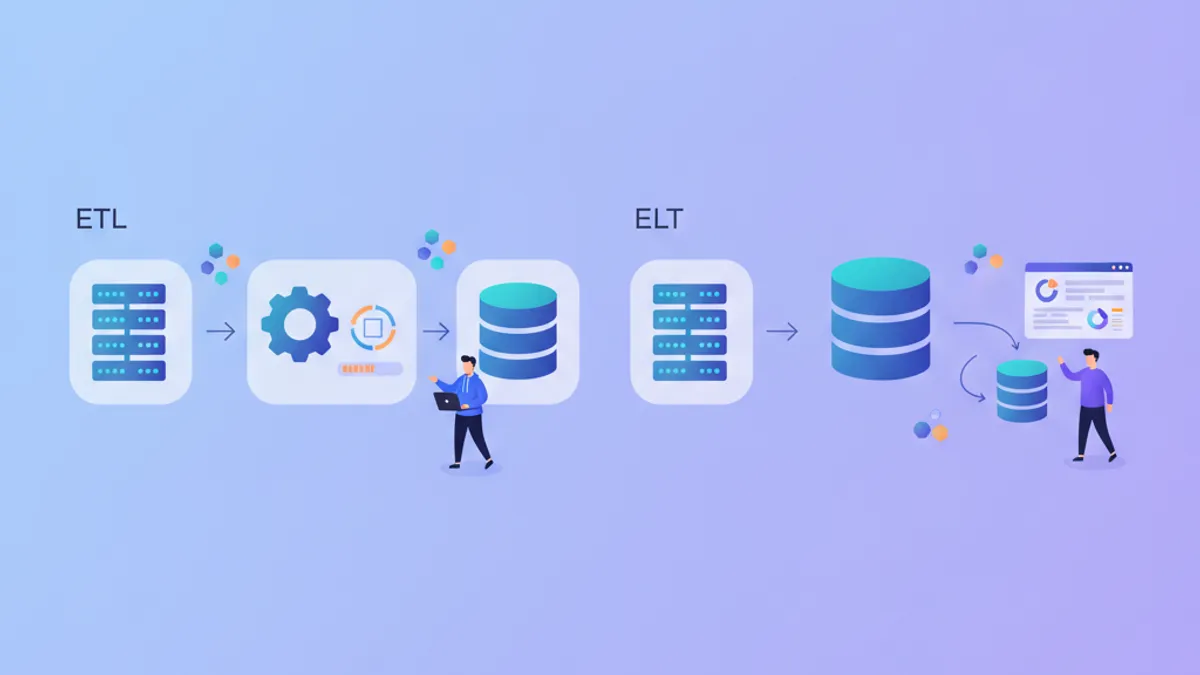
ETL vs ELT 2026: 데이터 파이프라인 아키텍처 심층 분석 및 면접 대비
ETL과 ELT의 차이점, 아키텍처, 사용 사례, 최신 도구, 데이터 엔지니어 면접 빈출 질문에 대해 알아봅니다.
데이터 생산 체인 전체를 다루는 포괄적인 Data Engineering 커리큘럼입니다. Docker와 GCP를 활용한 환경 설정부터 Airflow와 dbt를 활용한 파이프라인 오케스트레이션, BigQuery와 PostgreSQL을 활용한 Data Warehouse 구축까지 학습합니다. PySpark, Pub/Sub, Apache Beam을 활용한 데이터 스트리밍과 Kubernetes, Terraform을 활용한 프로덕션 배포를 마스터합니다. CI/CD, 모니터링, 현대적 데이터 아키텍처의 모범 사례를 습득합니다.
개발 환경: Linux, Git, GitHub, VS Code, 고급 Python
CI/CD와 코드 품질: Ruff, Pylint, Poetry, GitHub Actions
Docker와 Docker Compose를 활용한 컨테이너화
FastAPI를 활용한 API: 설계, 배포, 문서화
Data Lake: 수집, 저장, 원시 데이터 정리
BigQuery를 활용한 Data Warehouse: 스키마, 파티셔닝, 최적화
PostgreSQL: 설정, 관리, 매니지드 솔루션과의 비교
Fivetran과 Airbyte를 활용한 데이터 수집
dbt를 활용한 변환: models, tests, 문서화, 모듈성
Apache Airflow를 활용한 오케스트레이션: DAGs, 스케줄링, 모니터링
PySpark를 활용한 빅데이터: 대규모 변환
데이터 스트리밍: Google Pub/Sub, Apache Beam, Dataflow
Kubernetes: 컨테이너 배포, 스케일링, 프로덕션 클러스터
Terraform을 활용한 Infrastructure as Code
고급 데이터베이스: GraphDB, Document DBs, Wide Column DBs
로깅, 모니터링, 파이프라인 관측성
이 기술을 이해하고 면접에서 성공하기 위한 가장 중요한 개념
Linux과 Shell: 필수 명령어, bash 스크립팅, 권한, cron jobs
Git과 GitHub: branching, merge, rebase, pull requests, CI/CD 워크플로
고급 Python: OOP, 데코레이터, 제너레이터, 컨텍스트 매니저, typing, async/await
CI/CD: linting (Ruff, Pylint), packaging (Poetry), tests, GitHub Actions, pipelines
Docker: Dockerfile, 이미지, 컨테이너, volumes, networks, multi-stage builds
Docker Compose: 멀티 컨테이너 서비스, 의존성, healthchecks, 로컬 오케스트레이션
FastAPI: 라우트, Pydantic 모델, 의존성, middleware, 배포
고급 SQL: window functions, CTEs, 분석 쿼리, 최적화, 인덱싱
BigQuery: 서버리스 아키텍처, 파티셔닝, 클러스터링, 비용, UDFs, federated queries
PostgreSQL: 설정, 복제, 인덱싱 (B-tree, GIN, GiST), VACUUM, EXPLAIN ANALYZE
데이터 모델링: 스타 스키마, 팩트/디멘션 테이블, 정규화, SCD, data vault
ELT vs ETL vs ETLT: 패턴, 트레이드오프, 아키텍처 선택
Fivetran과 Airbyte: 커넥터, 동기화 모드, CDC, 스키마 진화
dbt: models, sources, refs, tests, snapshots, incremental models, Jinja macros
Apache Airflow: DAGs, operators, sensors, XCom, connections, pools, 태스크 의존성
PySpark: RDD vs DataFrame, 변환, 액션, 파티셔닝, broadcast variables
스트리밍: Pub/Sub (topics, subscriptions), Apache Beam (PCollections, transforms, windowing), Dataflow
Kubernetes: pods, deployments, services, ingress, ConfigMaps, Secrets, Helm, scaling
Terraform: providers, resources, state, modules, plan/apply, infrastructure as code
IAM과 보안: 최소 권한 원칙, service accounts, GCP 역할
NoSQL 데이터베이스: GraphDB (Neo4j), Document DBs (MongoDB, Firestore), Wide Column (Cassandra, Bigtable)
데이터 아키텍처: Data Lake vs Data Warehouse vs Data Lakehouse, Data Mesh, Data Contracts
모니터링과 관측성: 로깅, 메트릭, 알림, SLA/SLO/SLI, 데이터 품질 체크
하루 한 개의 코드. 버그를 찾거나, 버그가 없음을 증명하세요.
정규직과 프리랜서, 국가, 원격, 공개된 경우 급여까지. 매일 업데이트, 구독자 전용.
Data Engineering에 관한 최신 기사와 가이드를 확인하세요
ETL과 ELT의 차이점, 아키텍처, 사용 사례, 최신 도구, 데이터 엔지니어 면접 빈출 질문에 대해 알아봅니다.
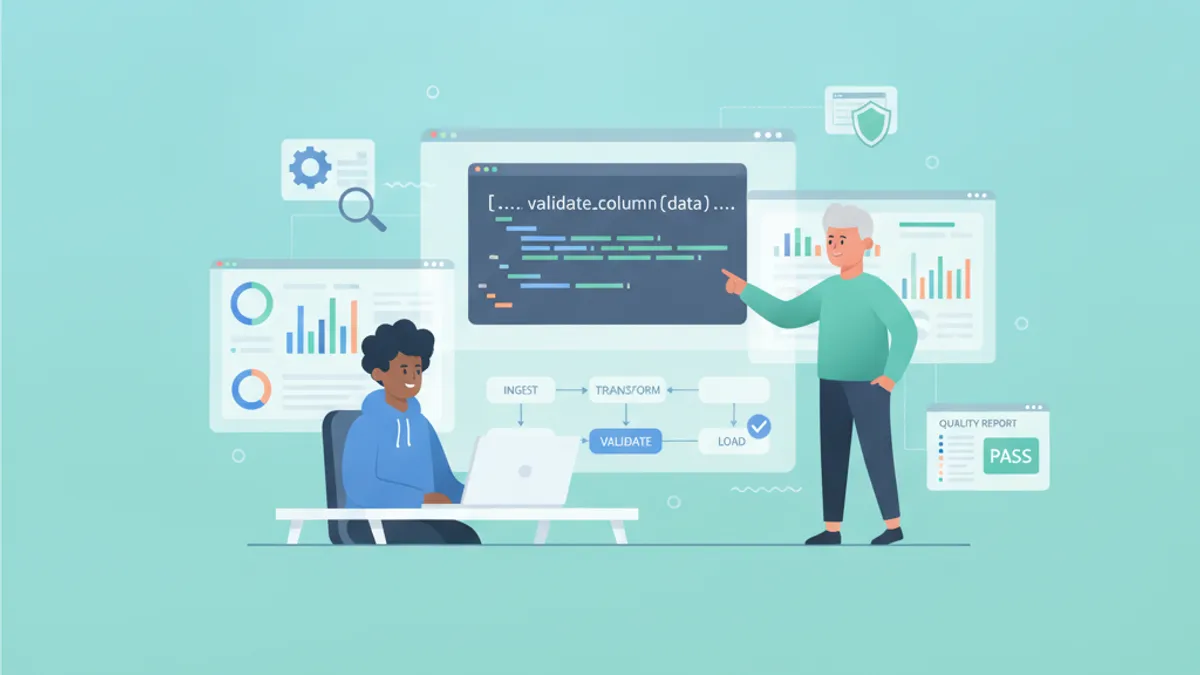
Great Expectations(GX)를 활용한 데이터 품질 검증의 실용적인 가이드입니다. 프로덕션 파이프라인에서의 구현 방법부터 데이터 엔지니어 면접에서 자주 나오는 질문까지 2026년 최신 정보를 다룹니다.
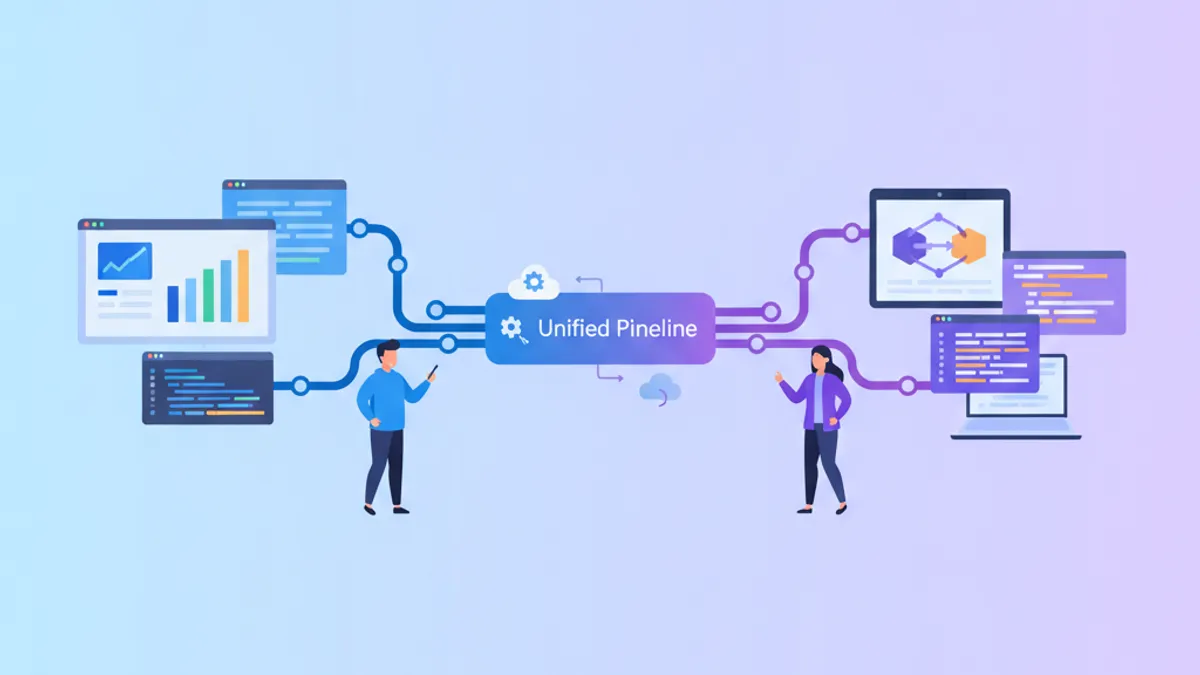
Apache Beam 2.76과 Spark 4.2를 철저히 비교합니다. 이식성, 윈도우 처리, 성능 차이를 분석하고 데이터 엔지니어링 면접에서 자주 출제되는 질문과 모범 답변을 제공합니다.