Service Objects Rails en 2026 : Design Patterns, PORO et Questions d'Entretien Technique
Les service objects Rails permettent d'extraire la logique métier des contrôleurs et modèles vers des classes Ruby simples. Ce guide couvre les patterns de conception, les implémentations PORO et les questions d'entretien technique les plus courantes.
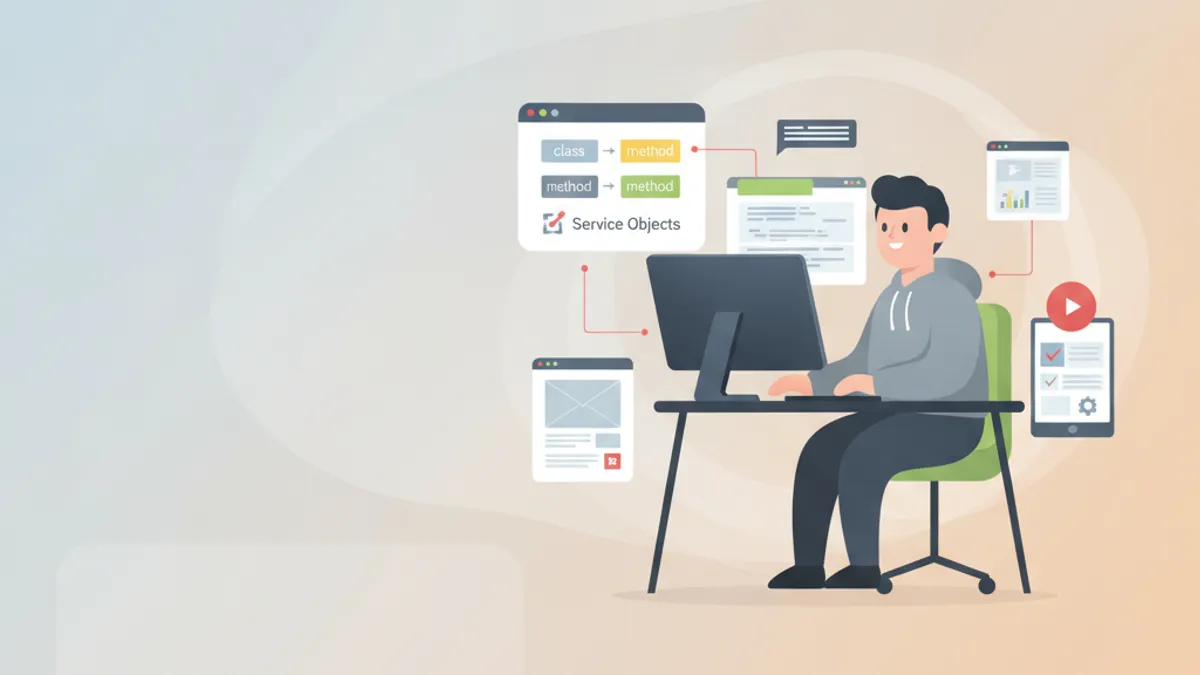
Les service objects Rails extraient la logique métier des contrôleurs et des modèles vers des Plain Old Ruby Objects (POROs). Ce pattern maintient les applications Rails maintenables à mesure qu'elles grandissent, et les recruteurs le testent fréquemment pour évaluer la compréhension des candidats en matière d'architecture propre.
Un service object encapsule une opération métier unique. La classe possède une seule méthode publique (généralement call), accepte les dépendances via son constructeur, et retourne un résultat prévisible. Les candidats capables d'expliquer pourquoi cela importe, pas seulement comment l'implémenter, se démarquent.
Pourquoi les Service Objects Résolvent les Problèmes de Fat Model et Fat Controller
Rails encourage à placer la logique quelque part. Sans orientation claire, les équipes la poussent dans les modèles ("fat models, skinny controllers") jusqu'à ce que les classes ActiveRecord atteignent des milliers de lignes. D'autres la laissent dans les contrôleurs, rendant les actions impossibles à tester isolément.
Les service objects offrent une troisième voie : la logique métier réside dans des classes dédiées qui ne dépendent de rien de Rails sauf ce qu'elles requièrent explicitement. Ce découplage rend le code testable sans charger le framework complet, portable à travers différents points d'entrée (contrôleurs, jobs en arrière-plan, console), et lisible car chaque classe fait une seule chose.
Les Rails Guides ne prescrivent pas les service objects, mais la communauté s'est standardisée autour du pattern. L'accent de Rails 8 sur la simplicité, avec Solid Queue et Solid Cache remplaçant les dépendances externes, rend les POROs encore plus attractifs : moins de gems, plus de Ruby pur.
Anatomie d'un Service Object Prêt pour la Production
Un service object nécessite trois éléments : un constructeur qui reçoit les dépendances, une seule méthode publique call, et un type de retour qui signale le succès ou l'échec.
# app/services/users/create_account.rb
module Users
  class CreateAccount
    def initialize(user_repo: User, mailer: UserMailer)
      @user_repo = user_repo
      @mailer = mailer
    end

    def call(params)
      user = @user_repo.new(params)
      return Result.failure(:validation_failed, user.errors) unless user.valid?

      user.save!
      @mailer.welcome_email(user).deliver_later
      Result.success(user)
    rescue ActiveRecord::RecordNotUnique
      Result.failure(:email_taken, "Email already registered")
    end
  end
end
Le constructeur accepte user_repo et mailer avec des valeurs par défaut. Le code de production utilise les valeurs par défaut ; les tests injectent des mocks. La méthode call valide, persiste, envoie un email, et encapsule chaque résultat dans un objet Result.
Construire une Classe Result Minimale Sans Gem
Certaines équipes adoptent immédiatement dry-monads. La gem est solide, mais ajoute une courbe d'apprentissage. Une classe Result de 30 lignes couvre la plupart des besoins :
# app/services/result.rb
class Result
  attr_reader :value, :error, :code

  def initialize(success:, value: nil, error: nil, code: nil)
    @success = success
    @value = value
    @error = error
    @code = code
  end

  def success? = @success
  def failure? = !@success

  def self.success(value) = new(success: true, value: value)
  def self.failure(code, error = nil) = new(success: false, code: code, error: error)

  def on_success
    yield(value) if success?
    self
  end

  def on_failure
    yield(code, error) if failure?
    self
  end
end
Ce Result supporte le chaînage avec on_success et on_failure, expose des codes d'erreur structurés, et ne requiert aucune dépendance. Les contrôleurs le consomment proprement :
# app/controllers/users_controller.rb
class UsersController < ApplicationController
  def create
    result = Users::CreateAccount.new.call(user_params)

    result
      .on_success { |user| redirect_to user, notice: "Account created" }
      .on_failure { |code, error| render :new, status: :unprocessable_entity }
  end

  private

  def user_params
    params.require(:user).permit(:email, :password, :name)
  end
endLes équipes utilisant déjà l'écosystème dry-rb, ou celles nécessitant la notation Do pour chaîner plusieurs opérations, bénéficient de dry-monads. La gem fournit les types Success, Failure et Maybe avec support du pattern matching en Ruby 3.x.
Conventions de Nommage qui Signalent l'Intention
Deux conventions dominent :
| Style | Exemple | Quand l'utiliser |
|---|---|---|
| Phrase verbale | CreateAccount, SendInvoice, RefundPayment | Commandes qui changent l'état |
| Nom avec -or | AccountCreator, InvoiceSender, PaymentRefunder | Moins courant, certaines équipes préfèrent |
Le style phrase verbale se lit naturellement : Users::CreateAccount.new.call(params). Le suffixe -or fonctionne mais ajoute des syllabes sans clarté.
La structure des répertoires compte aussi. Grouper par domaine garde les services liés ensemble :
app/services/
  users/
    create_account.rb
    reset_password.rb
    update_profile.rb
  orders/
    place_order.rb
    cancel_order.rb
    calculate_total.rb
  payments/
    process_payment.rb
    refund_payment.rb
Cette organisation permet de trouver instantanément la logique liée à un domaine. L'alternative, un répertoire plat avec des préfixes (user_create_account.rb), devient ingérable au-delà de 20 fichiers.
Injection de Dépendances pour des Tests Isolés
Les constructeurs des service objects acceptent des collaborateurs avec des valeurs par défaut. Cette technique permet aux tests de remplacer les dépendances lentes ou à effets de bord :
# spec/services/users/create_account_spec.rb
RSpec.describe Users::CreateAccount do
  describe "#call" do
    let(:fake_repo) { class_double(User) }
    let(:fake_mailer) { class_double(UserMailer) }
    let(:service) { described_class.new(user_repo: fake_repo, mailer: fake_mailer) }

    context "with valid params" do
      let(:user) { instance_double(User, valid?: true, save!: true) }
      let(:mail) { double(deliver_later: true) }

      before do
        allow(fake_repo).to receive(:new).and_return(user)
        allow(fake_mailer).to receive(:welcome_email).and_return(mail)
      end

      it "returns success with the user" do
        result = service.call(email: "test@example.com")

        expect(result).to be_success
        expect(result.value).to eq(user)
      end

      it "sends the welcome email" do
        service.call(email: "test@example.com")

        expect(fake_mailer).to have_received(:welcome_email).with(user)
      end
    end

    context "with invalid params" do
      let(:user) { instance_double(User, valid?: false, errors: { email: ["invalid"] }) }

      before { allow(fake_repo).to receive(:new).and_return(user) }

      it "returns failure with validation errors" do
        result = service.call(email: "invalid")

        expect(result).to be_failure
        expect(result.code).to eq(:validation_failed)
      end
    end
  end
end
Ces tests s'exécutent en millisecondes car ils n'instancient jamais de vrais modèles ActiveRecord ni n'envoient d'emails. Le code de production utilise les valeurs par défaut, donc aucune configuration n'est nécessaire en dehors des tests.
Composer Plusieurs Services pour des Opérations Complexes
Les opérations complexes enchaînent plusieurs services. Une transaction e-commerce pourrait impliquer la validation de l'inventaire, le traitement du paiement et la notification de l'expédition. Composer ces services garde chaque pièce testable :
# app/services/orders/checkout.rb
module Orders
  class Checkout
    def initialize(
      inventory_checker: Inventory::CheckAvailability.new,
      payment_processor: Payments::ProcessPayment.new,
      notifier: Notifications::SendOrderConfirmation.new
    )
      @inventory_checker = inventory_checker
      @payment_processor = payment_processor
      @notifier = notifier
    end

    def call(order)
      inventory_result = @inventory_checker.call(order.items)
      return inventory_result if inventory_result.failure?

      payment_result = @payment_processor.call(order.payment_details)
      return payment_result if payment_result.failure?

      order.complete!
      @notifier.call(order)
      Result.success(order)
    end
  end
end
Chaque service interne gère sa propre logique et retourne un Result. Le service parent retourne tôt si une étape échoue, évitant les callbacks imbriqués ou la gestion complexe des exceptions.
Questions d'Entretien Technique Courantes
Les recruteurs explorent la compréhension des service objects à travers des questions situationnelles. Voici les thèmes les plus courants avec des réponses solides :
Question : Quand devrait-on utiliser un service object plutôt qu'une méthode de modèle ?
Utiliser un service object quand l'opération implique plusieurs modèles, a des effets de bord (emails, APIs tierces), ou contient une logique métier qui n'appartient pas au cycle de vie d'un seul enregistrement. Les méthodes de modèle conviennent pour des requêtes simples ou des validations spécifiques à cet enregistrement.
Question : Comment tester les service objects qui interagissent avec des APIs externes ?
Injecter le client HTTP ou le wrapper API via le constructeur. En tests, fournir un double qui retourne des réponses prédéfinies. Ce design évite les appels réseau et permet de tester les chemins d'erreur sans déclencher de vraies pannes.
Question : Que devrait retourner un service object ?
Un objet typé qui représente succès ou échec. Les approches courantes incluent une classe Result personnalisée, dry-monads, ou même un simple struct avec un flag booléen et une payload. Le pire choix est de retourner des valeurs mixtes (parfois un modèle, parfois nil, parfois une exception), car les appelants ne peuvent pas gérer les résultats de manière cohérente.
Question : Comment les service objects gèrent-ils les transactions de base de données ?
Encapsuler le bloc ActiveRecord::Base.transaction à l'intérieur de la méthode call. Si plusieurs services doivent partager une transaction, passer le bloc transaction en argument ou utiliser un service orchestrateur qui gère les limites de transaction :
# app/services/orders/process_with_transaction.rb
module Orders
  class ProcessWithTransaction
    def call(order)
      ActiveRecord::Base.transaction do
        Inventory::Reserve.new.call(order.items).tap { |r| raise ActiveRecord::Rollback if r.failure? }
        Payments::Charge.new.call(order).tap { |r| raise ActiveRecord::Rollback if r.failure? }
        order.confirm!
        Result.success(order)
      end
    rescue ActiveRecord::Rollback
      Result.failure(:transaction_failed)
    end
  end
end
Éviter les Erreurs Courantes
Les équipes nouvelles aux service objects font souvent ces erreurs :
Créer des service objects pour tout. Tous les bouts de logique n'ont pas besoin de leur propre classe. Un callback de modèle simple ou un scope est parfois la bonne réponse. Le sur-engineering fragmenté la logique tellement que personne ne peut suivre le flux.
Exposer plusieurs méthodes publiques. Un service object devrait avoir une seule méthode publique, call. Plusieurs méthodes suggèrent que la classe gère plusieurs responsabilités et devrait être divisée.
Ignorer la gestion des erreurs. Retourner nil ou lever des exceptions brutes force les appelants à deviner ce qui a mal tourné. Le pattern Result rend les chemins d'échec explicites et le code appelant plus propre.
Coder en dur les dépendances. Appeler User.find ou UserMailer.welcome_email directement à l'intérieur des méthodes empêche la substitution de tests et couple le service à des classes concrètes.
Prêt à réussir tes entretiens Ruby on Rails ?
Entraîne-toi avec nos simulateurs interactifs, fiches express et tests techniques.
Organiser les Service Objects dans les Applications Plus Grandes
À mesure que les applications grandissent, les équipes ont besoin de conventions supplémentaires :
Services avec espace de noms par domaine. Users::CreateAccount et Billing::CreateInvoice gardent les contextes séparés. Les équipes construisant des architectures modulaires (comme Packwerk) mappent naturellement les espaces de noms aux packages.
Classes de base partagées avec précaution. Un ApplicationService qui fournit des helpers logging ou des raccourcis de transaction peut aider, mais l'héritage devient un fardeau si la classe de base grossit. Préférer les modules ou la composition.
Cohérence du pattern Result. Choisir un style Result et l'utiliser partout. Mélanger dry-monads, des classes Result personnalisées et des retours booléens force les appelants à vérifier plusieurs formats.
Performance et Scaling
Les service objects n'ajoutent pas de surcharge significative. Les appels de méthode Ruby sont rapides, et les allocations d'objets pour les petites classes sont triviales. Les vrais coûts de performance viennent de ce que les services font, pas du pattern lui-même.
Pour les opérations de haute fréquence, considérer :
Réutilisation des instances de service. Plutôt que Users::CreateAccount.new.call(params) dans une boucle serrée, instancier une fois et appeler plusieurs fois si le service est sans état.
Mise en cache des dépendances. Si un service crée des connexions coûteuses (pools de bases de données, clients HTTP), les passer depuis le code appelant plutôt que de les créer frais à chaque appel.
Background jobs pour les effets de bord. Déplacer les emails, webhooks et autres opérations lentes vers des jobs en arrière-plan. Le service devient responsable de la mise en queue du job, pas d'exécuter l'effet de bord directement.
Intégration avec les Jobs Background de Rails 8
Solid Queue de Rails 8 fonctionne parfaitement avec les service objects. Le job encapsule l'appel du service, gardant la logique métier séparée de la mécanique de mise en queue :
# app/jobs/process_order_job.rb
class ProcessOrderJob < ApplicationJob
  queue_as :default

  def perform(order_id)
    order = Order.find(order_id)
    result = Orders::Process.new.call(order)

    if result.failure?
      Rails.logger.error("Order processing failed: #{result.code}")
      raise result.error if result.code == :retriable_error
    end
  end
end
La logique de retry du job gère les échecs transitoires. Le service object reste concentré sur le traitement de la commande, pas sur la gestion de la queue.
Conclusion
Les service objects apportent structure et testabilité aux applications Rails sans introduire de complexité inutile. Le pattern encapsule la logique métier dans des POROs qui acceptent des dépendances, retournent des résultats structurés, et font une seule chose bien.
Les candidats en entretien technique qui peuvent expliquer non seulement comment implémenter les service objects, mais aussi pourquoi le pattern améliore la maintenabilité, démontrent la maturité architecturale que les équipes recherchent. Les exemples de code présentés ici fournissent une base pour construire et discuter des service objects en production.
La clé est la cohérence : choisir des conventions de nommage, adopter un pattern Result, injecter les dépendances, et appliquer ces choix à travers la base de code. Les applications Rails les plus maintenables ne sont pas celles avec les abstractions les plus intelligentes, mais celles où chaque service object suit les mêmes règles prévisibles.
Tu saurais repérer le bug en Ruby on Rails ?
Un vrai bout de code, un bug caché, une tentative par jour. Sans compte pour essayer.

Écrit par
Anthony Fillion-MailletFondateur de SharpSkill
Développeur fullstack depuis plus de 10 ans. Il dirige SharpSkill et répond de tout ce qui y est publié.
Mis à jour le 20 août 2026
Tags
Partager
Articles similaires
Jobs en arrière-plan Rails en 2026 : Sidekiq vs Good Job et questions d'entretien
Comparaison approfondie entre Sidekiq, Good Job et Solid Queue pour les tâches asynchrones Rails, avec les questions techniques posées en entretien.
Questions d'entretien Ruby on Rails : Top 25 en 2026
Les 25 questions d'entretien Ruby on Rails les plus posées. Architecture MVC, Active Record, migrations, tests RSpec, API REST avec réponses détaillées et exemples de code.
API GraphQL avec Rails en 2026 : graphql-ruby, Subscriptions et Questions d'Entretien
Construire une API GraphQL prête pour la production avec Rails 8 et graphql-ruby. Conception de schéma, mutations, subscriptions avec ActionCable et préparation aux entretiens.