Missions freelance data scientist en 2026 : où trouver des contrats, TJM et préparation
Guide complet pour les data scientists freelance en 2026 : plateformes de missions, TJM moyens, compétences recherchées et préparation aux entretiens techniques.
Parcours complet en Data Science et Machine Learning avec Python comme langage principal. De la manipulation de données avec Pandas et NumPy à l'implémentation de modèles de Deep Learning avec TensorFlow/Keras, en passant par le ML classique avec Scikit-Learn. Inclut également les compétences MLOps pour déployer et maintenir des modèles en production avec Docker, FastAPI et les plateformes cloud.
Python moderne avec programmation orientée objet et bonnes pratiques
Manipulation de données avec Pandas, NumPy et SQL (BigQuery)
Visualisation avec Matplotlib, Seaborn et Plotly
Statistiques descriptives et inférentielles avec Statsmodel
Machine Learning avec Scikit-Learn et XGBoost (régression, classification, clustering)
Deep Learning avec TensorFlow et Keras (CNN, RNN, Transformers)
NLP et GenAI avec Hugging Face, LangChain et LLMs (GPT, Gemini)
MLOps avec MLflow, Docker, FastAPI et Streamlit
Environnements de développement : Jupyter, Google Colab
Déploiement cloud avec Google Compute, Cloud Storage et GPU
Les concepts les plus importants pour comprendre cette techno et réussir tes entretiens
Python : types, structures de données, POO, décorateurs, générateurs, context managers
NumPy : arrays, broadcasting, indexation, opérations vectorisées, algèbre linéaire
Pandas : DataFrames, Series, indexation, groupby, merge, pivot, time series
SQL : SELECT, JOIN, GROUP BY, window functions, CTEs, optimisation de requêtes
Visualisation : Matplotlib (figures, axes, subplots), Seaborn (statistical plots), Plotly (interactif)
Statistiques : distributions, tests d'hypothèse, intervalles de confiance, régression
Feature Engineering : encoding, scaling, feature selection, feature creation
ML Supervised : régression linéaire/logistique, arbres, Random Forest, XGBoost, métriques
ML Unsupervised : K-Means, clustering hiérarchique, PCA, t-SNE
Pipeline ML : train/test split, cross-validation, hyperparameter tuning, overfitting
Deep Learning : perceptrons, backpropagation, activation functions, optimizers, loss functions
CNN : convolutions, pooling, architectures (ResNet, VGG), transfer learning
RNN/LSTM : séquences, vanishing gradient, attention mechanism, Transformers
NLP : tokenization, embeddings, word2vec, BERT, fine-tuning LLMs
MLOps : versioning (MLflow), containerisation (Docker), API (FastAPI), monitoring
Cloud : Google Cloud (Compute, Storage, BigQuery), GPU training, Vertex AI
Éthique IA : biais, explicabilité (SHAP, LIME), fairness, RGPD
Un extrait par jour. Trouve le bug, ou prouve qu'il n'y en a pas.
CDI et freelance, avec pays, remote et salaire quand il est publié. Mises à jour tous les jours, réservées aux abonnés.
Découvre nos derniers articles et guides sur Data Science & ML
Guide complet pour les data scientists freelance en 2026 : plateformes de missions, TJM moyens, compétences recherchées et préparation aux entretiens techniques.
Panorama complet du marché de l'emploi data scientist en 2026. Canaux de recherche, fourchettes de salaires actualisées, compétences recherchées et conseils de préparation aux entretiens techniques.
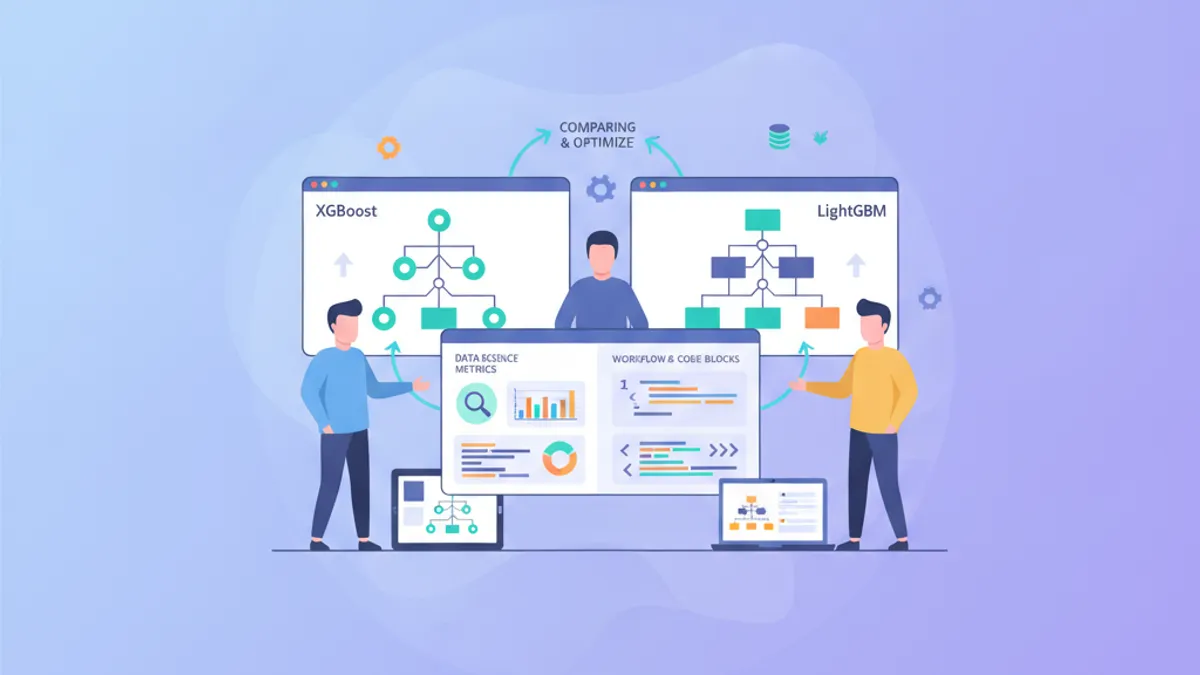
Maîtrisez XGBoost et LightGBM pour réussir vos entretiens en data science. Comparez les algorithmes de gradient boosting, apprenez l'optimisation des hyperparamètres et préparez-vous aux questions techniques avec des exemples Python.