Créer un blog C# en 2026 : blog technique avec ASP.NET Core et Minimal APIs
Construire un blog C# sous .NET 10 avec les Minimal APIs d'ASP.NET Core : articles Markdown avec front matter, magasin thread-safe rechargé à chaud, pages Razor, cache de sortie et flux RSS.
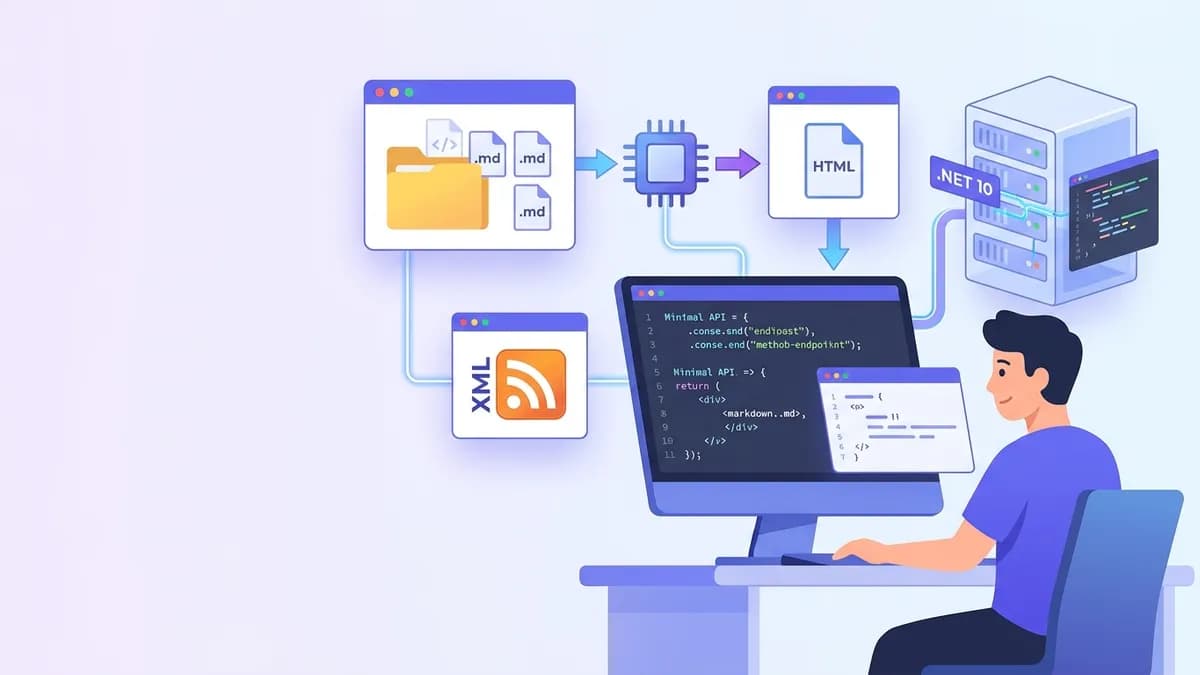
Un blog C# construit sur les Minimal APIs d'ASP.NET Core tient en quelques fichiers : des articles Markdown sur le disque, un magasin singleton qui les analyse une seule fois, quelques endpoints qui produisent du HTML et un flux RSS. Avec .NET 10, la version LTS sortie en novembre 2025, chaque brique de cette pile vient du framework ou de deux paquets NuGet bien maintenus. Aucun CMS, aucune base de données.
Un projet web .NET 10, Markdig pour convertir le Markdown en HTML, YamlDotNet pour l'en-tête des articles, un magasin d'articles immuable en mémoire rechargé à chaque modification de fichier, des endpoints Minimal API qui renvoient des pages RazorComponentResult, un cache de sortie avec éviction par tag et un flux RSS 2.0 généré par System.ServiceModel.Syndication. Le moteur complet reste sous la barre des 300 lignes de C#.
Pourquoi un moteur de blog en Minimal API plutôt qu'un générateur de site statique
Hugo, Jekyll et les autres générateurs statiques produisent des fichiers HTML au moment du build. Ils sont rapides et peu coûteux à héberger. En revanche, tout ce qui dépasse le gabarit (publication programmée, API JSON pour une application mobile, flux par tag, points d'accroche pour la mesure d'audience) passe par des plugins écrits dans un langage que le développeur .NET ne pratique pas au quotidien.
Un blog ASP.NET Core conserve le contenu sous forme de fichiers Markdown versionnés dans Git, les transforme en HTML à la première requête, puis sert le résultat depuis la mémoire. Avec un cache de sortie devant, le coût d'une requête se rapproche de celui d'un fichier statique, et le code exécuté reste du C# ordinaire, que l'on débogue, teste et étend sans changer d'outil. Le projet a un autre avantage : il touche à l'injection de dépendances, au pipeline de requêtes, au cache et à la concurrence, c'est-à-dire aux sujets qui reviennent dans un entretien technique .NET.
| Critère | Générateur de site statique | Blog ASP.NET Core en Minimal API |
|---|---|---|
| Format du contenu | Markdown + front matter | Markdown + front matter |
| Moment du rendu | Au build | À la première requête, puis en cache |
| Logique sur mesure | Plugins, gabarits | Endpoints C# classiques |
| Hébergement | Hébergeur statique ou CDN | Conteneur, App Service, n'importe quel VPS |
| Mise à jour du contenu | Rebuild et redéploiement | Le surveillant de fichiers recharge le magasin |
Créer le projet de blog ASP.NET Core sous .NET 10
Le point de départ est le modèle web vide. dotnet new web crée un projet basé sur le SDK Microsoft.NET.Sdk.Web, qui compile les composants .razor sans configuration supplémentaire. Trois paquets complètent l'ensemble : Markdig pour l'analyse CommonMark, YamlDotNet pour l'en-tête YAML et System.ServiceModel.Syndication pour le flux.
# terminal
dotnet new web -n CSharpBlog --framework net10.0
cd CSharpBlog
dotnet add package Markdig
dotnet add package YamlDotNet
dotnet add package System.ServiceModel.Syndication
mkdir posts Posts Endpoints Components
Tout se branche dans Program.cs. Le magasin d'articles est enregistré en singleton, puisque les articles analysés sont partagés par toutes les requêtes. Le middleware de cache de sortie est placé avant les endpoints, de sorte qu'une réponse en cache court-circuite totalement l'exécution du handler.
var builder = WebApplication.CreateBuilder(args);

// Site settings bound from the "Blog" section of appsettings.json
builder.Services.Configure<BlogOptions>(builder.Configuration.GetSection("Blog"));

builder.Services.AddSingleton<PostStore>();   // one parsed snapshot shared by all requests
builder.Services.AddRazorComponents();        // enables RazorComponentResult rendering
builder.Services.AddOpenApi();                // OpenAPI 3.1 document for the JSON API
builder.Services.AddOutputCache(options =>
    options.AddBasePolicy(policy => policy.Expire(TimeSpan.FromHours(1))));

var app = builder.Build();

app.MapStaticAssets();   // CSS and images from wwwroot, fingerprinted since .NET 9
app.UseOutputCache();    // must run before the endpoints it caches
app.MapOpenApi();

app.MapBlogEndpoints();
app.MapFeedEndpoints();

app.Run();

public sealed class BlogOptions
{
    public string Title { get; set; } = "C# Notes";
    public string SiteUrl { get; set; } = "https://localhost:5001/";
}
Le paramètre SiteUrl a son importance pour la suite : les liens canoniques et les adresses du flux sont construits à partir de la configuration, jamais à partir de l'en-tête Host de la requête entrante.
Analyser des articles Markdown avec front matter en C#
Chaque article est un fichier comme posts/output-caching-dotnet-10.md. Le nom du fichier sert de slug, et un bloc YAML en tête porte les métadonnées :
---
title: Output caching in .NET 10
summary: How tag-based eviction keeps cached pages fresh.
date: 2026-11-10
tags: [aspnet-core, performance]
draft: false
---
Output caching stores the full response on the server...
Le parseur isole le bloc YAML du corps, désérialise les métadonnées dans une petite classe, puis convertit le corps en HTML. Les fins de ligne sont normalisées en premier : sans cette étape, un article enregistré sous Windows fait échouer la recherche du délimiteur ---.
using Markdig;
using YamlDotNet.Serialization;
using YamlDotNet.Serialization.NamingConventions;

public sealed record Post(string Slug, string Title, string Summary,
    DateTime PublishedOn, IReadOnlyList<string> Tags, bool Draft, string Html);

public static class PostParser
{
    // Built once and reused by every reload
    private static readonly MarkdownPipeline Pipeline =
        new MarkdownPipelineBuilder().UseAdvancedExtensions().Build();

    private static readonly IDeserializer Yaml = new DeserializerBuilder()
        .WithNamingConvention(CamelCaseNamingConvention.Instance)
        .IgnoreUnmatchedProperties()   // unknown keys do not crash the reload
        .Build();

    public static Post Parse(string slug, string text)
    {
        text = text.ReplaceLineEndings("\n");
        if (!text.StartsWith("---\n"))
            throw new FormatException($"{slug}: missing front matter");

        var end = text.IndexOf("\n---", 4, StringComparison.Ordinal);
        if (end < 0)
            throw new FormatException($"{slug}: unterminated front matter");

        var meta = Yaml.Deserialize<FrontMatter>(text[4..end]);
        var html = Markdown.ToHtml(text[(end + 4)..], Pipeline);

        return new Post(slug, meta.Title, meta.Summary, meta.Date, meta.Tags, meta.Draft, html);
    }

    private sealed class FrontMatter
    {
        public string Title { get; set; } = "";
        public string Summary { get; set; } = "";
        public DateTime Date { get; set; }
        public List<string> Tags { get; set; } = [];
        public bool Draft { get; set; }
    }
}
UseAdvancedExtensions() active les tableaux, les notes de bas de page, les listes de tâches, les identifiants automatiques sur les titres et les autres extensions Markdig utiles à un blog technique. Par défaut, Markdig laisse passer le HTML brut. C'est acceptable pour des articles rédigés par le propriétaire du site, mais tout Markdown fourni par des utilisateurs (commentaires, articles invités) doit passer par un pipeline doté de DisableHtml() pour éviter une faille XSS stockée.
Un magasin d'articles singleton, thread-safe et rechargé à chaud
Au démarrage, le magasin lit tous les fichiers et conserve le résultat dans un FrozenDictionary (disponible depuis .NET 8), optimisé pour les lectures intensives. Lorsqu'un fichier change, il construit un dictionnaire entièrement neuf et remplace la référence en une seule affectation. Les lecteurs ne prennent jamais de verrou : chaque requête voit soit l'ancien instantané, soit le nouveau, jamais une collection à moitié remplie.
using System.Collections.Frozen;
using Microsoft.AspNetCore.OutputCaching;
using Microsoft.Extensions.FileProviders;
using Microsoft.Extensions.Primitives;

public sealed class PostStore
{
    private readonly PhysicalFileProvider _files;
    private readonly IOutputCacheStore _cache;
    private readonly ILogger<PostStore> _logger;
    private volatile FrozenDictionary<string, Post> _bySlug = FrozenDictionary<string, Post>.Empty;

    public PostStore(IWebHostEnvironment env, IOutputCacheStore cache, ILogger<PostStore> logger)
    {
        (_cache, _logger) = (cache, logger);
        _files = new PhysicalFileProvider(Path.Combine(env.ContentRootPath, "posts"));
        Reload();
        ChangeToken.OnChange(() => _files.Watch("*.md"), Reload);   // re-registers after each change
    }

    public Post? Find(string slug) => _bySlug.TryGetValue(slug, out var post) ? post : null;

    public IReadOnlyList<Post> Latest(int count) =>
        _bySlug.Values.OrderByDescending(p => p.PublishedOn).Take(count).ToList();

    private void Reload()
    {
        try
        {
            var snapshot = _files.GetDirectoryContents("")
                .Where(f => !f.IsDirectory && f.Name.EndsWith(".md", StringComparison.Ordinal))
                .Select(f => PostParser.Parse(Path.GetFileNameWithoutExtension(f.Name), File.ReadAllText(f.PhysicalPath!)))
                .Where(p => !p.Draft)
                .ToFrozenDictionary(p => p.Slug);

            _bySlug = snapshot;   // atomic reference swap
            _ = _cache.EvictByTagAsync("posts", CancellationToken.None).AsTask();
            _logger.LogInformation("Loaded {Count} posts", snapshot.Count);
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "Reload failed, keeping the previous snapshot");   // a typo never takes the site down
        }
    }
}
Trois détails rendent ce code fiable en production. Le champ volatile garantit que les autres threads lisent la dernière référence après l'échange. Le bloc try/catch conserve le dernier instantané valide quand un article contient du YAML invalide : une faute de frappe dans un fichier ne vide pas le blog. Enfin, l'appel à EvictByTagAsync supprime toutes les pages en cache portant le tag posts, si bien que le nouveau contenu apparaît dès la requête suivante et non après l'expiration d'une heure.
FileSystemWatcher s'appuie sur des notifications du système d'exploitation qui ne traversent pas de manière fiable les bind mounts Docker ni les partages réseau. Dans un conteneur qui monte le dossier posts, il faut définir la variable d'environnement DOTNET_USE_POLLING_FILE_WATCHER=true ou PhysicalFileProvider.UsePollingFileWatcher = true. Les éditeurs enregistrent aussi un fichier en plusieurs écritures, ce qui peut déclencher Reload deux ou trois fois par sauvegarde : sans conséquence ici, puisque chaque exécution produit le même instantané.
Endpoints Minimal API avec groupes de routes et TypedResults
Les pages publiques sont regroupées sous /blog avec MapGroup, ce qui applique la politique de cache et son tag à tous les endpoints en un seul endroit. Les handlers renvoient un RazorComponentResult<T>, disponible depuis .NET 8, qui rend un composant Razor comme réponse HTTP complète, sans MVC, sans Razor Pages et sans routeur Blazor.
using CSharpBlog.Components;   // namespace of PostPage and PostListPage
using Microsoft.AspNetCore.Http.HttpResults;

public static class BlogEndpoints
{
    public static IEndpointRouteBuilder MapBlogEndpoints(this IEndpointRouteBuilder app)
    {
        var blog = app.MapGroup("/blog").CacheOutput(p => p.Tag("posts"));

        blog.MapGet("/", (PostStore store) =>
            new RazorComponentResult<PostListPage>(new { Posts = store.Latest(20) }));

        blog.MapGet("/{slug:regex(^[a-z0-9-]+$)}", GetPost);   // rejects odd slugs before the handler

        app.MapGet("/api/posts", (PostStore store) =>
                TypedResults.Ok(store.Latest(50).Select(p => new PostSummary(p.Slug, p.Title, p.Summary, p.PublishedOn))))
            .CacheOutput(p => p.Tag("posts"))
            .WithName("ListPosts");

        return app;
    }

    // The union return type documents both outcomes for OpenAPI and for unit tests
    private static Results<RazorComponentResult<PostPage>, NotFound> GetPost(string slug, PostStore store) =>
        store.Find(slug) is { } post
            ? new RazorComponentResult<PostPage>(new { Post = post })
            : TypedResults.NotFound();
}

public sealed record PostSummary(string Slug, string Title, string Summary, DateTime PublishedOn);
Le type de retour Results<T1, T2> marque toute la différence entre TypedResults et les anciens helpers Results. Le compilateur vérifie que le handler ne renvoie que les issues déclarées, le générateur OpenAPI lit les deux codes de statut dans la signature, et un test unitaire peut vérifier result.Result is NotFound sans démarrer de serveur. L'endpoint JSON reste en dehors du groupe /blog pour que son URL n'entre pas en collision avec les slugs des articles.
La page d'article est un composant Razor tout à fait classique. MarkupString indique à Razor d'émettre la sortie de Markdig comme du HTML au lieu de l'encoder, et l'URL canonique provient de BlogOptions.
@* Components/PostPage.razor *@
@using Microsoft.Extensions.Options
@inject IOptions<BlogOptions> Options

<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="utf-8" />
    <title>@Post.Title | @Options.Value.Title</title>
    <meta name="description" content="@Post.Summary" />
    <link rel="canonical" href="@(new Uri(new Uri(Options.Value.SiteUrl), $"blog/{Post.Slug}"))" />
    <link rel="alternate" type="application/rss+xml" title="@Options.Value.Title" href="/feed.xml" />
    <link rel="stylesheet" href="/site.css" />
</head>
<body>
    <article>
        <h1>@Post.Title</h1>
        <time datetime="@(Post.PublishedOn.ToString("yyyy-MM-dd"))">@(Post.PublishedOn.ToString("d MMMM yyyy"))</time>
        @((MarkupString)Post.Html)
    </article>
</body>
</html>

@code {
    [Parameter, EditorRequired] public Post Post { get; set; } = default!;
}
PostListPage.razor reprend le même principe avec un paramètre Posts et une boucle sur les titres et les résumés. L'objet anonyme transmis à RazorComponentResult associe ses noms de propriétés aux paramètres du composant : new { Post = post } doit donc correspondre exactement au paramètre Post.
Prêt à réussir tes entretiens .NET ?
Entraîne-toi avec nos simulateurs interactifs, fiches express et tests techniques.
Le cache de sortie pour les pages d'un blog ASP.NET Core
Le cache de sortie (output caching), introduit avec ASP.NET Core 7, stocke la réponse complète côté serveur et la rejoue sans exécuter le handler ni rendre à nouveau le composant. Il se distingue de l'ancien middleware de response caching, qui suit la sémantique HTTP Cache-Control et laisse un client contourner le cache avec un en-tête no-cache. La documentation du cache de sortie sur Microsoft Learn détaille les règles par défaut : seules les requêtes GET et HEAD qui renvoient un 200 sont mises en cache, et les réponses qui posent des cookies ou qui proviennent de requêtes authentifiées sont ignorées.
Ce sont les tags qui rendent le cache de sortie adapté à un site de contenu. Chaque endpoint du blog porte le tag posts, et le magasin évince ce tag après chaque rechargement. La politique de base d'une heure ne sert que de filet de sécurité ; en pratique, les pages restent en cache jusqu'à ce que le contenu change.
Dans un déploiement à plusieurs instances, le stockage en mémoire est propre à chaque processus : une éviction sur une instance laisse les autres servir un contenu périmé. ASP.NET Core propose un stockage adossé à Redis via le paquet Microsoft.AspNetCore.OutputCaching.StackExchangeRedis et la méthode AddStackExchangeRedisOutputCache, qui partage les entrées en cache et les évictions entre instances. Une seule petite instance s'en passe très bien.
Générer un flux RSS en C# avec SyndicationFeed
Les lecteurs techniques s'abonnent encore via des lecteurs de flux, et les agrégateurs repèrent les nouveaux articles dans le flux plutôt que dans le sitemap. SyndicationFeed et Rss20FeedFormatter produisent un flux conforme à la spécification RSS 2.0 sans écrire une ligne de XML à la main.
using System.ServiceModel.Syndication;
using System.Text;
using System.Xml;
using Microsoft.Extensions.Options;

public static class FeedEndpoints
{
    public static IEndpointRouteBuilder MapFeedEndpoints(this IEndpointRouteBuilder app)
    {
        app.MapGet("/feed.xml", (PostStore store, IOptions<BlogOptions> options) =>
        {
            var site = new Uri(options.Value.SiteUrl);   // never built from the Host header
            var items = store.Latest(20).Select(p =>
            {
                var date = new DateTimeOffset(DateTime.SpecifyKind(p.PublishedOn, DateTimeKind.Utc));
                return new SyndicationItem(p.Title, p.Summary, new Uri(site, $"blog/{p.Slug}"), p.Slug, date)
                {
                    PublishDate = date   // RSS pubDate comes from PublishDate, not LastUpdatedTime
                };
            });

            var feed = new SyndicationFeed(options.Value.Title, "Articles on C# and .NET", site, items);

            using var buffer = new MemoryStream();
            using (var writer = XmlWriter.Create(buffer, new XmlWriterSettings { Encoding = new UTF8Encoding(false) }))
                new Rss20FeedFormatter(feed).WriteTo(writer);   // writer flushes on dispose

            return TypedResults.Bytes(buffer.ToArray(), "application/rss+xml; charset=utf-8");
        }).CacheOutput(p => p.Tag("posts"));

        return app;
    }
}
Construire les URL absolues à partir de BlogOptions.SiteUrl plutôt que de HttpContext.Request.Host ferme la porte à une injection d'en-tête Host : sans cette précaution, une seule requête avec une valeur Host falsifiée serait mise en cache, puis servie à tous les abonnés avec des liens pointant vers un autre domaine. L'argument UTF8Encoding(false) supprime l'indicateur d'ordre des octets (BOM), que certains lecteurs de flux rejettent.
Déployer le blog technique C# et les limites de Native AOT
dotnet publish -c Release produit un build dépendant du framework, exécutable sur n'importe quel hôte disposant du runtime .NET 10. Depuis .NET 8, le SDK sait aussi construire des images de conteneur sans Dockerfile : dotnet publish -c Release /t:PublishContainer crée une image basée sur l'image officielle du runtime ASP.NET Core. Le dossier posts peut être intégré à l'image (chaque modification de contenu impose alors un redéploiement) ou monté comme volume (le surveillant de fichiers prend en compte les modifications).
Native AOT séduit par son temps de démarrage et sa faible empreinte mémoire, mais ce projet s'y prête mal. Le tableau de compatibilité Native AOT d'ASP.NET Core classe les Minimal APIs comme partiellement prises en charge et Blazor Server comme non pris en charge, et le désérialiseur par défaut de YamlDotNet repose sur la réflexion. Un blog sert des pages en cache depuis un processus de longue durée : le temps de démarrage compte peu. Passer en AOT obligerait à remplacer les composants Razor par des gabarits de chaînes et le YAML par un front matter JSON généré par source generator, pour un gain marginal.
Les questions d'entretien .NET que ce projet de blog prépare
Chaque partie du moteur correspond à une question classique des entretiens ASP.NET Core. Les questions d'entretien .NET sur SharpSkill les traitent en profondeur, et le module Minimal APIs se concentre sur la partie endpoints.
« Un service singleton est-il sûr si de nombreuses requêtes le lisent en même temps ? » Seulement si son état est immuable ou synchronisé. Le magasin présenté plus haut repose sur un instantané immuable et un échange de référence volatile : les lecteurs ne verrouillent jamais et l'écriture ne bloque jamais la lecture. Le piège classique est un singleton qui contient une List<T> modifiée pendant le rechargement, ce qui lève une InvalidOperationException en pleine énumération sous charge. Le module sur l'injection de dépendances aborde aussi le problème de la dépendance captive : un singleton qui reçoit un service scoped, comme un DbContext, le maintient en vie pendant toute la durée de l'application.
« Quelle différence entre output caching et response caching ? » Le cache de sortie est piloté par le serveur, gère les tags et l'éviction, et ignore les en-têtes de cache du client. Le response caching suit la sémantique HTTP et sert surtout d'indication pour les proxys et les navigateurs.
« Pourquoi renvoyer des TypedResults plutôt que des Results ? » Les types de résultat concrets apportent une vérification à la compilation des issues possibles, des métadonnées OpenAPI automatiques et des handlers testables comme de simples méthodes. La comparaison approfondie avec les contrôleurs se trouve dans l'article sur l'architecture et les performances des Minimal APIs.
« Où l'ordre des middlewares compte-t-il dans cette application ? » UseOutputCache doit être enregistré avant les endpoints qu'il met en cache, et après UseCors lorsque CORS est activé. Un candidat capable d'expliquer en plus pourquoi la politique par défaut ne met jamais en cache les requêtes authentifiées, et ce qu'une IOutputCachePolicy personnalisée doit vérifier avant de le faire, montre qu'il comprend le pipeline au lieu de réciter un ordre appris par cœur.
Construire un blog C# avec ASP.NET Core : l'essentiel
- Partir de
dotnet new websous .NET 10 et n'ajouter que Markdig, YamlDotNet etSystem.ServiceModel.Syndication: un blog technique n'a besoin ni de CMS ni de base de données. - Analyser les articles une seule fois dans un
FrozenDictionaryimmuable et remplacer l'instantané entier au rechargement, pour que les lecteurs ne verrouillent jamais et qu'un fichier cassé ne vide jamais le site. - Rendre le HTML avec
RazorComponentResult<T>depuis les handlers Minimal API, et déclarer des types de retourResults<T1, T2>pour qu'OpenAPI et les tests unitaires voient chaque issue. - Placer chaque endpoint de contenu derrière le cache de sortie avec un tag commun, et appeler
EvictByTagAsyncaprès chaque rechargement plutôt que de compter sur des expirations courtes. - Construire les URL canoniques et celles du flux depuis la configuration, jamais depuis l'en-tête
Host, et activerDisableHtml()sur tout pipeline qui rend du Markdown fourni par des utilisateurs. - Définir
DOTNET_USE_POLLING_FILE_WATCHER=truelorsque le dossier des articles est monté dans un conteneur. - Utiliser le projet comme entraînement à l'entretien : savoir expliquer à voix haute la sécurité du singleton face aux threads, le choix du cache et l'ordre des middlewares.
Passe à la pratique !
Teste tes connaissances avec nos simulateurs d'entretien et tests techniques.
Tu saurais repérer le bug en .NET ?
Un vrai bout de code, un bug caché, une tentative par jour. Sans compte pour essayer.
Écrit par
Anthony Fillion-MailletFondateur de SharpSkill
Développeur fullstack depuis plus de 10 ans. Il dirige SharpSkill et répond de tout ce qui y est publié.
Mis à jour le 17 novembre 2026
Tags
Partager
Articles similaires
Durée de Vie de DbContext dans ASP.NET Core : Performance vs Thread Safety en Async
Maîtrisez la gestion de la durée de vie de DbContext dans ASP.NET Core. Apprenez quand utiliser scoped vs transient, comment gérer les opérations async en toute sécurité et optimiser les performances avec le pooling de DbContext.
LINQ avancé en C# en 2026 : Opérateurs, Performance et Questions d'Entretien
Maîtriser les opérateurs LINQ avancés, optimiser les performances des requêtes et se préparer aux questions d'entretien technique C# avec des exemples pratiques.
.NET 9 Blazor : Développement Full-Stack avec Blazor United en 2026
.NET 9 Blazor United réunit le rendu statique SSR, le mode Server et WebAssembly dans un framework full-stack unifié. Un tutoriel pratique couvrant les modes de rendu, le streaming, l'injection par constructeur et les patterns de production.