Principes SRE en 2026 : ingénierie de la fiabilité, SLO et questions d'entretien
Principes SRE expliqués pour 2026 : choisir ses SLI, fixer ses SLO, calculer le budget d'erreur, écrire des alertes burn rate multi-fenêtres dans Prometheus et répondre aux questions d'entretien SRE les plus fréquentes.
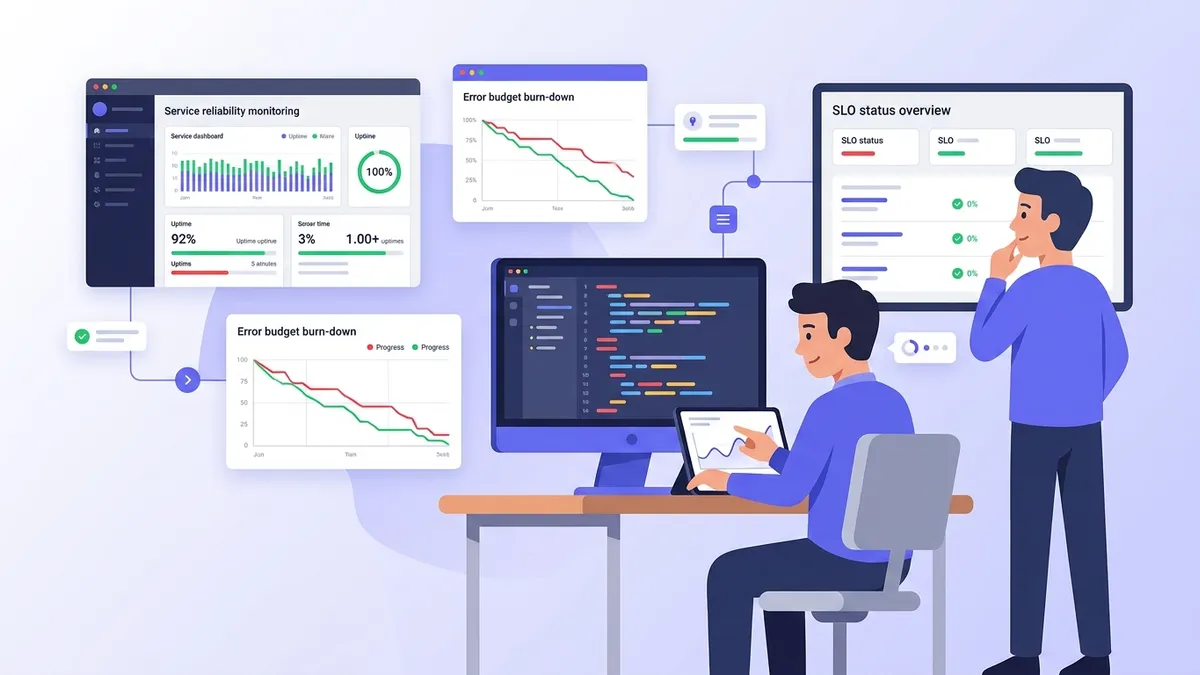
Les principes SRE transforment la fiabilité, notion souvent floue, en un chiffre sur lequel l'équipe produit et l'équipe technique s'accordent, puis s'en servent pour décider quand livrer et quand ralentir. Le site reliability engineering, formalisé chez Google puis adopté par la plupart des équipes plateforme, repose sur quelques idées simples : mesurer ce que vivent les utilisateurs (les SLI), fixer un objectif inférieur à 100 % (les SLO), dépenser l'écart sous forme de budget d'erreur et limiter le travail manuel qui maintient les systèmes en vie. En 2026, les questions d'entretien SRE portent précisément sur ces notions, le plus souvent sous la forme d'un exercice : définir le SLO d'un service réel et écrire l'alerte qui le protège.
Un SLI est une mesure : le rapport entre les événements réussis et les événements valides, par exemple les requêtes abouties sur l'ensemble des requêtes. Un SLO est la cible interne de ce rapport sur une fenêtre donnée, par exemple 99,9 % sur 30 jours. Un SLA est l'engagement contractuel envers les clients, assorti de pénalités, et il est toujours moins exigeant que le SLO.
Les principes fondateurs du site reliability engineering
Le livre SRE de Google présente la fiabilité comme une fonctionnalité qui a un coût. Chaque « neuf » supplémentaire mobilise davantage d'ingénierie et freine les mises en production, alors que les utilisateurs ne perçoivent quasiment jamais la différence entre 99,99 % et 99,999 % : leur réseau, leur appareil et leur fournisseur d'accès sont eux-mêmes moins fiables. L'objectif est donc le bon niveau de fiabilité, pas le niveau maximal.
Plusieurs principes découlent de ce point de départ :
- La fiabilité se mesure du côté de l'utilisateur. La consommation CPU et les redémarrages de pods sont des causes. Un paiement qui échoue ou une page lente, voilà ce que l'utilisateur subit, et c'est ce que capture un SLI.
- 100 % est une mauvaise cible. Un SLO à 100 % interdit tout changement, puisque chaque déploiement comporte un risque. L'écart sous les 100 % constitue le budget d'erreur, et il est fait pour être dépensé : livraisons, expérimentations, migrations.
- Le toil est plafonné. Le chapitre consacré à l'élimination du toil recommande de maintenir le travail opérationnel sous 50 % du temps d'un SRE. Le toil désigne un travail manuel, répétitif, automatisable, qui croît linéairement avec le service. Le reste du temps sert à l'ingénierie qui le supprime.
- Les postmortems sont sans reproche. L'analyse d'un incident cherche ce qui, dans le système, a permis la panne, et non qui a tapé la commande. Un ingénieur mis en cause dissimule de l'information ; une analyse sans reproche la fait remonter.
- Le monitoring alerte sur les symptômes. Une astreinte est réveillée quand les utilisateurs souffrent ou vont souffrir, pas quand un nœud isolé présente une courbe inhabituelle.
En entretien, le deuxième point distingue nettement un SRE confirmé d'un candidat qui a seulement lu le livre. Une réponse junior présente le budget d'erreur comme une tolérance à l'échec. Une réponse senior le présente comme un outil de pilotage des livraisons : c'est le mécanisme qui permet au produit et à la fiabilité de débattre avec des données plutôt qu'avec des opinions.
Choisir des SLI qui reflètent l'expérience utilisateur
Un bon SLI est un ratio compris entre 0 et 1, calculé à partir d'événements que l'utilisateur reconnaîtrait. Le SRE workbook propose une courte liste selon le type de service :
| Type de service | SLI courants | Point de mesure |
|---|---|---|
| API orientée requêtes | Disponibilité, latence | Logs du load balancer ou de l'ingress, métriques serveur |
| Pipeline de données | Fraîcheur, exactitude, couverture | Horodatage des sorties, jobs de validation |
| Système de stockage | Durabilité, latence en lecture et écriture | Couche de stockage, sondes synthétiques |
| Frontend | Temps de chargement, erreurs vues par le navigateur | Real user monitoring |
Mesurer au niveau du load balancer permet de capter les pannes que l'application ne voit jamais, par exemple un pod planté qui ne renvoie rien. Mesurer dans le navigateur révèle les problèmes de CDN et de DNS, mais ajoute le bruit des connexions mobiles médiocres. La plupart des équipes commencent par le load balancer ou l'ingress, car les données y sont déjà disponibles.
Avec Prometheus, les deux SLI classiques d'un service HTTP sont un ratio de disponibilité et un ratio de latence. Le SLI de latence compte comme réussies les requêtes servies sous un seuil, ce qui en fait un ratio comme les autres plutôt qu'un percentile.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Deux détails reviennent souvent en entretien. D'abord, les réponses 4xx sont généralement comptées comme valides et réussies : un 404 ou une erreur de validation relève de l'erreur du client, et les compter comme des échecs permettrait à un client mal configuré de consommer tout le budget. Ensuite, le seuil de latence doit correspondre à une borne de bucket de l'histogramme, sans quoi la requête ne renvoie rien ou s'appuie silencieusement sur le mauvais bucket. Prometheus 3.16, publié le 5 novembre 2026, prend en charge les histogrammes natifs, qui lèvent cette contrainte de buckets fixes mais doivent être activés côté scrape.
Fixer la cible du SLO et calculer le budget d'erreur
Un SLO associe un SLI, une cible et une fenêtre. La fenêtre est généralement glissante, sur 28 ou 30 jours, de sorte que le budget se reconstitue progressivement au lieu de se réinitialiser le premier du mois. La cible se choisit à partir des performances historiques et des attentes des utilisateurs, pas en fonction de ce qui sonne bien sur une diapositive.
Le tableau ci-dessous indique ce que chaque cible autorise sur 30 jours. Il s'agit d'arithmétique pure : le budget vaut (1 - SLO) × 30 jours.
| Cible SLO | Budget d'erreur | Indisponibilité totale tolérée sur 30 jours |
|---|---|---|
| 99 % | 1 % | 7 h 12 min |
| 99,5 % | 0,5 % | 3 h 36 min |
| 99,9 % | 0,1 % | 43 min 12 s |
| 99,95 % | 0,05 % | 21 min 36 s |
| 99,99 % | 0,01 % | 4 min 19 s |
Pour les SLO fondés sur les requêtes, le budget s'exprime en nombre de requêtes plutôt qu'en minutes : à 99,9 % avec 12 millions de requêtes sur la fenêtre, 12 000 requêtes en échec sont admises. Ce mode de calcul est plus juste pour les services au trafic irrégulier, car une panne à 3 heures du matin coûte moins de budget que la même panne en pleine heure de pointe.
Un exercice fréquent en entretien consiste à calculer le budget restant et la vitesse à laquelle il se consomme. Le script suivant correspond au type de réponse attendu lorsque la question exige du code.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Un burn rate de 15 signifie que le service échoue sur 1,5 % des requêtes alors que le SLO n'en tolère que 0,1 %. À ce rythme, les 35 % de budget restants disparaissent en moins de 17 heures, ce qui justifie de réveiller quelqu'un.
Prêt à réussir tes entretiens DevOps ?
Entraîne-toi avec nos simulateurs interactifs, fiches express et tests techniques.
Alerter sur le burn rate avec plusieurs fenêtres
Alerter directement sur le SLI (« taux d'erreur supérieur à 0,1 % ») déclenche une alerte à chaque pic bref et laisse passer les fuites lentes. Le chapitre du workbook sur l'alerting à partir des SLO recommande plutôt des alertes multi-fenêtres et multi-burn-rate. Chaque alerte répond à une seule question : le budget se consomme-t-il assez vite pour être épuisé avant que quelqu'un ne s'en aperçoive ?
Les seuils de référence pour une fenêtre de 30 jours sont les suivants :
| Gravité | Fenêtre longue | Fenêtre courte | Burn rate | Budget consommé au déclenchement |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2 % |
| Page | 6 h | 30 min | 6 | 5 % |
| Ticket | 3 jours | 6 h | 1 | 10 % |
La fenêtre longue apporte la significativité : une minute difficile ne réveille personne. La fenêtre courte, égale à un douzième de la longue, permet à l'alerte de se résorber rapidement une fois l'incident terminé, afin qu'elle ne continue pas de sonner pendant une heure après le correctif. Les deux conditions doivent être vraies simultanément.
Le premier fichier enregistre le ratio d'erreur pour chaque fenêtre, ce qui garde les expressions d'alerte peu coûteuses. Le second définit les deux alertes de type page pour un SLO à 99,9 %, soit une fraction de budget de 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageÉcrire ces règles à la main pour chaque service devient vite fastidieux. Sloth, un générateur de SLO open source, prend une spécification courte et produit les règles d'enregistrement et les alertes multi-burn-rate présentées plus haut. Le marqueur {{.window}} est remplacé par chacune des fenêtres dont Sloth a besoin.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Les équipes qui recherchent un format indépendant de tout éditeur se tournent vers la spécification OpenSLO, qui décrit les SLO en YAML sans dépendre du backend de monitoring.
Politique de budget d'erreur et décisions de mise en production
Un budget d'erreur sans politique associée reste un tableau de bord que personne n'exploite. L'exemple de politique de budget d'erreur du workbook détaille ce qui se passe quand le budget est épuisé, et qui l'a validé à l'avance.
Une politique type comprend :
- Le déclencheur. Le service a dépassé son budget d'erreur sur la fenêtre glissante.
- La conséquence. Les livraisons de fonctionnalités s'arrêtent, à l'exception des correctifs de sécurité et des changements qui améliorent la fiabilité, jusqu'au retour dans le SLO.
- La voie d'exception. Un incident isolé causé par une dépendance hors du périmètre de l'équipe peut être exclu, avec une décision documentée.
- L'escalade. Les désaccords remontent à un rôle nommé, par exemple le CTO, et non à celui qui argumente le plus fort.
La politique est signée par le produit et l'ingénierie avant le premier dépassement, et c'est tout son intérêt : le gel des livraisons devient une règle convenue d'avance plutôt qu'un conflit en plein incident. Les recruteurs demandent souvent ce qu'il faut faire lorsque le budget n'est jamais entamé. La réponse attendue : le SLO est peut-être trop lâche, ou l'équipe livre avec trop de prudence, et le budget devrait servir à accélérer les déploiements ou à mener des migrations plus ambitieuses.
Aligner le SLO interne sur le SLA client ne laisse aucune marge : le premier dépassement du SLO constitue déjà une pénalité contractuelle. Le SLO doit être plus strict que le SLA, afin que les alertes se déclenchent et que le gel commence alors que le contrat est encore respecté.
Réduction du toil, astreinte et postmortems sans reproche
Le temps d'un SRE se partage entre opérations et ingénierie. Les opérations couvrent l'astreinte, les tickets et les interventions manuelles. L'ingénierie couvre l'automatisation, la planification de capacité et les fonctionnalités de fiabilité. Lorsque le toil dépasse le seuil de 50 %, l'équipe SRE renvoie une partie du travail vers l'équipe de développement ou investit dans l'automatisation ; sinon, elle devient une équipe d'exploitation sous un nouvel intitulé.
La santé de l'astreinte se mesure plutôt qu'elle ne se suppose. Les indicateurs utiles sont le nombre d'alertes par garde, la part d'alertes ayant réellement nécessité une action et le délai de prise en compte. Une alerte qui ne demande aucune action est un bug de l'alerting : elle doit être corrigée ou supprimée. Les alertes fondées sur les symptômes et le burn rate, comme dans les règles ci-dessus, réduisent fortement le volume par rapport aux alertes sur le CPU, la mémoire ou les redémarrages de pods.
Après un incident, le chapitre sur la culture du postmortem décrit l'analyse qui suit. Un postmortem consigne l'impact en termes de SLO (la part de budget consommée), la chronologie, les facteurs contributifs et les actions correctives avec responsables et échéances. Il ne désigne aucune personne comme cause. Deux relances sont fréquentes en entretien : comment garantir que les actions correctives sont réellement menées (les suivre dans le même backlog que les fonctionnalités, les revoir lors d'une réunion récurrente), et quand un postmortem est obligatoire (tout incident ayant consommé une part significative du budget, toute alerte qui a réveillé quelqu'un, toute perte de données).
Les quatre signaux clés du livre SRE, latence, trafic, erreurs et saturation, complètent le dispositif de monitoring. La latence et les erreurs deviennent généralement des SLI. Le trafic et la saturation alimentent la planification de capacité et les tableaux de bord plutôt que les alertes.
Questions d'entretien SRE et réponses attendues
Voici les questions qui reviennent dans les processus de recrutement SRE et DevOps senior, avec l'essentiel d'une bonne réponse. Le module d'entretien sur les principes SRE approfondit ces sujets, et le module alerting et gestion d'incidents couvre le volet astreinte.
Q : Quelle différence entre un SLI, un SLO et un SLA ?
Le SLI est le ratio mesuré, le SLO sa cible interne sur une fenêtre, le SLA le contrat externe assorti de pénalités. Le SLO est plus strict que le SLA pour que l'équipe réagisse avant toute perte financière.
Q : Pourquoi ne pas fixer le SLO à 100 % ?
Parce que chaque changement comporte un risque : une cible de 100 % interdit donc toute livraison. Les utilisateurs ne perçoivent pas non plus une fiabilité supérieure à celle de leur propre réseau. L'écart sous les 100 % forme le budget d'erreur, qui finance les livraisons.
Q : Définir un SLO pour une API de paiement.
Une réponse solide retient deux SLI (disponibilité hors 4xx, latence sous un seuil mesurée au load balancer), une fenêtre glissante de 30 jours, des cibles fondées sur les données du dernier trimestre, puis explique comment l'alerting et la politique de budget d'erreur en découlent. Se contenter de « 99,99 % d'uptime » sans préciser ce qui est mesuré constitue la réponse faible classique.
Q : Pourquoi une alerte sur la latence p99 est-elle une mauvaise alerte de SLO ?
Un p99 sur une fenêtre courte est bruité et ne s'agrège pas entre instances. Transformer la latence en ratio de requêtes sous un seuil la rend additive, comparable au SLI de disponibilité et compatible avec les alertes de burn rate.
Q : Expliquer le burn rate et l'intérêt des deux fenêtres.
Le burn rate est le ratio d'erreur observé divisé par la fraction de budget ; une valeur de 1 signifie que le budget dure exactement la fenêtre. La fenêtre longue filtre les pics brefs, la fenêtre courte permet à l'alerte de se résorber vite après le rétablissement.
Q : Qu'est-ce que le toil et comment le maîtriser ?
Un travail manuel, répétitif, automatisable, sans valeur durable, qui croît avec le service. Il se mesure, se plafonne (Google retient 50 %) et se réduit par l'automatisation ou en rendant le travail à l'équipe propriétaire.
Q : Qu'est-ce qui rend un postmortem « sans reproche » ?
Il se concentre sur les conditions du système qui ont permis la panne, part du principe que chacun a agi raisonnablement avec les informations disponibles et produit des actions suivies. Le test : l'ingénieur concerné partagerait-il chaque détail sans crainte ?
Les questions de monitoring suivent souvent celles sur les SLO dans le même entretien. Le guide des questions d'entretien Prometheus couvre PromQL, les types de métriques et la cardinalité, et la page technologie DevOps regroupe tous les modules pour une préparation plus large.
SLO et budgets d'erreur en pratique : l'essentiel à retenir
- Définir chaque SLI comme un ratio d'événements réussis sur événements valides, mesuré au plus près de l'utilisateur, en excluant les 4xx des échecs pour la plupart des API
- Choisir le SLO à partir des données historiques et d'une fenêtre glissante de 28 ou 30 jours, en le gardant plus strict que tout SLA client
- Convertir la cible en budget exprimé en minutes ou en requêtes, et connaître les ordres de grandeur : 99,9 % sur 30 jours représentent 43 minutes
- Alerter sur le burn rate avec des fenêtres couplées (14,4 sur 1 h et 5 min, 6 sur 6 h et 30 min), jamais sur le taux d'erreur brut ou le CPU
- Générer les règles avec Sloth ou un outil équivalent dès que plusieurs services disposent de SLO, afin de garder des seuils cohérents
- Rédiger et faire signer la politique de budget d'erreur avant le premier dépassement, avec la règle de gel et le chemin d'escalade
- Suivre le toil, le volume d'alertes et les actions issues des postmortems avec la même rigueur que les fonctionnalités
Passe à la pratique !
Teste tes connaissances avec nos simulateurs d'entretien et tests techniques.
Tu saurais repérer le bug en DevOps ?
Un vrai bout de code, un bug caché, une tentative par jour. Sans compte pour essayer.

Écrit par
Anthony Fillion-MailletFondateur de SharpSkill
Développeur fullstack depuis plus de 10 ans. Il dirige SharpSkill et répond de tout ce qui y est publié.
Mis à jour le 7 novembre 2026
Tags
Partager
Articles similaires

Questions d'entretien Prometheus 2026 : Prometheus vs Grafana vs Datadog comparés
Questions d'entretien Prometheus pour les postes DevOps et SRE, avec les réponses sur PromQL, les types de métriques, la cardinalité et la HA, plus un comparatif Prometheus vs Grafana vs Datadog : architecture, alerting et tarifs.
Ansible vs Terraform en 2026 : Infrastructure as Code et Questions d'Entretien DevOps
Comparaison approfondie entre Ansible et Terraform pour l'Infrastructure as Code en 2026. Comprendre la gestion de configuration vs le provisioning, quand utiliser chaque outil, et préparer les entretiens DevOps.
Docker Compose en 2026 : Applications Multi-Conteneurs, Réseau et Questions d'Entretien DevOps
Guide complet sur Docker Compose en 2026 couvrant les applications multi-conteneurs, la configuration réseau avancée, et les questions fréquentes en entretien DevOps.