RAG et LLMs en 2026 : Retrieval-Augmented Generation pour les Entretiens Data Science
Retrieval-Augmented Generation (RAG) expliqué pour les entretiens data science en 2026. Bases vectorielles, chunking, embedding, RAG agentique, Graph RAG et conformité EU AI Act.
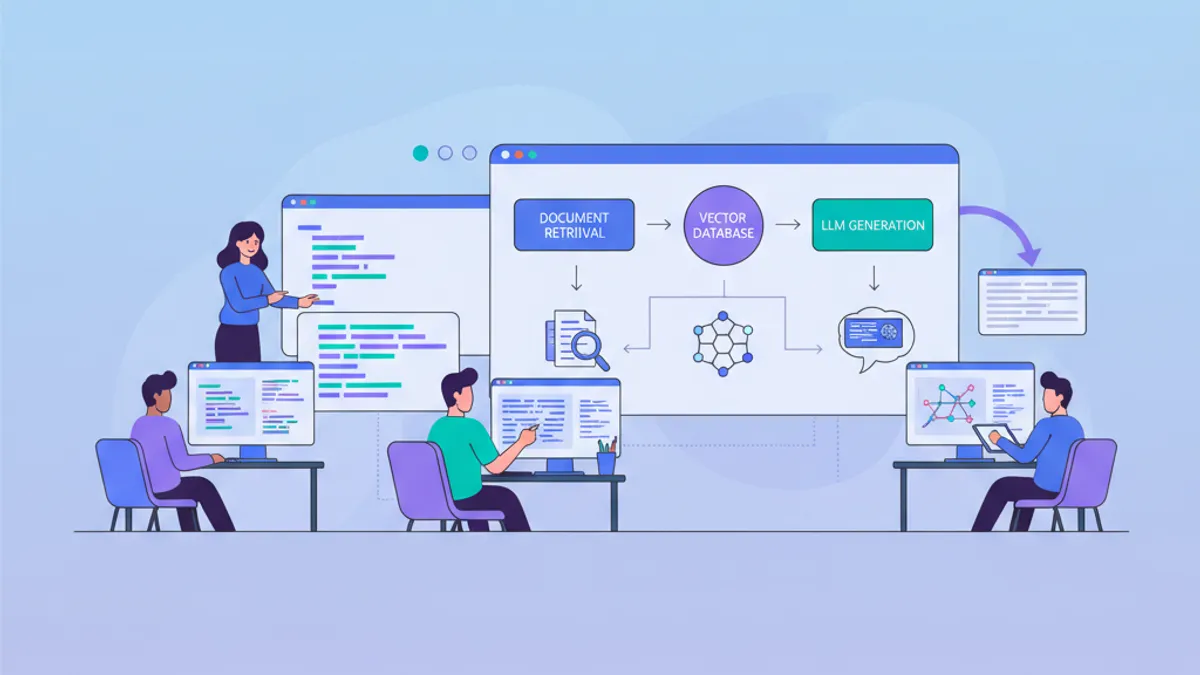
Les grands modèles de langage (LLMs) ont révolutionné le traitement du langage naturel, mais ils présentent des limitations critiques : connaissances obsolètes, hallucinations et absence d'accès aux données propriétaires. Le Retrieval-Augmented Generation (RAG) résout ces problèmes en combinant la capacité générative des LLMs avec des systèmes de récupération d'information en temps réel. Dans les entretiens data science de 2026, les questions sur le RAG apparaissent aux côtés des sujets ML traditionnels, évaluant à la fois la conception de systèmes et les compétences d'implémentation pratique.
Le Retrieval-Augmented Generation combine un système de récupération (recherche vectorielle dans une base de connaissances) avec un LLM générateur, permettant au modèle de répondre à partir de documents réels plutôt que de se fier aux données mémorisées pendant l'entraînement.
Fonctionnement du pipeline RAG de bout en bout
Un système RAG fonctionne en deux phases : une phase d'ingestion offline qui construit la base de connaissances, et une phase de requête online qui récupère le contexte pertinent et génère une réponse.
Pendant l'ingestion, les documents bruts passent par le nettoyage, le chunking et l'embedding avant d'être stockés dans une base de données vectorielle. Pendant l'inférence, la requête de l'utilisateur suit le même chemin d'embedding, et la recherche des plus proches voisins récupère les chunks les plus pertinents. Ces chunks deviennent partie du prompt du LLM, ancrant la réponse générée dans le matériel source.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Ce pipeline couvre le cycle RAG fondamental : découper, encoder, stocker, récupérer et générer. Le paramètre search_type="mmr" garantit que les chunks récupérés sont à la fois pertinents et diversifiés, réduisant la redondance dans la fenêtre de contexte.
Stratégies de chunking essentielles
Le chunking détermine la qualité de la récupération plus que tout autre composant. Un mauvais chunking signifie que le retriever renvoie des fragments manquant de contexte ou diluant le signal avec du contenu non pertinent.
Trois approches de chunking dominent les systèmes de production en 2026 :
Chunking à taille fixe découpe le texte à un nombre défini de tokens (typiquement de 256 à 512) avec chevauchement. Simple à implémenter, mais coupe les phrases et les idées en plein milieu.
Chunking sémantique détecte les frontières thématiques en mesurant la similarité d'embedding entre phrases consécutives. Lorsque la similarité descend sous un seuil, un nouveau chunk commence. Chaque chunk porte une idée cohérente plutôt qu'une tranche arbitraire de texte.
Late chunking applique d'abord le modèle transformer au document complet, produisant des embeddings contextuels par token, puis découpe en chunks. Cela préserve les dépendances à longue distance que le chunking traditionnel détruit.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Le point clé pour les entretiens : la taille de chunk est un compromis précision-recall. Les petits chunks (100 tokens) améliorent la précision de récupération mais fragmentent le contexte. Les grands chunks (1000 tokens) préservent le contexte mais diluent la spécificité de l'embedding. La plupart des systèmes de production se situent entre 256 et 512 tokens avec 10 à 20% de chevauchement.
Bases de données vectorielles et modèles d'embedding en production
La base de données vectorielle stocke les embeddings et permet une recherche rapide de plus proches voisins approximatifs (ANN). Le choix de la bonne combinaison modèle d'embedding et base vectorielle impacte directement la latence et la précision de récupération.
Les modèles d'embedding en 2026 ont convergé vers quelques options performantes. Le text-embedding-3-large d'OpenAI (3072 dimensions) et les alternatives open-source comme bge-m3 de BAAI ou embed-v4 de Cohere offrent une récupération multilingue de qualité. Le MTEB leaderboard reste le benchmark de référence pour comparer la qualité des embeddings. Le modèle text-embedding-3-large supporte l'apprentissage de représentation Matryoshka, permettant une troncation des dimensions (à 1024 ou 256) avec une perte de qualité minimale, réduisant significativement les coûts de stockage.
Le marché des bases de données vectorielles s'est consolidé en 2026. Quatre produits représentent la majorité des charges de travail RAG en production :
| Database | Indexing | Managed | Strength |
|---|---|---|---|
| Pinecone | Proprietary | Yes | Zéro-ops, inférence intégrée, recherche hybride |
| Weaviate | HNSW | Yes/Self | Fusion native BM25 + dense en une requête |
| Qdrant | HNSW | Yes/Self | Performance Rust, filtrage payload, meilleur tier gratuit |
| pgvector | IVF, HNSW | Self | Intégration PostgreSQL pour stacks existantes |
Pour les discussions en entretien, le point critique est de comprendre l'algorithme HNSW (Hierarchical Navigable Small World) : il construit un graphe multicouche où chaque noeud se connecte à ses voisins les plus proches, permettant une recherche en O(log n) au prix d'une utilisation mémoire plus élevée.
Le point de basculement des coûts se situe entre 60 et 80 millions de requêtes par mois. Au-delà, Qdrant ou Weaviate auto-hébergés sur infrastructure à coût fixe reviennent systématiquement de 3 à 10 fois moins cher que Pinecone Serverless.
Prêt à réussir tes entretiens Data Science & ML ?
Entraîne-toi avec nos simulateurs interactifs, fiches express et tests techniques.
Récupération hybride : combiner recherche dense et sparse
La recherche vectorielle pure échoue sur les correspondances exactes de mots-clés et les termes rares. La recherche lexicale pure (BM25) ne capture pas la similarité sémantique. La récupération hybride combine les deux, et en 2026 c'est le standard par défaut pour les systèmes RAG en production.
Le pattern standard utilise Reciprocal Rank Fusion (RRF) pour fusionner les résultats classés des deux retrievers :
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
La récupération hybride résout le problème de "désalignement de vocabulaire" où un utilisateur demande "annuler un abonnement" mais le document pertinent utilise "politique de résiliation de compte". BM25 capture la correspondance exacte des termes tandis que la recherche vectorielle capture la relation sémantique.
Reranking : le filtre de second niveau
La récupération renvoie des candidats. Le reranking les ordonne par pertinence réelle. Les rerankers cross-encoder comme Cohere Rerank ou bge-reranker-v2.5-gemma2-lightweight évaluent chaque paire requête-document conjointement, produisant des scores de pertinence bien plus précis que la similarité par bi-encoder.
Le pipeline de récupération en deux étapes (recall large en première étape avec top 50 à 100 candidats via vector + BM25, puis reranking précis vers top 5 à 10 pour le prompt) est standard en production. Cela maintient la latence gérable : la première étape utilise une recherche ANN rapide, tandis que le cross-encoder coûteux ne traite qu'un petit ensemble de candidats.
Les cross-encoders sont plus précis que les bi-encoders car ils traitent la requête et le document ensemble à travers toutes les couches du transformer. Les bi-encoders les encodent indépendamment, perdant les signaux d'interaction fine. Le compromis est la vitesse : les cross-encoders ne peuvent pas être pré-indexés.
RAG adaptatif : routage des requêtes vers le bon pipeline
Toutes les requêtes ne nécessitent pas la même complexité de récupération. Le RAG adaptatif entraîne un petit classifieur pour router chaque question vers le chemin optimal :
- Pas de récupération pour les requêtes factuelles simples que le modèle connaît déjà
- Récupération en une étape pour les requêtes modérées
- Récupération itérative multi-étapes pour le raisonnement complexe
Ce pattern équilibre coût et précision sur des charges de travail mixtes. Un système de production traitant 100 000 requêtes par jour peut réduire les coûts d'inférence de 40% en routant les questions simples hors des pipelines multi-étapes coûteux.
Le classifieur lui-même peut être un petit modèle fine-tuné ou un prompt zero-shot demandant : « Cette question nécessite-t-elle des connaissances externes pour répondre avec précision ? »
RAG spéculatif : échanger l'ancrage contre la vitesse
Le RAG spéculatif exécute la récupération en parallèle avec une génération brouillon rapide. Si le brouillon affiche une haute confiance (mesurée par logprob), l'étape de récupération est entièrement ignorée. Si la confiance est basse, le contexte récupéré fusionne avec le brouillon et une regénération a lieu.
Cette approche réduit la latence moyenne de 30 à 40% sur les requêtes à haute confiance. Elle fonctionne mieux pour les chatbots temps réel, les suggestions d'autocomplétion et les systèmes de service client où le temps de réponse importe plus qu'un sourcing exhaustif sur chaque requête.
Le compromis : le RAG spéculatif renvoie occasionnellement des réponses sans ancrage lorsque le modèle est trop confiant. Les systèmes de production l'associent à une calibration de confiance et un fallback vers la récupération complète lorsque l'incertitude dépasse un seuil.
RAG agentique : au-delà de la récupération en un seul passage
Le RAG naïf récupère une fois et génère. Le RAG agentique traite le LLM comme un agent de raisonnement qui décide quand récupérer, quoi récupérer et si le contexte récupéré est suffisant.
En 2026, le RAG agentique est le pattern dominant pour les requêtes complexes nécessitant un raisonnement multi-étapes. L'agent peut :
- Auto-évaluer : déterminer si les documents récupérés répondent à la question
- Re-requêter : reformuler la requête de recherche si les résultats initiaux sont insuffisants
- Router : choisir entre différentes sources de connaissances (base vectorielle, base SQL, API)
- Vérifier : recouper les faits entre plusieurs passages récupérés
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Ce pattern (récupérer, évaluer, optionnellement reformuler et réessayer) est connu sous le nom de Corrective RAG (CRAG). L'AgentExecutor de LangChain est déprécié depuis 2026 ; les nouveaux projets doivent utiliser create_react_agent() pour les patterns préconstruits ou le StateGraph de LangGraph pour l'orchestration personnalisée. Pour une couverture plus approfondie des patterns LangChain pour data scientists, consultez l'article dédié.
Graph RAG : récupération de connaissances structurées
Le Graph RAG extrait les entités et relations des documents dans un graphe de connaissances, puis interroge à la fois le graphe et la base vectorielle. Cette architecture réduit les hallucinations sur les requêtes factuelles en ancrant les réponses dans des relations explicites entre entités plutôt que dans la similarité de texte non structuré.
Le pipeline d'ingestion extrait des triplets (sujet, prédicat, objet) de chaque chunk de document. Au moment de la requête, le système identifie les entités pertinentes dans la question, parcourt le graphe de connaissances pour trouver les faits connectés, et combine le contexte récupéré du graphe avec les passages récupérés par vecteurs.
Le Graph RAG excelle sur les questions de raisonnement multi-saut comme « Quelle équipe dirige le projet qui utilise le framework mentionné dans le document X ? » Ces requêtes nécessitent de connecter des faits à travers plusieurs documents, ce que la recherche vectorielle pure peine à faire car aucun chunk unique ne contient la réponse complète.
Le Graph RAG améliore significativement la précision factuelle (jusqu'à 40% de réduction des hallucinations sur les requêtes riches en entités) mais nécessite un pipeline mature d'extraction d'entités. Une extraction bruitée produit un graphe bruité, ce qui peut dégrader les résultats en dessous du RAG naïf. Le projet GraphRAG de Microsoft est passé en mode maintenance en 2026 ; il recevra des corrections de bugs mais pas de nouvelles fonctionnalités.
La variante LazyGraphRAG de Microsoft (sortie en juin 2025) réduit drastiquement les coûts d'indexation en différant la summarization au moment de la requête, ce qui la rend adaptée à l'analyse exploratoire ou aux données en streaming où la construction anticipée du graphe n'est pas pratique.
Conformité à l'EU AI Act pour les systèmes RAG
L'EU AI Act est devenu largement applicable en août 2026. La première amende majeure sous ce règlement a touché un consortium bancaire européen dont le chatbot RAG ne respectait pas les exigences de transparence fin mai 2026, et une société de gestion de patrimoine de Francfort a reçu une pénalité de 4,5 millions d'euros en avril 2026 pour un système RAG client qui n'expliquait pas la provenance des données.
Les architectures RAG satisfont naturellement plusieurs exigences de conformité : traçabilité des sources (les chunks portent des références documentaires), transparence des réponses (les citations peuvent être exposées), et auditabilité (les logs de récupération existent par construction). Cependant, une conformité complète nécessite des mesures supplémentaires :
Classification des risques : Un chatbot public relève du risque limité (transparence requise). Un système RAG médical ou juridique est à haut risque avec des obligations plus strictes de documentation et de supervision.
Journalisation d'audit : Enregistrer quelle question a déclenché quels chunks récupérés et quelle réponse a été générée. Ce journal constitue la base de la traçabilité requise.
Supervision humaine : Les systèmes à haut risque nécessitent une validation humaine sur les cas sensibles, la capacité de corriger les outputs, et des mécanismes pour effacer les données indexées sur demande.
Résidence des données : Héberger l'indexation dans l'UE et utiliser BYOK (Bring Your Own Key) pour s'assurer que les données ne transitent pas par des comptes tiers hors juridiction.
La non-conformité peut coûter 7% du chiffre d'affaires annuel mondial. Pour les discussions en entretien, le point clé est que la capacité de citation inhérente au RAG est un avantage, mais ne se substitue pas à la couche de gouvernance.
Évaluation des systèmes RAG : métriques essentielles
L'évaluation RAG se divise en métriques de récupération et métriques de génération. Les deux doivent être mesurées indépendamment pour diagnostiquer les échecs.
Métriques de récupération :
- Recall@k : les documents pertinents sont-ils apparus dans les k premiers résultats ?
- MRR (Mean Reciprocal Rank) : à quelle position se trouve le premier résultat pertinent ?
- NDCG : le classement correspond-il à l'ordre de pertinence idéal ?
Métriques de génération :
- Fidélité (Faithfulness) : la réponse utilise-t-elle uniquement l'information du contexte récupéré ? (Mesure les hallucinations)
- Pertinence de la réponse : la réponse répond-elle à la question originale ?
- Précision du contexte : les chunks récupérés sont-ils réellement utilisés dans la réponse ?
Des frameworks comme Ragas et DeepEval automatisent ces évaluations en utilisant des patterns LLM-as-judge. Les principales questions d'entretien data science incluent de plus en plus la conception d'évaluation RAG, le candidat devant expliquer comment mesurer si un système RAG fonctionne correctement.
Modes de défaillance en production et débogage
Les systèmes RAG échouent de manières prévisibles. Connaître ces patterns est essentiel tant pour les entretiens que pour le déploiement réel.
Contamination de la fenêtre de contexte survient lorsque trop de chunks récupérés diluent le signal pertinent. Le LLM reçoit 10 chunks mais seulement 2 contiennent de l'information utile. La solution : utiliser un reranker pour filtrer et réduire le top-k du retriever.
Artéfacts de chunking surviennent lorsque le découpage à taille fixe coupe les phrases, tableaux ou blocs de code en plein milieu. Le chunk récupéré est syntaxiquement incomplet et sémantiquement inutile. Le chunking sémantique ou le découpage conscient de la structure du document (respectant headers, paragraphes, code fences) résout ce problème.
Dérive d'embedding émerge lorsque le modèle d'embedding est mis à jour mais que la base vectorielle contient toujours des embeddings de l'ancien modèle. Les requêtes encodées avec le nouveau modèle cherchent dans un espace vectoriel construit par l'ancien, dégradant la qualité de récupération. Solution : ré-encoder tout le corpus après tout changement de modèle.
Index obsolètes délivrent des informations périmées parce que le pipeline d'ingestion a pris du retard sur les mises à jour documentaires. Dans les systèmes de machine learning, c'est analogue au training-serving skew, où le système de récupération voit une distribution de données différente de celle qui existe en production.
Sources
- Turing Post: 20 Advanced RAG Types to Know in 2026 - taxonomie complète des patterns RAG
- LangChain and LangGraph 1.0 Milestones - dépréciation d'AgentExecutor, nouveaux patterns
- Microsoft GraphRAG GitHub - statut mode maintenance
- IgnitionRAG EU AI Act Guide - exigences de conformité pour les systèmes RAG
- MarkTechPost: Best Vector Databases in 2026 - consolidation du marché et tarification
Passe à la pratique !
Teste tes connaissances avec nos simulateurs d'entretien et tests techniques.
Points clés sur le RAG pour les entretiens Data Science
- Le RAG combine la récupération (recherche vectorielle dans une base de connaissances) avec la génération LLM pour produire des réponses fondées et factuelles sans réentraîner le modèle
- La stratégie de chunking a le plus grand impact sur la qualité de récupération ; le chunking sémantique et le late chunking surpassent le découpage à taille fixe dans la plupart des cas d'usage
- La récupération hybride (vecteurs denses + BM25 sparse) avec Reciprocal Rank Fusion est le standard de production, résolvant le problème de désalignement de vocabulaire que la recherche vectorielle pure ne peut pas gérer
- Les rerankers cross-encoder ajoutent une couche de précision après la récupération large, ne traitant qu'un petit ensemble de candidats pour maintenir une latence acceptable
- Le RAG adaptatif route les requêtes vers la complexité de pipeline appropriée, réduisant les coûts de 40% sur les charges de travail mixtes
- Le RAG spéculatif échange l'ancrage contre la vitesse, réduisant la latence de 30 à 40% sur les requêtes à haute confiance
- Le RAG agentique (récupérer, évaluer, reformuler, réessayer) et le Graph RAG (extraction de relations entités) gèrent les requêtes complexes multi-saut où le RAG naïf échoue
- La conformité à l'EU AI Act (août 2026) exige journalisation d'audit, supervision humaine et classification des risques pour les systèmes RAG en production
- L'évaluation doit séparer les métriques de récupération (Recall@k, MRR) des métriques de génération (fidélité, pertinence de la réponse) pour diagnostiquer où le pipeline se casse
- Les défaillances de production les plus courantes (contamination du contexte, artéfacts de chunking, dérive d'embedding, index obsolètes) ont toutes des corrections directes une fois identifiées
Tu saurais repérer le bug en Data Science & ML ?
Un vrai bout de code, un bug caché, une tentative par jour. Sans compte pour essayer.

Écrit par
Anthony Fillion-MailletFondateur de SharpSkill
Développeur fullstack depuis plus de 10 ans. Il dirige SharpSkill et répond de tout ce qui y est publié.
Mis à jour le 24 août 2026
Tags
Partager
Articles similaires
Feature Engineering pour le Machine Learning : Techniques et Questions d'Entretien 2026
Guide complet du feature engineering en data science : encodage categoriel, scaling, selection de features, pipelines de production et questions d'entretien technique avec exemples de code Python.

XGBoost vs LightGBM en 2026 : Gradient Boosting et Questions d'Entretien Data Science
Maîtrisez XGBoost et LightGBM pour réussir vos entretiens en data science. Comparez les algorithmes de gradient boosting, apprenez l'optimisation des hyperparamètres et préparez-vous aux questions techniques avec des exemples Python.

Pipelines Scikit-Learn en 2026 : Feature Engineering et Questions d'Entretien
Maîtrisez les pipelines scikit-learn pour le feature engineering et préparez vos entretiens techniques. Guide complet avec ColumnTransformer, GridSearchCV et bonnes pratiques de déploiement.