ETL vs ELT en 2026 : Architecture des Pipelines de Données et Questions d'Entretien
Analyse approfondie des architectures ETL et ELT, comparaison des patterns de pipelines de données et questions d'entretien pour ingénieurs data en 2026.
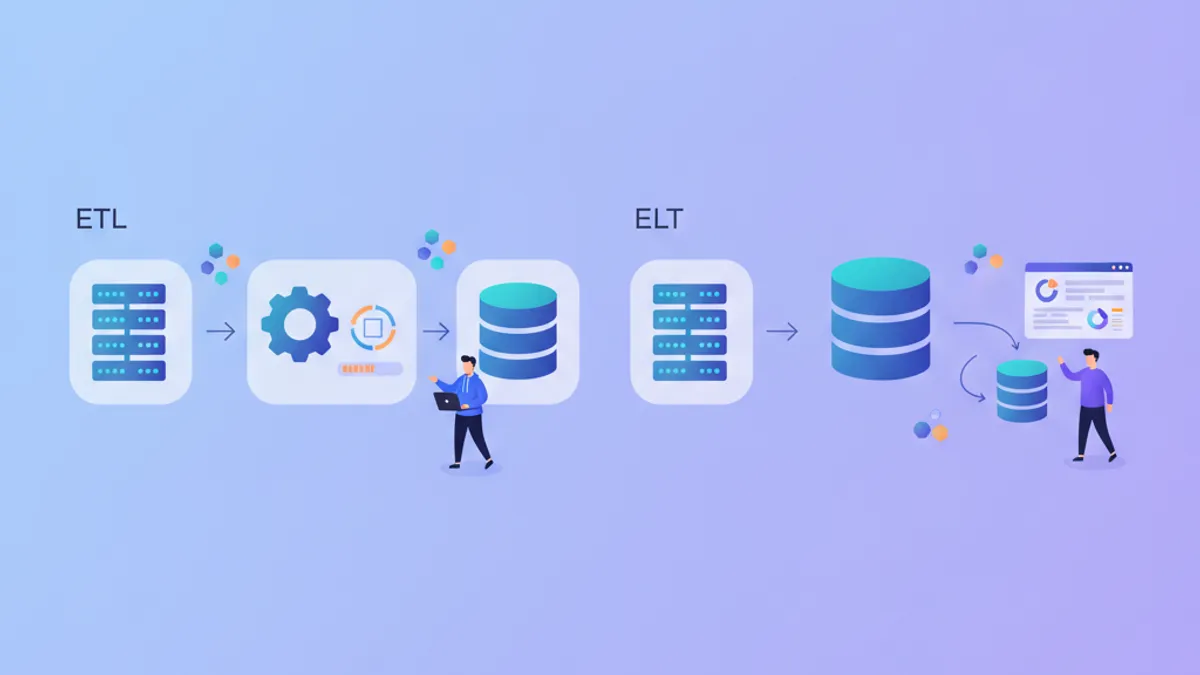
ETL vs ELT définit la manière dont les données circulent des systèmes sources vers les environnements analytiques. Le choix entre extraire, transformer puis charger (ETL) ou extraire, charger puis transformer (ELT) influence les coûts d'infrastructure, la fraîcheur des données et les compétences requises au sein des équipes d'ingénierie.
ETL transforme les données avant le chargement dans le système cible, nécessitant des ressources de calcul dédiées. ELT charge les données brutes en premier, puis les transforme en utilisant la puissance de traitement de l'entrepôt de destination. La plupart des stacks data cloud-natives en 2026 privilégient ELT car le calcul s'adapte à la demande.
Architecture ETL : Transformer Avant de Charger
L'ETL est apparu lorsque les entrepôts de données avaient une capacité de calcul limitée et que le stockage coûtait cher. Le pattern avait du sens : filtrer et agréger les données en dehors de l'entrepôt, charger uniquement ce que l'analyse requiert. Oracle Warehouse Builder, Informatica PowerCenter et Talend ont construit leurs outils autour de ce modèle.
L'étape de transformation dans l'ETL s'exécute sur des serveurs intermédiaires. Les données passent de la source vers une zone de staging, sont nettoyées et remodelées, puis chargées dans la destination. Cette approche réduit la charge de l'entrepôt mais crée un goulot d'étranglement au niveau de la couche de transformation.
# etl_pipeline.py
# Pattern ETL traditionnel avec transformation intermédiaire

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
L'ETL fonctionne bien lorsque la logique de transformation reste stable et que les volumes de données demeurent prévisibles. L'inconvénient se manifeste quand les exigences changent : modifier les transformations signifie retraiter les données historiques depuis le début.
Architecture ELT : Charger D'abord, Transformer dans l'Entrepôt
L'ELT déplace la transformation dans l'entrepôt de données. Snowflake, BigQuery, Databricks et Redshift fournissent une capacité de calcul quasi illimitée qui s'adapte à la complexité des requêtes. Charger les données brutes en premier préserve l'état source ; les transformations deviennent des modèles SQL versionnés et réexécutables sans nouvelle extraction.
Le projet dbt (data build tool) a popularisé l'ELT en traitant les transformations SQL comme du code. Au lieu de jobs ETL opaques, les transformations résident dans le contrôle de version sous forme d'instructions SELECT qui référencent les tables brutes et construisent des modèles dérivés.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggL'ELT préserve les données brutes, ce qui permet le retraitement lorsque la logique métier change. Si un calcul était erroné il y a six mois, corriger le modèle dbt et lancer un rafraîchissement complet corrige les données historiques. Avec l'ETL, la même correction nécessite une nouvelle extraction depuis des sources qui peuvent ne plus avoir les enregistrements originaux.
Tableau Comparatif : Compromis ETL vs ELT
| Facteur | ETL | ELT |
|---|---|---|
| Emplacement du calcul | Serveur de transformation dédié | Entrepôt de destination |
| Rétention des données brutes | Souvent supprimées après transformation | Préservées dans la zone d'atterrissage |
| Coût de retraitement | Nouvelle extraction depuis la source | Réexécution des modèles SQL |
| Flexibilité du schéma | Fixé au moment de la transformation | Schema-on-read possible |
| Exemples d'outils | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Idéal pour | Exigences stables, systèmes legacy | Exigences changeantes, entrepôts cloud |
| Latence | Plus élevée (transformation avant chargement) | Plus basse (chargement puis transformation) |
| Gouvernance des données | Plus simple (données filtrées avant l'entrepôt) | Nécessite des contrôles au niveau de l'entrepôt |
Prêt à réussir tes entretiens Data Engineering ?
Entraîne-toi avec nos simulateurs interactifs, fiches express et tests techniques.
Approches Hybrides : Quand ETL et ELT se Combinent
Les stacks data modernes utilisent rarement l'ETL ou l'ELT de manière pure. Apache Airflow orchestre des pipelines qui mélangent les deux patterns. Les données sensibles peuvent être anonymisées avant le chargement (une étape ETL), tandis que les agrégations s'exécutent dans l'entrepôt (ELT).
Fivetran et Airbyte extraient et chargent les données brutes sans transformation, puis dbt transforme à l'intérieur de l'entrepôt. Mais ces outils supportent aussi des transformations légères pendant l'extraction : sélection de colonnes, conversion de types de données, hachage des champs PII. Cela brouille la frontière ETL/ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Le pipeline ci-dessus extrait depuis Salesforce avec Airbyte (qui peut hacher les adresses email pendant la synchronisation), charge vers Snowflake, puis exécute les modèles dbt pour les transformations métier. Ni ETL pur ni ELT pur, mais pratique.
Questions d'Entretien : ETL vs ELT pour les Ingénieurs Data
Les entretiens techniques pour les postes d'ingénierie data dans les entreprises utilisant des stacks data modernes sondent la compréhension de l'architecture des pipelines. Ces questions apparaissent fréquemment, basées sur les patterns des modules de préparation aux entretiens ETL/ELT.
Question 1 : Quand Choisiriez-Vous ETL Plutôt Qu'ELT ?
Les bonnes réponses identifient des scénarios spécifiques :
- Exigences de conformité : Le RGPD ou HIPAA impose que certaines données n'atteignent jamais l'entrepôt sous forme brute. Les PII doivent être anonymisées ou supprimées avant le chargement.
- Contraintes d'entrepôt legacy : Les systèmes on-premises comme Teradata ou les anciennes configurations Redshift avec calcul fixe bénéficient de chargements pré-agrégés.
- Coûts réseau : Charger 10 To quotidiennement vers un entrepôt cloud, puis en supprimer 90% après transformation, gaspille la bande passante de sortie. Le pré-filtrage a un sens économique.
Les réponses faibles disent "l'ETL est obsolète" ou échouent à donner des scénarios concrets. Les recruteurs recherchent la nuance.
Question 2 : Comment Gérez-Vous les Changements de Schéma dans un Pipeline ELT ?
Cela teste la compréhension des zones d'atterrissage de données brutes. Sujets attendus :
- Colonnes JSON ou semi-structurées qui absorbent les nouveaux champs sans migration de schéma
- Modèles de staging qui sélectionnent explicitement les colonnes, isolant les modèles en aval des changements de source
- Macros dbt ou assertions Dataform qui font échouer les builds quand les colonnes attendues disparaissent
- Surveillance de la dérive de schéma avec des outils comme Monte Carlo ou Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Question 3 : Comparez l'Orchestration ETL avec Airflow vs l'Exécution dbt pour ELT
La question sonde la compréhension que ces outils résolvent des problèmes différents :
- Airflow orchestre des tâches : extraction, appels API, transferts de fichiers, entraînement de modèles. Il gère les dépendances entre des jobs hétérogènes.
- dbt transforme les données à l'intérieur d'un entrepôt. Il gère les dépendances entre les modèles SQL, exécute les tests, génère la documentation.
Un pipeline complet utilise souvent les deux : Airflow déclenche les synchronisations Airbyte, attend leur achèvement, puis déclenche les exécutions dbt. Savoir quand utiliser quel outil distingue les candidats seniors.
Question 4 : Votre Pipeline ELT Traite 500M de Lignes Quotidiennement et les Analystes Signalent des Requêtes Lentes
Cette question ouverte teste la pensée diagnostique :
- Vérifier la matérialisation des modèles : Les modèles lourds sont-ils encore des vues ? Les modèles incrémentaux ou les tables pourraient aider.
- Partitionner et clustériser : Pour BigQuery, les tables de faits sont-elles partitionnées par date ? Pour Snowflake, le clustering est-il optimisé pour les patterns de requêtes courants ?
- Pushdown des requêtes : Les analystes interrogent-ils les modèles de staging au lieu des marts pré-agrégés ?
- Dimensionnement de l'entrepôt : Le calcul est-il correctement dimensionné pendant les heures de requête ?
- Exigences de fraîcheur : La transformation pourrait-elle s'exécuter la nuit plutôt qu'aux heures ouvrables ?
Aucune réponse unique n'existe. Les recruteurs évaluent le dépannage systématique.
Paysage des Outils en 2026
Le marché de l'intégration de données s'est consolidé autour de quelques patterns :
Extraction et chargement : Fivetran, Airbyte, Stitch et Meltano gèrent la partie EL. Ces outils se connectent à des centaines de sources et synchronisent vers les entrepôts cloud sans code personnalisé.
Transformation : dbt domine la transformation basée sur SQL. Les alternatives incluent Dataform (maintenant partie de Google Cloud), SQLMesh (open source avec environnements de données virtuels) et Coalesce (modélisation visuelle).
Orchestration : Airflow reste la référence pour les pipelines complexes. Dagster et Prefect offrent des alternatives avec un meilleur développement local et des vues centrées sur les assets.
Qualité : Great Expectations, les tests dbt, Monte Carlo et Soda fournissent la surveillance de la qualité des données. Ces outils détectent les problèmes entre l'extraction et la consommation en aval.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Passe à la pratique !
Teste tes connaissances avec nos simulateurs d'entretien et tests techniques.
Sélectionner l'Architecture de Pipeline pour les Nouveaux Projets
Pour la plupart des projets greenfield en 2026, l'ELT est le choix par défaut. Le calcul dans les entrepôts cloud coûte moins cher que la maintenance de serveurs de transformation. La préservation des données brutes permet des corrections rétroactives. Les transformations basées sur SQL sont auditables et versionnées.
L'ETL reste pertinent pour :
- Les environnements réglementaires exigeant une minimisation des données avant l'entrée dans l'entrepôt
- Le streaming temps réel où la transformation doit se produire au moment de l'ingestion (Kafka Streams, Flink)
- Les scénarios d'edge computing avec stockage aval limité
- Les intégrations legacy où le système source contrôle le format d'export
La réponse prête pour l'entretien reconnaît les deux patterns et explique les compromis sans préférence idéologique.
Points Clés pour l'Architecture des Pipelines de Données
- ETL transforme les données avant le chargement, réduisant la charge de l'entrepôt mais créant une friction de retraitement quand la logique change
- ELT charge les données brutes en premier, permettant des transformations SQL versionnables, testables et réexécutables sur les données historiques
- Les stacks modernes combinent typiquement les deux : transformations d'extraction légères (hachage PII, conversion de types) avec agrégation basée sur l'entrepôt
- dbt est devenu le standard pour la transformation ELT, traitant les modèles SQL comme du code testable et documenté
- Les questions d'entretien sondent la sélection de scénarios, la gestion de l'évolution des schémas et les compromis d'outils plutôt que des définitions par cœur
- La préservation des données brutes dans les pipelines ELT permet de corriger les calculs historiques sans nouvelle extraction depuis les sources
Tu saurais repérer le bug en Data Engineering ?
Un vrai bout de code, un bug caché, une tentative par jour. Sans compte pour essayer.

Écrit par
Anthony Fillion-MailletFondateur de SharpSkill
Développeur fullstack depuis plus de 10 ans. Il dirige SharpSkill et répond de tout ce qui y est publié.
Mis à jour le 14 septembre 2026
Partager
Articles similaires
Great Expectations en 2026 : Validation de la Qualité des Données et Questions d'Entretien
Guide complet sur Great Expectations 1.22 pour la validation de la qualité des données. Expectations, Checkpoints, intégration Airflow et questions d'entretien data engineering.

Apache Beam vs Spark en 2026 : Pipelines Unifiés et Questions d'Entretien
Comparaison détaillée entre Apache Beam et Spark pour les pipelines de données en 2026. Portabilité, windowing, performances et questions d'entretien techniques.

Apache Flink en 2026 : Traitement de Flux, Event Time et Questions d'Entretien
Guide complet sur Apache Flink 2.3 pour le traitement de flux en temps réel. Watermarks, fenêtrage, gestion d'état et préparation aux entretiens data engineering.