Excel Power Query en 2026 : ETL pour analystes de données et questions d'entretien
Guide complet sur Excel Power Query pour l'ETL : transformations de données, langage M, fusion de requêtes et questions d'entretien pour analystes de données.
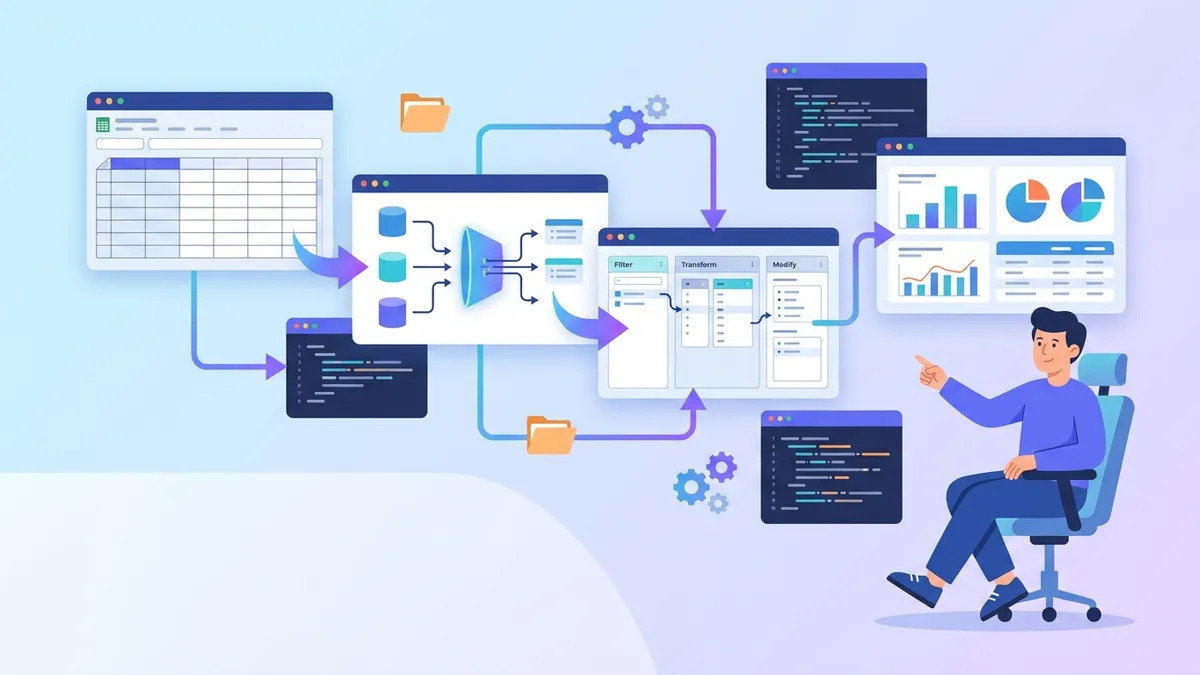
Excel Power Query révolutionne la manière dont les analystes de données gèrent les flux de travail ETL (Extract, Transform, Load) directement dans Excel. Contrairement aux opérations manuelles de copier-coller ou aux macros VBA complexes, Power Query offre une interface visuelle soutenue par le langage M, permettant des transformations de données reproductibles qui se rafraîchissent en un seul clic.
Power Query est intégré à Excel 365, Excel 2021, Excel 2019 et Excel 2016. Dans les versions antérieures, il était disponible sous forme de complément gratuit appelé « Power Query pour Excel ». Le même moteur alimente les dataflows de Power BI Desktop.
Ce que Power Query résout pour les analystes de données
Les analystes de données consacrent un temps considérable à la préparation des données : fusion de fichiers provenant de différentes sources, nettoyage de formats incohérents, filtrage des lignes non pertinentes et restructuration des tables pour l'analyse. Power Query traite ces tâches via un éditeur de requêtes qui enregistre chaque étape de transformation. Lorsque les données sources changent, l'ensemble du pipeline se réexécute automatiquement.
Le workflow suit trois étapes : connexion aux sources de données, application des transformations et chargement des résultats dans des tableaux Excel ou dans le modèle de données. Chaque étape est enregistrée dans la barre de formule en utilisant la syntaxe du langage M, qui peut être modifiée directement pour des scénarios avancés.
Cette approche diffère des formules Excel traditionnelles. Alors que les formules recalculent les cellules, Power Query opère sur des tables entières avant qu'elles n'atteignent la feuille de calcul. Une requête qui consolide 50 fichiers CSV, supprime les doublons et dépivote les colonnes s'exécute une seule fois et produit une table propre, plutôt que de construire des formules imbriquées complexes qui ralentissent le classeur.
Connexion aux sources de données avec Obtenir des données
Power Query prend en charge les connexions aux fichiers (CSV, Excel, JSON, XML), aux bases de données (SQL Server, MySQL, PostgreSQL, Oracle), aux services cloud (SharePoint, Azure, Salesforce) et aux pages web. Le type de connexion détermine les options d'authentification et d'importation qui apparaissent.
// Sources de données courantes dans Power Query
Données > Obtenir des données > À partir d'un fichier > À partir d'un fichier CSV
Données > Obtenir des données > À partir d'une base de données > À partir d'une base de données SQL Server
Données > Obtenir des données > À partir d'autres sources > À partir du web
Données > Obtenir des données > À partir d'un dossier (fichiers multiples)
L'option « À partir d'un dossier » est particulièrement utile pour consolider plusieurs fichiers. Au lieu d'importer chaque fichier séparément, Power Query analyse un dossier, liste tous les fichiers correspondants et les combine en une seule requête. L'ajout d'un nouveau fichier dans le dossier l'inclut automatiquement lors du prochain rafraîchissement.
Lors de la connexion à une base de données SQL, Power Query peut pousser la logique de transformation vers le serveur via le repliement de requête (query folding). Les filtres et sélections de colonnes se traduisent en clauses SQL WHERE et SELECT, réduisant les données transférées vers Excel. La barre de formule affiche l'option « Afficher la requête native » lorsque le repliement est actif.
Transformations principales dans l'Éditeur de requêtes
L'Éditeur de requêtes fournit des commandes de ruban pour les opérations courantes, mais comprendre le code M sous-jacent aide lorsque des personnalisations sont nécessaires. Chaque transformation ajoute une étape au volet « Étapes appliquées », créant une séquence auditable.
Filtrage et tri des lignes
Le filtrage supprime les lignes qui ne répondent pas aux critères. Le menu déroulant de l'en-tête de colonne fournit des filtres rapides, tandis que la boîte de dialogue « Filtrer les lignes » prend en charge des conditions complexes avec une logique ET/OU.
// Étape FilteredRows en langage M
let
    Source = Excel.CurrentWorkbook(){[Name="SalesData"]}[Content],
    FilteredRows = Table.SelectRows(Source, each [Region] = "EMEA" and [Amount] > 1000)
in
    FilteredRows
La fonction Table.SelectRows prend une table et une condition. Le mot-clé each crée une fonction où _ représente la ligne courante, et l'accès aux champs utilise la notation entre crochets [Region]. Les conditions multiples se combinent avec les opérateurs and ou or.
Suppression et renommage des colonnes
Les sources de données incluent souvent des colonnes inutiles pour l'analyse. Les supprimer tôt réduit l'utilisation de la mémoire et simplifie les étapes suivantes.
// Supprimer des colonnes, puis renommer celles restantes
let
    Source = Excel.CurrentWorkbook(){[Name="RawData"]}[Content],
    RemovedColumns = Table.RemoveColumns(Source, {"TempID", "InternalNotes", "Debug"}),
    RenamedColumns = Table.RenameColumns(RemovedColumns, {{"Cust_Name", "CustomerName"}, {"Amt", "Amount"}})
in
    RenamedColumns
La liste de colonnes utilise des accolades {} pour plusieurs éléments. Le renommage prend une liste de paires, où chaque paire contient l'ancien nom et le nouveau nom. Des conventions de nommage cohérentes entre les requêtes facilitent la combinaison des ensembles de données.
Fractionnement et fusion de colonnes
Les colonnes de texte nécessitent fréquemment une analyse. Une colonne « NomComplet » peut nécessiter un fractionnement en prénom et nom de famille, ou des colonnes séparées de date et d'heure peuvent nécessiter une fusion.
// Fractionner NomComplet par délimiteur en deux colonnes
let
    Source = Excel.CurrentWorkbook(){[Name="Contacts"]}[Content],
    SplitColumn = Table.SplitColumn(Source, "FullName", Splitter.SplitTextByDelimiter(" ", QuoteStyle.Csv), {"FirstName", "LastName"})
in
    SplitColumn
La fonction Splitter.SplitTextByDelimiter gère la logique d'analyse. Pour des motifs plus complexes, Splitter.SplitTextByEachDelimiter ou Splitter.SplitTextByPositions offrent un contrôle supplémentaire. Lorsque le nombre de colonnes résultantes varie, Power Query crée des colonnes dynamiquement.
Conversions de types et qualité des données
Power Query infère les types de colonnes lors de l'importation, mais l'attribution explicite des types détecte les erreurs tôt. Une colonne de texte contenant des identifiants numériques doit rester en texte si les zéros non significatifs sont importants. Les colonnes de dates importées en tant que texte causent des problèmes de tri.
// Attributions de types explicites
let
    Source = Csv.Document(File.Contents("C:\Data\transactions.csv")),
    TypedColumns = Table.TransformColumnTypes(Source, {
        {"TransactionID", type text},
        {"Date", type date},
        {"Amount", type number},
        {"IsProcessed", type logical}
    })
in
    TypedColumns
Le mot-clé type spécifie le type cible. Les types disponibles incluent text, number, date, datetime, datetimezone, time, duration, logical et binary. Les erreurs de type apparaissent comme des valeurs « Erreur » dans les cellules, rendant les problèmes de qualité des données visibles avant l'analyse.
La gestion des valeurs null nécessite une logique explicite. La fonction Table.ReplaceValue substitue les nulls par des valeurs par défaut, tandis que Table.SelectRows avec [Column] <> null les filtre.
Regroupement et agrégation avec Grouper par
L'agrégation des données par catégories est une exigence fréquente. La transformation « Grouper par » réduit les lignes partageant les mêmes valeurs de clé et applique des fonctions d'agrégation.
// Grouper les ventes par région et année, calculer la somme et le nombre
let
    Source = Excel.CurrentWorkbook(){[Name="Sales"]}[Content],
    Grouped = Table.Group(Source, {"Region", "Year"}, {
        {"TotalSales", each List.Sum([Amount]), type number},
        {"OrderCount", each Table.RowCount(_), Int64.Type},
        {"AvgOrderValue", each List.Average([Amount]), type number}
    })
in
    Grouped
Les colonnes de regroupement apparaissent en premier, suivies des définitions d'agrégation. Chaque agrégation spécifie un nouveau nom de colonne, une fonction d'agrégation et un type de résultat optionnel. Le mot-clé each représente la sous-table pour chaque groupe, permettant n'importe quelle fonction de table ou de liste.
Les agrégations imbriquées permettent des calculs comme « pourcentage du total du groupe » en référençant à la fois la valeur de la ligne et l'agrégat du groupe dans une étape ultérieure.
Prêt à réussir tes entretiens Data Analytics ?
Entraîne-toi avec nos simulateurs interactifs, fiches express et tests techniques.
Pivot et Dépivot pour la restructuration des données
Le pivot convertit les valeurs de lignes en colonnes, créant une disposition en tableau croisé. Le dépivot fait l'inverse, convertissant les colonnes en lignes pour des structures normalisées.
// Dépivoter les colonnes de mois en lignes
let
    Source = Excel.CurrentWorkbook(){[Name="MonthlySales"]}[Content],
    // Original : colonnes Product, Jan, Feb, Mar, Apr
    Unpivoted = Table.UnpivotOtherColumns(Source, {"Product"}, "Month", "Sales")
    // Résultat : colonnes Product, Month, Sales
in
    Unpivoted
La fonction Table.UnpivotOtherColumns garde les colonnes spécifiées fixes et dépivote le reste. C'est plus sûr que de lister toutes les colonnes à dépivoter, car l'ajout de nouvelles colonnes de mois les inclut automatiquement. Les deux derniers paramètres nomment la colonne d'attribut (« Month ») et la colonne de valeur (« Sales »).
Le pivot utilise Table.Pivot avec une fonction d'agrégation pour les cas où plusieurs valeurs existent pour la même combinaison ligne-colonne :
// Pivoter les ventes par région
let
    Source = Excel.CurrentWorkbook(){[Name="DetailedSales"]}[Content],
    Pivoted = Table.Pivot(Source, List.Distinct(Source[Region]), "Region", "Amount", List.Sum)
in
    Pivoted
Fusion et ajout de requêtes
La combinaison de données provenant de plusieurs sources est l'endroit où Power Query réduit l'effort manuel. La fusion effectue une jointure entre deux tables basée sur des colonnes correspondantes. L'ajout empile les tables verticalement.
// Jointure gauche : Commandes avec détails Client
let
    Orders = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    Customers = Excel.CurrentWorkbook(){[Name="Customers"]}[Content],
    Merged = Table.NestedJoin(Orders, {"CustomerID"}, Customers, {"ID"}, "CustomerDetails", JoinKind.LeftOuter),
    Expanded = Table.ExpandTableColumn(Merged, "CustomerDetails", {"Name", "Email"})
in
    Expanded
La fonction Table.NestedJoin crée une colonne de table imbriquée contenant les lignes correspondantes. La fonction Table.ExpandTableColumn aplatit ensuite la structure imbriquée en colonnes régulières. Les types de jointure incluent Inner, LeftOuter, RightOuter, FullOuter, LeftAnti et RightAnti.
L'ajout avec Table.Combine nécessite des noms de colonnes correspondants. Lorsque les schémas diffèrent, Table.SelectColumns sur chaque source avant la combinaison assure la cohérence :
// Ajouter deux tables de ventes avec des colonnes cohérentes
let
    Sales2024 = Table.SelectColumns(Source2024, {"Date", "Product", "Amount"}),
    Sales2025 = Table.SelectColumns(Source2025, {"Date", "Product", "Amount"}),
    Combined = Table.Combine({Sales2024, Sales2025})
in
    Combined
Colonnes personnalisées et logique conditionnelle
La fonctionnalité « Ajouter une colonne > Colonne personnalisée » permet des champs calculés utilisant des expressions M. La logique conditionnelle utilise la syntaxe if-then-else.
// Ajouter une colonne calculée avec logique conditionnelle
let
    Source = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    AddedColumn = Table.AddColumn(Source, "OrderCategory", each
        if [Amount] >= 10000 then "Enterprise"
        else if [Amount] >= 1000 then "Business"
        else "Consumer",
        type text
    )
in
    AddedColumn
L'expression if doit inclure les branches then et else. Les conditions imbriquées s'enchaînent avec else if. Le dernier paramètre spécifie le type de colonne, améliorant les performances et prévenant les problèmes d'inférence de type.
Pour les transformations complexes, les fonctions auxiliaires définies dans le bloc let maintiennent la lisibilité du code :
let
    // Fonction auxiliaire pour le trimestre fiscal
    GetFiscalQuarter = (date as date) as text =>
        let
            month = Date.Month(date),
            fiscalQ = if month >= 4 and month <= 6 then "Q1"
                     else if month >= 7 and month <= 9 then "Q2"
                     else if month >= 10 and month <= 12 then "Q3"
                     else "Q4"
        in
            fiscalQ,

    Source = Excel.CurrentWorkbook(){[Name="Transactions"]}[Content],
    AddedQuarter = Table.AddColumn(Source, "FiscalQuarter", each GetFiscalQuarter([Date]), type text)
in
    AddedQuarter
Gestion des erreurs dans Power Query
Les erreurs de transformation apparaissent comme des valeurs « Erreur » dans les cellules plutôt que de faire échouer toute la requête. La construction try-otherwise gère les erreurs gracieusement :
// Gérer les erreurs potentielles de division
let
    Source = Excel.CurrentWorkbook(){[Name="Metrics"]}[Content],
    AddedRatio = Table.AddColumn(Source, "Ratio", each
        try [Value1] / [Value2] otherwise null,
        type number
    )
in
    AddedRatio
Le mot-clé try tente l'expression et retourne un enregistrement avec les champs HasError et Value. La clause otherwise fournit une valeur de repli lorsque HasError est vrai. Pour plus de contrôle, accédez aux détails de l'erreur avec try Expression :
// Capturer les détails de l'erreur
let
    result = try SomeRiskyFunction(),
    output = if result[HasError] then "Error: " & result[Error][Message] else result[Value]
in
    output
Questions d'entretien Power Query pour analystes de données
Les recruteurs évaluent à la fois les compétences pratiques et la compréhension de quand Power Query s'intègre dans un workflow. Ces questions apparaissent fréquemment dans les entretiens pour analystes de données.
Qu'est-ce que le repliement de requête (query folding) et pourquoi est-il important ?
Le repliement de requête traduit les transformations Power Query en requêtes natives pour la source de données. Lors de la connexion à SQL Server, une étape de filtrage devient une clause WHERE exécutée sur le serveur, réduisant le transfert réseau. Toutes les transformations ne se replient pas : les fonctions M personnalisées, certaines manipulations de dates et les opérations après une étape non repliable cassent la chaîne. Vérifiez le statut du repliement en cliquant droit sur une étape et en cherchant « Afficher la requête native ».
En quoi Power Query diffère-t-il des formules Excel pour la transformation de données ?
Les formules Excel opèrent cellule par cellule dans la feuille de calcul et recalculent à chaque modification. Power Query opère sur les tables avant qu'elles n'atteignent la feuille de calcul, traitant les données en masse lors du rafraîchissement. Pour des transformations comme le dépivotement, la déduplication ou la fusion de fichiers, Power Query exprime la logique plus directement que des formules INDEX-EQUIV imbriquées ou des colonnes auxiliaires.
Quand choisir Power Query plutôt que Power BI pour l'ETL ?
Power Query dans Excel convient aux scénarios où les analystes ont besoin de données transformées sous forme de feuille de calcul pour une analyse ad-hoc, des tableaux croisés dynamiques ou un partage avec des utilisateurs n'ayant pas accès à Power BI. Power BI offre une visualisation plus riche, une plus grande capacité de données et des fonctionnalités de partage d'entreprise. Le même code M fonctionne dans les deux outils, donc les requêtes développées dans Excel peuvent migrer vers Power BI Desktop sans réécriture.
Comment gérer les incompatibilités de types de données lors de l'ajout de tables ?
Définissez des types explicites sur chaque table source avant de combiner avec Table.Combine. Si une colonne est en texte dans une source et en nombre dans une autre, l'ajout échoue ou produit des erreurs. Utilisez Table.TransformColumnTypes sur les deux sources pour imposer des types cohérents. Le pattern try-otherwise gère les cas limites où la conversion échoue pour des valeurs spécifiques.
Expliquez la différence entre Fusionner et Ajouter dans Power Query.
Fusionner effectue une jointure horizontale basée sur des colonnes de clé correspondantes, similaire à SQL JOIN. Ajouter effectue une union verticale des lignes de plusieurs tables, similaire à SQL UNION ALL. Fusionner nécessite au moins une colonne commune pour la correspondance. Ajouter nécessite que les colonnes portant les mêmes noms s'alignent correctement.
Pour une préparation plus approfondie sur les concepts SQL qui complètent les compétences Power Query, le module sur les fonctions de fenêtrage SQL couvre les patterns de classement et d'agrégation, tandis que le module sur les sous-requêtes et CTE SQL aborde les techniques de structuration des requêtes.
Options de chargement et stratégies de rafraîchissement
Après les transformations, le bouton « Fermer et charger » offre des choix de chargement : charger dans un tableau de feuille de calcul, charger uniquement dans le modèle de données (Power Pivot), ou créer une requête de connexion uniquement. Les requêtes de connexion uniquement servent d'étapes intermédiaires pour d'autres requêtes sans consommer d'espace dans la feuille de calcul.
Le comportement de rafraîchissement dépend de la destination de chargement. Les tableaux de feuille de calcul se rafraîchissent avec le bouton « Actualiser tout » ou peuvent être configurés pour se rafraîchir à l'ouverture du fichier. Les tables du modèle de données participent au cycle de rafraîchissement du modèle de données du classeur. Pour les requêtes connectées à des bases de données externes, des invites d'identification peuvent apparaître lors du rafraîchissement sauf si des informations d'identification enregistrées existent.
Le rafraîchissement en arrière-plan permet au classeur de rester utilisable pendant le chargement des données, mais crée de la complexité lorsque des formules en aval dépendent des données rafraîchies. L'option « Activer le rafraîchissement en arrière-plan » dans les propriétés de la requête contrôle ce comportement. Pour les rapports critiques, désactiver le rafraîchissement en arrière-plan assure une exécution séquentielle.
Considérations de performance pour les grands ensembles de données
Power Query peut gérer des millions de lignes, mais la réactivité du classeur dépend de la façon dont les données se chargent. Charger dans le modèle de données au lieu des tableaux de feuille de calcul évite la limite de lignes d'Excel et améliore les performances des tableaux croisés dynamiques. Supprimer les colonnes inutiles tôt réduit l'empreinte mémoire.
Pour les requêtes qui prennent plusieurs minutes, l'« Aperçu des données » dans l'Éditeur de requêtes n'affiche qu'un échantillon. Les transformations s'appliquent à l'ensemble des données lors du rafraîchissement. Les erreurs visibles dans l'aperçu indiquent des problèmes, mais certaines erreurs n'apparaissent qu'avec les données complètes. Exécuter un rafraîchissement de test sur un sous-ensemble valide la requête avant de tout traiter.
Lors de la consolidation de nombreux fichiers, la fonctionnalité de combinaison binaire de Power Query traite les fichiers en parallèle. Définir une fonction qui transforme un fichier, puis l'invoquer pour chaque ligne de la liste de fichiers, offre plus de contrôle que l'approche de combinaison par défaut.
La documentation Microsoft sur les meilleures pratiques Power Query détaille les techniques d'optimisation incluant les structures de dépendance des requêtes et l'utilisation des tampons.
Power Query pour des pipelines ETL reproductibles
Les étapes enregistrées dans Power Query créent une documentation de la logique de transformation. Lorsque les exigences changent, la modification d'une étape met à jour automatiquement toutes les étapes en aval. Cela contraste avec les manipulations Excel ad-hoc qui nécessitent une recréation à partir de zéro lorsque les données sources changent.
Les équipes peuvent partager des requêtes en exportant des connexions ou en stockant le code M des requêtes dans un contrôle de version. L'Éditeur avancé (Affichage > Éditeur avancé) affiche le script M complet, qui peut être copié et collé dans un autre classeur. Pour les scénarios d'entreprise, les dataflows Power BI et Fabric fournissent une gestion centralisée des requêtes.
- Power Query gère l'ETL dans Excel en utilisant des étapes de transformation enregistrées et reproductibles
- Le langage M sous-jacent à l'interface visuelle permet des personnalisations au-delà des commandes du ruban
- Le repliement de requête pousse les filtres et projections vers les bases de données sources pour de meilleures performances
- Fusionner effectue des jointures entre tables, Ajouter empile les tables verticalement
- Les attributions de types et la gestion des erreurs préviennent les problèmes silencieux de qualité des données
- Les requêtes de connexion uniquement créent des étapes intermédiaires réutilisables sans sortie de feuille de calcul
- Les questions d'entretien se concentrent sur le repliement de requête, la comparaison avec les formules et les distinctions entre fusionner et ajouter
Passe à la pratique !
Teste tes connaissances avec nos simulateurs d'entretien et tests techniques.
Tu saurais repérer le bug en Data Analytics ?
Un vrai bout de code, un bug caché, une tentative par jour. Sans compte pour essayer.

Écrit par
Anthony Fillion-MailletFondateur de SharpSkill
Développeur fullstack depuis plus de 10 ans. Il dirige SharpSkill et répond de tout ce qui y est publié.
Mis à jour le 20 septembre 2026
Partager
Articles similaires
Questions Entretien Data Analyst 2026 : Guide Complet SQL, Python et Analytics
Maîtrisez les questions d'entretien data analyst les plus fréquentes en 2026. Fonctions SQL window, manipulation pandas, statistiques et études de cas métier avec exemples de code pratiques.
Questions d'Entretien Data Analyst Italie 2026 : SQL Avancé, Python et Études de Cas
Préparer les entretiens Data Analyst en Italie avec des questions réelles des entreprises italiennes en 2026. SQL avancé, Python pandas, études de cas et processus de recrutement italien.
Polars vs Pandas en 2026 : Performance, Syntaxe et Questions d'Entretien pour Analystes de Données
Comparaison approfondie entre Polars et Pandas en 2026 avec benchmarks de performance, différences syntaxiques et questions d'entretien technique pour analystes de données.