Nguyên tắc SRE năm 2026: Kỹ thuật độ tin cậy, SLO và câu hỏi phỏng vấn
Nguyên tắc SRE cho năm 2026: cách chọn SLI, đặt SLO, tính error budget, viết alert burn rate đa cửa sổ trong Prometheus và trả lời các câu hỏi phỏng vấn SRE xuất hiện thường xuyên nhất.
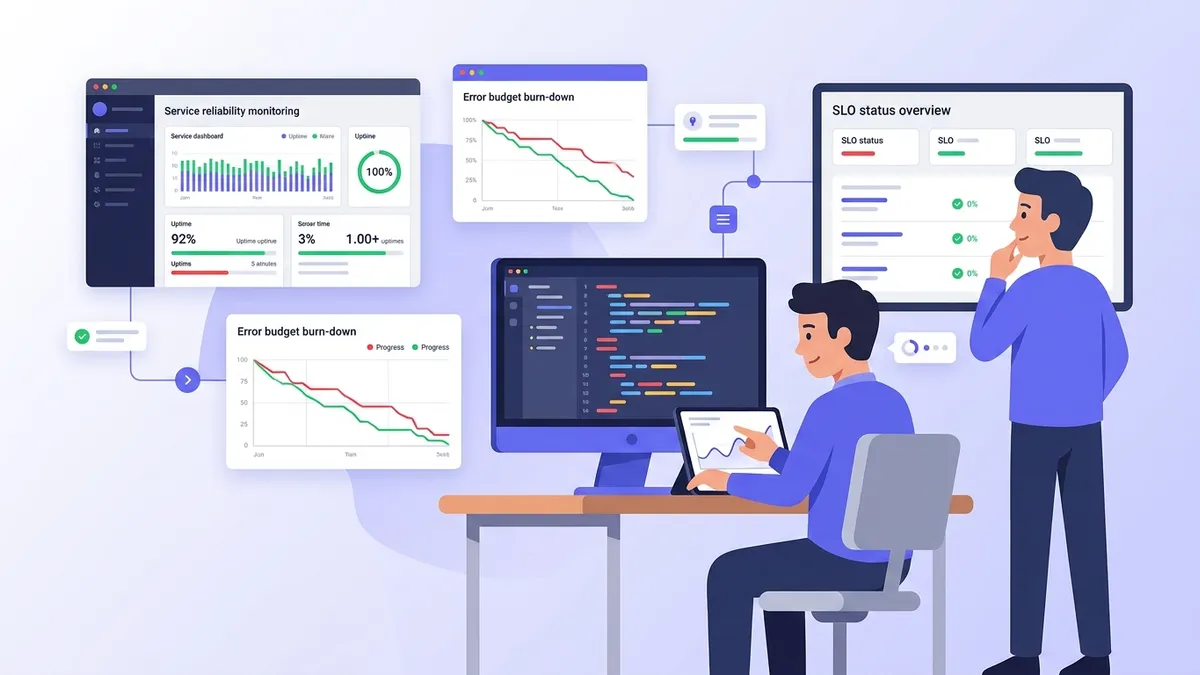
Các nguyên tắc SRE biến độ tin cậy từ một mục tiêu mơ hồ thành một con số cụ thể mà cả đội kỹ thuật lẫn đội sản phẩm cùng thống nhất, rồi dùng chính con số đó để quyết định khi nào được phát hành và khi nào cần dừng lại. Site reliability engineering, khởi nguồn từ Google và hiện được áp dụng ở hầu hết các đội platform, dựa trên vài ý tưởng cốt lõi: đo lường những gì người dùng thực sự trải nghiệm (SLI), đặt mục tiêu thấp hơn 100% (SLO), sử dụng phần chênh lệch như một error budget, và giới hạn khối lượng công việc thủ công để duy trì hệ thống. Các câu hỏi phỏng vấn SRE năm 2026 kiểm tra đúng những ý tưởng này, thường bằng cách yêu cầu ứng viên định nghĩa SLO cho một dịch vụ thực tế và viết alert để bảo vệ nó.
SLI là phép đo: tỷ lệ giữa số sự kiện tốt và số sự kiện hợp lệ, ví dụ số request thành công chia cho tổng số request. SLO là mục tiêu nội bộ cho tỷ lệ đó trong một khoảng thời gian, ví dụ 99,9% trong 30 ngày. SLA là cam kết theo hợp đồng với khách hàng, đi kèm điều khoản phạt, và luôn lỏng hơn SLO.
Những nguyên tắc nền tảng của site reliability engineering
Cuốn sách SRE của Google xem độ tin cậy là một tính năng có chi phí. Mỗi con số chín được thêm vào đòi hỏi nhiều thời gian kỹ thuật hơn và làm chậm tốc độ phát hành. Trong khi đó, người dùng gần như không nhận ra sự khác biệt giữa 99,99% và 99,999%, bởi chính mạng, thiết bị và nhà cung cấp internet của họ còn kém tin cậy hơn thế. Mục tiêu là mức độ tin cậy phù hợp, không phải mức tối đa.
Từ điểm xuất phát đó, một số nguyên tắc được hình thành:
- Độ tin cậy được đo từ phía người dùng. Mức sử dụng CPU hay số lần pod khởi động lại chỉ là nguyên nhân. Thanh toán thất bại và trang tải chậm mới là thứ người dùng gặp phải, và đó chính là điều SLI cần phản ánh.
- 100% là mục tiêu sai. Một SLO 100% đồng nghĩa với việc cấm mọi thay đổi, vì lần deploy nào cũng tiềm ẩn rủi ro. Khoảng trống dưới 100% chính là error budget, và nó được tạo ra để chi tiêu cho các bản phát hành, thử nghiệm và di chuyển hệ thống.
- Toil bị giới hạn. Hướng dẫn của Google trong chương về loại bỏ toil giữ công việc vận hành dưới 50% thời gian của một kỹ sư SRE. Toil là công việc thủ công, lặp đi lặp lại, có thể tự động hóa và tăng tuyến tính theo quy mô dịch vụ. Thời gian còn lại dành cho công việc kỹ thuật nhằm loại bỏ chính toil đó.
- Postmortem không đổ lỗi (blameless). Buổi rà soát sự cố đặt câu hỏi điều gì trong hệ thống đã cho phép sự cố xảy ra, chứ không hỏi ai đã gõ lệnh. Một kỹ sư bị đổ lỗi sẽ che giấu thông tin, còn một buổi rà soát không đổ lỗi giúp thông tin được đưa ra ánh sáng.
- Giám sát cảnh báo dựa trên triệu chứng. Một page chỉ được gửi khi người dùng đang hoặc sắp bị ảnh hưởng, không phải khi một node đơn lẻ có biểu hiện bất thường.
Trong phỏng vấn, nguyên tắc thứ hai là yếu tố phân biệt một SRE dày dạn kinh nghiệm với người chỉ mới đọc sách. Câu trả lời ở cấp junior coi error budget là mức chịu đựng lỗi. Câu trả lời ở cấp senior coi nó là công cụ quản lý phát hành: cơ chế giúp đội sản phẩm và đội độ tin cậy tranh luận bằng dữ liệu thay vì cảm tính.
Lựa chọn SLI phản ánh trải nghiệm người dùng
Một SLI tốt là một tỷ lệ nằm trong khoảng từ 0 đến 1, được tính từ những sự kiện mà người dùng có thể nhận biết. SRE workbook gợi ý một danh sách ngắn tùy theo loại dịch vụ:
| Loại dịch vụ | SLI thường dùng | Điểm đo |
|---|---|---|
| API xử lý request | Tính sẵn sàng, độ trễ | Log của load balancer hoặc ingress, metric máy chủ |
| Data pipeline | Độ mới, độ chính xác, độ bao phủ | Timestamp đầu ra của pipeline, job kiểm tra |
| Hệ thống lưu trữ | Độ bền dữ liệu, độ trễ đọc và ghi | Tầng lưu trữ, probe tổng hợp |
| Frontend | Thời gian tải trang, tỷ lệ lỗi phía trình duyệt | Real user monitoring |
Đo tại load balancer giúp phát hiện những lỗi mà ứng dụng không bao giờ thấy, chẳng hạn một pod bị crash và không trả về gì cả. Đo tại trình duyệt phát hiện được sự cố CDN và DNS nhưng lại thêm nhiễu từ các kết nối di động kém. Phần lớn các đội bắt đầu từ load balancer hoặc ingress vì dữ liệu đã có sẵn.
Với Prometheus, hai SLI kinh điển cho một dịch vụ HTTP là tỷ lệ sẵn sàng và tỷ lệ độ trễ. SLI độ trễ coi các request nhanh hơn một ngưỡng nhất định là tốt, nhờ đó nó vẫn là một tỷ lệ giống các SLI khác thay vì một percentile.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Có hai chi tiết thường được hỏi trong phỏng vấn. Thứ nhất, phản hồi 4xx thường được tính là hợp lệ và tốt, vì lỗi 404 hay lỗi validation là do phía client. Nếu tính chúng là lỗi, một client hoạt động sai có thể đốt sạch budget. Thứ hai, ngưỡng độ trễ phải trùng với một ranh giới bucket của histogram, nếu không truy vấn sẽ không trả về kết quả hoặc âm thầm dùng sai bucket. Prometheus 3.16, phát hành ngày 5 tháng 11 năm 2026, hỗ trợ native histogram giúp loại bỏ ràng buộc bucket cố định, nhưng tính năng này cần được bật ở phía scrape.
Đặt mục tiêu SLO và tính toán error budget
Một SLO gồm ba thành phần: SLI, mục tiêu và cửa sổ thời gian. Cửa sổ thường là cửa sổ trượt (rolling) 28 hoặc 30 ngày, để budget phục hồi dần dần thay vì bị đặt lại vào ngày đầu tháng. Mục tiêu được chọn dựa trên hiệu năng trong quá khứ và kỳ vọng của người dùng, chứ không phải một con số nghe hay trên slide thuyết trình.
Bảng dưới đây cho thấy mỗi mục tiêu cho phép bao nhiêu trong cửa sổ 30 ngày. Đây chỉ là phép tính đơn giản: budget bằng (1 - SLO) × 30 ngày.
| Mục tiêu SLO | Error budget | Thời gian ngừng hoàn toàn cho phép trong 30 ngày |
|---|---|---|
| 99% | 1% | 7 giờ 12 phút |
| 99,5% | 0,5% | 3 giờ 36 phút |
| 99,9% | 0,1% | 43 phút 12 giây |
| 99,95% | 0,05% | 21 phút 36 giây |
| 99,99% | 0,01% | 4 phút 19 giây |
Với SLO dựa trên request, budget được tính bằng số request thay vì số phút. Ở mức 99,9% với 12 triệu request trong cửa sổ, hệ thống được phép có 12.000 request thất bại. Budget dựa trên request công bằng hơn với những dịch vụ có lưu lượng không đều, vì một sự cố lúc 3 giờ sáng tiêu tốn ít budget hơn cùng sự cố đó vào giờ cao điểm.
Một bài tập phỏng vấn phổ biến là tính phần budget còn lại và tốc độ tiêu hao của nó. Đoạn script sau là dạng câu trả lời được kỳ vọng khi đề bài yêu cầu viết code.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Burn rate bằng 15 nghĩa là dịch vụ đang lỗi ở 1,5% số request, trong khi SLO chỉ cho phép 0,1%. Với tốc độ này, 35% budget còn lại sẽ cạn trong chưa đầy 17 giờ, đủ lý do để đánh thức kỹ sư trực on-call.
Sẵn sàng chinh phục phỏng vấn DevOps?
Luyện tập với mô phỏng tương tác, flashcards và bài kiểm tra kỹ thuật.
Cảnh báo burn rate với nhiều cửa sổ thời gian
Đặt alert trực tiếp lên SLI ("tỷ lệ lỗi trên 0,1%") sẽ tạo ra page cho mọi đợt tăng vọt ngắn, nhưng lại bỏ sót những rò rỉ diễn ra chậm. Chương về alerting dựa trên SLO trong SRE workbook khuyến nghị dùng alert đa cửa sổ, đa burn rate. Mỗi alert trả lời một câu hỏi duy nhất: budget có đang bị tiêu nhanh đến mức sẽ cạn trước khi có người kịp xem xét hay không?
Các ngưỡng tham chiếu cho cửa sổ 30 ngày như sau:
| Mức độ | Cửa sổ dài | Cửa sổ ngắn | Burn rate | Budget đã tiêu khi alert kích hoạt |
|---|---|---|---|---|
| Page | 1 giờ | 5 phút | 14,4 | 2% |
| Page | 6 giờ | 30 phút | 6 | 5% |
| Ticket | 3 ngày | 6 giờ | 1 | 10% |
Cửa sổ dài mang lại ý nghĩa thống kê: một phút tồi tệ không đủ để gửi page. Cửa sổ ngắn, bằng một phần mười hai cửa sổ dài, giúp alert tắt nhanh sau khi sự cố kết thúc, để page không tiếp tục kêu suốt một giờ sau khi đã khắc phục. Cả hai điều kiện phải đúng cùng lúc.
Khối đầu tiên ghi lại tỷ lệ lỗi ở từng cửa sổ để biểu thức alert luôn nhẹ. Khối thứ hai định nghĩa hai alert dạng page cho SLO 99,9%, với tỷ lệ budget là 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageViết tay những rule này cho từng dịch vụ nhanh chóng trở nên lặp lại. Sloth, một công cụ sinh SLO mã nguồn mở, nhận một đặc tả ngắn gọn và tạo ra các recording rule cùng alert đa burn rate như trên. Placeholder {{.window}} được thay thế bằng từng cửa sổ mà Sloth cần.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Những đội muốn một định dạng trung lập với nhà cung cấp có thể tham khảo đặc tả OpenSLO, mô tả SLO bằng YAML mà không phụ thuộc vào backend giám sát.
Chính sách error budget và quyết định phát hành
Một error budget không có chính sách đi kèm chỉ là một dashboard không ai hành động theo. Ví dụ về error budget policy trong SRE workbook mô tả rõ điều gì xảy ra khi budget cạn, và ai đã phê duyệt điều đó từ trước.
Một chính sách điển hình bao gồm:
- Điều kiện kích hoạt. Dịch vụ đã vượt quá error budget trong cửa sổ trượt.
- Hệ quả. Dừng phát hành tính năng, ngoại trừ bản vá bảo mật và các thay đổi cải thiện độ tin cậy, cho đến khi dịch vụ quay lại trong phạm vi SLO.
- Ngoại lệ. Một sự cố đơn lẻ do phụ thuộc nằm ngoài tầm kiểm soát của đội có thể được loại trừ, với quyết định được ghi lại bằng văn bản.
- Leo thang. Bất đồng được chuyển lên một vai trò được chỉ định trước, chẳng hạn CTO, thay vì người nói to nhất.
Chính sách được đội sản phẩm và đội kỹ thuật ký trước lần vi phạm đầu tiên, và đó chính là mục đích cốt lõi: việc đóng băng phát hành trở thành một quy tắc đã thống nhất, không còn là cuộc tranh cãi giữa lúc sự cố. Người phỏng vấn cũng thường hỏi điều gì xảy ra khi budget liên tục không được dùng đến. Câu trả lời được kỳ vọng là SLO có thể quá lỏng, hoặc đội đang phát hành quá thận trọng, và budget nên được dùng cho các bản phát hành nhanh hơn hoặc những đợt di chuyển hệ thống mạo hiểm hơn.
Đặt SLO nội bộ bằng đúng SLA với khách hàng sẽ không còn biên an toàn: lần vi phạm SLO đầu tiên đã là một khoản phạt hợp đồng. SLO cần chặt hơn SLA, để alert kích hoạt và việc đóng băng bắt đầu trong khi hợp đồng vẫn được đảm bảo.
Giảm toil, trực on-call và postmortem không đổ lỗi
Thời gian của SRE được chia giữa vận hành và kỹ thuật. Vận hành bao gồm trực on-call, xử lý ticket và can thiệp thủ công. Kỹ thuật bao gồm tự động hóa, lập kế hoạch năng lực và các tính năng tăng độ tin cậy. Khi toil vượt quá ngưỡng 50%, đội SRE trả bớt công việc về cho đội phát triển hoặc đầu tư vào tự động hóa. Nếu không, đội SRE sẽ chỉ là một đội vận hành mang chức danh mới.
Sức khỏe của ca trực được đo lường, không phải phỏng đoán. Các tín hiệu hữu ích gồm số page mỗi ca, tỷ lệ page thực sự cần hành động và thời gian xác nhận (time to acknowledge). Một page không đòi hỏi hành động nào là lỗi của hệ thống cảnh báo và cần được sửa hoặc xóa bỏ. Alert dựa trên triệu chứng theo burn rate SLO, như các rule ở trên, giảm đáng kể số lượng page so với alert theo CPU, bộ nhớ hay việc khởi động lại của từng pod.
Khi sự cố xảy ra, chương về văn hóa postmortem trong sách SRE mô tả buổi rà soát tiếp theo. Một bản postmortem ghi lại tác động theo đơn vị SLO (đã tiêu bao nhiêu budget), dòng thời gian, các yếu tố góp phần và danh sách action item có người phụ trách cùng thời hạn. Bản này tránh nêu tên một cá nhân như nguyên nhân. Hai câu hỏi tiếp nối thường gặp: làm sao đảm bảo action item thực sự được hoàn thành (theo dõi chúng trong cùng backlog với tính năng và rà soát trong một cuộc họp định kỳ), và khi nào bắt buộc phải viết postmortem (mọi sự cố tiêu tốn một phần đáng kể budget, mọi page đánh thức ai đó, mọi trường hợp mất dữ liệu).
Bốn golden signal trong sách SRE gồm độ trễ, lưu lượng, lỗi và mức bão hòa, hoàn thiện bức tranh giám sát. Độ trễ và lỗi thường trở thành SLI. Lưu lượng và mức bão hòa phục vụ việc lập kế hoạch năng lực và dashboard hơn là gửi page.
Câu hỏi phỏng vấn SRE kèm câu trả lời mong đợi
Dưới đây là những câu hỏi lặp lại trong các vòng phỏng vấn SRE và DevOps cấp senior, cùng phần cốt lõi của một câu trả lời tốt. Module phỏng vấn về nguyên tắc SRE luyện tập chính những chủ đề này, còn module alerting và incident response đi sâu vào khía cạnh trực on-call.
H: SLI, SLO và SLA khác nhau như thế nào?
SLI là tỷ lệ được đo, SLO là mục tiêu nội bộ cho tỷ lệ đó trong một cửa sổ thời gian, còn SLA là hợp đồng với bên ngoài có điều khoản phạt. SLO chặt hơn SLA để đội kịp phản ứng trước khi phát sinh thiệt hại tài chính.
H: Vì sao không đặt SLO ở mức 100%?
Vì mọi thay đổi đều có rủi ro, nên mục tiêu 100% đồng nghĩa với việc cấm phát hành. Người dùng cũng không thể cảm nhận độ tin cậy vượt quá mạng của chính họ. Khoảng trống dưới 100% là error budget, nguồn lực dành cho các bản phát hành.
H: Hãy định nghĩa SLO cho một API thanh toán (checkout).
Câu trả lời tốt chọn hai SLI (tính sẵn sàng không tính 4xx là lỗi, và độ trễ dưới một ngưỡng, đo tại load balancer), cửa sổ trượt 30 ngày, mục tiêu dựa trên dữ liệu quý gần nhất, sau đó giải thích cách alerting và error budget policy được xây dựng từ đó. Câu trả lời yếu điển hình chỉ nêu "uptime 99,99%" mà không nói rõ đo cái gì.
H: Vì sao alert dựa trên percentile như độ trễ p99 không phù hợp làm alert SLO?
p99 trên một cửa sổ ngắn rất nhiễu và không thể cộng gộp giữa các instance. Chuyển độ trễ thành tỷ lệ request dưới một ngưỡng giúp nó có tính cộng, so sánh được với SLI sẵn sàng và tương thích với alert burn rate.
H: Giải thích burn rate và lý do alert dùng hai cửa sổ.
Burn rate là tỷ lệ lỗi quan sát được chia cho tỷ lệ budget. Giá trị 1 nghĩa là budget vừa đủ dùng hết cửa sổ. Cửa sổ dài lọc bỏ các đợt tăng vọt ngắn, cửa sổ ngắn giúp alert tắt nhanh sau khi hệ thống phục hồi.
H: Toil là gì và kiểm soát nó bằng cách nào?
Toil là công việc thủ công, lặp lại, có thể tự động hóa, không tạo giá trị lâu dài và tăng theo quy mô dịch vụ. Nó được đo lường, giới hạn (Google dùng mốc 50%) và giảm dần thông qua tự động hóa hoặc trả công việc về cho đội sở hữu dịch vụ.
H: Điều gì khiến một postmortem được gọi là blameless?
Nó tập trung vào các điều kiện của hệ thống đã cho phép sự cố xảy ra, giả định mọi người hành động hợp lý với thông tin họ có tại thời điểm đó, và tạo ra các action item được theo dõi. Phép thử: kỹ sư liên quan có sẵn sàng chia sẻ mọi chi tiết mà không sợ hãi hay không?
Câu hỏi về giám sát thường theo sau câu hỏi về SLO trong cùng một buổi phỏng vấn. Bài hướng dẫn câu hỏi phỏng vấn Prometheus đề cập PromQL, các loại metric và cardinality, còn trang công nghệ DevOps liệt kê toàn bộ module để chuẩn bị rộng hơn.
SLO và error budget trong thực tế: những điểm cần ghi nhớ
- Định nghĩa mỗi SLI là tỷ lệ giữa sự kiện tốt và sự kiện hợp lệ, đo càng gần người dùng càng tốt trong phạm vi dữ liệu cho phép, và với đa số API không tính 4xx là lỗi
- Chọn SLO dựa trên dữ liệu lịch sử với cửa sổ trượt 28 hoặc 30 ngày, và luôn giữ nó chặt hơn mọi SLA với khách hàng
- Quy đổi mục tiêu thành budget theo phút hoặc theo số request, và thuộc lòng các con số: 99,9% trong 30 ngày tương đương 43 phút
- Cảnh báo theo burn rate với cặp cửa sổ (14,4 trên 1 giờ và 5 phút, 6 trên 6 giờ và 30 phút), không dựa trên tỷ lệ lỗi thô hay CPU
- Sinh rule bằng Sloth hoặc công cụ tương tự khi có nhiều hơn vài dịch vụ áp dụng SLO, để các ngưỡng luôn nhất quán
- Soạn và ký error budget policy trước lần vi phạm đầu tiên, bao gồm quy tắc đóng băng phát hành và quy trình leo thang
- Theo dõi toil, số lượng page và action item của postmortem với mức nghiêm túc tương đương các tính năng
Bắt đầu luyện tập!
Kiểm tra kiến thức với mô phỏng phỏng vấn và bài kiểm tra kỹ thuật.
Bạn có tìm ra lỗi trong DevOps không?
Một đoạn mã thật, một lỗi ẩn, mỗi ngày một lượt. Không cần tài khoản để thử.

Viết bởi
Anthony Fillion-MailletNgười sáng lập SharpSkill
Lập trình viên fullstack hơn 10 năm. Anh điều hành SharpSkill và chịu trách nhiệm về mọi nội dung đăng tại đây.
Cập nhật ngày 7 tháng 11, 2026
Thẻ
Chia sẻ
Bài viết liên quan

Câu Hỏi Phỏng Vấn Prometheus 2026: So Sánh Prometheus, Grafana và Datadog
Câu hỏi phỏng vấn Prometheus cho vị trí DevOps và SRE, kèm câu trả lời về PromQL, các loại metric, cardinality và HA, cùng phần so sánh Prometheus, Grafana và Datadog về kiến trúc, cảnh báo và chi phí.
Việc Làm DevOps Engineer 2026: Nơi Tìm Kiếm, Mức Lương, Cách Chuẩn Bị
Hướng dẫn toàn diện về việc làm DevOps engineer năm 2026, bao gồm các nền tảng tuyển dụng hàng đầu, dữ liệu lương cập nhật và chiến lược chuẩn bị phỏng vấn hiệu quả.
Bảo mật Pipeline DevOps 2026: Thực tiễn DevSecOps và Câu hỏi Phỏng vấn
Hướng dẫn toàn diện về bảo mật pipeline DevOps năm 2026, bao gồm các thực tiễn tốt nhất DevSecOps, triển khai CI/CD an toàn, và câu hỏi phỏng vấn kỹ thuật để chuẩn bị sự nghiệp.