Blog w C# w 2026 roku: blog techniczny na ASP.NET Core i Minimal APIs
Praktyczny przewodnik budowy bloga w C# na .NET 10: wpisy w Markdown z front matter, magazyn wpisów z przeładowaniem na gorąco, strony z komponentów Razor, output caching i kanał RSS.
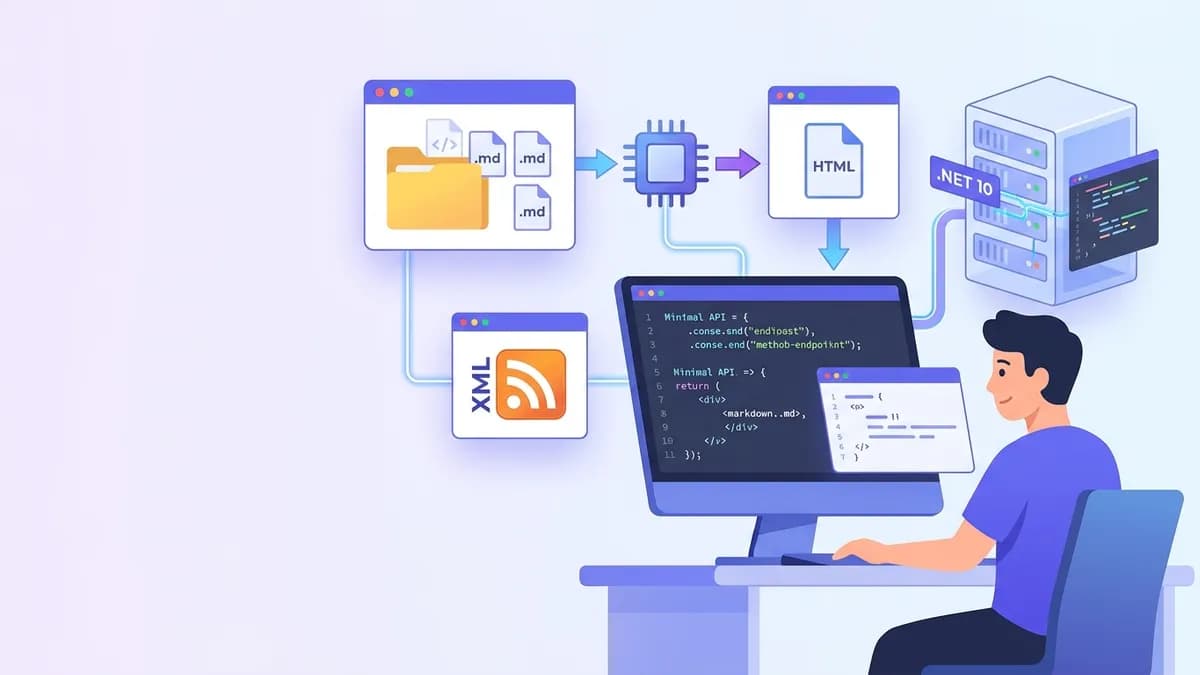
Własny blog techniczny w C# nie wymaga dziś ani systemu CMS, ani bazy danych. Wystarczy katalog z plikami Markdown, jeden serwis typu singleton, który parsuje je przy starcie, kilka endpointów Minimal API zwracających HTML oraz kanał RSS. Na .NET 10, wydaniu z długoterminowym wsparciem (LTS) opublikowanym w listopadzie 2025 roku, prawie wszystkie potrzebne elementy znajdują się w samym frameworku, a resztę uzupełniają dwa dojrzałe pakiety NuGet.
Projekt webowy na .NET 10, Markdig do zamiany Markdown na HTML, YamlDotNet do odczytu front matter, niemutowalny magazyn wpisów w pamięci przeładowywany po zmianie pliku, endpointy Minimal API zwracające strony przez RazorComponentResult, output caching z unieważnianiem po tagach oraz kanał RSS 2.0 z System.ServiceModel.Syndication. Cały silnik mieści się w mniej niż 300 liniach C#.
Minimal API czy generator stron statycznych
Generatory takie jak Hugo czy Jekyll tworzą pliki HTML na etapie budowania. Są szybkie i tanie w utrzymaniu, ale każda funkcja wykraczająca poza szablony, na przykład publikacja zaplanowana na konkretny dzień, API w JSON dla aplikacji mobilnej, osobne kanały dla tagów czy integracja z analityką, zamienia się we wtyczkę pisaną w języku, z którym programista .NET nie pracuje na co dzień.
Blog oparty na ASP.NET Core trzyma treść w zwykłych plikach Markdown w repozytorium Git, renderuje je przy pierwszym żądaniu, a potem serwuje wynik z pamięci. Z output cachingiem na froncie koszt pojedynczego żądania jest zbliżony do serwowania pliku statycznego, a cała logika to zwykły kod C#, który można debugować, testować i rozbudowywać. Taki projekt ma też wartość szkoleniową: dotyka wstrzykiwania zależności, potoku żądań, cache'owania i współbieżności, czyli dokładnie tych tematów, które pojawiają się na rozmowach rekrutacyjnych z .NET.
| Kryterium | Generator stron statycznych | Blog na ASP.NET Core Minimal API |
|---|---|---|
| Format treści | Markdown + front matter | Markdown + front matter |
| Moment renderowania | Podczas budowania | Pierwsze żądanie, potem cache |
| Własna logika | Wtyczki, szablony | Zwykłe endpointy w C# |
| Hosting | Dowolny hosting statyczny lub CDN | Kontener, App Service, dowolny VPS |
| Aktualizacja treści | Przebudowa i ponowne wdrożenie | Obserwator plików przeładowuje magazyn |
Przygotowanie projektu ASP.NET Core na .NET 10
Punktem wyjścia jest pusty szablon webowy. Polecenie dotnet new web tworzy projekt na SDK Microsoft.NET.Sdk.Web, które kompiluje komponenty .razor bez dodatkowej konfiguracji. Resztę pokrywają trzy pakiety: Markdig do parsowania CommonMark, YamlDotNet do metadanych oraz System.ServiceModel.Syndication do kanału RSS.
# terminal
dotnet new web -n CSharpBlog --framework net10.0
cd CSharpBlog
dotnet add package Markdig
dotnet add package YamlDotNet
dotnet add package System.ServiceModel.Syndication
mkdir posts Posts Endpoints Components
Plik Program.cs spina wszystkie elementy. Magazyn wpisów jest rejestrowany jako singleton, ponieważ sparsowane wpisy są współdzielone przez wszystkie żądania. Middleware output cachingu znajduje się w potoku przed endpointami, dzięki czemu odpowiedź z cache'u w ogóle nie uruchamia handlera.
var builder = WebApplication.CreateBuilder(args);

// Site settings bound from the "Blog" section of appsettings.json
builder.Services.Configure<BlogOptions>(builder.Configuration.GetSection("Blog"));

builder.Services.AddSingleton<PostStore>();   // one parsed snapshot shared by all requests
builder.Services.AddRazorComponents();        // enables RazorComponentResult rendering
builder.Services.AddOpenApi();                // OpenAPI 3.1 document for the JSON API
builder.Services.AddOutputCache(options =>
    options.AddBasePolicy(policy => policy.Expire(TimeSpan.FromHours(1))));

var app = builder.Build();

app.MapStaticAssets();   // CSS and images from wwwroot, fingerprinted since .NET 9
app.UseOutputCache();    // must run before the endpoints it caches
app.MapOpenApi();

app.MapBlogEndpoints();
app.MapFeedEndpoints();

app.Run();

public sealed class BlogOptions
{
    public string Title { get; set; } = "C# Notes";
    public string SiteUrl { get; set; } = "https://localhost:5001/";
}
Ustawienie SiteUrl będzie istotne w dalszej części: adresy kanoniczne i linki w kanale RSS budowane są z konfiguracji, nigdy z nagłówka Host przychodzącego żądania.
Parsowanie wpisów Markdown z front matter w C#
Każdy wpis to osobny plik, na przykład posts/output-caching-dotnet-10.md. Nazwa pliku staje się slugiem, a blok YAML na początku pliku zawiera metadane:
---
title: Output caching in .NET 10
summary: How tag-based eviction keeps cached pages fresh.
date: 2026-11-10
tags: [aspnet-core, performance]
draft: false
---
Output caching stores the full response on the server...
Parser oddziela blok YAML od treści, deserializuje metadane do małej klasy i konwertuje resztę pliku na HTML. Najpierw normalizowane są znaki końca linii. Bez tego wpis zapisany w edytorze na Windows (z \r\n) psuje wyszukiwanie ogranicznika ---.
using Markdig;
using YamlDotNet.Serialization;
using YamlDotNet.Serialization.NamingConventions;

public sealed record Post(string Slug, string Title, string Summary,
    DateTime PublishedOn, IReadOnlyList<string> Tags, bool Draft, string Html);

public static class PostParser
{
    // Built once and reused by every reload
    private static readonly MarkdownPipeline Pipeline =
        new MarkdownPipelineBuilder().UseAdvancedExtensions().Build();

    private static readonly IDeserializer Yaml = new DeserializerBuilder()
        .WithNamingConvention(CamelCaseNamingConvention.Instance)
        .IgnoreUnmatchedProperties()   // unknown keys do not crash the reload
        .Build();

    public static Post Parse(string slug, string text)
    {
        text = text.ReplaceLineEndings("\n");
        if (!text.StartsWith("---\n"))
            throw new FormatException($"{slug}: missing front matter");

        var end = text.IndexOf("\n---", 4, StringComparison.Ordinal);
        if (end < 0)
            throw new FormatException($"{slug}: unterminated front matter");

        var meta = Yaml.Deserialize<FrontMatter>(text[4..end]);
        var html = Markdown.ToHtml(text[(end + 4)..], Pipeline);

        return new Post(slug, meta.Title, meta.Summary, meta.Date, meta.Tags, meta.Draft, html);
    }

    private sealed class FrontMatter
    {
        public string Title { get; set; } = "";
        public string Summary { get; set; } = "";
        public DateTime Date { get; set; }
        public List<string> Tags { get; set; } = [];
        public bool Draft { get; set; }
    }
}
Wywołanie UseAdvancedExtensions() włącza tabele, przypisy, listy zadań, automatyczne identyfikatory nagłówków i pozostałe rozszerzenia Markdig, których potrzebuje blog techniczny. Warto pamiętać, że Markdig domyślnie przepuszcza surowy HTML. Przy wpisach pisanych przez właściciela serwisu nie stanowi to problemu, ale każdy Markdown pochodzący od użytkowników (komentarze, wpisy gościnne) wymaga w swoim potoku wywołania DisableHtml(), inaczej otwiera drogę do ataku stored XSS.
Statyczne pola Pipeline i Yaml nie są przypadkowe. Budowa potoku Markdig i deserializatora YamlDotNet jest kosztowna, a oba obiekty są bezpieczne do współdzielenia między wątkami, więc tworzy się je raz na cały czas życia procesu.
Magazyn wpisów: singleton bezpieczny wątkowo z przeładowaniem na gorąco
Magazyn wczytuje wszystkie pliki przy starcie i trzyma wynik w FrozenDictionary (dostępnym od .NET 8), czyli kolekcji zoptymalizowanej pod intensywne odczyty. Gdy plik się zmieni, magazyn buduje od zera nowy słownik i podmienia referencję jednym przypisaniem. Czytelnicy nigdy nie zakładają blokady: każde żądanie widzi albo stary, albo nowy snapshot, nigdy kolekcję w połowie budowy.
using System.Collections.Frozen;
using Microsoft.AspNetCore.OutputCaching;
using Microsoft.Extensions.FileProviders;
using Microsoft.Extensions.Primitives;

public sealed class PostStore
{
    private readonly PhysicalFileProvider _files;
    private readonly IOutputCacheStore _cache;
    private readonly ILogger<PostStore> _logger;
    private volatile FrozenDictionary<string, Post> _bySlug = FrozenDictionary<string, Post>.Empty;

    public PostStore(IWebHostEnvironment env, IOutputCacheStore cache, ILogger<PostStore> logger)
    {
        (_cache, _logger) = (cache, logger);
        _files = new PhysicalFileProvider(Path.Combine(env.ContentRootPath, "posts"));
        Reload();
        ChangeToken.OnChange(() => _files.Watch("*.md"), Reload);   // re-registers after each change
    }

    public Post? Find(string slug) => _bySlug.TryGetValue(slug, out var post) ? post : null;

    public IReadOnlyList<Post> Latest(int count) =>
        _bySlug.Values.OrderByDescending(p => p.PublishedOn).Take(count).ToList();

    private void Reload()
    {
        try
        {
            var snapshot = _files.GetDirectoryContents("")
                .Where(f => !f.IsDirectory && f.Name.EndsWith(".md", StringComparison.Ordinal))
                .Select(f => PostParser.Parse(Path.GetFileNameWithoutExtension(f.Name), File.ReadAllText(f.PhysicalPath!)))
                .Where(p => !p.Draft)
                .ToFrozenDictionary(p => p.Slug);

            _bySlug = snapshot;   // atomic reference swap
            _ = _cache.EvictByTagAsync("posts", CancellationToken.None).AsTask();
            _logger.LogInformation("Loaded {Count} posts", snapshot.Count);
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "Reload failed, keeping the previous snapshot");   // a typo never takes the site down
        }
    }
}
O tym, że ten kod nadaje się na produkcję, decydują trzy szczegóły:
- Pole oznaczone jako
volatilegwarantuje, że pozostałe wątki odczytają aktualną referencję po podmianie. - Blok
try/catchzachowuje ostatni poprawny snapshot, gdy któryś wpis ma uszkodzony YAML. Literówka w jednym pliku nie opróżnia całego bloga. - Wywołanie
EvictByTagAsyncusuwa z cache'u wszystkie strony oznaczone tagiemposts, więc nowa treść pojawia się przy następnym żądaniu, a nie dopiero po godzinie, gdy wygaśnie polityka bazowa.
Metoda ChangeToken.OnChange zasługuje na osobną uwagę. Token zmiany z PhysicalFileProvider jest jednorazowy: po pierwszym wywołaniu przestaje działać. OnChange przyjmuje fabrykę tokenów i po każdej zmianie rejestruje obserwację od nowa, co zwalnia programistę z ręcznego zarządzania subskrypcją.
FileSystemWatcher korzysta z powiadomień systemu operacyjnego, które nie przechodzą niezawodnie przez bind mounty Dockera ani udziały sieciowe. W kontenerze z zamontowanym katalogiem posts należy ustawić zmienną środowiskową DOTNET_USE_POLLING_FILE_WATCHER=true albo PhysicalFileProvider.UsePollingFileWatcher = true. Edytory zapisują też pliki w kilku krokach, przez co Reload potrafi uruchomić się dwa lub trzy razy na jeden zapis. Tutaj nie ma to znaczenia, bo każde uruchomienie daje identyczny snapshot.
Endpointy Minimal API z grupami tras i TypedResults
Publiczne strony są zgrupowane pod /blog za pomocą MapGroup. Grupa pozwala w jednym miejscu nałożyć politykę output cachingu i tag na wszystkie endpointy. Handlery zwracają RazorComponentResult<T> (dostępny od .NET 8), który renderuje komponent Razor jako pełną odpowiedź HTTP bez MVC, Razor Pages i bez routera Blazora.
using CSharpBlog.Components;   // namespace of PostPage and PostListPage
using Microsoft.AspNetCore.Http.HttpResults;

public static class BlogEndpoints
{
    public static IEndpointRouteBuilder MapBlogEndpoints(this IEndpointRouteBuilder app)
    {
        var blog = app.MapGroup("/blog").CacheOutput(p => p.Tag("posts"));

        blog.MapGet("/", (PostStore store) =>
            new RazorComponentResult<PostListPage>(new { Posts = store.Latest(20) }));

        blog.MapGet("/{slug:regex(^[a-z0-9-]+$)}", GetPost);   // rejects odd slugs before the handler

        app.MapGet("/api/posts", (PostStore store) =>
                TypedResults.Ok(store.Latest(50).Select(p => new PostSummary(p.Slug, p.Title, p.Summary, p.PublishedOn))))
            .CacheOutput(p => p.Tag("posts"))
            .WithName("ListPosts");

        return app;
    }

    // The union return type documents both outcomes for OpenAPI and for unit tests
    private static Results<RazorComponentResult<PostPage>, NotFound> GetPost(string slug, PostStore store) =>
        store.Find(slug) is { } post
            ? new RazorComponentResult<PostPage>(new { Post = post })
            : TypedResults.NotFound();
}

public sealed record PostSummary(string Slug, string Title, string Summary, DateTime PublishedOn);
Typ zwracany Results<T1, T2> to właśnie to, co odróżnia TypedResults od starszych helperów Results. Kompilator pilnuje, by handler zwracał wyłącznie zadeklarowane wyniki, generator OpenAPI odczytuje oba kody statusu wprost z sygnatury, a test jednostkowy może sprawdzić result.Result is NotFound bez uruchamiania serwera. Endpoint JSON pozostaje poza grupą /blog, żeby jego adres nie kolidował ze slugami wpisów.
Ograniczenie regex(^[a-z0-9-]+$) w szablonie trasy odrzuca nietypowe slugi, zanim żądanie dotrze do handlera. Zapytania o adresy z kropkami, ukośnikami czy wielkimi literami kończą się błędem 404 już na etapie routingu.
Strona wpisu to zwykły komponent Razor. MarkupString informuje Razor, że wynik z Markdig ma zostać wyemitowany jako HTML, a nie zakodowany, a adres kanoniczny pochodzi z BlogOptions.
@* Components/PostPage.razor *@
@using Microsoft.Extensions.Options
@inject IOptions<BlogOptions> Options

<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="utf-8" />
    <title>@Post.Title | @Options.Value.Title</title>
    <meta name="description" content="@Post.Summary" />
    <link rel="canonical" href="@(new Uri(new Uri(Options.Value.SiteUrl), $"blog/{Post.Slug}"))" />
    <link rel="alternate" type="application/rss+xml" title="@Options.Value.Title" href="/feed.xml" />
    <link rel="stylesheet" href="/site.css" />
</head>
<body>
    <article>
        <h1>@Post.Title</h1>
        <time datetime="@(Post.PublishedOn.ToString("yyyy-MM-dd"))">@(Post.PublishedOn.ToString("d MMMM yyyy"))</time>
        @((MarkupString)Post.Html)
    </article>
</body>
</html>

@code {
    [Parameter, EditorRequired] public Post Post { get; set; } = default!;
}
Plik PostListPage.razor działa na tej samej zasadzie: przyjmuje parametr Posts i w pętli wyświetla tytuły oraz streszczenia. Obiekt anonimowy przekazany do RazorComponentResult mapuje nazwy swoich właściwości na parametry komponentu, dlatego new { Post = post } musi dokładnie odpowiadać parametrowi Post. Literówka w nazwie nie zostanie wykryta przy kompilacji, tylko w czasie działania.
Gotowy na rozmowy o .NET?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Output caching dla stron bloga w ASP.NET Core
Output caching, dodany w ASP.NET Core 7, przechowuje całą odpowiedź po stronie serwera i odtwarza ją bez uruchamiania handlera i ponownego renderowania komponentu. To mechanizm inny niż starszy middleware response caching, który działa według semantyki nagłówka HTTP Cache-Control i pozwala klientowi ominąć cache nagłówkiem no-cache. Dokumentacja output cachingu na Microsoft Learn opisuje domyślne reguły: cache'owane są tylko żądania GET i HEAD zakończone kodem 200, a odpowiedzi ustawiające ciasteczka lub dotyczące uwierzytelnionych żądań są pomijane.
To tagi sprawiają, że output caching pasuje do serwisu z treścią. Każdy endpoint bloga ma tag posts, a magazyn unieważnia ten tag po każdym przeładowaniu. Godzinna polityka bazowa to tylko zabezpieczenie: w praktyce strony pozostają w cache'u aż do zmiany treści.
Przy wdrożeniu na kilka instancji domyślny magazyn w pamięci jest lokalny dla procesu, więc unieważnienie na jednej instancji zostawia nieaktualne strony na pozostałych. ASP.NET Core oferuje magazyn oparty na Redisie w pakiecie Microsoft.AspNetCore.OutputCaching.StackExchangeRedis z metodą AddStackExchangeRedisOutputCache, który współdzieli wpisy i unieważnienia między instancjami. Dla jednej niewielkiej instancji nie jest potrzebny.
Kanał RSS w C# z SyndicationFeed
Czytelnicy techniczni wciąż subskrybują blogi w czytnikach kanałów, a agregatory wyłapują nowe wpisy z RSS, nie z mapy strony. SyndicationFeed razem z Rss20FeedFormatter generuje kanał zgodny ze specyfikacją RSS 2.0 bez ręcznego pisania XML.
using System.ServiceModel.Syndication;
using System.Text;
using System.Xml;
using Microsoft.Extensions.Options;

public static class FeedEndpoints
{
    public static IEndpointRouteBuilder MapFeedEndpoints(this IEndpointRouteBuilder app)
    {
        app.MapGet("/feed.xml", (PostStore store, IOptions<BlogOptions> options) =>
        {
            var site = new Uri(options.Value.SiteUrl);   // never built from the Host header
            var items = store.Latest(20).Select(p =>
            {
                var date = new DateTimeOffset(DateTime.SpecifyKind(p.PublishedOn, DateTimeKind.Utc));
                return new SyndicationItem(p.Title, p.Summary, new Uri(site, $"blog/{p.Slug}"), p.Slug, date)
                {
                    PublishDate = date   // RSS pubDate comes from PublishDate, not LastUpdatedTime
                };
            });

            var feed = new SyndicationFeed(options.Value.Title, "Articles on C# and .NET", site, items);

            using var buffer = new MemoryStream();
            using (var writer = XmlWriter.Create(buffer, new XmlWriterSettings { Encoding = new UTF8Encoding(false) }))
                new Rss20FeedFormatter(feed).WriteTo(writer);   // writer flushes on dispose

            return TypedResults.Bytes(buffer.ToArray(), "application/rss+xml; charset=utf-8");
        }).CacheOutput(p => p.Tag("posts"));

        return app;
    }
}
Budowanie adresów bezwzględnych z BlogOptions.SiteUrl zamiast z HttpContext.Request.Host zamyka podatność typu host header injection. Bez tego jedno żądanie ze sfałszowanym nagłówkiem Host trafiłoby do cache'u i każdy subskrybent dostawałby linki prowadzące do obcej domeny. Argument UTF8Encoding(false) usuwa znacznik BOM, którego niektóre czytniki nie akceptują. Warto też zwrócić uwagę na PublishDate: element pubDate w RSS pochodzi właśnie z tej właściwości, a nie z LastUpdatedTime przekazanego w konstruktorze.
Wdrożenie bloga technicznego w C# i ograniczenia Native AOT
Polecenie dotnet publish -c Release tworzy build zależny od frameworka, który działa na każdym hoście z runtime'em .NET 10. Od .NET 8 SDK potrafi też budować obrazy kontenerów bez pliku Dockerfile: dotnet publish -c Release /t:PublishContainer tworzy obraz na bazie oficjalnego obrazu runtime'u ASP.NET Core. Katalog posts można wbudować w obraz (wtedy każda zmiana treści wymaga ponownego wdrożenia) albo zamontować jako wolumen (wtedy zmiany wyłapuje obserwator plików).
Native AOT kusi krótszym czasem startu i mniejszym zużyciem pamięci, ale ten projekt nie jest dobrym kandydatem. Tabela zgodności Native AOT w ASP.NET Core oznacza Minimal APIs jako wspierane częściowo, a Blazor Server jako niewspierany. Domyślny deserializator YamlDotNet opiera się ponadto na refleksji. Blog serwuje strony z cache'u w długo działającym procesie, więc czas startu ma marginalne znaczenie. Przejście na AOT oznaczałoby zastąpienie komponentów Razor szablonami tekstowymi, a YAML front matterem w JSON z generatorem źródeł, przy niewielkim zysku.
Pytania rekrutacyjne z .NET, do których przygotowuje ten projekt
Każdy element silnika odpowiada pytaniu, które pada na rozmowach o pracę z ASP.NET Core. Pytania rekrutacyjne z .NET na SharpSkill omawiają je szczegółowo, a moduł o Minimal APIs skupia się na warstwie endpointów.
„Czy serwis singleton jest bezpieczny, gdy czyta go wiele żądań jednocześnie?” Tylko wtedy, gdy jego stan jest niemutowalny albo synchronizowany. Opisany magazyn używa niemutowalnego snapshotu i podmiany referencji volatile, więc czytelnicy nie blokują się nawzajem, a zapis nie blokuje odczytów. Klasyczna pułapka to singleton z List<T> modyfikowaną podczas przeładowania, który pod obciążeniem rzuca InvalidOperationException w trakcie enumeracji. Moduł o wstrzykiwaniu zależności omawia też problem captive dependency: singleton, który otrzymuje serwis o zasięgu scoped, na przykład DbContext, utrzymuje go przy życiu przez cały czas działania aplikacji.
„Czym różni się output caching od response cachingu?” Output caching jest kontrolowany przez serwer, obsługuje tagi i unieważnianie, ignoruje nagłówki cache'u wysyłane przez klienta. Response caching podąża za semantyką HTTP i jest przede wszystkim wskazówką dla proxy i przeglądarek.
„Dlaczego zwracać TypedResults zamiast Results?” Konkretne typy wyników dają sprawdzanie możliwych odpowiedzi w czasie kompilacji, automatyczne metadane OpenAPI i handlery, które da się testować jak zwykłe metody. Szersze porównanie z kontrolerami zawiera artykuł o architekturze i wydajności Minimal APIs.
„Gdzie w tej aplikacji ma znaczenie kolejność middleware?” UseOutputCache musi być zarejestrowany przed endpointami, które cache'uje, oraz po UseCors, jeśli CORS jest włączony. Kandydat, który potrafi też wyjaśnić, dlaczego domyślna polityka nigdy nie cache'uje żądań uwierzytelnionych i co musi sprawdzić własna implementacja IOutputCachePolicy, zanim zacznie je cache'ować, pokazuje zrozumienie potoku, a nie wyuczoną na pamięć kolejność.
Blog w C# na ASP.NET Core: najważniejsze wnioski
- Projekt startuje od
dotnet new webna .NET 10 i potrzebuje jedynie Markdig, YamlDotNet orazSystem.ServiceModel.Syndication. Blog techniczny obywa się bez CMS i bez bazy danych. - Wpisy parsuje się raz do niemutowalnego
FrozenDictionaryi przy przeładowaniu podmienia cały snapshot, więc odczyty nie wymagają blokad, a uszkodzony plik nie opróżnia serwisu. - HTML renderuje się przez
RazorComponentResult<T>z handlerów Minimal API, a typy zwracaneResults<T1, T2>pozwalają OpenAPI i testom jednostkowym widzieć każdy możliwy wynik. - Wszystkie endpointy z treścią działają za output cachingiem ze wspólnym tagiem, a
EvictByTagAsyncpo każdym przeładowaniu zastępuje krótkie czasy wygasania. - Adresy kanoniczne i linki w RSS buduje się z konfiguracji, nigdy z nagłówka
Host. Każdy potok renderujący Markdown od użytkowników wymagaDisableHtml(). - Gdy katalog z wpisami jest montowany do kontenera, potrzebna jest zmienna
DOTNET_USE_POLLING_FILE_WATCHER=true. - Projekt sprawdza się jako trening przed rozmową rekrutacyjną: warto umieć na głos wyjaśnić bezpieczeństwo wątkowe singletona, wybór mechanizmu cache'owania i kolejność middleware.
Zacznij ćwiczyć!
Sprawdź swoją wiedzę z naszymi symulatorami rozmów i testami technicznymi.
Znajdziesz błąd w .NET?
Prawdziwy fragment kodu, ukryty błąd, jedna próba dziennie. Bez konta, żeby spróbować.
Autor:
Anthony Fillion-MailletZałożyciel SharpSkill
Programista fullstack od ponad 10 lat. Prowadzi SharpSkill i odpowiada za wszystko, co się tu ukazuje.
Zaktualizowano 17 listopada 2026
Tagi
Udostępnij
Powiązane artykuły
Zarządzanie czasem życia DbContext w ASP.NET Core: Wydajność kontra bezpieczeństwo wątkowe w operacjach asynchronicznych
Kompleksowy przewodnik po zarządzaniu czasem życia DbContext w ASP.NET Core. Dowiedz się, kiedy stosować scoped vs transient, jak bezpiecznie obsługiwać operacje asynchroniczne oraz jak optymalizować wydajność za pomocą poolingu DbContext.
.NET 9 Blazor: Pełnostackowy rozwój aplikacji z Blazor United w 2026
.NET 9 Blazor United łączy statyczny SSR, Server i WebAssembly w jednym frameworku full-stack. Praktyczny poradnik obejmujący tryby renderowania, streaming rendering, wstrzykiwanie zależności i wzorce produkcyjne.
Clean Architecture w .NET: Praktyczny Przewodnik
Opanowanie Clean Architecture w .NET z C#. Poznanie zasad SOLID, separacji warstw i wzorców implementacyjnych dla aplikacji łatwych w utrzymaniu.