Django REST Framework 시리얼라이저 심층 분석: 유효성 검사, 중첩 및 N+1 문제
DRF 시리얼라이저의 고급 기법을 상세히 다룹니다. 커스텀 유효성 검사, 중첩 시리얼라이저, N+1 문제 해결 방법, 성능 최적화 모범 사례를 포괄적으로 설명합니다.
Django REST Framework(DRF)에서 시리얼라이저는 API의 입출력을 제어하는 핵심 컴포넌트입니다. 2026년 현재, DRF 3.15 이후 버전에서는 시리얼라이저 기능이 더욱 강화되어 유연하고 효율적인 API 개발이 가능해졌습니다. 본 문서에서는 시리얼라이저의 유효성 검사, 중첩 구조 처리, 그리고 프로덕션 환경에서 심각한 문제가 되는 N+1 쿼리 해결 방법을 상세히 설명합니다. 시리얼라이저를 깊이 이해하면 견고하고 성능이 뛰어난 RESTful API를 구축할 수 있습니다.
DRF의 시리얼라이저는 Python 객체(주로 Django 모델)와 JSON/XML 등의 데이터 형식을 상호 변환하는 컴포넌트입니다. Django의 폼과 유사한 역할을 수행하며, 데이터의 유효성 검사, 시리얼라이즈(객체→JSON), 디시리얼라이즈(JSON→객체)를 담당합니다. 적절히 설계된 시리얼라이저는 API의 일관성과 보안을 보장합니다.
기본 시리얼라이저 구조
DRF에서는 Serializer와 ModelSerializer 두 가지 기본 클래스를 제공합니다. ModelSerializer는 Django 모델에 대응하는 시리얼라이저를 빠르게 생성할 수 있으며, Serializer는 완전히 커스텀한 구조를 정의할 때 사용합니다.
# serializers.py
from rest_framework import serializers
from .models import Article, Author, Tag

class AuthorSerializer(serializers.ModelSerializer):
    """Author model serializer with computed field"""
    full_name = serializers.SerializerMethodField()

    class Meta:
        model = Author
        fields = ['id', 'first_name', 'last_name', 'full_name', 'email', 'bio']
        read_only_fields = ['id']

    def get_full_name(self, obj):
        return f"{obj.first_name} {obj.last_name}"


class TagSerializer(serializers.ModelSerializer):
    class Meta:
        model = Tag
fields = ['id', 'name', 'slug']SerializerMethodField를 사용하면 모델에 존재하지 않는 계산 필드를 추가할 수 있습니다. read_only_fields를 지정하면 특정 필드가 업데이트 시 무시되도록 보장합니다.
커스텀 유효성 검사 구현
DRF의 유효성 검사는 세 가지 레벨에서 실행됩니다: 필드 레벨, 객체 레벨, 그리고 밸리데이터 클래스입니다. 이들을 조합하여 복잡한 비즈니스 규칙을 구현할 수 있습니다.
# serializers.py
from rest_framework import serializers
from rest_framework.validators import UniqueTogetherValidator
from django.utils import timezone
from .models import Article

class ArticleSerializer(serializers.ModelSerializer):
    """Article serializer with multi-level validation"""

    class Meta:
        model = Article
        fields = ['id', 'title', 'slug', 'content', 'author', 'tags',
                  'published_at', 'status', 'view_count']
        read_only_fields = ['id', 'view_count', 'slug']
        validators = [
            UniqueTogetherValidator(
                queryset=Article.objects.all(),
                fields=['author', 'title'],
                message="This author already has an article with this title."
            )
        ]

    # Field-level validation
    def validate_title(self, value):
        """Ensure title meets requirements"""
        if len(value) < 10:
            raise serializers.ValidationError(
                "Title must be at least 10 characters long."
            )
        if value.isupper():
            raise serializers.ValidationError(
                "Title cannot be all uppercase."
            )
        return value

    def validate_published_at(self, value):
        """Prevent publishing in the past"""
        if value and value < timezone.now():
            raise serializers.ValidationError(
                "Publication date cannot be in the past."
            )
        return value

    # Object-level validation
    def validate(self, attrs):
        """Cross-field validation"""
        status = attrs.get('status')
        published_at = attrs.get('published_at')
        content = attrs.get('content', '')

        # Published articles must have publication date
        if status == 'published' and not published_at:
            raise serializers.ValidationError({
                'published_at': 'Publication date is required for published articles.'
            })

        # Published articles need minimum content length
        if status == 'published' and len(content) < 100:
            raise serializers.ValidationError({
                'content': 'Published articles must have at least 100 characters.'
            })

        return attrs
필드 레벨 유효성 검사는 validate_<field_name> 메서드로 정의하며, 단일 필드 검증에 사용합니다. 객체 레벨 유효성 검사는 validate 메서드로 정의하며, 여러 필드 간의 정합성 검사에 사용합니다. UniqueTogetherValidator와 같은 밸리데이터 클래스는 Meta.validators에서 선언적으로 지정합니다.
중첩 시리얼라이저 처리
API에서는 관련 객체를 중첩하여 반환하는 경우가 많습니다. 중첩 시리얼라이저를 적절히 구현하면 클라이언트는 한 번의 요청으로 필요한 데이터를 모두 가져올 수 있습니다.
# serializers.py
from rest_framework import serializers
from .models import Article, Author, Tag, Comment

class CommentSerializer(serializers.ModelSerializer):
    author_name = serializers.CharField(source='author.username', read_only=True)

    class Meta:
        model = Comment
        fields = ['id', 'content', 'author_name', 'created_at']


class ArticleDetailSerializer(serializers.ModelSerializer):
    """Detailed article serializer with nested relations"""
    author = AuthorSerializer(read_only=True)
    tags = TagSerializer(many=True, read_only=True)
    comments = CommentSerializer(many=True, read_only=True)
    comment_count = serializers.IntegerField(read_only=True)

    # Write-only fields for creating/updating
    author_id = serializers.PrimaryKeyRelatedField(
        queryset=Author.objects.all(),
        source='author',
        write_only=True
    )
    tag_ids = serializers.PrimaryKeyRelatedField(
        queryset=Tag.objects.all(),
        source='tags',
        many=True,
        write_only=True
    )

    class Meta:
        model = Article
        fields = [
            'id', 'title', 'slug', 'content',
            'author', 'author_id',
            'tags', 'tag_ids',
            'comments', 'comment_count',
            'published_at', 'status'
        ]
        read_only_fields = ['id', 'slug']
이 설계에서는 읽기 시에는 완전한 객체(author, tags)를 반환하고, 쓰기 시에는 ID(author_id, tag_ids)를 받습니다. source 파라미터로 시리얼라이저 필드와 모델 필드를 매핑할 수 있습니다.
쓰기 가능한 중첩 시리얼라이저
기본적으로 중첩 시리얼라이저는 읽기 전용입니다. 쓰기 가능하게 만들려면 create와 update 메서드를 오버라이드해야 합니다.
# serializers.py
from django.db import transaction
from rest_framework import serializers
from .models import Order, OrderItem, Product

class OrderItemSerializer(serializers.ModelSerializer):
    product_name = serializers.CharField(source='product.name', read_only=True)
    subtotal = serializers.DecimalField(
        max_digits=10, decimal_places=2, read_only=True
    )

    class Meta:
        model = OrderItem
        fields = ['id', 'product', 'product_name', 'quantity', 'price', 'subtotal']
        read_only_fields = ['id', 'price', 'subtotal']


class OrderSerializer(serializers.ModelSerializer):
    """Order serializer with writable nested items"""
    items = OrderItemSerializer(many=True)
    total_amount = serializers.DecimalField(
        max_digits=10, decimal_places=2, read_only=True
    )

    class Meta:
        model = Order
        fields = ['id', 'customer', 'items', 'total_amount',
                  'status', 'created_at', 'updated_at']
        read_only_fields = ['id', 'total_amount', 'created_at', 'updated_at']

    def validate_items(self, value):
        """Ensure order has at least one item"""
        if not value:
            raise serializers.ValidationError(
                "Order must have at least one item."
            )
        return value

    @transaction.atomic
    def create(self, validated_data):
        """Create order with nested items"""
        items_data = validated_data.pop('items')
        order = Order.objects.create(**validated_data)

        for item_data in items_data:
            product = item_data['product']
            item_data['price'] = product.price  # Set current price
            OrderItem.objects.create(order=order, **item_data)

        return order

    @transaction.atomic
    def update(self, instance, validated_data):
        """Update order and replace items"""
        items_data = validated_data.pop('items', None)

        # Update order fields
        for attr, value in validated_data.items():
            setattr(instance, attr, value)
        instance.save()

        # Replace items if provided
        if items_data is not None:
            instance.items.all().delete()
            for item_data in items_data:
                product = item_data['product']
                item_data['price'] = product.price
                OrderItem.objects.create(order=instance, **item_data)

        return instance
@transaction.atomic 데코레이터를 사용하면 부모 객체와 자식 객체의 생성이 하나의 트랜잭션으로 실행되어 데이터 정합성이 보장됩니다.
Django 면접 준비가 되셨나요?
인터랙티브 시뮬레이터, flashcards, 기술 테스트로 연습하세요.
N+1 문제의 이해와 해결
N+1 문제는 중첩 시리얼라이저를 사용할 때 가장 흔히 발생하는 성능 문제입니다. 한 번의 쿼리로 N개의 객체를 가져온 후, 각 객체의 관련 데이터를 가져오기 위해 N번의 추가 쿼리가 발생합니다.
# views.py - N+1 problem example
from rest_framework import generics
from .models import Article
from .serializers import ArticleDetailSerializer

# BAD: This causes N+1 queries
class ArticleListView(generics.ListAPIView):
    queryset = Article.objects.all()  # N+1 problem!
    serializer_class = ArticleDetailSerializer
위 코드에서는 기사 목록을 가져올 때 각 기사의 작성자와 태그를 가져오기 위해 추가 쿼리가 실행됩니다. 100개의 기사가 있다면 수백 개의 쿼리가 발생할 수 있습니다.
select_related와 prefetch_related를 통한 해결
# views.py - Optimized queries
from rest_framework import generics
from django.db.models import Count, Prefetch
from .models import Article, Comment
from .serializers import ArticleDetailSerializer

class ArticleListView(generics.ListAPIView):
    serializer_class = ArticleDetailSerializer

    def get_queryset(self):
        return Article.objects.select_related(
            'author'  # ForeignKey - single JOIN
        ).prefetch_related(
            'tags',  # ManyToMany - separate query
            Prefetch(
                'comments',
                queryset=Comment.objects.select_related('author')
                    .order_by('-created_at')[:5]  # Latest 5 comments
            )
        ).annotate(
            comment_count=Count('comments')  # Computed in DB
).order_by('-published_at')select_related는 ForeignKey와 OneToOne 관계에 사용하며, JOIN을 통해 한 번의 쿼리로 관련 데이터를 가져옵니다. prefetch_related는 ManyToMany와 역방향 ForeignKey 관계에 사용하며, 별도의 쿼리로 관련 데이터를 일괄 조회합니다. Prefetch 객체를 사용하면 관련 데이터의 쿼리를 커스터마이즈할 수 있습니다.
커스텀 Manager를 통한 재사용 가능한 최적화
# models.py
from django.db import models
from django.db.models import Count, Prefetch

class ArticleQuerySet(models.QuerySet):
    def with_relations(self):
        """Eager load common relations"""
        return self.select_related(
            'author'
        ).prefetch_related(
            'tags'
        )

    def with_comments(self, limit=5):
        """Include latest comments"""
        from .models import Comment
        return self.prefetch_related(
            Prefetch(
                'comments',
                queryset=Comment.objects.select_related('author')
                    .order_by('-created_at')[:limit]
            )
        )

    def with_stats(self):
        """Include computed statistics"""
        return self.annotate(
            comment_count=Count('comments', distinct=True),
            tag_count=Count('tags', distinct=True)
        )

    def published(self):
        """Filter to published articles only"""
        return self.filter(status='published')


class ArticleManager(models.Manager):
    def get_queryset(self):
        return ArticleQuerySet(self.model, using=self._db)

    def with_relations(self):
        return self.get_queryset().with_relations()

    def published_with_details(self):
        """Common query for public article list"""
        return self.get_queryset().published().with_relations().with_stats()


class Article(models.Model):
    # ... fields ...
    objects = ArticleManager()
커스텀 QuerySet과 Manager를 사용하면 최적화된 쿼리를 재사용 가능한 메서드로 캡슐화할 수 있습니다. 뷰에서는 Article.objects.published_with_details()를 호출하기만 하면 적절히 최적화된 쿼리가 실행됩니다.
시리얼라이저 성능 최적화
N+1 문제 외에도 시리얼라이저 자체의 성능을 최적화하는 방법이 있습니다.
# serializers.py
from rest_framework import serializers
from .models import Article

class ArticleListSerializer(serializers.ModelSerializer):
    """Lightweight serializer for list views"""
    author_name = serializers.CharField(source='author.full_name', read_only=True)
    tag_names = serializers.SlugRelatedField(
        many=True, read_only=True, slug_field='name', source='tags'
    )

    class Meta:
        model = Article
        fields = ['id', 'title', 'slug', 'author_name', 'tag_names',
                  'published_at', 'comment_count']


class ArticleDetailSerializer(serializers.ModelSerializer):
    """Full serializer for detail views"""
    author = AuthorSerializer(read_only=True)
    tags = TagSerializer(many=True, read_only=True)
    comments = CommentSerializer(many=True, read_only=True)

    class Meta:
        model = Article
        fields = ['id', 'title', 'slug', 'content', 'author', 'tags',
                  'comments', 'published_at', 'status', 'view_count']
목록 조회용과 상세 조회용으로 서로 다른 시리얼라이저를 사용하면 불필요한 데이터 시리얼라이즈를 피할 수 있습니다. 목록 조회에서는 경량화된 ArticleListSerializer를, 상세 조회에서는 완전한 ArticleDetailSerializer를 사용합니다.
동적 필드 선택
클라이언트가 필요한 필드만 요청할 수 있도록 하면 추가적인 최적화가 가능합니다.
# serializers.py
class DynamicFieldsSerializer(serializers.ModelSerializer):
    """Base serializer with dynamic field selection"""

    def __init__(self, *args, **kwargs):
        fields = kwargs.pop('fields', None)
        exclude = kwargs.pop('exclude', None)

        super().__init__(*args, **kwargs)

        if fields is not None:
            allowed = set(fields)
            existing = set(self.fields)
            for field_name in existing - allowed:
                self.fields.pop(field_name)

        if exclude is not None:
            for field_name in exclude:
                self.fields.pop(field_name, None)


class ArticleSerializer(DynamicFieldsSerializer):
    author = AuthorSerializer(read_only=True)
    tags = TagSerializer(many=True, read_only=True)

    class Meta:
        model = Article
        fields = ['id', 'title', 'slug', 'content', 'author', 'tags',
                  'published_at', 'status']


# views.py - Usage
class ArticleViewSet(viewsets.ModelViewSet):
    serializer_class = ArticleSerializer

    def get_serializer(self, *args, **kwargs):
        # Allow ?fields=id,title,author query param
        fields_param = self.request.query_params.get('fields')
        if fields_param:
            kwargs['fields'] = fields_param.split(',')
        return super().get_serializer(*args, **kwargs)
DRF 면접에서 자주 묻는 질문
2026년 Django 개발자 면접에서는 DRF 시리얼라이저에 대한 깊은 이해가 요구됩니다. 다음은 자주 출제되는 질문과 답변입니다.
Q1: Serializer와 ModelSerializer의 차이점은 무엇이며, 각각 언제 사용합니까?
ModelSerializer는 Django 모델에 대응하는 시리얼라이저를 자동으로 생성합니다. 필드 정의, 밸리데이터, create/update 메서드가 모델에서 추론됩니다. 반면 Serializer는 완전히 수동으로 정의해야 하며, 모델에 대응하지 않는 데이터 구조(로그인 폼, 검색 쿼리 등)에 사용합니다. 데이터베이스에 저장하지 않는 데이터의 검증, 여러 모델을 조합한 복잡한 구조, 외부 API와의 연동 등에서는 Serializer를 사용합니다. 대부분의 CRUD 작업에서는 ModelSerializer로 충분합니다.
Q2: 시리얼라이저의 유효성 검사가 실행되는 순서를 설명해 주십시오.
DRF의 유효성 검사는 다음 순서로 실행됩니다. (1) 필드의 to_internal_value 메서드에 의한 타입 변환 및 유효성 검사. (2) 각 필드의 밸리데이터(validators 속성) 실행. (3) validate_<field_name> 메서드에 의한 필드 레벨 유효성 검사. (4) Meta.validators에서 정의된 밸리데이터 실행. (5) validate 메서드에 의한 객체 레벨 유효성 검사. 어느 단계에서든 ValidationError가 발생하면 나머지 유효성 검사는 실행되지 않습니다.
Q3: N+1 문제란 무엇이며, DRF에서 어떻게 해결합니까?
N+1 문제는 한 번의 쿼리로 N개의 객체를 가져온 후, 각 객체의 관련 데이터를 가져오기 위해 N번의 추가 쿼리가 발생하는 문제입니다. 100개의 기사와 각 기사의 작성자를 가져올 경우, 1(기사 목록)+100(각 작성자)=101번의 쿼리가 발생합니다. 해결 방법으로, ForeignKey 관계에는 select_related를 사용하여 JOIN으로 한 번의 쿼리로 통합하고, ManyToMany 관계에는 prefetch_related를 사용하여 두 번의 쿼리로 전체 데이터를 조회합니다. 뷰의 get_queryset 메서드에서 적절한 프리페치를 설정하는 것이 중요합니다.
Q4: 쓰기 가능한 중첩 시리얼라이저를 구현할 때 주의할 점은 무엇입니까?
기본적으로 중첩 시리얼라이저는 읽기 전용입니다. 쓰기 가능하게 만들려면 create와 update 메서드를 오버라이드해야 합니다. 주의할 점으로, (1) 트랜잭션을 사용하여 부모-자식 객체의 정합성을 보장합니다. (2) 업데이트 시 기존 자식 객체를 어떻게 처리할지(삭제 후 재생성, 병합 등)를 명확히 합니다. (3) 유효성 검사 에러 메시지를 적절히 중첩합니다. (4) 성능을 고려하여 bulk_create나 bulk_update 사용을 검토합니다.
Q5: source 파라미터의 용도와 사용 예시를 설명해 주십시오.
source 파라미터는 시리얼라이저 필드를 모델의 다른 속성에 매핑합니다. 용도로는, (1) 필드명 변경: author_email = serializers.EmailField(source='author.email'). (2) 관련 객체의 속성 접근: category_name = serializers.CharField(source='category.name'). (3) 메서드 호출: full_name = serializers.CharField(source='get_full_name'). (4) 읽기/쓰기 필드 분리: 읽기 시에는 author(객체), 쓰기 시에는 author_id(ID) 사용. source='*'를 지정하면 객체 전체가 전달됩니다.
프로덕션 환경에서의 모범 사례
프로덕션 환경에서 DRF 시리얼라이저를 사용할 때는 다음의 모범 사례를 따르는 것이 권장됩니다.
# serializers.py - Production patterns
from rest_framework import serializers
from django.core.cache import cache
from .models import Article

class CachedAuthorSerializer(serializers.ModelSerializer):
    """Serializer with caching for expensive computations"""
    article_count = serializers.SerializerMethodField()

    class Meta:
        model = Author
        fields = ['id', 'full_name', 'email', 'article_count']

    def get_article_count(self, obj):
        cache_key = f'author_{obj.id}_article_count'
        count = cache.get(cache_key)
        if count is None:
            count = obj.articles.filter(status='published').count()
            cache.set(cache_key, count, timeout=3600)  # 1 hour
        return count
계산 비용이 높은 필드에는 캐시를 적용하여 응답 시간을 개선합니다. 또한 Django의 고급 ORM 기법을 활용하면 추가적인 최적화가 가능합니다. Python의 비동기 기능과 결합하면 높은 부하의 API에서도 확장 가능한 성능을 실현할 수 있습니다.
연습을 시작하세요!
면접 시뮬레이터와 기술 테스트로 지식을 테스트하세요.
결론
Django REST Framework의 시리얼라이저는 API의 품질과 성능을 결정하는 중요한 컴포넌트입니다. 본 문서에서 설명한 주요 내용을 정리합니다.
- 유효성 검사: 필드 레벨, 객체 레벨, 밸리데이터 클래스의 3계층으로 견고한 데이터 검증을 구현합니다
- 중첩 시리얼라이저: 읽기와 쓰기에서 서로 다른 필드를 사용하고,
create/update메서드를 오버라이드하여 쓰기를 가능하게 합니다 - N+1 문제:
select_related와prefetch_related를 적절히 사용하여 쿼리 수를 최소화합니다 - 성능 최적화: 목록용과 상세용으로 서로 다른 시리얼라이저를 사용하고, 동적 필드 선택으로 응답 크기를 줄입니다
시리얼라이저에 대한 깊은 이해는 2026년 Django 개발자 면접에서 중요한 차별화 요소가 됩니다. 본 문서의 코드 예제와 모범 사례를 실습하면 프로덕션 수준의 RESTful API를 구축하는 역량을 갖출 수 있습니다.
Django 코드의 버그를 찾을 수 있나요
실제 코드 한 조각, 숨은 버그 하나, 하루 한 번. 계정 없이 바로 도전할 수 있습니다.

작성자
Anthony Fillion-MailletSharpSkill 창업자
10년 이상 풀스택 개발을 해왔습니다. SharpSkill을 운영하며 이곳에 게시되는 모든 내용에 책임을 집니다.
2026년 7월 12일 업데이트
태그
공유
관련 기사
Django 면접 질문: ORM, 미들웨어, DRF 심층 분석
Django 면접에서 자주 출제되는 ORM 최적화(select_related와 prefetch_related, Django 6.1의 FETCH_PEERS 모드), 미들웨어 아키텍처, Django REST Framework 시리얼라이저 성능, 권한 설정, 페이지네이션 패턴을 상세히 다룹니다.
Django 미들웨어 완벽 가이드 2026: 커스텀 미들웨어, 로깅 구현 및 기술 면접 대비
Django 6.0 미들웨어를 심층 분석합니다. 커스텀 미들웨어 작성법, 비동기 미들웨어, 요청 ID 로깅, 그리고 기술 면접에서 자주 나오는 질문과 답변을 상세히 다룹니다.
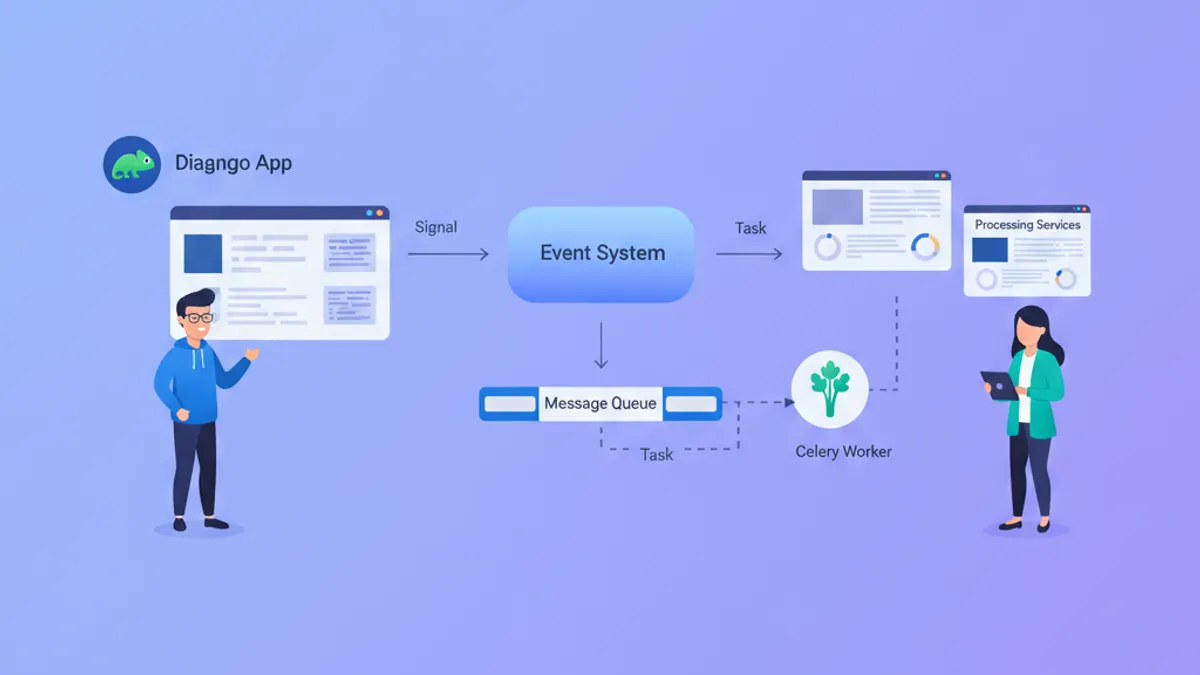
Django Signals vs Celery Tasks 2026: 적절한 사용법과 면접 대비 가이드
Django Signals와 Celery Tasks의 차이점을 상세히 분석합니다. 동기/비동기 처리 구분, 성능 최적화, 기술 면접에서 자주 나오는 질문과 모범 답변을 제공합니다.