RAG와 LLM 2026년판: 데이터 사이언스 면접을 위한 검색 증강 생성 완벽 가이드
2026년 데이터 사이언스 면접을 위한 RAG 해설. 벡터 데이터베이스, 청킹 전략, 임베딩 모델, 에이전틱 RAG, Graph RAG, 프로덕션 파이프라인 아키텍처, EU AI Act 컴플라이언스를 포괄적으로 다룹니다.
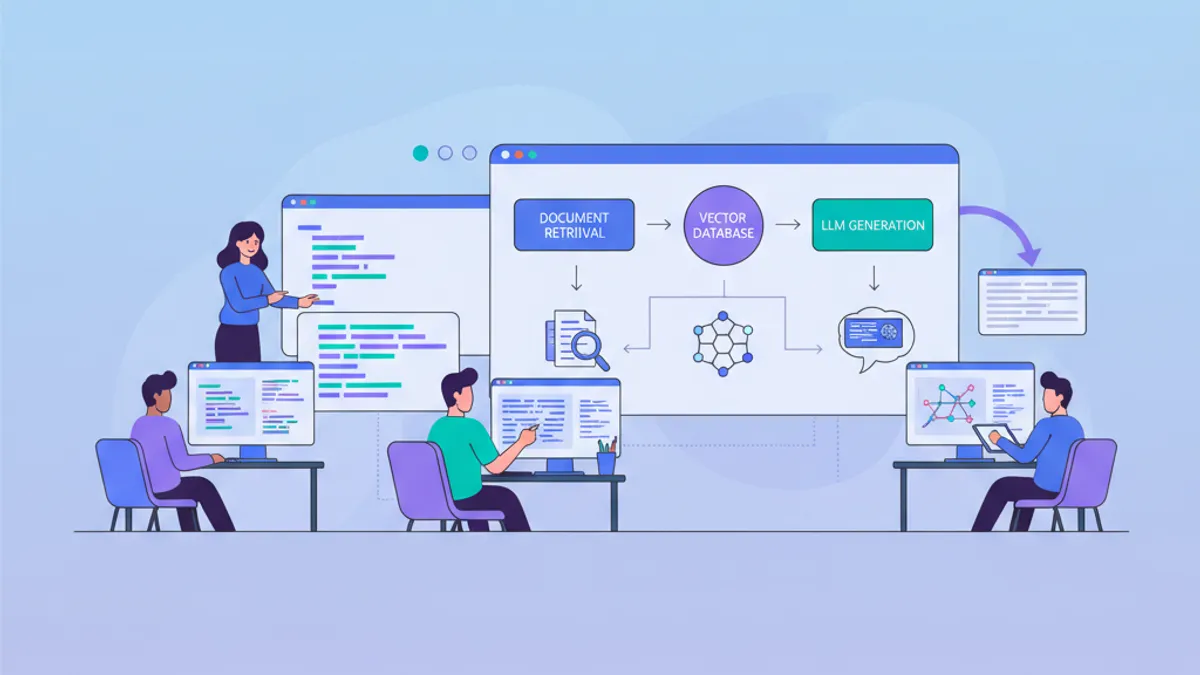
검색 증강 생성(RAG: Retrieval-Augmented Generation)은 LLM의 출력을 사실에 기반한 최신 데이터로 뒷받침하는 표준 아키텍처로 자리 잡았습니다. 2026년 데이터 사이언스 및 AI 엔지니어링 면접에서는 RAG 관련 질문이 기존 ML(머신러닝) 주제와 함께 출제되고 있으며, 시스템 설계 역량과 실제 구현 능력이 동시에 평가됩니다.
검색 증강 생성(RAG)은 검색 시스템(지식 베이스에 대한 벡터 검색)과 LLM 생성기를 결합하여, 모델이 학습 데이터의 기억에 의존하지 않고 실제 문서를 기반으로 답변을 생성하는 아키텍처입니다.
RAG 파이프라인의 엔드투엔드 동작 원리
RAG 시스템은 두 가지 단계로 동작합니다. 지식 베이스를 구축하는 오프라인 인제스천 단계와, 관련 컨텍스트를 검색하여 답변을 생성하는 온라인 쿼리 단계입니다.
인제스천 과정에서는 원본 문서가 클리닝, 청킹, 임베딩 처리를 거쳐 벡터 데이터베이스에 저장됩니다. 추론 시에는 사용자의 쿼리가 동일한 임베딩 경로를 따르며, 최근접 이웃 검색을 통해 가장 관련성이 높은 청크가 검색됩니다. 이러한 청크가 LLM 프롬프트의 일부가 되어, 생성되는 답변이 소스 자료에 근거하게 됩니다.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
이 파이프라인은 RAG의 핵심 루프(청킹, 임베딩, 저장, 검색, 생성)를 다루고 있습니다. search_type="mmr" 파라미터는 검색된 청크가 관련성과 다양성을 동시에 갖추도록 보장하여, 컨텍스트 윈도우 내의 중복을 줄입니다.
검색 품질을 좌우하는 청킹 전략
청킹은 다른 어떤 컴포넌트보다 검색 품질에 큰 영향을 미칩니다. 부적절한 청킹은 컨텍스트가 부족한 단편이나 무관한 정보로 신호가 희석된 단편을 검색 결과로 반환하는 원인이 됩니다.
2026년 프로덕션 시스템에서는 세 가지 청킹 접근 방식이 주류를 이루고 있습니다.
고정 크기 청킹은 설정된 토큰 수(보통 256~512 토큰)로 텍스트를 분할하고 오버랩을 둡니다. 구현이 간단하지만 문장이나 아이디어 중간에서 분할되는 단점이 있습니다.
시맨틱 청킹은 연속된 문장 간의 임베딩 유사도를 측정하여 주제의 경계를 감지합니다. 유사도가 임계값 아래로 떨어지면 새로운 청크가 시작됩니다. 각 청크는 텍스트의 임의 단편이 아닌 일관된 아이디어를 담게 됩니다.
레이트 청킹은 먼저 트랜스포머 모델을 문서 전체에 적용하여 컨텍스트가 포함된 토큰 임베딩을 생성한 후, 청크로 분할합니다. 이를 통해 기존 청킹이 파괴하는 장거리 의존 관계를 보존할 수 있습니다.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
면접에서의 핵심 포인트는 청크 크기가 정밀도와 재현율 간의 트레이드오프라는 점입니다. 작은 청크(100 토큰)는 검색 정밀도를 향상시키지만 컨텍스트가 단편화됩니다. 큰 청크(1000 토큰)는 컨텍스트를 보존하지만 임베딩의 특이성이 희석됩니다. 대부분의 프로덕션 시스템에서는 1020%의 오버랩을 둔 256512 토큰으로 설정합니다.
프로덕션 환경의 벡터 데이터베이스와 임베딩 모델
벡터 데이터베이스는 임베딩을 저장하고 고속 근사 최근접 이웃(ANN) 검색을 지원합니다. 임베딩 모델과 벡터 데이터베이스의 적절한 조합을 선택하는 것이 검색 레이턴시와 정확도에 직접적인 영향을 미칩니다.
2026년의 임베딩 모델은 몇 가지 고성능 옵션으로 수렴되었습니다. OpenAI의 text-embedding-3-large(3072차원)와 BAAI의 bge-m3, Cohere의 embed-v4 같은 오픈소스 대안이 강력한 다국어 검색 성능을 제공하고 있습니다. MTEB 리더보드는 임베딩 품질 비교를 위한 표준 벤치마크로 계속 활용되고 있습니다. text-embedding-3-large는 마트료시카 표현 학습을 지원하여 차원을 1024나 256으로 줄여도 품질 저하가 최소화되므로, 스토리지 비용을 크게 절감할 수 있습니다.
2026년 벡터 데이터베이스 시장은 통합이 진행되었습니다. 4개 제품이 프로덕션 RAG 워크로드의 대부분을 차지하고 있습니다.
| 데이터베이스 | 인덱싱 | 매니지드 | 강점 |
|---|---|---|---|
| Pinecone | 독자 방식 | 지원 | 제로 운영, 내장 추론, 하이브리드 검색 |
| Weaviate | HNSW | 지원/셀프 | 네이티브 BM25 + 밀집 벡터 융합을 단일 쿼리로 실행 |
| Qdrant | HNSW | 지원/셀프 | Rust 기반 고성능, 페이로드 필터링, 최고의 무료 티어 |
| pgvector | IVF, HNSW | 셀프 | 기존 스택에 PostgreSQL 통합 |
면접에서 중요한 것은 HNSW(Hierarchical Navigable Small World) 알고리즘에 대한 이해입니다. HNSW는 다층 그래프를 구축하여 각 노드가 최근접 이웃에 연결되며, 메모리 사용량 증가를 대가로 O(log n) 검색을 구현합니다.
비용 전환점은 월간 6천만8천만 쿼리입니다. 이 임계값을 초과하면 고정 비용 인프라에서 셀프 호스팅하는 Qdrant나 Weaviate가 매니지드 Pinecone Serverless보다 일관되게 310배의 비용 효율성을 보입니다.
Data Science & ML 면접 준비가 되셨나요?
인터랙티브 시뮬레이터, flashcards, 기술 테스트로 연습하세요.
하이브리드 검색: 밀집 벡터와 희소 벡터의 결합
순수 벡터 검색은 정확한 키워드 매칭이나 희귀 용어 검색에 실패합니다. 반면 순수 렉시컬 검색(BM25)은 시맨틱 유사성을 놓칩니다. 하이브리드 검색은 이 둘을 결합하는 접근 방식이며, 2026년 프로덕션 RAG 시스템에서는 기본 설정이 되었습니다.
표준 패턴에서는 Reciprocal Rank Fusion(RRF)을 사용하여 두 리트리버의 랭킹 결과를 통합합니다.
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
하이브리드 검색은 '어휘 불일치' 문제를 해결합니다. 예를 들어, 사용자가 '구독 취소'에 대해 질문하고 있는데, 관련 문서에서는 '계정 해지 정책'이라는 표현을 사용하는 경우입니다. BM25가 정확한 용어 일치를 포착하는 반면, 벡터 검색은 시맨틱 관련성을 파악합니다.
리랭킹: 2단계 필터
검색은 후보를 반환하고, 리랭킹은 그것들을 실제 관련성에 따라 정렬합니다. Cohere Rerank나 bge-reranker-v2.5-gemma2-lightweight 같은 크로스 인코더 리랭커는 각 쿼리-문서 쌍을 동시에 스코어링하여, 바이 인코더 유사도보다 훨씬 정확한 관련성 점수를 생성합니다.
2단계 검색 파이프라인(넓은 1단계 리콜에서 벡터 + BM25로 상위 50100개 후보를 가져온 후, 정밀 리랭킹으로 프롬프트용 상위 510개로 좁힘)은 프로덕션 환경의 표준입니다. 1단계에서 고속 ANN 검색을 사용하고, 비용이 높은 크로스 인코더는 소수의 후보 세트만 처리하기 때문에 레이턴시를 관리 가능한 수준으로 유지할 수 있습니다.
크로스 인코더가 바이 인코더보다 정확한 이유는 쿼리와 문서를 트랜스포머의 모든 레이어에서 동시에 처리하기 때문입니다. 바이 인코더는 각각을 독립적으로 임베딩하므로 세밀한 상호작용 신호가 손실됩니다. 트레이드오프는 속도입니다. 크로스 인코더는 사전 인덱싱이 불가능합니다.
적응형 RAG: 적절한 파이프라인으로 쿼리 라우팅
모든 쿼리가 동일한 검색 복잡도를 요구하지는 않습니다. 적응형 RAG는 작은 분류기를 훈련하여 각 질문을 최적의 경로로 라우팅합니다.
- 검색 없음: 모델이 이미 알고 있는 단순한 사실 쿼리
- 단일 단계 검색: 중간 수준 쿼리
- 다단계 반복 검색: 복잡한 추론
이 패턴은 혼합 워크로드 전반에서 비용과 정확도의 균형을 맞춥니다. 하루 10만 건의 쿼리를 처리하는 프로덕션 시스템은 단순한 질문을 비용이 높은 다단계 파이프라인에서 제외함으로써 추론 비용을 40% 절감할 수 있습니다.
분류기 자체는 작은 파인튜닝 모델이거나 "이 질문에 정확히 답하려면 외부 지식이 필요한가?"라고 묻는 제로샷 프롬프트로 구현할 수 있습니다.
투기적 RAG: 속도를 위한 레이턴시 트레이드오프
투기적 RAG는 빠른 드래프트 생성과 병렬로 검색을 실행합니다. 드래프트가 높은 확신도를 보이면(logprob로 측정) 검색 단계를 완전히 건너뜁니다. 확신도가 낮으면 검색된 컨텍스트가 드래프트에 병합되고 재생성이 이루어집니다.
이 접근법은 높은 확신도의 쿼리에서 평균 레이턴시를 30~40% 줄입니다. 실시간 챗봇, 자동완성 제안, 고객 서비스 시스템처럼 모든 쿼리에서 완벽한 소싱보다 응답 시간이 중요한 경우에 효과적입니다.
트레이드오프로, 투기적 RAG는 모델이 과신할 때 근거 없이 답변을 반환하는 경우가 있습니다. 프로덕션 시스템에서는 확신도 보정과 불확실성이 임계값을 초과할 때 전체 검색으로 폴백하는 방식을 함께 사용합니다.
에이전틱 RAG: 단발성 검색을 넘어서
나이브 RAG는 한 번 검색하고 생성하는 것이 전부입니다. 에이전틱 RAG는 LLM을 언제 검색할지, 무엇을 검색할지, 검색된 컨텍스트가 충분한지를 판단하는 추론 에이전트로 취급합니다.
2026년에는 다단계 추론이 필요한 복잡한 쿼리에 대해 에이전틱 RAG가 지배적인 패턴이 되었습니다. 에이전트는 다음과 같은 작업을 수행할 수 있습니다.
- 자기 평가: 검색된 문서가 질문에 답변하고 있는지 평가
- 재쿼리: 초기 결과가 불충분할 경우 검색 쿼리를 재구성
- 라우팅: 다양한 지식 소스(벡터 DB, SQL 데이터베이스, API) 중에서 선택
- 검증: 여러 검색 패시지 간의 사실 관계를 교차 확인
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
이 패턴(검색, 평가, 필요 시 쿼리 재작성 후 재시도)은 Corrective RAG(CRAG)로 알려져 있습니다. LangChain의 AgentExecutor는 2026년 기준으로 더 이상 사용되지 않으며, 새 프로젝트에서는 내장 패턴용으로 create_react_agent()를, 커스텀 오케스트레이션용으로 LangGraph의 StateGraph를 사용해야 합니다. 데이터 사이언티스트를 위한 LangChain 패턴에 대한 자세한 내용은 전용 기사를 참조하시기 바랍니다.
Graph RAG: 구조화된 지식 검색
Graph RAG는 문서에서 엔티티와 관계를 추출하여 지식 그래프를 구축하고, 그래프와 벡터 스토어 양쪽에 쿼리를 실행합니다. 이 아키텍처는 비정형 텍스트 유사성이 아닌 명시적인 엔티티 간 관계에 답변을 근거함으로써, 사실 관련 쿼리에서의 할루시네이션을 줄입니다.
인제스천 파이프라인은 각 문서 청크에서 트리플(주어, 술어, 목적어)을 추출합니다. 쿼리 시에는 질문 내의 관련 엔티티를 식별하고, 지식 그래프를 탐색하여 연결된 사실을 검색한 후, 그래프 검색으로 얻은 컨텍스트와 벡터 검색으로 얻은 패시지를 결합합니다.
Graph RAG는 '문서 X에서 언급된 프레임워크를 사용하는 프로젝트를 이끄는 팀은 어디인가?'와 같은 멀티홉 추론 쿼리에 탁월합니다. 이는 여러 문서에 걸친 사실을 연결해야 하는 쿼리로, 단일 청크에 완전한 답변이 포함되어 있지 않기 때문에 순수 벡터 검색으로는 대응하기 어렵습니다.
Graph RAG는 사실 정확도를 크게 향상시키지만(엔티티가 많은 쿼리에서 할루시네이션을 최대 40% 감소), 성숙한 엔티티 추출 파이프라인을 필요로 합니다. 노이즈가 많은 추출은 노이즈가 많은 그래프를 생성하여, 나이브 RAG보다 결과가 악화될 수 있습니다. 또한 Microsoft의 GraphRAG 프로젝트는 2026년에 유지보수 모드로 전환되었습니다. 버그 수정은 계속되지만 새로운 기능 추가는 없습니다.
Microsoft의 LazyGraphRAG 변형(2025년 6월 출시)은 요약 처리를 쿼리 시점까지 지연시켜 인덱싱 비용을 크게 줄이며, 사전 그래프 구축이 현실적이지 않은 탐색적 분석이나 스트리밍 데이터에 적합합니다.
EU AI Act: RAG 시스템의 컴플라이언스 요건
EU AI Act는 2026년 8월부터 광범위하게 적용되고 있습니다. 동법에 따른 첫 고액 벌금은 2026년 5월 말 유럽 은행 컨소시엄의 RAG 챗봇에 부과되었으며, 2026년 4월에는 프랑크푸르트의 자산운용사가 데이터 출처를 설명하지 못하는 고객 대면 RAG 시스템으로 인해 450만 유로의 벌금을 받았습니다.
RAG 아키텍처는 여러 컴플라이언스 요건을 본질적으로 충족합니다. 소스 추적 가능성(청크가 문서 참조를 보유), 답변 투명성(인용 표시 가능), 감사 가능성(검색 로그가 구조적으로 존재)이 그것입니다. 다만 완전한 컴플라이언스를 위해서는 추가 조치가 필요합니다.
위험 분류: 공개 챗봇은 제한적 위험(투명성 필요)에 해당합니다. 의료 또는 법률 RAG 시스템은 더 엄격한 문서화 및 감독 의무가 따르는 고위험으로 분류됩니다.
감사 로그: 어떤 질문이 어떤 검색 청크를 트리거했고 어떤 답변이 생성되었는지 기록합니다. 이 로그가 필수 추적 가능성의 기반이 됩니다.
인적 감독: 고위험 시스템은 민감한 케이스에서의 인적 검증, 출력 수정 기능, 요청 시 인덱싱된 데이터 삭제 메커니즘이 필요합니다.
데이터 레지던시: 인덱싱을 EU 내에서 호스팅하고 BYOK(Bring Your Own Key)를 사용하여 데이터가 관할권 외의 제3자 계정을 경유하지 않도록 합니다.
위반 시 전 세계 연간 매출의 7%에 해당하는 벌금이 부과될 수 있습니다. 면접에서 중요한 점은 RAG가 본질적으로 갖춘 인용 기능이 장점이지만, 그것만으로는 거버넌스 레이어를 대체할 수 없다는 것입니다.
RAG 시스템 평가: 중요한 지표
RAG 평가는 검색 지표와 생성 지표로 나뉩니다. 장애 진단을 위해서는 두 가지를 독립적으로 측정해야 합니다.
검색 지표:
- Recall@k: 관련 문서가 상위 k개 결과에 포함되었는가?
- MRR(Mean Reciprocal Rank): 첫 번째 관련 결과의 순위는 얼마나 높은가?
- NDCG: 랭킹이 이상적인 관련성 순서와 일치하는가?
생성 지표:
- 충실도(Faithfulness): 답변이 검색된 컨텍스트의 정보만 사용하고 있는가? (할루시네이션 측정)
- 답변 관련성(Answer relevance): 답변이 원래 질문에 대응하고 있는가?
- 컨텍스트 정밀도(Context precision): 검색된 청크가 실제로 답변에 활용되었는가?
Ragas와 DeepEval 같은 프레임워크는 LLM-as-judge 패턴을 사용하여 이러한 평가를 자동화합니다. 데이터 사이언스 면접 빈출 질문에서는 RAG 평가 설계가 점점 더 많이 포함되고 있으며, RAG 시스템이 올바르게 작동하는지를 어떻게 측정하는지에 대한 설명이 요구됩니다.
프로덕션 환경의 장애 모드와 디버깅
RAG 시스템은 예측 가능한 패턴으로 장애를 일으킵니다. 이러한 패턴을 아는 것은 면접과 실제 배포 모두에 필수적입니다.
컨텍스트 윈도우 오염은 검색된 청크가 너무 많아 관련 신호가 희석될 때 발생합니다. LLM이 10개의 청크를 받지만 유용한 정보를 포함한 것은 2개뿐인 상황입니다. 해결책: 리랭커를 사용하여 필터링하고 리트리버의 top-k를 줄입니다.
청킹 아티팩트는 고정 크기 분할이 문장, 테이블, 코드 블록을 중간에서 잘라낼 때 발생합니다. 검색된 청크는 구문적으로 불완전하고 시맨틱적으로 무용합니다. 시맨틱 청킹 또는 문서 구조를 고려한 분할(헤더, 단락, 코드 펜스 존중)로 해결할 수 있습니다.
임베딩 드리프트는 임베딩 모델이 업데이트되었음에도 벡터 스토어에 이전 모델의 임베딩이 그대로 저장되어 있을 때 발생합니다. 새 모델로 인코딩된 쿼리가 이전 모델로 구축된 벡터 공간을 검색하게 되어 검색 품질이 저하됩니다. 해결책: 모델 변경 후 전체 코퍼스를 재임베딩합니다.
노후화된 인덱스는 인제스천 파이프라인이 문서 업데이트에 뒤처져 오래된 정보를 제공하는 경우입니다. 머신러닝 시스템에서는 이를 학습-서빙 스큐에 비유할 수 있습니다. 검색 시스템이 프로덕션 환경에 존재하는 데이터 분포와 다른 것을 참조하게 되는 것입니다.
Sources
- Turing Post: 20 Advanced RAG Types to Know in 2026 - RAG 패턴의 포괄적 분류
- LangChain and LangGraph 1.0 Milestones - AgentExecutor 지원 중단과 새로운 패턴
- Microsoft GraphRAG GitHub - 유지보수 모드 상태
- IgnitionRAG EU AI Act Guide - RAG 시스템의 컴플라이언스 요건
- MarkTechPost: Best Vector Databases in 2026 - 시장 통합과 가격 정책
연습을 시작하세요!
면접 시뮬레이터와 기술 테스트로 지식을 테스트하세요.
데이터 사이언스 면접을 위한 RAG 핵심 포인트
- RAG는 검색(지식 베이스에 대한 벡터 검색)과 LLM 생성을 결합하여, 모델 재학습 없이 사실에 기반한 답변을 생성합니다
- 청킹 전략이 검색 품질에 가장 큰 영향을 미칩니다. 시맨틱 청킹과 레이트 청킹은 대부분의 사용 사례에서 고정 크기 분할을 능가합니다
- 하이브리드 검색(밀집 벡터 + 희소 BM25)과 Reciprocal Rank Fusion은 프로덕션의 기본 설정이며, 순수 벡터 검색으로는 해결할 수 없는 어휘 불일치 문제를 해결합니다
- 크로스 인코더 리랭커는 광범위한 검색 후 정밀도 계층을 추가하며, 소수의 후보 세트만 처리하여 레이턴시를 허용 범위 내로 유지합니다
- 적응형 RAG는 쿼리를 적절한 파이프라인 복잡도로 라우팅하여 혼합 워크로드에서 비용을 40% 절감합니다
- 투기적 RAG는 근거 있는 답변과 속도를 맞바꾸며, 높은 확신도의 쿼리에서 레이턴시를 30~40% 줄입니다
- 에이전틱 RAG(검색, 평가, 재작성, 재시도)와 Graph RAG(엔티티-관계 추출)는 나이브 RAG가 실패하는 복잡한 멀티홉 쿼리를 처리합니다
- EU AI Act 컴플라이언스(2026년 8월)로 인해 프로덕션 RAG 시스템에는 감사 로그, 인적 감독, 위험 분류가 필요합니다
- 평가는 검색 지표(Recall@k, MRR)와 생성 지표(충실도, 답변 관련성)를 분리하여, 파이프라인에서 장애가 발생하는 위치를 진단해야 합니다
- 가장 흔한 프로덕션 장애(컨텍스트 오염, 청킹 아티팩트, 임베딩 드리프트, 노후화된 인덱스)는 식별되면 모두 간단히 수정할 수 있습니다
Data Science & ML 코드의 버그를 찾을 수 있나요
실제 코드 한 조각, 숨은 버그 하나, 하루 한 번. 계정 없이 바로 도전할 수 있습니다.

작성자
Anthony Fillion-MailletSharpSkill 창업자
10년 이상 풀스택 개발을 해왔습니다. SharpSkill을 운영하며 이곳에 게시되는 모든 내용에 책임을 집니다.
2026년 8월 24일 업데이트
태그
공유
관련 기사
2026년 MLOps: MLflow, 모델 레지스트리와 기술 면접 질문
ML 라이프사이클, MLflow 실험 추적, 모델 레지스트리 승격, 배포 패턴, 드리프트 모니터링, 2026년을 위한 시스템 디자인을 Python 코드와 답변으로 다루는 MLOps 면접 질문.
머신러닝 알고리즘 완벽 해설: 기술 면접을 위한 종합 가이드
머신러닝 알고리즘 기술 면접 가이드. 선형 모델, 의사결정 트리, 앙상블, 클러스터링, 평가 지표, 정규화를 scikit-learn 코드와 함께 체계적으로 해설합니다.
2026년 데이터 사이언스 면접 질문 25선
통계, 머신러닝, 피처 엔지니어링, 딥러닝, SQL, 시스템 설계를 망라하는 데이터 사이언스 면접 질문 25선 — Python 코드 예제와 심층 해설 포함.