2026년 Excel Power Query 완벽 가이드: 데이터 분석가를 위한 ETL 기법과 면접 대비
Excel Power Query를 활용한 ETL 워크플로우 완벽 가이드입니다. M 언어 기초, 데이터 변환 테크닉, 쿼리 폴딩, 데이터 분석가 면접에서 자주 출제되는 질문을 다룹니다.
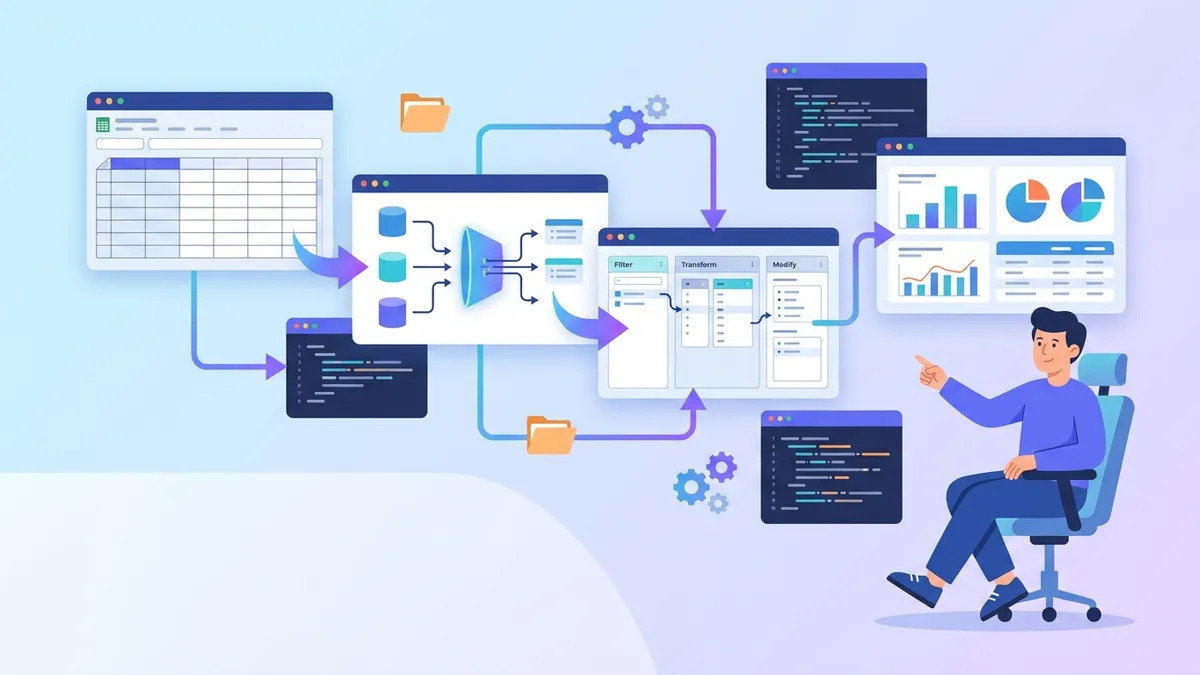
Excel Power Query는 데이터 분석가가 Excel 내에서 직접 ETL(Extract, Transform, Load) 워크플로우를 수행하는 방식을 근본적으로 바꿔놓습니다. 수동 복사-붙여넣기나 복잡한 VBA 매크로와 달리, Power Query는 M 언어 기반의 시각적 인터페이스를 제공하여 한 번의 클릭으로 새로고침 가능한 반복 가능한 데이터 변환을 구현합니다.
Power Query는 Excel 365, Excel 2021, Excel 2019, Excel 2016에 기본 탑재되어 있습니다. 이전 버전에서는 "Power Query for Excel"이라는 무료 추가 기능으로 제공되었습니다. 동일한 엔진이 Power BI Desktop 데이터 흐름에도 사용됩니다.
Power Query가 데이터 분석가의 과제를 해결하는 방법
데이터 분석가는 데이터 준비에 상당한 시간을 소비합니다. 서로 다른 소스에서 파일 병합, 일관성 없는 형식 정리, 불필요한 행 필터링, 분석을 위한 테이블 재구성 등의 작업입니다. Power Query는 각 변환 단계를 기록하는 쿼리 편집기를 통해 이러한 작업을 처리합니다. 소스 데이터가 변경되면 전체 파이프라인이 자동으로 다시 실행됩니다.
워크플로우는 세 단계로 구성됩니다: 데이터 소스에 연결, 변환 적용, Excel 테이블 또는 데이터 모델에 결과 로드입니다. 각 단계는 M 언어 구문을 사용하는 수식 입력줄에 기록되며, 고급 시나리오에서는 직접 편집할 수 있습니다.
이 접근 방식은 전통적인 Excel 수식과 다릅니다. 수식이 셀을 다시 계산하는 반면, Power Query는 워크시트에 도달하기 전에 전체 테이블에 대해 작업합니다. 50개의 CSV 파일을 통합하고, 중복을 제거하고, 열을 언피벗하는 쿼리는 한 번 실행되어 깨끗한 테이블을 생성합니다. 통합 문서를 느리게 만드는 복잡하게 중첩된 수식을 작성할 필요가 없습니다.
데이터 가져오기로 데이터 소스에 연결하기
Power Query는 파일(CSV, Excel, JSON, XML), 데이터베이스(SQL Server, MySQL, PostgreSQL, Oracle), 클라우드 서비스(SharePoint, Azure, Salesforce), 웹 페이지에 대한 연결을 지원합니다. 연결 유형에 따라 표시되는 인증 및 가져오기 옵션이 결정됩니다.
// Power Query의 주요 데이터 소스
데이터 > 데이터 가져오기 > 파일에서 > CSV에서
데이터 > 데이터 가져오기 > 데이터베이스에서 > SQL Server 데이터베이스에서
데이터 > 데이터 가져오기 > 기타 원본에서 > 웹에서
데이터 > 데이터 가져오기 > 폴더에서 (여러 파일)
"폴더에서" 옵션은 여러 파일을 통합하는 데 특히 유용합니다. 각 파일을 개별적으로 가져오는 대신, Power Query가 폴더를 스캔하고 일치하는 모든 파일을 나열하여 단일 쿼리로 결합합니다. 폴더에 새 파일을 추가하면 다음 새로고침 시 자동으로 포함됩니다.
SQL 데이터베이스에 연결할 때 Power Query는 쿼리 폴딩을 통해 변환 로직을 서버에 푸시할 수 있습니다. 필터와 열 선택이 SQL WHERE 및 SELECT 절로 변환되어 Excel로 전송되는 데이터 양이 줄어듭니다. 폴딩이 활성화되면 수식 입력줄에 "네이티브 쿼리 보기" 옵션이 표시됩니다.
쿼리 편집기에서의 핵심 변환
쿼리 편집기는 일반적인 작업을 위한 리본 명령을 제공하지만, 사용자 정의가 필요할 때는 기본 M 코드를 이해하는 것이 도움됩니다. 각 변환은 "적용된 단계" 창에 단계를 추가하여 감사 가능한 시퀀스를 생성합니다.
행 필터링 및 정렬
필터링은 조건을 충족하지 않는 행을 제거합니다. 열 머리글 드롭다운에서 빠른 필터를 제공하고, "행 필터" 대화 상자에서는 AND/OR 논리를 사용한 복잡한 조건을 지원합니다.
// M 언어의 FilteredRows 단계
let
    Source = Excel.CurrentWorkbook(){[Name="SalesData"]}[Content],
    FilteredRows = Table.SelectRows(Source, each [Region] = "EMEA" and [Amount] > 1000)
in
    FilteredRows
Table.SelectRows 함수는 테이블과 조건을 받습니다. each 키워드는 함수를 생성하고, _는 현재 행을 나타내며, 필드 접근은 대괄호 표기법 [Region]을 사용합니다. 여러 조건은 and 또는 or 연산자로 결합됩니다.
열 제거 및 이름 바꾸기
데이터 소스에는 분석에 필요하지 않은 열이 포함되어 있는 경우가 많습니다. 일찍 제거하면 메모리 사용량이 줄고 후속 단계가 간소화됩니다.
// 열 제거 후 나머지 열 이름 바꾸기
let
    Source = Excel.CurrentWorkbook(){[Name="RawData"]}[Content],
    RemovedColumns = Table.RemoveColumns(Source, {"TempID", "InternalNotes", "Debug"}),
    RenamedColumns = Table.RenameColumns(RemovedColumns, {{"Cust_Name", "CustomerName"}, {"Amt", "Amount"}})
in
    RenamedColumns
열 목록은 여러 항목에 중괄호 {}를 사용합니다. 이름 바꾸기는 쌍의 목록을 받으며, 각 쌍에는 이전 이름과 새 이름이 포함됩니다. 쿼리 간에 일관된 명명 규칙을 사용하면 데이터셋 결합이 쉬워집니다.
열 분할 및 병합
텍스트 열은 종종 파싱이 필요합니다. "FullName" 열을 성과 이름으로 분할해야 하거나, 별도의 날짜와 시간 열을 병합해야 할 수 있습니다.
// 구분 기호로 FullName을 두 열로 분할
let
    Source = Excel.CurrentWorkbook(){[Name="Contacts"]}[Content],
    SplitColumn = Table.SplitColumn(Source, "FullName", Splitter.SplitTextByDelimiter(" ", QuoteStyle.Csv), {"FirstName", "LastName"})
in
    SplitColumn
Splitter.SplitTextByDelimiter 함수가 파싱 로직을 처리합니다. 더 복잡한 패턴의 경우 Splitter.SplitTextByEachDelimiter 또는 Splitter.SplitTextByPositions가 추가 제어를 제공합니다. 결과 열 수가 달라지면 Power Query가 동적으로 열을 생성합니다.
형식 변환 및 데이터 품질
Power Query는 가져오기 시 열 형식을 추론하지만, 명시적 형식 할당으로 오류를 조기에 발견할 수 있습니다. 앞에 오는 0이 중요한 경우 숫자 ID가 포함된 텍스트 열은 텍스트로 유지해야 합니다. 텍스트로 가져온 날짜 열은 정렬 문제를 일으킵니다.
// 명시적 형식 할당
let
    Source = Csv.Document(File.Contents("C:\Data\transactions.csv")),
    TypedColumns = Table.TransformColumnTypes(Source, {
        {"TransactionID", type text},
        {"Date", type date},
        {"Amount", type number},
        {"IsProcessed", type logical}
    })
in
    TypedColumns
type 키워드가 대상 형식을 지정합니다. 사용 가능한 형식에는 text, number, date, datetime, datetimezone, time, duration, logical, binary가 있습니다. 형식 오류는 셀에서 "Error" 값으로 표시되어 분석 전에 데이터 품질 문제가 보입니다.
Null 값 처리에는 명시적 로직이 필요합니다. Table.ReplaceValue 함수는 null을 기본값으로 대체하고, Table.SelectRows에서 [Column] <> null을 사용하면 null을 필터링할 수 있습니다.
Group By를 통한 그룹화 및 집계
카테고리별 데이터 집계는 자주 요구되는 작업입니다. "그룹화" 변환은 동일한 키 값을 공유하는 행을 축소하고 집계 함수를 적용합니다.
// 지역과 연도별로 매출을 그룹화하고 합계와 개수 계산
let
    Source = Excel.CurrentWorkbook(){[Name="Sales"]}[Content],
    Grouped = Table.Group(Source, {"Region", "Year"}, {
        {"TotalSales", each List.Sum([Amount]), type number},
        {"OrderCount", each Table.RowCount(_), Int64.Type},
        {"AvgOrderValue", each List.Average([Amount]), type number}
    })
in
    Grouped
그룹화 열이 먼저 나타나고, 그 뒤에 집계 정의가 따릅니다. 각 집계는 새 열 이름, 집계 함수, 선택적 결과 형식을 지정합니다. each 키워드는 각 그룹의 하위 테이블을 나타내며, 모든 테이블 또는 목록 함수를 사용할 수 있습니다.
중첩 집계를 통해 후속 단계에서 행 값과 그룹 집계를 모두 참조하여 "그룹 합계 대비 백분율"과 같은 계산이 가능합니다.
Data Analytics 면접 준비가 되셨나요?
인터랙티브 시뮬레이터, flashcards, 기술 테스트로 연습하세요.
피벗 및 언피벗으로 데이터 재구성
피벗은 행 값을 열로 변환하여 크로스탭 레이아웃을 생성합니다. 언피벗은 그 반대로, 정규화된 구조를 위해 열을 행으로 변환합니다.
// 월 열을 행으로 언피벗
let
    Source = Excel.CurrentWorkbook(){[Name="MonthlySales"]}[Content],
    // 원본: Product, Jan, Feb, Mar, Apr 열
    Unpivoted = Table.UnpivotOtherColumns(Source, {"Product"}, "Month", "Sales")
    // 결과: Product, Month, Sales 열
in
    Unpivoted
Table.UnpivotOtherColumns 함수는 지정된 열을 고정하고 나머지를 언피벗합니다. 이는 언피벗할 모든 열을 나열하는 것보다 안전합니다. 새 월 열을 추가하면 자동으로 포함되기 때문입니다. 뒤의 두 매개변수는 속성 열("Month")과 값 열("Sales")의 이름을 지정합니다.
피벗은 동일한 행-열 조합에 여러 값이 있을 때 집계 함수와 함께 Table.Pivot을 사용합니다:
// 지역별로 매출 피벗
let
    Source = Excel.CurrentWorkbook(){[Name="DetailedSales"]}[Content],
    Pivoted = Table.Pivot(Source, List.Distinct(Source[Region]), "Region", "Amount", List.Sum)
in
    Pivoted
쿼리 병합 및 추가
여러 소스에서 데이터를 결합하는 것은 Power Query가 수동 작업을 줄이는 부분입니다. 병합(Merge)은 일치하는 열을 기반으로 두 테이블 간에 조인을 수행합니다. 추가(Append)는 테이블을 세로로 쌓습니다.
// 왼쪽 외부 조인: Orders와 Customer 세부 정보
let
    Orders = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    Customers = Excel.CurrentWorkbook(){[Name="Customers"]}[Content],
    Merged = Table.NestedJoin(Orders, {"CustomerID"}, Customers, {"ID"}, "CustomerDetails", JoinKind.LeftOuter),
    Expanded = Table.ExpandTableColumn(Merged, "CustomerDetails", {"Name", "Email"})
in
    Expanded
Table.NestedJoin 함수는 일치하는 행이 포함된 중첩 테이블 열을 생성합니다. Table.ExpandTableColumn 함수가 중첩 구조를 일반 열로 평면화합니다. 조인 종류에는 Inner, LeftOuter, RightOuter, FullOuter, LeftAnti, RightAnti가 있습니다.
Table.Combine을 사용한 추가에는 일치하는 열 이름이 필요합니다. 스키마가 다를 경우 결합 전에 각 소스에서 Table.SelectColumns를 사용하여 일관성을 확보합니다:
// 일관된 열로 두 매출 테이블 추가
let
    Sales2024 = Table.SelectColumns(Source2024, {"Date", "Product", "Amount"}),
    Sales2025 = Table.SelectColumns(Source2025, {"Date", "Product", "Amount"}),
    Combined = Table.Combine({Sales2024, Sales2025})
in
    Combined
사용자 지정 열 및 조건 논리
"열 추가 > 사용자 지정 열" 기능을 통해 M 식을 사용한 계산 필드가 가능합니다. 조건 논리는 if-then-else 구문을 사용합니다.
// 조건 논리로 계산 열 추가
let
    Source = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    AddedColumn = Table.AddColumn(Source, "OrderCategory", each
        if [Amount] >= 10000 then "Enterprise"
        else if [Amount] >= 1000 then "Business"
        else "Consumer",
        type text
    )
in
    AddedColumn
if 식에는 then과 else 분기가 모두 포함되어야 합니다. 중첩 조건은 else if로 연결합니다. 마지막 매개변수는 열 형식을 지정하여 성능을 향상시키고 형식 추론 문제를 방지합니다.
복잡한 변환의 경우 let 블록에서 정의된 헬퍼 함수로 코드가 읽기 쉬워집니다:
let
    // 회계 분기용 헬퍼 함수
    GetFiscalQuarter = (date as date) as text =>
        let
            month = Date.Month(date),
            fiscalQ = if month >= 4 and month <= 6 then "Q1"
                     else if month >= 7 and month <= 9 then "Q2"
                     else if month >= 10 and month <= 12 then "Q3"
                     else "Q4"
        in
            fiscalQ,

    Source = Excel.CurrentWorkbook(){[Name="Transactions"]}[Content],
    AddedQuarter = Table.AddColumn(Source, "FiscalQuarter", each GetFiscalQuarter([Date]), type text)
in
    AddedQuarter
Power Query에서의 오류 처리
변환 오류는 전체 쿼리를 실패시키는 대신 셀에서 "Error" 값으로 표시됩니다. try-otherwise 구문으로 오류를 적절히 처리할 수 있습니다:
// 잠재적 나눗셈 오류 처리
let
    Source = Excel.CurrentWorkbook(){[Name="Metrics"]}[Content],
    AddedRatio = Table.AddColumn(Source, "Ratio", each
        try [Value1] / [Value2] otherwise null,
        type number
    )
in
    AddedRatio
try 키워드는 식을 시도하고 HasError 및 Value 필드가 있는 레코드를 반환합니다. otherwise 절은 HasError가 true일 때 폴백을 제공합니다. 더 많은 제어가 필요하면 try Expression으로 오류 세부 정보에 접근할 수 있습니다:
// 오류 세부 정보 캡처
let
    result = try SomeRiskyFunction(),
    output = if result[HasError] then "Error: " & result[Error][Message] else result[Value]
in
    output
데이터 분석가를 위한 Power Query 면접 질문
면접관은 실무 기술과 Power Query가 워크플로우에 적합한 상황에 대한 이해를 모두 평가합니다. 다음 질문들이 데이터 분석가 면접에서 자주 출제됩니다.
쿼리 폴딩이란 무엇이고 왜 중요한가?
쿼리 폴딩은 Power Query 변환을 데이터 소스의 네이티브 쿼리로 변환합니다. SQL Server에 연결할 때 필터 단계는 서버에서 실행되는 WHERE 절이 되어 네트워크 전송이 줄어듭니다. 모든 변환이 폴딩되는 것은 아닙니다: 사용자 정의 M 함수, 특정 날짜 조작, 폴딩 불가능한 단계 이후의 작업은 체인을 끊습니다. 단계를 마우스 오른쪽 버튼으로 클릭하고 "네이티브 쿼리 보기"를 찾아 폴딩 상태를 확인할 수 있습니다.
Power Query는 데이터 변환에서 Excel 수식과 어떻게 다른가?
Excel 수식은 워크시트 내에서 셀 단위로 작동하고 모든 변경 시 다시 계산됩니다. Power Query는 워크시트에 도달하기 전에 테이블에 대해 작동하며, 새로고침 중에 데이터를 일괄 처리합니다. 언피벗, 중복 제거, 파일 병합과 같은 변환의 경우 Power Query는 중첩된 index-match나 헬퍼 열보다 더 직접적으로 로직을 표현합니다.
ETL에 Power BI 대신 Power Query를 선택하는 때는 언제인가?
Excel 내의 Power Query는 분석가가 임시 분석, 피벗 테이블 또는 Power BI에 액세스할 수 없는 사용자와 공유하기 위해 스프레드시트 형식의 변환된 데이터가 필요한 시나리오에 적합합니다. Power BI는 더 풍부한 시각화, 더 큰 데이터 용량, 엔터프라이즈 공유 기능을 제공합니다. 동일한 M 코드가 두 도구 모두에서 작동하므로 Excel에서 개발한 쿼리를 다시 작성하지 않고 Power BI Desktop으로 마이그레이션할 수 있습니다.
테이블을 추가할 때 데이터 형식 불일치를 어떻게 처리하는가?
Table.Combine으로 결합하기 전에 각 소스 테이블에 명시적 형식을 설정합니다. 열이 한 소스에서는 텍스트이고 다른 소스에서는 숫자인 경우 추가가 실패하거나 오류가 발생합니다. 두 소스 모두에서 Table.TransformColumnTypes를 사용하여 일관된 형식을 적용합니다. try-otherwise 패턴은 특정 값에서 변환이 실패하는 에지 케이스를 처리합니다.
Power Query에서 Merge와 Append의 차이를 설명해 주세요.
Merge는 일치하는 키 열을 기반으로 수평 조인을 수행합니다. SQL JOIN과 유사합니다. Append는 여러 테이블에서 행의 수직 합집합을 수행합니다. SQL UNION ALL과 유사합니다. Merge에는 매칭을 위해 최소 하나의 공통 열이 필요합니다. Append에서는 열 이름이 동일해야 올바르게 정렬됩니다.
Power Query 기술을 보완하는 SQL 개념에 대한 심층 준비를 위해 SQL 윈도우 함수 모듈에서 순위 지정 및 집계 패턴을, SQL 서브쿼리 및 CTE 모듈에서 쿼리 구조화 기법을 확인할 수 있습니다.
로드 옵션 및 새로고침 전략
변환 후 "닫기 및 로드" 버튼은 로드 선택지를 제공합니다: 워크시트 테이블로 로드, 데이터 모델(Power Pivot)에만 로드, 또는 연결 전용 쿼리 생성입니다. 연결 전용 쿼리는 워크시트 공간을 사용하지 않고 다른 쿼리의 스테이징 단계로 사용됩니다.
새로고침 동작은 로드 대상에 따라 다릅니다. 워크시트 테이블은 "모두 새로고침" 버튼으로 새로고침하거나 파일을 열 때 새로고침되도록 설정할 수 있습니다. 데이터 모델 테이블은 통합 문서의 데이터 모델 새로고침 주기에 참여합니다. 외부 데이터베이스에 연결된 쿼리의 경우, 저장된 자격 증명이 없으면 새로고침 시 자격 증명 프롬프트가 나타날 수 있습니다.
백그라운드 새로고침을 사용하면 데이터 로딩 중에도 통합 문서를 사용할 수 있지만, 다운스트림 수식이 새로고침된 데이터에 의존할 때 복잡성이 생깁니다. 쿼리 속성의 "백그라운드 새로고침 사용" 옵션이 이 동작을 제어합니다. 중요한 보고서의 경우 백그라운드 새로고침을 비활성화하면 순차 실행이 보장됩니다.
대규모 데이터셋의 성능 고려 사항
Power Query는 수백만 행을 처리할 수 있지만, 통합 문서 응답성은 데이터 로드 방식에 따라 달라집니다. 워크시트 테이블 대신 데이터 모델에 로드하면 Excel의 행 제한을 피하고 피벗 테이블 성능이 향상됩니다. 불필요한 열을 일찍 제거하면 메모리 풋프린트가 줄어듭니다.
몇 분이 걸리는 쿼리의 경우, 쿼리 편집기의 "데이터 미리 보기"는 샘플만 표시합니다. 변환은 새로고침 중에 전체 데이터셋에 적용됩니다. 미리 보기에 표시되는 오류는 문제를 나타내지만, 일부 오류는 전체 데이터에서만 나타납니다. 하위 집합에서 테스트 새로고침을 실행하면 모든 것을 처리하기 전에 쿼리를 검증할 수 있습니다.
많은 파일을 통합할 때 Power Query의 바이너리 결합 기능은 파일을 병렬로 처리합니다. 하나의 파일을 변환하는 함수를 정의한 다음 파일 목록의 각 행에 대해 호출하면 기본 결합 접근 방식보다 더 많은 제어가 가능합니다.
Microsoft의 Power Query 모범 사례 문서에서 쿼리 종속성 구조와 버퍼 사용을 포함한 최적화 기법을 자세히 설명합니다.
반복 가능한 ETL 파이프라인을 위한 Power Query
Power Query에서 기록된 단계는 변환 로직의 문서를 생성합니다. 요구 사항이 변경되면 단계를 수정하면 모든 다운스트림 단계가 자동으로 업데이트됩니다. 이는 소스 데이터가 변경되면 처음부터 다시 만들어야 하는 임시 Excel 조작과 대조됩니다.
팀은 연결을 내보내거나 쿼리 M 코드를 버전 관리에 저장하여 쿼리를 공유할 수 있습니다. 고급 편집기(보기 > 고급 편집기)는 전체 M 스크립트를 표시하며, 다른 통합 문서에 복사하여 붙여넣을 수 있습니다. 엔터프라이즈 시나리오의 경우 Power BI 데이터 흐름과 Fabric이 중앙 집중식 쿼리 관리를 제공합니다.
- Power Query는 기록되고 반복 가능한 변환 단계를 사용하여 Excel 내에서 ETL을 처리합니다
- 시각적 인터페이스의 기반인 M 언어는 리본 명령을 넘어선 사용자 정의를 가능하게 합니다
- 쿼리 폴딩은 필터와 프로젝션을 소스 데이터베이스에 푸시하여 성능을 향상시킵니다
- Merge는 테이블 간 조인을 수행하고, Append는 테이블을 세로로 쌓습니다
- 형식 할당과 오류 처리로 무음 데이터 품질 문제를 방지합니다
- 연결 전용 쿼리는 워크시트 출력 없이 재사용 가능한 스테이징 단계를 생성합니다
- 면접 질문은 쿼리 폴딩, 수식 비교, Merge와 Append 구분에 초점을 맞춥니다
연습을 시작하세요!
면접 시뮬레이터와 기술 테스트로 지식을 테스트하세요.
Data Analytics 코드의 버그를 찾을 수 있나요
실제 코드 한 조각, 숨은 버그 하나, 하루 한 번. 계정 없이 바로 도전할 수 있습니다.
작성자
Anthony Fillion-MailletSharpSkill 창업자
10년 이상 풀스택 개발을 해왔습니다. SharpSkill을 운영하며 이곳에 게시되는 모든 내용에 책임을 집니다.
2026년 9월 20일 업데이트
공유
관련 기사
데이터 분석가 면접 질문 2026년 완벽 가이드: SQL, Python, 분석 스킬
2026년 데이터 분석가 면접에서 자주 출제되는 SQL, Python, 통계 분석 질문과 모범 답변을 상세히 다룹니다. 실전 코드 예제와 핵심 포인트로 취업 성공을 준비합니다.
2026년 이탈리아 데이터 분석가 면접 가이드: SQL, Python, 케이스 스터디 완벽 대비
2026년 이탈리아 기업의 데이터 분석가 면접에서 출제되는 SQL, Python, 케이스 스터디 문제와 대비 전략을 상세히 분석합니다. 밀라노와 로마의 채용 프로세스 및 연봉 수준도 소개합니다.
Polars vs Pandas 2026년 비교: 성능, 문법, 데이터 분석가 면접 대비
2026년 Polars와 Pandas의 상세 비교 분석입니다. 벤치마크 결과, 문법 차이, 메모리 효율성, 그리고 데이터 분석가 면접에서 자주 출제되는 질문과 모범 답변을 다룹니다.