Principios SRE en 2026: ingeniería de confiabilidad, SLO y preguntas de entrevista
Principios SRE explicados para 2026: cómo elegir SLI, fijar SLO, calcular el presupuesto de errores, escribir alertas de burn rate con múltiples ventanas en Prometheus y responder las preguntas de entrevista SRE más comunes.
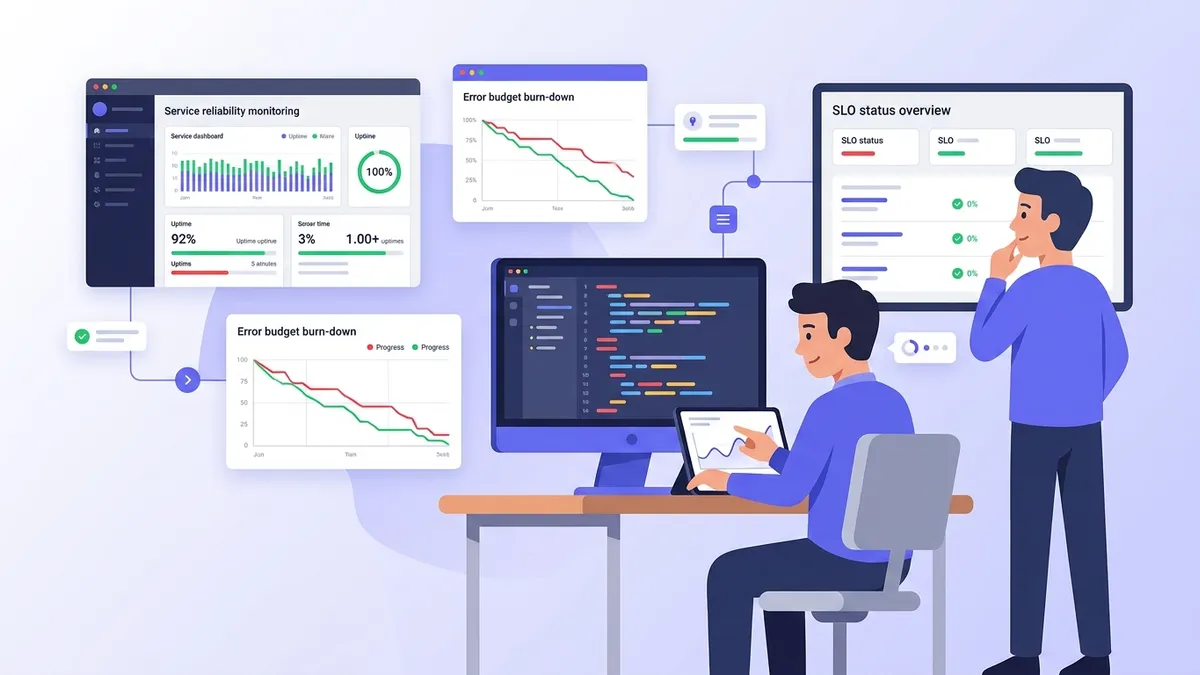
Los principios SRE convierten la confiabilidad, un objetivo que suele quedarse en lo abstracto, en un número que producto e ingeniería aceptan por igual, y luego usan ese número para decidir cuándo lanzar cambios y cuándo frenar. El site reliability engineering, tal como lo definió Google y como hoy lo aplican la mayoría de los equipos de plataforma, se apoya en pocas ideas: medir lo que experimenta el usuario (SLI), fijar una meta por debajo del 100 % (SLO), gastar esa diferencia como presupuesto de errores y limitar el trabajo manual que mantiene los sistemas en pie. Las preguntas de entrevista SRE de 2026 evalúan justamente estas ideas, casi siempre pidiendo al candidato que defina el SLO de un servicio real y escriba la alerta que lo protege.
Un SLI es una medición: la proporción entre eventos buenos y eventos válidos, por ejemplo solicitudes exitosas sobre el total de solicitudes. Un SLO es la meta interna para esa proporción en una ventana de tiempo, como 99,9 % en 30 días. Un SLA es el compromiso contractual con los clientes, con penalizaciones, y siempre es más laxo que el SLO.
Los principios centrales del site reliability engineering
El libro de SRE de Google trata la confiabilidad como una funcionalidad con costo. Cada nueve adicional exige más tiempo de ingeniería y vuelve más lentos los despliegues, mientras que los usuarios casi nunca notan la diferencia entre 99,99 % y 99,999 %, porque su propia red, su dispositivo y su proveedor de internet son menos confiables que eso. La meta es el nivel adecuado de confiabilidad, no el máximo posible.
De ese punto de partida se derivan algunos principios:
- La confiabilidad se mide desde el lado del usuario. El uso de CPU y los reinicios de pods son causas. Un pago fallido o una página que tarda en cargar es lo que vive el usuario, y eso es lo que captura un SLI.
- El 100 % es la meta equivocada. Un SLO del 100 % prohíbe cualquier cambio, ya que todo despliegue implica riesgo. La brecha por debajo del 100 % es el presupuesto de errores, y está pensado para gastarse en lanzamientos, experimentos y migraciones.
- El toil tiene un tope. El capítulo sobre eliminación del toil establece que el trabajo operativo debe ocupar menos del 50 % del tiempo de un SRE. El toil es trabajo manual, repetitivo, automatizable y que crece de forma lineal con el servicio. El resto del tiempo se dedica a la ingeniería que lo elimina.
- Los postmortems no buscan culpables. La revisión de un incidente pregunta qué permitió la falla dentro del sistema, no quién ejecutó el comando. Un ingeniero señalado oculta información; una revisión sin culpables la saca a la luz.
- El monitoreo alerta sobre síntomas. Una alerta de guardia se dispara cuando los usuarios están siendo afectados o están por serlo, no cuando un nodo aislado se comporta de forma extraña.
En una entrevista, el segundo punto es el que separa a un SRE con experiencia de alguien que solo leyó el libro. Una respuesta junior describe el presupuesto de errores como una tolerancia a fallas. Una respuesta senior lo describe como una herramienta de gestión de lanzamientos: el mecanismo que permite a producto y confiabilidad discutir con datos en lugar de opiniones.
Cómo elegir SLI que reflejen la experiencia del usuario
Un buen SLI es una proporción entre 0 y 1, calculada a partir de eventos que el usuario reconocería. El SRE workbook sugiere un menú corto según el tipo de servicio:
| Tipo de servicio | SLI habituales | Dónde medir |
|---|---|---|
| API basada en solicitudes | Disponibilidad, latencia | Logs del balanceador o del ingress, métricas del servidor |
| Pipeline de datos | Frescura, exactitud, cobertura | Marcas de tiempo de salida, jobs de validación |
| Sistema de almacenamiento | Durabilidad, latencia de lectura y escritura | Capa de almacenamiento, sondas sintéticas |
| Frontend | Tiempo de carga, tasa de errores en el navegador | Real user monitoring |
Medir en el balanceador de carga detecta fallas que la aplicación nunca ve, como un pod caído que no responde nada. Medir en el navegador revela problemas de CDN y DNS, pero suma ruido por conexiones móviles inestables. La mayoría de los equipos empieza por el balanceador o el ingress, porque los datos ya están ahí.
Con Prometheus, los dos SLI clásicos de un servicio HTTP son una proporción de disponibilidad y una de latencia. El SLI de latencia cuenta como buenas las solicitudes que responden por debajo de un umbral, lo que lo convierte en una proporción como las demás en lugar de un percentil.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Hay dos detalles que suelen salir en entrevistas. Primero, las respuestas 4xx normalmente cuentan como válidas y buenas, porque un 404 o un error de validación es responsabilidad del cliente; contarlas como fallas permite que un cliente defectuoso consuma el presupuesto. Segundo, el umbral de latencia debe coincidir con un límite de bucket del histograma; de lo contrario, la consulta no devuelve nada o usa en silencio el bucket incorrecto. Prometheus 3.16, publicado el 5 de noviembre de 2026, soporta histogramas nativos, que eliminan la restricción de buckets fijos pero deben habilitarse del lado del scrape.
Cómo fijar la meta del SLO y calcular el presupuesto de errores
Un SLO combina un SLI, una meta y una ventana. La ventana suele ser móvil, de 28 o 30 días, para que el presupuesto se recupere gradualmente en vez de reiniciarse el primer día del mes. La meta se define con base en el desempeño histórico y en lo que esperan los usuarios, no en lo que luce bien en una presentación.
La siguiente tabla muestra lo que permite cada meta en una ventana de 30 días. Es aritmética simple: el presupuesto es (1 - SLO) × 30 días.
| Meta del SLO | Presupuesto de errores | Caída total permitida en 30 días |
|---|---|---|
| 99 % | 1 % | 7 h 12 min |
| 99,5 % | 0,5 % | 3 h 36 min |
| 99,9 % | 0,1 % | 43 min 12 s |
| 99,95 % | 0,05 % | 21 min 36 s |
| 99,99 % | 0,01 % | 4 min 19 s |
En los SLO basados en solicitudes, el presupuesto se expresa en solicitudes y no en minutos: con 99,9 % y 12 millones de solicitudes en la ventana, se admiten 12 000 solicitudes fallidas. Este enfoque es más justo para servicios con tráfico irregular, ya que una caída a las 3 de la mañana consume menos presupuesto que la misma caída en hora pico.
Un ejercicio frecuente en entrevistas es calcular el presupuesto restante y la velocidad a la que se consume. El siguiente script es el tipo de respuesta que se espera cuando la pregunta pide código.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Un burn rate de 15 significa que el servicio falla en el 1,5 % de las solicitudes mientras el SLO solo permite 0,1 %. A ese ritmo, el 35 % de presupuesto restante se agota en menos de 17 horas, lo cual justifica despertar a alguien.
¿Listo para aprobar tus entrevistas de DevOps?
Practica con nuestros simuladores interactivos, flashcards y tests técnicos.
Alertas por burn rate con múltiples ventanas
Alertar directamente sobre el SLI («tasa de errores mayor a 0,1 %») genera alertas con cada pico breve y deja pasar las fugas lentas. El capítulo del workbook sobre alertas basadas en SLO recomienda en su lugar alertas de múltiples ventanas y múltiples burn rates. Cada alerta responde una sola pregunta: ¿el presupuesto se está gastando tan rápido que se agotará antes de que alguien lo revise?
Los umbrales de referencia para una ventana de 30 días son:
| Severidad | Ventana larga | Ventana corta | Burn rate | Presupuesto consumido al dispararse |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2 % |
| Page | 6 h | 30 min | 6 | 5 % |
| Ticket | 3 días | 6 h | 1 | 10 % |
La ventana larga aporta significancia: un minuto malo no despierta a nadie. La ventana corta, equivalente a un doceavo de la larga, hace que la alerta se resuelva rápido una vez superado el incidente, para que no siga sonando durante una hora después de la corrección. Ambas condiciones deben cumplirse al mismo tiempo.
El primer bloque registra la proporción de errores para cada ventana, de modo que las expresiones de alerta sean baratas de evaluar. El segundo define las dos alertas de tipo page para un SLO de 99,9 %, donde la fracción de presupuesto es 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageEscribir estas reglas a mano para cada servicio se vuelve repetitivo. Sloth, un generador de SLO de código abierto, toma una especificación breve y produce las reglas de registro y las alertas multi-burn-rate mostradas arriba. El marcador {{.window}} se reemplaza por cada ventana que Sloth necesita.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Los equipos que buscan un formato neutral respecto al proveedor recurren a la especificación OpenSLO, que describe los SLO en YAML sin depender del backend de monitoreo.
Política de presupuesto de errores y decisiones de lanzamiento
Un presupuesto de errores sin política es un dashboard que nadie usa para actuar. El ejemplo de política de presupuesto de errores del workbook detalla qué ocurre cuando el presupuesto se agota y quién lo aprobó por adelantado.
Una política típica incluye:
- El disparador. El servicio superó su presupuesto de errores en la ventana móvil.
- La consecuencia. Se detienen los lanzamientos de funcionalidades, salvo correcciones de seguridad y cambios que mejoren la confiabilidad, hasta que el servicio vuelva a cumplir su SLO.
- La vía de excepción. Un incidente puntual causado por una dependencia fuera del control del equipo puede excluirse, siempre que la decisión quede documentada.
- La escalación. Los desacuerdos se elevan a un rol definido, como el CTO, y no a quien discuta con más fuerza.
Producto e ingeniería firman la política antes del primer incumplimiento, y ese es precisamente su valor: el congelamiento se convierte en una regla acordada de antemano y no en una pelea en medio de un incidente. Los entrevistadores suelen preguntar qué sucede cuando el presupuesto nunca se toca. La respuesta esperada es que el SLO podría ser demasiado laxo, o que el equipo lanza con demasiada cautela, y que el presupuesto debería invertirse en lanzamientos más rápidos o en migraciones más arriesgadas.
Igualar el SLO interno al SLA con el cliente no deja margen: el primer incumplimiento del SLO ya es una penalización contractual. El SLO debe ser más estricto que el SLA, para que las alertas se disparen y el congelamiento empiece mientras el contrato todavía se cumple.
Reducción del toil, guardias y postmortems sin culpables
El tiempo de un SRE se reparte entre operaciones e ingeniería. Las operaciones incluyen guardias, tickets e intervenciones manuales. La ingeniería abarca automatización, planificación de capacidad y funcionalidades de confiabilidad. Cuando el toil supera el límite del 50 %, el equipo SRE devuelve trabajo al equipo de desarrollo o invierte en automatización; de lo contrario, termina siendo un equipo de operaciones con un nuevo nombre.
La salud de las guardias se mide, no se supone. Las señales útiles son las alertas por turno, la proporción de alertas que requirieron una acción y el tiempo de reconocimiento. Una alerta que no exige ninguna acción es un bug del sistema de alertas y debe corregirse o eliminarse. Las alertas basadas en síntomas y en el burn rate del SLO, como las reglas anteriores, reducen considerablemente el volumen frente a las alertas por CPU, memoria o reinicios de pods individuales.
Cuando ocurre un incidente, el capítulo sobre la cultura del postmortem del libro SRE describe la revisión posterior. Un postmortem registra el impacto en términos de SLO (cuánto presupuesto se consumió), la línea de tiempo, los factores contribuyentes y las acciones pendientes con responsables y fechas. Evita señalar a una persona como causa. En entrevistas suelen aparecer dos preguntas de seguimiento: cómo asegurar que las acciones realmente se completen (registrarlas en el mismo backlog que las funcionalidades y revisarlas en una reunión periódica) y cuándo es obligatorio un postmortem (cualquier incidente que haya consumido una parte importante del presupuesto, cualquier alerta que haya despertado a alguien, cualquier pérdida de datos).
Las cuatro señales doradas del libro SRE, latencia, tráfico, errores y saturación, completan el panorama de monitoreo. La latencia y los errores suelen convertirse en SLI. El tráfico y la saturación alimentan la planificación de capacidad y los dashboards, más que las alertas.
Preguntas de entrevista SRE con respuestas esperadas
Estas son las preguntas que se repiten en los procesos de selección para SRE y DevOps senior, junto con el núcleo de una buena respuesta. El módulo de entrevista sobre principios SRE practica los mismos temas, y el módulo de alertas y respuesta a incidentes cubre la parte de guardias.
P: ¿Cuál es la diferencia entre un SLI, un SLO y un SLA?
El SLI es la proporción medida, el SLO es la meta interna para ella en una ventana y el SLA es el contrato externo con penalizaciones. El SLO es más estricto que el SLA para que el equipo reaccione antes de perder dinero.
P: ¿Por qué no fijar el SLO en 100 %?
Porque todo cambio implica riesgo, así que una meta del 100 % prohíbe los lanzamientos. Además, los usuarios no perciben una confiabilidad superior a la de su propia red. La brecha por debajo del 100 % es el presupuesto de errores, que financia los lanzamientos.
P: Defina un SLO para una API de checkout.
Una respuesta sólida elige dos SLI (disponibilidad excluyendo 4xx y latencia por debajo de un umbral medida en el balanceador), una ventana móvil de 30 días, metas basadas en los datos del último trimestre, y explica cómo se derivan de ellos las alertas y la política de presupuesto de errores. Mencionar solo «99,99 % de uptime» sin decir qué se mide es la respuesta débil típica.
P: ¿Por qué las alertas sobre la latencia p99 son una mala alerta de SLO?
Un p99 en una ventana corta es ruidoso y no puede agregarse entre instancias. Convertir la latencia en una proporción de solicitudes por debajo de un umbral la vuelve aditiva, comparable con el SLI de disponibilidad y compatible con las alertas de burn rate.
P: Explique el burn rate y por qué las alertas usan dos ventanas.
El burn rate es la proporción de errores observada dividida entre la fracción de presupuesto; un valor de 1 significa que el presupuesto dura exactamente la ventana. La ventana larga filtra los picos breves y la corta permite que la alerta se resuelva rápido tras la recuperación.
P: ¿Qué es el toil y cómo se mantiene bajo control?
Trabajo manual, repetitivo y automatizable, sin valor duradero, que escala con el servicio. Se mide, se limita (Google usa el 50 %) y se reduce mediante automatización o devolviendo el trabajo al equipo responsable.
P: ¿Qué hace que un postmortem sea sin culpables?
Se enfoca en las condiciones del sistema que permitieron la falla, asume que las personas actuaron razonablemente con la información disponible y genera acciones con seguimiento. La prueba: ¿el ingeniero involucrado compartiría cada detalle sin temor?
Las preguntas de monitoreo suelen venir después de las de SLO en la misma entrevista. La guía de preguntas de entrevista sobre Prometheus cubre PromQL, tipos de métricas y cardinalidad, y la página de la tecnología DevOps reúne todos los módulos para una preparación más amplia.
SLO y presupuestos de errores en la práctica: lo esencial
- Definir cada SLI como una proporción de eventos buenos sobre eventos válidos, medida lo más cerca posible del usuario, excluyendo los 4xx de las fallas en la mayoría de las API
- Elegir el SLO a partir de datos históricos y una ventana móvil de 28 o 30 días, manteniéndolo más estricto que cualquier SLA con clientes
- Traducir la meta en un presupuesto expresado en minutos o en solicitudes y dominar las cifras: 99,9 % en 30 días equivale a 43 minutos
- Alertar sobre el burn rate con ventanas pareadas (14,4 en 1 h y 5 min, 6 en 6 h y 30 min), no sobre la tasa de errores bruta ni sobre el CPU
- Generar las reglas con Sloth o una herramienta similar en cuanto más de un par de servicios tengan SLO, para mantener umbrales coherentes
- Redactar y firmar la política de presupuesto de errores antes del primer incumplimiento, incluyendo la regla de congelamiento y la ruta de escalación
- Dar seguimiento al toil, al volumen de alertas y a las acciones de los postmortems con el mismo rigor que a las funcionalidades
¡Empieza a practicar!
Pon a prueba tu conocimiento con nuestros simuladores de entrevista y tests técnicos.
¿Sabrías detectar el bug en DevOps?
Un fragmento real, un bug oculto, un intento al día. Sin cuenta para probar.

Escrito por
Anthony Fillion-MailletFundador de SharpSkill
Desarrollador fullstack desde hace más de 10 años. Dirige SharpSkill y responde por todo lo que se publica aquí.
Actualizado el 7 de noviembre de 2026
Etiquetas
Compartir
Artículos relacionados

Preguntas de entrevista sobre Prometheus 2026: Prometheus vs Grafana vs Datadog comparados
Preguntas de entrevista sobre Prometheus para roles DevOps y SRE, con respuestas sobre PromQL, tipos de métricas, cardinalidad y HA, más una comparativa de Prometheus vs Grafana vs Datadog en arquitectura, alertado y precios.
Ansible vs Terraform en 2026: Infrastructure as Code y Preguntas de Entrevista DevOps
Comparativa completa entre Ansible y Terraform para Infrastructure as Code en 2026. Entender gestión de configuración vs aprovisionamiento, cuándo usar cada herramienta, y prepararse para entrevistas DevOps.
Docker Compose en 2026: Aplicaciones Multi-Contenedor, Redes y Preguntas de Entrevista DevOps
Guía completa sobre Docker Compose en 2026 que cubre aplicaciones multi-contenedor, configuración avanzada de redes y preguntas frecuentes en entrevistas DevOps.