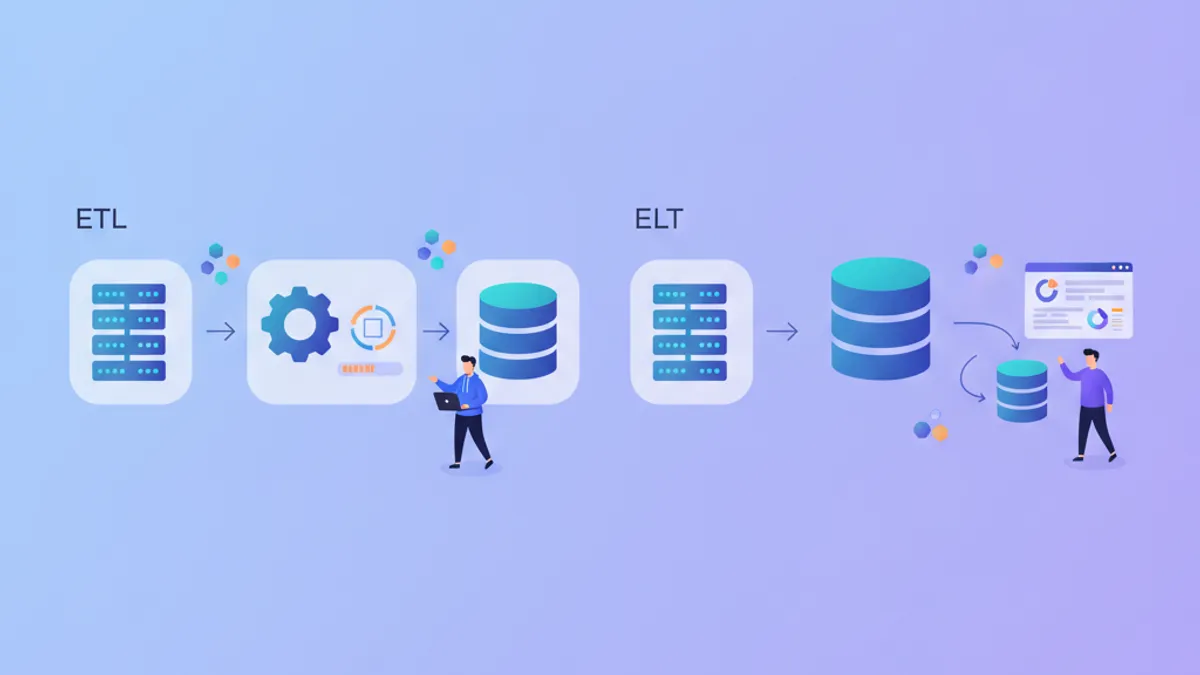
ETL vs ELT en 2026: Arquitectura de Pipelines de Datos y Preguntas de Entrevista
Análisis profundo de las arquitecturas ETL y ELT, comparación de patrones de pipelines de datos y preguntas de entrevista para ingenieros de datos en 2026.
Programa completo de Data Engineering que cubre toda la cadena de producción de datos. Desde la configuración de entornos con Docker y GCP hasta la orquestación de pipelines con Airflow y dbt, pasando por la creación de Data Warehouses con BigQuery y PostgreSQL. Aprende a manejar streaming de datos con PySpark, Pub/Sub y Apache Beam, y a desplegar en producción con Kubernetes y Terraform. Domina las mejores prácticas de CI/CD, monitoreo y arquitecturas de datos modernas.
Entornos de desarrollo: Linux, Git, GitHub, VS Code, Python avanzado
CI/CD y calidad de código: Ruff, Pylint, Poetry, GitHub Actions
Contenedorización con Docker y Docker Compose
APIs con FastAPI: diseño, despliegue, documentación
Data Lake: ingestión, almacenamiento, organización de datos crudos
Data Warehouse con BigQuery: esquemas, particionamiento, optimización
PostgreSQL: configuración, administración, comparación con soluciones administradas
Ingestión de datos con Fivetran y Airbyte
Transformación con dbt: models, tests, documentación, modularidad
Orquestación con Apache Airflow: DAGs, scheduling, monitoreo
Big Data con PySpark: transformaciones a gran escala
Streaming de datos: Google Pub/Sub, Apache Beam, Dataflow
Kubernetes: despliegue de contenedores, scaling, clusters de producción
Infrastructure as Code con Terraform
Bases de datos avanzadas: GraphDB, Document DBs, Wide Column DBs
Logging, monitoreo y observabilidad de pipelines
Los conceptos más importantes para entender esta tecnología y aprobar tus entrevistas
Linux y Shell: comandos esenciales, scripting bash, permisos, cron jobs
Git y GitHub: branching, merge, rebase, pull requests, CI/CD workflows
Python avanzado: POO, decoradores, generadores, context managers, typing, async/await
CI/CD: linting (Ruff, Pylint), packaging (Poetry), tests, GitHub Actions, pipelines
Docker: Dockerfile, imágenes, contenedores, volumes, networks, multi-stage builds
Docker Compose: servicios multi-contenedor, dependencias, healthchecks, orquestación local
FastAPI: rutas, modelos Pydantic, dependencias, middleware, despliegue
SQL avanzado: window functions, CTEs, consultas analíticas, optimización, indexación
BigQuery: arquitectura serverless, particionamiento, clustering, costos, UDFs, federated queries
PostgreSQL: configuración, replicación, indexación (B-tree, GIN, GiST), VACUUM, EXPLAIN ANALYZE
Data Modeling: esquema en estrella, tablas de hechos/dimensiones, normalización, SCD, data vault
ELT vs ETL vs ETLT: patrones, trade-offs, decisiones de arquitectura
Fivetran y Airbyte: conectores, modos de sincronización, CDC, evolución de esquema
dbt: models, sources, refs, tests, snapshots, incremental models, Jinja macros
Apache Airflow: DAGs, operators, sensors, XCom, connections, pools, dependencias de tareas
PySpark: RDD vs DataFrame, transformaciones, acciones, partitioning, broadcast variables
Streaming: Pub/Sub (topics, subscriptions), Apache Beam (PCollections, transforms, windowing), Dataflow
Kubernetes: pods, deployments, services, ingress, ConfigMaps, Secrets, Helm, scaling
Terraform: providers, resources, state, modules, plan/apply, infrastructure as code
IAM y seguridad: principios de privilegio mínimo, service accounts, roles de GCP
Bases de datos NoSQL: GraphDB (Neo4j), Document DBs (MongoDB, Firestore), Wide Column (Cassandra, Bigtable)
Arquitectura de datos: Data Lake vs Data Warehouse vs Data Lakehouse, Data Mesh, Data Contracts
Monitoreo y observabilidad: logging, métricas, alertas, SLA/SLO/SLI, data quality checks
Un fragmento al día. Encuentra el bug, o demuestra que no hay ninguno.
Puestos fijos y freelance, con país, remoto y salario cuando se publica. Actualizadas cada día, reservadas a los suscriptores.
Descubre nuestros últimos artículos y guías sobre Data Engineering
Análisis profundo de las arquitecturas ETL y ELT, comparación de patrones de pipelines de datos y preguntas de entrevista para ingenieros de datos en 2026.
Guía completa de Great Expectations 1.22 para validación de calidad de datos. Expectations, Checkpoints, integración con Airflow y preguntas de entrevista de data engineering.
Comparación detallada entre Apache Beam y Spark para pipelines de datos en 2026. Portabilidad, windowing, rendimiento y preguntas técnicas de entrevista.