RAG và LLM năm 2026: Retrieval-Augmented Generation cho Phỏng Vấn Data Science
Retrieval-Augmented Generation (RAG) giải thích cho phỏng vấn data science năm 2026. Bao gồm cơ sở dữ liệu vector, chiến lược chunking, mô hình embedding, agentic RAG, Graph RAG, tuân thủ EU AI Act, và kiến trúc pipeline sẵn sàng cho sản xuất.
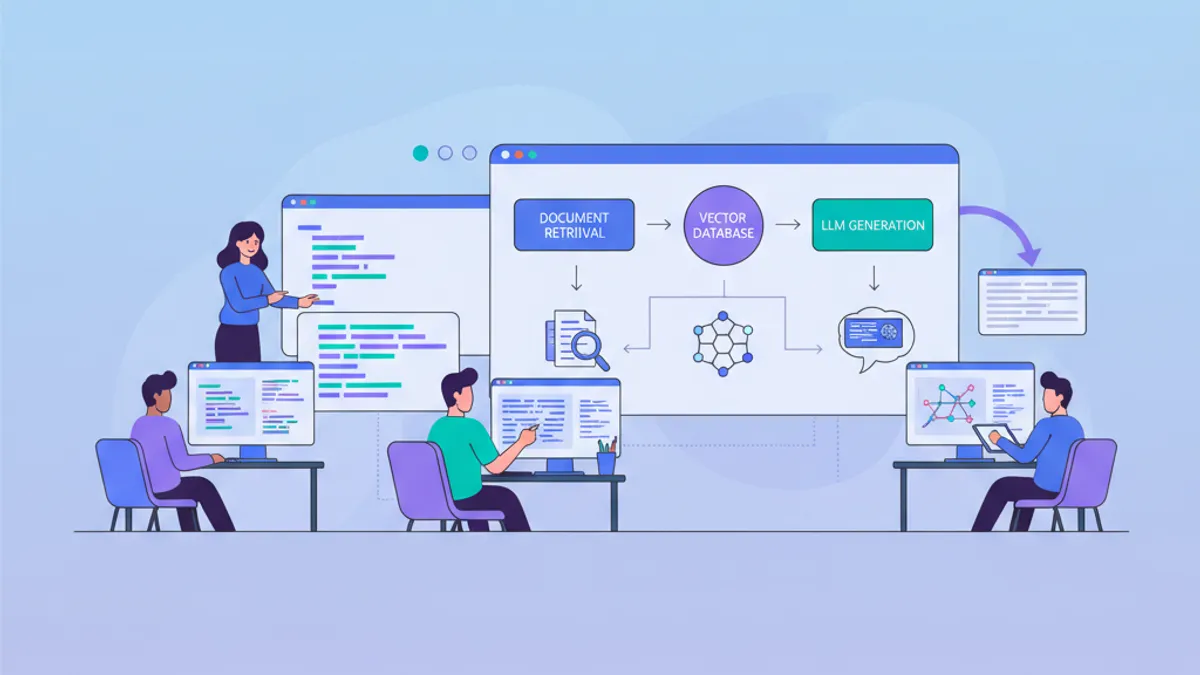
Retrieval-Augmented Generation (RAG) đã trở thành kiến trúc tiêu chuẩn để neo các đầu ra của LLM vào dữ liệu thực tế và cập nhật. Trong các buổi phỏng vấn data science và kỹ thuật AI năm 2026, câu hỏi về RAG giờ đây xuất hiện song song với các chủ đề ML truyền thống, kiểm tra cả tư duy thiết kế hệ thống lẫn kỹ năng triển khai thực hành.
Retrieval-Augmented Generation kết hợp một hệ thống truy xuất (tìm kiếm vector trên cơ sở tri thức) với một bộ sinh LLM, để mô hình trả lời dựa trên tài liệu thực thay vì dựa vào dữ liệu huấn luyện đã ghi nhớ.
Pipeline RAG Hoạt Động Từ Đầu Đến Cuối Như Thế Nào
Một hệ thống RAG vận hành theo hai pha: pha nạp dữ liệu (ingestion) ngoại tuyến xây dựng cơ sở tri thức, và pha truy vấn trực tuyến truy xuất ngữ cảnh liên quan rồi sinh câu trả lời.
Trong quá trình nạp dữ liệu, tài liệu thô đi qua làm sạch, chia đoạn (chunking) và nhúng (embedding) trước khi lưu vào cơ sở dữ liệu vector. Trong quá trình suy luận, truy vấn của người dùng theo cùng đường nhúng đó, và tìm kiếm láng giềng gần nhất truy xuất các đoạn liên quan nhất. Những đoạn này trở thành một phần của prompt LLM, neo câu trả lời được sinh ra vào tài liệu nguồn.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Pipeline này bao quát vòng lặp cốt lõi của RAG: chia đoạn, nhúng, lưu trữ, truy xuất, sinh. Tham số search_type="mmr" đảm bảo các đoạn được truy xuất vừa liên quan vừa đa dạng, giảm dư thừa trong cửa sổ ngữ cảnh.
Chiến Lược Chunking Thực Sự Quan Trọng
Chunking quyết định chất lượng truy xuất hơn bất kỳ thành phần nào khác. Chunking kém nghĩa là bộ truy xuất trả về các mảnh hoặc thiếu ngữ cảnh hoặc làm loãng tín hiệu bằng nội dung không liên quan.
Ba cách tiếp cận chunking chiếm ưu thế trong các hệ thống sản xuất năm 2026:
Chunking kích thước cố định chia văn bản tại một số lượng token đã định (thường là 256 đến 512 token) với phần chồng lấn (overlap). Đơn giản để triển khai, nhưng cắt câu và ý tưởng ở giữa chừng.
Chunking ngữ nghĩa phát hiện ranh giới chủ đề bằng cách đo độ tương đồng nhúng giữa các câu liên tiếp. Khi độ tương đồng giảm xuống dưới ngưỡng, một đoạn mới bắt đầu. Mỗi đoạn mang một ý tưởng mạch lạc thay vì một lát cắt văn bản tùy ý.
Late chunking áp dụng mô hình transformer cho toàn bộ tài liệu trước, tạo ra các nhúng token theo ngữ cảnh, rồi mới chia thành đoạn. Cách này giữ lại các phụ thuộc tầm xa mà chunking truyền thống phá hủy.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Hiểu biết phỏng vấn then chốt: kích thước đoạn là một sự đánh đổi giữa độ chính xác và độ bao phủ (precision-recall). Đoạn nhỏ (100 token) cải thiện độ chính xác truy xuất nhưng phân mảnh ngữ cảnh. Đoạn lớn (1000 token) giữ ngữ cảnh nhưng làm loãng tính đặc thù của nhúng. Hầu hết hệ thống sản xuất dừng ở 256 đến 512 token với phần chồng lấn 10 đến 20%.
Cơ Sở Dữ Liệu Vector và Mô Hình Embedding Trong Sản Xuất
Cơ sở dữ liệu vector lưu trữ các nhúng và hỗ trợ tìm kiếm láng giềng gần nhất xấp xỉ (ANN) nhanh chóng. Việc chọn đúng tổ hợp mô hình embedding và cơ sở dữ liệu vector ảnh hưởng trực tiếp đến độ trễ và độ chính xác truy xuất.
Các mô hình embedding năm 2026 đã hội tụ quanh một vài lựa chọn hiệu năng cao. text-embedding-3-large của OpenAI (3072 chiều) và các lựa chọn mã nguồn mở như bge-m3 của BAAI hay embed-v4 của Cohere cung cấp khả năng truy xuất đa ngôn ngữ mạnh mẽ. Bảng xếp hạng MTEB vẫn là chuẩn benchmark để so sánh chất lượng embedding. Cần lưu ý rằng text-embedding-3-large hỗ trợ Matryoshka representation learning, cho phép cắt giảm chiều (xuống 1024 hoặc 256) với mất mát chất lượng tối thiểu, giảm đáng kể chi phí lưu trữ.
Thị trường cơ sở dữ liệu vector đã hợp nhất vào năm 2026. Bốn sản phẩm chiếm phần lớn khối lượng công việc RAG sản xuất:
| Cơ sở dữ liệu | Lập chỉ mục | Có quản lý | Thế mạnh |
|---|---|---|---|
| Pinecone | Độc quyền | Có | Không cần vận hành, suy luận tích hợp, tìm kiếm lai |
| Weaviate | HNSW | Có/Tự host | Kết hợp BM25 + dense nguyên bản trong một truy vấn |
| Qdrant | HNSW | Có/Tự host | Hiệu năng Rust, lọc payload, tier miễn phí tốt nhất |
| pgvector | IVF, HNSW | Tự host | Tích hợp PostgreSQL cho stack hiện có |
Đối với phần thảo luận phỏng vấn, điểm then chốt là hiểu thuật toán HNSW (Hierarchical Navigable Small World): nó xây dựng một đồ thị nhiều lớp trong đó mỗi nút kết nối với các láng giềng gần nhất, cho phép tìm kiếm O(log n) với cái giá là sử dụng bộ nhớ cao hơn.
Điểm hòa vốn chi phí là 60 đến 80 triệu truy vấn mỗi tháng. Trên mức này, Qdrant hoặc Weaviate tự host trên hạ tầng chi phí cố định liên tục rẻ hơn Pinecone Serverless từ 3x đến 10x.
Sẵn sàng chinh phục phỏng vấn Data Science & ML?
Luyện tập với mô phỏng tương tác, flashcards và bài kiểm tra kỹ thuật.
Truy Xuất Lai: Kết Hợp Tìm Kiếm Dày Đặc và Thưa
Tìm kiếm vector thuần túy thất bại với khớp từ khóa chính xác và các thuật ngữ hiếm. Tìm kiếm từ vựng thuần túy (BM25) bỏ lỡ độ tương đồng ngữ nghĩa. Truy xuất lai kết hợp cả hai, và năm 2026 đây là mặc định cho các hệ thống RAG sản xuất.
Mẫu hình tiêu chuẩn dùng Reciprocal Rank Fusion (RRF) để hợp nhất kết quả đã xếp hạng từ cả hai bộ truy xuất:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Truy xuất lai giải quyết vấn đề "không khớp từ vựng" khi người dùng hỏi về "hủy đăng ký" nhưng tài liệu liên quan dùng cụm "chính sách chấm dứt tài khoản". BM25 bắt được sự trùng lặp thuật ngữ chính xác trong khi tìm kiếm vector nắm bắt mối quan hệ ngữ nghĩa.
Reranking: Bộ Lọc Giai Đoạn Hai
Truy xuất trả về các ứng viên. Reranking sắp xếp chúng theo độ liên quan thực sự. Các bộ rerank kiểu cross-encoder như Cohere Rerank hay bge-reranker-v2.5-gemma2-lightweight chấm điểm từng cặp truy vấn-tài liệu cùng nhau, tạo ra điểm liên quan chính xác hơn nhiều so với độ tương đồng bi-encoder.
Pipeline truy xuất hai giai đoạn (recall giai đoạn đầu rộng với 50 đến 100 ứng viên qua vector + BM25, rồi rerank chính xác đến 5 đến 10 cho prompt) là chuẩn trong sản xuất. Cách này giữ độ trễ ở mức quản lý được: giai đoạn đầu dùng tìm kiếm ANN nhanh, còn cross-encoder tốn kém chỉ xử lý một tập ứng viên nhỏ.
Cross-encoder chính xác hơn bi-encoder vì chúng xử lý truy vấn và tài liệu cùng nhau qua tất cả các lớp transformer. Bi-encoder nhúng chúng độc lập, làm mất các tín hiệu tương tác tinh tế. Sự đánh đổi là tốc độ: cross-encoder không thể được lập chỉ mục trước.
Adaptive RAG: Định Tuyến Truy Vấn Đến Pipeline Phù Hợp
Không phải mọi truy vấn đều cần cùng mức độ phức tạp truy xuất. Adaptive RAG huấn luyện một bộ phân loại nhỏ để định tuyến mỗi câu hỏi đến đường đi tối ưu:
- Không truy xuất cho các truy vấn dữ kiện đơn giản mà mô hình đã biết
- Truy xuất một bước cho các truy vấn mức trung bình
- Truy xuất lặp nhiều bước cho suy luận phức tạp
Mẫu hình này cân bằng chi phí và độ chính xác qua các khối lượng công việc hỗn hợp. Một hệ thống sản xuất xử lý 100.000 truy vấn mỗi ngày có thể cắt giảm chi phí suy luận 40% bằng cách định tuyến các câu hỏi đơn giản ra khỏi các pipeline nhiều bước tốn kém.
Bản thân bộ phân loại có thể là một mô hình nhỏ được fine-tune hoặc một prompt zero-shot hỏi: "Câu hỏi này có cần tri thức bên ngoài để trả lời chính xác không?"
Speculative RAG: Đổi Độ Căn Cứ Lấy Tốc Độ
Speculative RAG chạy truy xuất song song với việc tạo bản nháp nhanh. Nếu bản nháp cho thấy độ tin cậy cao (đo bằng logprob), bước truy xuất được bỏ qua hoàn toàn. Nếu độ tin cậy thấp, ngữ cảnh được truy xuất sẽ hợp nhất với bản nháp và quá trình tạo lại diễn ra.
Cách tiếp cận này cắt giảm độ trễ trung bình 30 đến 40% trên các truy vấn có độ tin cậy cao. Nó phù hợp nhất cho chatbot thời gian thực, gợi ý autocomplete, và hệ thống dịch vụ khách hàng nơi thời gian phản hồi quan trọng hơn việc dẫn nguồn đầy đủ cho mỗi truy vấn.
Sự đánh đổi: speculative RAG đôi khi trả về câu trả lời không có căn cứ khi mô hình quá tự tin. Hệ thống sản xuất kết hợp nó với hiệu chỉnh độ tin cậy và dự phòng về truy xuất đầy đủ khi độ không chắc chắn vượt ngưỡng.
Agentic RAG: Vượt Ra Ngoài Truy Xuất Một Lần
RAG ngây thơ truy xuất một lần rồi sinh. Agentic RAG coi LLM như một tác nhân suy luận, quyết định khi nào truy xuất, truy xuất gì, và liệu ngữ cảnh truy xuất đã đủ hay chưa.
Năm 2026, agentic RAG là mẫu hình chủ đạo cho các truy vấn phức tạp đòi hỏi suy luận nhiều bước. Tác nhân có thể:
- Tự đánh giá: Xác định liệu tài liệu truy xuất có trả lời được câu hỏi
- Truy vấn lại: Diễn đạt lại truy vấn tìm kiếm nếu kết quả ban đầu chưa đủ
- Định tuyến (routing): Chọn giữa các nguồn tri thức khác nhau (vector DB, cơ sở dữ liệu SQL, API)
- Xác minh: Đối chiếu chéo sự kiện qua nhiều đoạn được truy xuất
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Mẫu hình này (truy xuất, chấm điểm, tùy chọn diễn đạt lại và thử lại) được gọi là Corrective RAG (CRAG). Cần lưu ý rằng AgentExecutor của LangChain đã bị deprecated kể từ 2026; các dự án mới nên sử dụng create_react_agent() cho các mẫu có sẵn hoặc StateGraph của LangGraph cho điều phối tùy chỉnh. Để tìm hiểu sâu hơn về các mẫu LangChain cho data scientist, xem bài viết chuyên đề.
Graph RAG: Truy Xuất Tri Thức Có Cấu Trúc
Graph RAG trích xuất các thực thể và mối quan hệ từ tài liệu vào một đồ thị tri thức, rồi truy vấn cả đồ thị lẫn kho vector. Kiến trúc này giảm ảo giác trên các truy vấn dữ kiện bằng cách neo câu trả lời vào các mối quan hệ thực thể tường minh thay vì độ tương đồng văn bản phi cấu trúc.
Pipeline nạp dữ liệu trích xuất các bộ ba (chủ thể, vị từ, đối tượng) từ mỗi đoạn tài liệu. Tại thời điểm truy vấn, hệ thống xác định các thực thể liên quan trong câu hỏi, duyệt đồ thị tri thức để tìm các sự kiện kết nối, và kết hợp ngữ cảnh truy xuất từ đồ thị với các đoạn truy xuất bằng vector.
Graph RAG xuất sắc với các câu hỏi suy luận nhiều bước (multi-hop) như "Đội nào dẫn dắt dự án sử dụng framework được nhắc đến trong tài liệu X?" Những truy vấn này đòi hỏi kết nối sự kiện qua nhiều tài liệu, điều mà tìm kiếm vector thuần túy gặp khó vì không một đoạn đơn lẻ nào chứa câu trả lời hoàn chỉnh.
Graph RAG cải thiện đáng kể độ chính xác dữ kiện (giảm tới 40% ảo giác trên các truy vấn nặng thực thể) nhưng đòi hỏi một pipeline trích xuất thực thể trưởng thành. Trích xuất nhiễu tạo ra đồ thị nhiễu, có thể làm kết quả tệ hơn cả RAG ngây thơ. Cần lưu ý rằng dự án GraphRAG của Microsoft đã chuyển sang chế độ bảo trì vào năm 2026; nó sẽ nhận các bản sửa lỗi nhưng không có tính năng mới.
Biến thể LazyGraphRAG của Microsoft (phát hành tháng 6 năm 2025) giảm chi phí lập chỉ mục đáng kể bằng cách trì hoãn việc tóm tắt cho đến thời điểm truy vấn, làm cho nó phù hợp với phân tích khám phá hoặc dữ liệu streaming nơi việc xây dựng đồ thị trước không thực tế.
Tuân Thủ EU AI Act Cho Hệ Thống RAG
EU AI Act bắt đầu có hiệu lực rộng rãi vào tháng 8 năm 2026. Án phạt cao cấp đầu tiên theo Đạo luật này đã đánh vào chatbot RAG của một tập đoàn ngân hàng châu Âu vào cuối tháng 5 năm 2026, và một công ty quản lý tài sản Frankfurt nhận mức phạt 4,5 triệu EUR vào tháng 4 năm 2026 cho một hệ thống RAG phục vụ khách hàng không giải thích được nguồn gốc dữ liệu.
Kiến trúc RAG tự nhiên đáp ứng một số yêu cầu tuân thủ: khả năng truy vết nguồn (các đoạn mang tham chiếu tài liệu), minh bạch câu trả lời (có thể hiển thị trích dẫn), và khả năng kiểm toán (log truy xuất tồn tại theo thiết kế). Tuy nhiên, tuân thủ đầy đủ đòi hỏi các biện pháp bổ sung:
Phân loại rủi ro: Chatbot công cộng thuộc rủi ro hạn chế (yêu cầu minh bạch). Hệ thống RAG y tế hoặc pháp lý là rủi ro cao với nghĩa vụ tài liệu và giám sát nghiêm ngặt hơn.
Ghi nhật ký kiểm toán: Ghi lại câu hỏi nào kích hoạt các đoạn nào được truy xuất và câu trả lời nào được tạo. Nhật ký này tạo cơ sở cho khả năng truy vết bắt buộc.
Giám sát con người: Hệ thống rủi ro cao đòi hỏi xác nhận của con người cho các trường hợp nhạy cảm, khả năng sửa đầu ra, và cơ chế xóa dữ liệu đã lập chỉ mục theo yêu cầu.
Nơi lưu trữ dữ liệu: Host việc lập chỉ mục tại EU và sử dụng BYOK (Bring Your Own Key) để đảm bảo dữ liệu không đi qua các tài khoản bên thứ ba ngoài khu vực pháp lý.
Vi phạm có thể tốn 7% doanh thu toàn cầu hàng năm. Đối với thảo luận phỏng vấn, điểm then chốt là khả năng trích dẫn vốn có của RAG là một lợi thế, nhưng nó không thay thế lớp quản trị.
Đánh Giá Hệ Thống RAG: Những Chỉ Số Quan Trọng
Đánh giá RAG chia thành các chỉ số truy xuất và các chỉ số sinh. Cả hai phải được đo độc lập để chẩn đoán lỗi.
Chỉ số truy xuất:
- Recall@k: Tài liệu liên quan có xuất hiện trong top k kết quả không?
- MRR (Mean Reciprocal Rank): Kết quả liên quan đầu tiên được xếp hạng cao đến đâu?
- NDCG: Thứ hạng có khớp với thứ tự liên quan lý tưởng không?
Chỉ số sinh:
- Faithfulness (độ trung thực): Câu trả lời có chỉ dùng thông tin từ ngữ cảnh truy xuất không? (Đo ảo giác)
- Độ liên quan của câu trả lời: Câu trả lời có giải quyết câu hỏi gốc không?
- Độ chính xác ngữ cảnh: Các đoạn truy xuất có thực sự được dùng trong câu trả lời không?
Các framework như Ragas và DeepEval tự động hóa các đánh giá này bằng mẫu hình LLM-làm-giám-khảo (LLM-as-judge). Các câu hỏi phỏng vấn data science hàng đầu ngày càng bao gồm thiết kế đánh giá RAG, vì vậy hãy chuẩn bị giải thích cách đo lường xem một hệ thống RAG có hoạt động đúng hay không.
Các Chế Độ Lỗi Trong Sản Xuất và Gỡ Lỗi
Hệ thống RAG thất bại theo những cách có thể dự đoán. Biết các mẫu hình này là thiết yếu cho cả phỏng vấn lẫn triển khai thực tế.
Ô nhiễm cửa sổ ngữ cảnh xảy ra khi quá nhiều đoạn truy xuất làm loãng tín hiệu liên quan. LLM nhận 10 đoạn nhưng chỉ 2 chứa thông tin hữu ích. Cách khắc phục: dùng bộ rerank để lọc, và giảm top-k từ bộ truy xuất.
Tạo phẩm chunking xảy ra khi việc chia kích thước cố định cắt câu, bảng, hay khối mã ở giữa phần tử. Đoạn được truy xuất không hoàn chỉnh về cú pháp và vô dụng về ngữ nghĩa. Chunking ngữ nghĩa hay chia có nhận biết tài liệu (tôn trọng tiêu đề, đoạn văn, code fence) giải quyết điều này.
Trôi dạt embedding (embedding drift) xuất hiện khi mô hình embedding được cập nhật nhưng kho vector vẫn chứa các nhúng từ mô hình cũ. Các truy vấn được mã hóa bằng mô hình mới tìm kiếm trong một không gian vector do mô hình cũ xây dựng, làm giảm chất lượng truy xuất. Giải pháp: nhúng lại toàn bộ kho ngữ liệu sau mỗi lần đổi mô hình.
Chỉ mục lỗi thời cung cấp thông tin cũ vì pipeline nạp dữ liệu tụt lại sau các cập nhật tài liệu. Trong các hệ thống machine learning, điều này tương tự lệch huấn luyện-phục vụ (training-serving skew), nơi hệ thống truy xuất thấy một phân bố dữ liệu khác với cái tồn tại trong sản xuất.
Nguồn Tham Khảo
- Turing Post: 20 Advanced RAG Types to Know in 2026 - phân loại toàn diện các mẫu RAG
- LangChain and LangGraph 1.0 Milestones - deprecation AgentExecutor, các mẫu mới
- Microsoft GraphRAG GitHub - trạng thái chế độ bảo trì
- IgnitionRAG EU AI Act Guide - yêu cầu tuân thủ cho hệ thống RAG
- MarkTechPost: Best Vector Databases in 2026 - hợp nhất thị trường và giá cả
Bắt đầu luyện tập!
Kiểm tra kiến thức với mô phỏng phỏng vấn và bài kiểm tra kỹ thuật.
Điểm Then Chốt Về RAG Cho Phỏng Vấn Data Science
- RAG kết hợp truy xuất (tìm kiếm vector trên cơ sở tri thức) với sinh LLM để tạo ra câu trả lời có cơ sở dữ kiện mà không cần huấn luyện lại mô hình
- Chiến lược chunking có tác động lớn nhất đến chất lượng truy xuất; chunking ngữ nghĩa và late chunking vượt trội hơn chia kích thước cố định trong hầu hết trường hợp sử dụng
- Truy xuất lai (vector dày đặc + BM25 thưa) với Reciprocal Rank Fusion là mặc định sản xuất, giải quyết vấn đề không khớp từ vựng mà tìm kiếm vector thuần túy không xử lý được
- Bộ rerank cross-encoder thêm một lớp chính xác sau truy xuất rộng, chỉ xử lý một tập ứng viên nhỏ để giữ độ trễ ở mức chấp nhận được
- Adaptive RAG định tuyến truy vấn đến độ phức tạp pipeline phù hợp, cắt giảm chi phí 40% trên các khối lượng công việc hỗn hợp
- Speculative RAG đổi độ căn cứ lấy tốc độ, cắt giảm độ trễ 30 đến 40% trên các truy vấn có độ tin cậy cao
- Agentic RAG (truy xuất, chấm điểm, diễn đạt lại, thử lại) và Graph RAG (trích xuất quan hệ thực thể) xử lý các truy vấn multi-hop phức tạp mà RAG ngây thơ thất bại
- Tuân thủ EU AI Act (tháng 8 năm 2026) đòi hỏi ghi nhật ký kiểm toán, giám sát con người, và phân loại rủi ro cho các hệ thống RAG sản xuất
- Đánh giá phải tách biệt chỉ số truy xuất (Recall@k, MRR) khỏi chỉ số sinh (faithfulness, độ liên quan câu trả lời) để chẩn đoán nơi pipeline gãy
- Các lỗi sản xuất phổ biến nhất (ô nhiễm ngữ cảnh, tạo phẩm chunking, trôi dạt embedding, chỉ mục lỗi thời) đều có cách khắc phục đơn giản một khi đã xác định
Bạn có tìm ra lỗi trong Data Science & ML không?
Một đoạn mã thật, một lỗi ẩn, mỗi ngày một lượt. Không cần tài khoản để thử.

Viết bởi
Anthony Fillion-MailletNgười sáng lập SharpSkill
Lập trình viên fullstack hơn 10 năm. Anh điều hành SharpSkill và chịu trách nhiệm về mọi nội dung đăng tại đây.
Cập nhật ngày 24 tháng 8, 2026
Thẻ
Chia sẻ
Bài viết liên quan
Feature Engineering cho Machine Learning: Kỹ thuật và Câu hỏi Phỏng vấn 2026
Nắm vững các kỹ thuật feature engineering cho machine learning với các ví dụ Python thực tế. Bao gồm encoding, scaling, chọn lọc đặc trưng, pipeline scikit-learn và các câu hỏi phỏng vấn data science.
Việc làm Freelance Data Scientist 2026: Nơi tìm hợp đồng, mức giá theo ngày và cách chuẩn bị
Hướng dẫn toàn diện cho các data scientist muốn làm việc tự do năm 2026: nền tảng tìm hợp đồng, mức giá theo ngày trung bình và chiến lược chuẩn bị phỏng vấn kỹ thuật.
Việc làm Data Scientist 2026: Nơi tìm kiếm, mức lương và cách chuẩn bị
Việc làm data scientist vẫn là một trong những vị trí kỹ thuật được săn đón nhất năm 2026. Bài viết này hướng dẫn nơi tìm việc, mức lương hiện tại và cách chuẩn bị phỏng vấn hiệu quả.