ETL vs ELT 2026: Kiến Trúc Data Pipeline và Câu Hỏi Phỏng Vấn
Tìm hiểu sự khác biệt giữa ETL và ELT, kiến trúc data pipeline hiện đại, cùng các câu hỏi phỏng vấn data engineering thường gặp năm 2026.
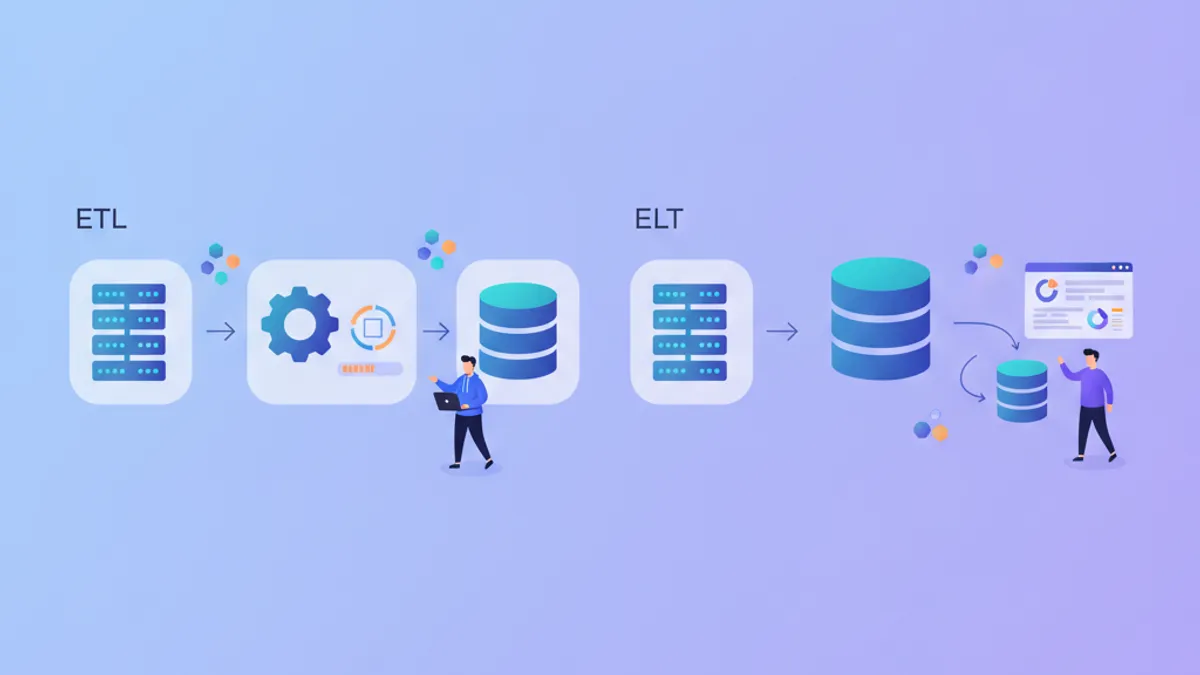
ETL và ELT là hai phương pháp cơ bản để di chuyển dữ liệu từ hệ thống nguồn đến môi trường phân tích. Việc lựa chọn giữa extract-transform-load (ETL) và extract-load-transform (ELT) ảnh hưởng đến chi phí hạ tầng, độ tươi mới của dữ liệu, và kỹ năng cần thiết từ đội ngũ kỹ sư. Hiểu sâu về cả hai kiến trúc này là điều quan trọng đối với data engineer làm việc với data pipeline hiện đại.
ETL biến đổi dữ liệu trước khi tải vào hệ thống đích, đòi hỏi tài nguyên tính toán riêng biệt. ELT tải dữ liệu thô trước, sau đó biến đổi bằng sức mạnh xử lý của warehouse đích. Hầu hết các data stack cloud-native trong năm 2026 ưu tiên ELT vì khả năng tính toán có thể mở rộng theo nhu cầu.
Kiến Trúc ETL: Biến Đổi Trước Khi Tải
ETL xuất hiện khi data warehouse có dung lượng tính toán hạn chế và lưu trữ đắt đỏ. Mô hình này hợp lý vào thời điểm đó: lọc và tổng hợp dữ liệu bên ngoài warehouse, chỉ tải những gì cần thiết cho phân tích. Oracle Warehouse Builder, Informatica PowerCenter, và Talend đã xây dựng công cụ xung quanh mô hình này.
Giai đoạn biến đổi trong ETL chạy trên các server trung gian. Dữ liệu di chuyển từ nguồn đến khu vực staging, được làm sạch và tái cấu trúc, sau đó tải đến đích. Phương pháp này giảm tải cho warehouse nhưng tạo ra bottleneck ở tầng biến đổi.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL hoạt động tốt khi logic biến đổi ổn định và khối lượng dữ liệu có thể dự đoán được. Nhược điểm xuất hiện khi yêu cầu thay đổi: việc sửa đổi biến đổi đồng nghĩa với việc xử lý lại dữ liệu lịch sử từ đầu.
Kiến Trúc ELT: Tải Trước, Biến Đổi Trong Warehouse
ELT chuyển biến đổi vào bên trong data warehouse. Snowflake, BigQuery, Databricks, và Redshift cung cấp khả năng tính toán gần như không giới hạn, có thể mở rộng theo độ phức tạp của query. Tải dữ liệu thô trước giữ nguyên trạng thái nguồn; biến đổi trở thành các model SQL có thể được version và chạy lại mà không cần trích xuất lại.
Dự án dbt (data build tool) đã phổ biến ELT bằng cách xử lý biến đổi SQL như code. Thay vì các job ETL black-box, biến đổi tồn tại trong version control dưới dạng câu lệnh SELECT tham chiếu đến bảng thô và xây dựng các model dẫn xuất.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT bảo tồn dữ liệu thô, cho phép xử lý lại khi logic kinh doanh thay đổi. Nếu một phép tính sai sáu tháng trước, việc sửa model dbt và chạy full refresh sẽ sửa dữ liệu lịch sử. Với ETL, việc sửa tương tự đòi hỏi trích xuất lại từ nguồn mà có thể không còn giữ các bản ghi gốc.
Bảng So Sánh: Đánh Đổi ETL vs ELT
| Yếu Tố | ETL | ELT |
|---|---|---|
| Vị trí tính toán | Server biến đổi riêng | Warehouse đích |
| Giữ lại dữ liệu thô | Thường bị loại bỏ sau biến đổi | Được bảo tồn trong landing zone |
| Chi phí xử lý lại | Trích xuất lại từ nguồn | Chạy lại model SQL |
| Linh hoạt schema | Cố định tại thời điểm biến đổi | Schema-on-read có thể |
| Ví dụ tooling | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Phù hợp cho | Yêu cầu ổn định, hệ thống legacy | Yêu cầu thay đổi, cloud warehouse |
| Độ trễ | Cao hơn (biến đổi trước khi tải) | Thấp hơn (tải rồi biến đổi) |
| Data governance | Dễ hơn (dữ liệu được lọc trước warehouse) | Cần kiểm soát cấp warehouse |
Sẵn sàng chinh phục phỏng vấn Data Engineering?
Luyện tập với mô phỏng tương tác, flashcards và bài kiểm tra kỹ thuật.
Phương Pháp Hybrid: Khi ETL và ELT Kết Hợp
Data stack hiện đại hiếm khi sử dụng ETL hoặc ELT thuần túy. Apache Airflow điều phối các pipeline kết hợp cả hai mô hình. Dữ liệu nhạy cảm có thể được ẩn danh trước khi tải (bước ETL), trong khi tổng hợp chạy trong warehouse (ELT).
Fivetran và Airbyte trích xuất và tải dữ liệu thô không biến đổi, sau đó dbt biến đổi bên trong warehouse. Nhưng các công cụ này cũng hỗ trợ biến đổi nhẹ trong quá trình trích xuất: chọn cột, ép kiểu dữ liệu, hash các trường PII. Điều này làm mờ ranh giới ETL/ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Pipeline trên trích xuất từ Salesforce với Airbyte (có thể hash địa chỉ email trong quá trình đồng bộ), tải vào Snowflake, sau đó chạy model dbt cho biến đổi kinh doanh. Không phải ETL thuần túy hay ELT thuần túy, nhưng thực tiễn.
Câu Hỏi Phỏng Vấn: ETL vs ELT cho Data Engineer
Phỏng vấn kỹ thuật cho vị trí data engineering tại các công ty sử dụng data stack hiện đại kiểm tra hiểu biết về kiến trúc pipeline. Các câu hỏi này thường xuất hiện, dựa trên các mẫu từ module chuẩn bị phỏng vấn ETL/ELT.
Câu Hỏi 1: Khi Nào Chọn ETL Thay Vì ELT?
Câu trả lời mạnh xác định các kịch bản cụ thể:
- Yêu cầu tuân thủ: GDPR hoặc HIPAA yêu cầu một số dữ liệu nhất định không bao giờ đến warehouse ở dạng thô. PII phải được ẩn danh hoặc loại bỏ trước khi tải.
- Hạn chế warehouse legacy: Hệ thống on-premises như Teradata hoặc cấu hình Redshift cũ với compute cố định được hưởng lợi từ việc tải đã được tổng hợp trước.
- Chi phí mạng: Tải 10TB hàng ngày vào cloud warehouse, sau đó loại bỏ 90% sau biến đổi, lãng phí băng thông egress. Pre-filtering kinh tế hơn.
Câu trả lời yếu nói "ETL đã lỗi thời" hoặc không đưa ra kịch bản cụ thể. Người phỏng vấn tìm kiếm sự tinh tế.
Câu Hỏi 2: Xử Lý Thay Đổi Schema Trong Pipeline ELT Như Thế Nào?
Câu hỏi này kiểm tra hiểu biết về raw data landing zone. Các chủ đề được mong đợi:
- Cột JSON hoặc semi-structured hấp thụ các trường mới mà không cần migration schema
- Model staging chọn cột một cách rõ ràng, cách ly model downstream khỏi thay đổi nguồn
- Macro dbt hoặc assertion Dataform làm fail build khi cột được mong đợi biến mất
- Monitoring cho schema drift sử dụng công cụ như Monte Carlo hoặc Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Câu Hỏi 3: So Sánh Điều Phối ETL với Airflow vs Chạy dbt cho ELT
Câu hỏi này kiểm tra hiểu biết rằng các công cụ này giải quyết vấn đề khác nhau:
- Airflow điều phối task: trích xuất, gọi API, chuyển file, training model. Nó quản lý dependency giữa các job không đồng nhất.
- dbt biến đổi dữ liệu bên trong warehouse. Nó quản lý dependency giữa các model SQL, chạy test, tạo documentation.
Pipeline hoàn chỉnh thường sử dụng cả hai: Airflow trigger đồng bộ Airbyte, chờ hoàn thành, sau đó trigger dbt run. Biết khi nào sử dụng công cụ nào phân biệt ứng viên senior.
Câu Hỏi 4: Pipeline ELT Xử Lý 500M Hàng Mỗi Ngày và Analyst Báo Cáo Query Chậm
Câu hỏi mở này kiểm tra tư duy chẩn đoán:
- Kiểm tra materialization model: Model nặng vẫn còn là view? Model incremental hoặc table có thể giúp ích.
- Partition và cluster: Với BigQuery, bảng fact có được partition theo ngày không? Với Snowflake, clustering có được tối ưu cho pattern query phổ biến không?
- Query pushdown: Analyst có đang query model staging thay vì mart đã được tổng hợp không?
- Kích thước warehouse: Compute có được scale phù hợp trong giờ query không?
- Yêu cầu freshness: Biến đổi có thể chạy vào ban đêm thay vì trong giờ làm việc không?
Không có một câu trả lời đúng duy nhất. Người phỏng vấn đánh giá troubleshooting có hệ thống.
Bối Cảnh Tooling Năm 2026
Thị trường tích hợp dữ liệu đã hợp nhất xung quanh một vài pattern:
Trích xuất và tải: Fivetran, Airbyte, Stitch, và Meltano xử lý phần EL. Các công cụ này kết nối với hàng trăm nguồn và đồng bộ vào cloud warehouse mà không cần code tùy chỉnh.
Biến đổi: dbt thống trị biến đổi dựa trên SQL. Các lựa chọn thay thế bao gồm Dataform (hiện là một phần của Google Cloud), SQLMesh (open source với virtual data environment), và Coalesce (visual modeling).
Điều phối: Airflow vẫn là mặc định cho pipeline phức tạp. Dagster và Prefect cung cấp các lựa chọn thay thế với phát triển local tốt hơn và view asset-centric.
Chất lượng: Great Expectations, dbt test, Monte Carlo, và Soda cung cấp monitoring chất lượng dữ liệu. Các công cụ này bắt vấn đề giữa trích xuất và tiêu thụ downstream.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Bắt đầu luyện tập!
Kiểm tra kiến thức với mô phỏng phỏng vấn và bài kiểm tra kỹ thuật.
Chọn Kiến Trúc Pipeline cho Dự Án Mới
Đối với hầu hết dự án greenfield năm 2026, ELT là mặc định. Chi phí compute cloud warehouse rẻ hơn so với duy trì server biến đổi. Bảo tồn dữ liệu thô cho phép sửa chữa hồi tố. Biến đổi dựa trên SQL có thể kiểm toán và kiểm soát phiên bản.
ETL vẫn phù hợp cho:
- Môi trường quy định yêu cầu tối thiểu hóa dữ liệu trước khi vào warehouse
- Streaming real-time nơi biến đổi phải xảy ra tại thời điểm ingestion (Kafka Streams, Flink)
- Kịch bản edge computing với lưu trữ downstream hạn chế
- Tích hợp legacy nơi hệ thống nguồn kiểm soát format export
Câu trả lời sẵn sàng phỏng vấn thừa nhận cả hai pattern và giải thích đánh đổi mà không có sở thích ý thức hệ.
Kết Luận: Kiến Trúc Data Pipeline
- ETL biến đổi dữ liệu trước khi tải, giảm tải warehouse nhưng tạo ma sát xử lý lại khi logic thay đổi
- ELT tải dữ liệu thô trước, cho phép biến đổi dựa trên SQL có thể version, test, và chạy lại với dữ liệu lịch sử
- Stack hiện đại thường kết hợp cả hai: biến đổi trích xuất nhẹ (hash PII, ép kiểu) với tổng hợp dựa trên warehouse
- dbt đã trở thành tiêu chuẩn cho biến đổi ELT, xử lý model SQL như code có thể test và document
- Câu hỏi phỏng vấn kiểm tra lựa chọn kịch bản, xử lý evolution schema, và đánh đổi tooling thay vì định nghĩa học thuộc
- Bảo tồn dữ liệu thô trong pipeline ELT cho phép sửa chữa tính toán lịch sử mà không cần trích xuất lại từ nguồn
Bạn có tìm ra lỗi trong Data Engineering không?
Một đoạn mã thật, một lỗi ẩn, mỗi ngày một lượt. Không cần tài khoản để thử.

Viết bởi
Anthony Fillion-MailletNgười sáng lập SharpSkill
Lập trình viên fullstack hơn 10 năm. Anh điều hành SharpSkill và chịu trách nhiệm về mọi nội dung đăng tại đây.
Cập nhật ngày 14 tháng 9, 2026
Chia sẻ
Bài viết liên quan
Great Expectations 2026: Kiểm Tra Chất Lượng Dữ Liệu và Câu Hỏi Phỏng Vấn
Hướng dẫn toàn diện về framework Great Expectations 1.22 để kiểm tra chất lượng dữ liệu trong pipeline Python, bao gồm tích hợp Airflow và câu hỏi phỏng vấn data engineering.

Apache Beam vs Spark 2026: So Sánh Pipeline Hợp Nhất và Câu Hỏi Phỏng Vấn
Hướng dẫn toàn diện so sánh Apache Beam 2.76 và Spark 4.2 cho data engineering. Tìm hiểu sự khác biệt về kiến trúc, windowing, hiệu suất và các câu hỏi phỏng vấn thường gặp.

Apache Flink 2026: Xu ly Stream, Event Time va Cau hoi Phong van
Huong dan Apache Flink 2.3 cho xu ly stream voi event time semantics, watermark va windowing. Bao gom cau hoi phong van va vi du code production.