Zasady SRE w 2026: inżynieria niezawodności, SLO i pytania rekrutacyjne
Zasady SRE w 2026 roku: jak dobierać SLI, wyznaczać SLO, obliczać budżet błędów, pisać w Prometheusie alerty burn rate z wieloma oknami i odpowiadać na pytania rekrutacyjne SRE, które padają w każdym procesie.
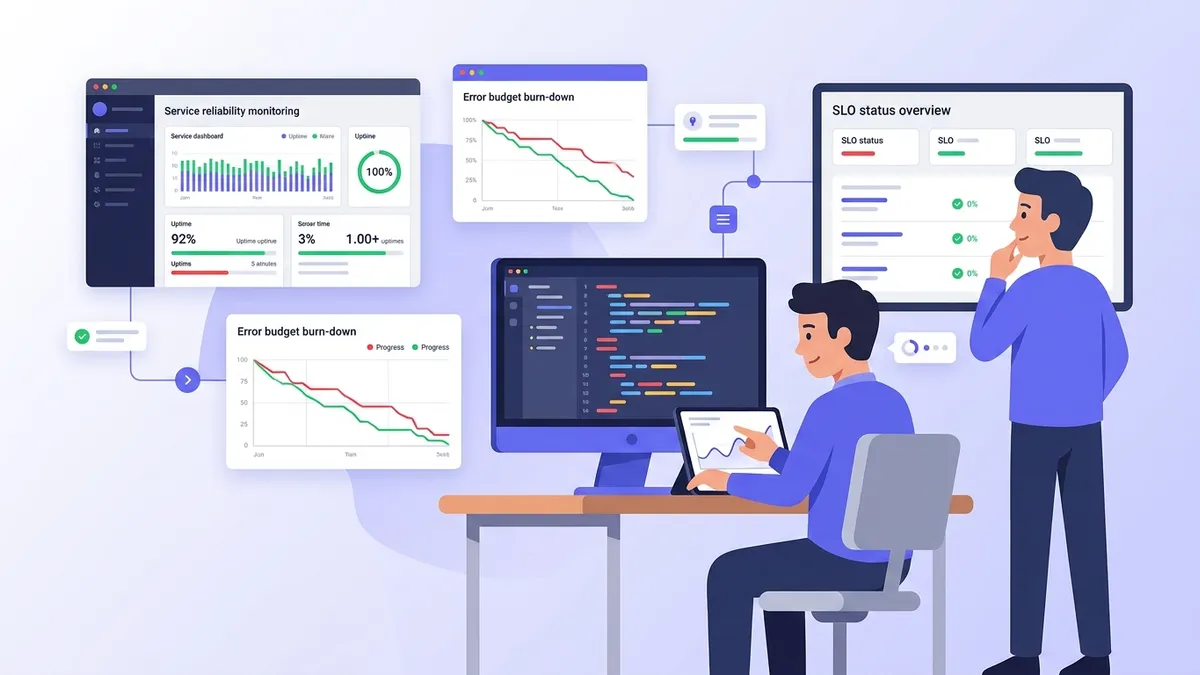
Zasady SRE zamieniają niezawodność z ogólnikowego hasła w konkretną liczbę, którą zespół inżynierski i produktowy akceptują wspólnie. Ta liczba decyduje potem, kiedy wolno wdrażać nowe funkcje, a kiedy trzeba się zatrzymać. Site reliability engineering, w formie opisanej przez Google i stosowanej dziś w większości zespołów platformowych, opiera się na kilku filarach: mierzyć to, czego doświadcza użytkownik (SLI), wyznaczać cel poniżej 100% (SLO), traktować różnicę jako budżet błędów (error budget) i ograniczać ręczną pracę operacyjną. Pytania rekrutacyjne na stanowiska SRE w 2026 roku sprawdzają właśnie te zagadnienia, najczęściej przez polecenie zdefiniowania SLO dla prawdziwej usługi i napisania alertu, który go chroni.
SLI to pomiar: stosunek zdarzeń poprawnych do wszystkich zdarzeń branych pod uwagę, na przykład udanych żądań do wszystkich żądań. SLO to wewnętrzny cel dla tego stosunku w określonym oknie czasowym, na przykład 99,9% w ciągu 30 dni. SLA to umowne zobowiązanie wobec klienta, obwarowane karami, i zawsze jest łagodniejsze niż SLO.
Fundamenty site reliability engineering
Książka Google o SRE przedstawia niezawodność jako funkcję produktu, która ma swoją cenę. Każda kolejna „dziewiątka” kosztuje więcej czasu inżynierów i spowalnia wydania, a użytkownicy rzadko zauważają różnicę między 99,99% a 99,999%, ponieważ ich własna sieć, urządzenie i dostawca internetu są mniej niezawodne. Celem jest właściwy poziom niezawodności, a nie poziom maksymalny.
Z tego założenia wynika kilka zasad:
- Niezawodność mierzy się od strony użytkownika. Zużycie CPU i restarty podów to przyczyny. Nieudane płatności i wolno ładujące się strony to skutki odczuwane przez użytkownika i właśnie je rejestruje SLI.
- 100% to zły cel. SLO na poziomie 100% zabrania jakiejkolwiek zmiany, bo każde wdrożenie niesie ryzyko. Luka poniżej 100% to budżet błędów, przeznaczony do wydawania na releasy, eksperymenty i migracje.
- Toil ma górny limit. Wytyczna Google z rozdziału o eliminowaniu toilu utrzymuje pracę operacyjną poniżej 50% czasu inżyniera SRE. Toil to praca ręczna, powtarzalna, możliwa do zautomatyzowania i rosnąca liniowo wraz z usługą. Pozostały czas trafia na inżynierię, która ten toil usuwa.
- Postmortemy są bez szukania winnych. Analiza incydentu pyta, co w systemie dopuściło do awarii, a nie kto wpisał polecenie. Obwiniany inżynier ukrywa informacje, a analiza bez obwiniania je ujawnia.
- Monitoring alarmuje na podstawie objawów. Powiadomienie (page) trafia do dyżurnego, gdy użytkownicy cierpią albo zaraz zaczną, a nie wtedy, gdy pojedynczy węzeł wygląda nietypowo.
Na rozmowie kwalifikacyjnej doświadczonego SRE od osoby, która jedynie przeczytała książkę, odróżnia zwykle punkt drugi. Odpowiedź juniora traktuje budżet błędów jako tolerancję na awarie. Odpowiedź seniora traktuje go jako narzędzie zarządzania wydaniami: mechanizm, dzięki któremu produkt i zespół niezawodności spierają się na podstawie danych, a nie opinii.
Dobór SLI odzwierciedlających doświadczenie użytkownika
Dobre SLI to stosunek z przedziału od 0 do 1, wyliczany ze zdarzeń, które użytkownik by rozpoznał. SRE Workbook proponuje krótką listę zależną od rodzaju usługi:
| Rodzaj usługi | Typowe SLI | Gdzie mierzyć |
|---|---|---|
| API obsługujące żądania | Dostępność, opóźnienie | Logi load balancera lub ingressu, metryki serwera |
| Potok danych | Świeżość, poprawność, pokrycie | Znaczniki czasu wyników potoku, zadania walidacyjne |
| System składowania | Trwałość, opóźnienie odczytu i zapisu | Warstwa storage, sondy syntetyczne |
| Frontend | Czas ładowania strony, błędy widziane przez przeglądarkę | Real user monitoring |
Pomiar na load balancerze wychwytuje awarie, których aplikacja w ogóle nie widzi, na przykład pod, który padł i nic nie zwraca. Pomiar w przeglądarce wyłapuje problemy z CDN i DNS, ale dodaje szum ze słabych połączeń mobilnych. Większość zespołów zaczyna od load balancera lub ingressu, ponieważ dane są tam już dostępne.
W Prometheusie dwa klasyczne SLI dla usługi HTTP to wskaźnik dostępności i wskaźnik opóźnienia. SLI opóźnienia uznaje za poprawne żądania szybsze od ustalonego progu, dzięki czemu jest stosunkiem, tak jak pozostałe, a nie percentylem.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Na rozmowach powracają dwa szczegóły. Po pierwsze, odpowiedzi 4xx zwykle liczą się jako zdarzenia ważne, ale poprawne, bo błąd 404 lub błąd walidacji wynika z pomyłki klienta. Liczenie ich jako awarii pozwala źle działającemu klientowi przepalić cały budżet. Po drugie, próg opóźnienia musi pokrywać się z granicą kubełka histogramu, w przeciwnym razie zapytanie nic nie zwróci albo po cichu użyje niewłaściwego kubełka. Prometheus 3.16, wydany 5 listopada 2026 roku, obsługuje histogramy natywne, które znoszą ograniczenie stałych kubełków, ale trzeba je włączyć po stronie scrapowania.
Wyznaczanie celów SLO i obliczanie budżetu błędów
SLO łączy w sobie SLI, cel i okno czasowe. Okno jest zwykle kroczące, 28 lub 30 dni, więc budżet odnawia się stopniowo, zamiast zerować się pierwszego dnia miesiąca. Cel wybiera się na podstawie historycznych wyników i oczekiwań użytkowników, a nie tego, co dobrze wygląda na slajdzie.
Poniższa tabela pokazuje, na co pozwala każdy cel w 30-dniowym oknie. To zwykła arytmetyka: budżet wynosi (1 - SLO) × 30 dni.
| Cel SLO | Budżet błędów | Dopuszczalny całkowity przestój w 30 dni |
|---|---|---|
| 99% | 1% | 7 h 12 min |
| 99,5% | 0,5% | 3 h 36 min |
| 99,9% | 0,1% | 43 min 12 s |
| 99,95% | 0,05% | 21 min 36 s |
| 99,99% | 0,01% | 4 min 19 s |
W przypadku SLO opartych na żądaniach budżet wyraża się liczbą żądań, a nie minutami: przy 99,9% i 12 milionach żądań w oknie dopuszczalnych jest 12 000 nieudanych żądań. Budżety liczone w żądaniach są sprawiedliwsze dla usług o nierównym ruchu, ponieważ awaria o trzeciej w nocy zużywa mniej budżetu niż taka sama awaria w szczycie.
Częste zadanie rekrutacyjne polega na obliczeniu pozostałego budżetu i tempa jego zużycia. Poniższy skrypt to odpowiedź, jakiej oczekuje się, gdy pytanie wymaga kodu.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Burn rate równy 15 oznacza, że usługa zawodzi przy 1,5% żądań, podczas gdy SLO dopuszcza 0,1%. W tym tempie pozostałe 35% budżetu zniknie w niecałe 17 godzin, co uzasadnia obudzenie dyżurnego.
Gotowy na rozmowy o DevOps?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Alerty burn rate z wieloma oknami czasowymi
Alarmowanie bezpośrednio na podstawie SLI („odsetek błędów powyżej 0,1%”) generuje powiadomienia przy każdym krótkim skoku i przeoczy powolne wycieki. Rozdział SRE Workbook o alertach opartych na SLO zaleca zamiast tego alerty z wieloma oknami i wieloma progami burn rate. Każdy alert odpowiada na jedno pytanie: czy budżet znika na tyle szybko, że wyczerpie się, zanim ktokolwiek na niego spojrzy?
Wartości referencyjne dla okna 30-dniowego:
| Ważność | Okno długie | Okno krótkie | Burn rate | Zużyty budżet w chwili alertu |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2% |
| Page | 6 h | 30 min | 6 | 5% |
| Ticket | 3 dni | 6 h | 1 | 10% |
Okno długie zapewnia istotność statystyczną: jedna zła minuta nie budzi dyżurnego. Okno krótkie, stanowiące jedną dwunastą długiego, sprawia, że alert szybko gaśnie po zakończeniu incydentu i nie wisi jeszcze przez godzinę po naprawie. Oba warunki muszą być spełnione jednocześnie.
Pierwszy blok zapisuje wskaźnik błędów dla każdego okna jako recording rule, aby wyrażenia alertów pozostały tanie. Drugi blok definiuje dwa alerty typu page dla SLO 99,9%, w którym budżet wynosi 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageRęczne pisanie tych reguł dla każdej usługi szybko staje się monotonne. Sloth, otwartoźródłowy generator SLO, przyjmuje krótką specyfikację i tworzy z niej powyższe recording rules oraz alerty z wieloma progami burn rate. Symbol zastępczy {{.window}} jest podmieniany na każde okno, którego Sloth potrzebuje.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Zespoły szukające formatu niezależnego od dostawcy sięgają po specyfikację OpenSLO, która opisuje SLO w YAML-u bez wiązania się z konkretnym backendem monitoringu.
Polityka budżetu błędów a decyzje o wydaniach
Budżet błędów bez polityki to dashboard, na który nikt nie reaguje. Przykładowa polityka budżetu błędów z SRE Workbook precyzuje, co się dzieje po wyczerpaniu budżetu i kto zatwierdził te zasady z wyprzedzeniem.
Typowa polityka zawiera:
- Wyzwalacz. Usługa przekroczyła budżet błędów w kroczącym oknie.
- Konsekwencję. Wydania nowych funkcji zostają wstrzymane, z wyjątkiem poprawek bezpieczeństwa i zmian poprawiających niezawodność, dopóki usługa nie wróci w granice SLO.
- Ścieżkę wyjątków. Pojedynczy incydent spowodowany przez zależność poza kontrolą zespołu może zostać wyłączony z rozliczenia, a decyzja jest dokumentowana.
- Eskalację. Spory trafiają do wskazanej roli, na przykład CTO, a nie do osoby, która najgłośniej argumentuje.
Polityka jest podpisywana przez produkt i inżynierię przed pierwszym przekroczeniem i w tym tkwi cały sens: zamrożenie wydań staje się wcześniej uzgodnioną regułą, a nie kłótnią w trakcie incydentu. Rekruterzy często pytają, co się dzieje, gdy budżet konsekwentnie pozostaje nietknięty. Oczekiwana odpowiedź: SLO może być zbyt luźne albo zespół wdraża zbyt ostrożnie, a budżet należy wykorzystać na szybsze wydania lub bardziej ryzykowne migracje.
Ustawienie wewnętrznego SLO na poziomie SLA wobec klienta nie zostawia marginesu: pierwsze naruszenie SLO od razu oznacza karę umowną. SLO powinno być bardziej rygorystyczne niż SLA, aby alerty zadziałały, a zamrożenie wydań ruszyło, zanim umowa zostanie złamana.
Redukcja toilu, dyżury i postmortemy bez obwiniania
Czas zespołu SRE dzieli się między operacje i inżynierię. Operacje obejmują dyżury on-call, zgłoszenia i ręczne interwencje. Inżynieria obejmuje automatyzację, planowanie pojemności i funkcje zwiększające niezawodność. Gdy toil przekracza wytyczne 50%, zespół SRE oddaje część pracy zespołowi deweloperskiemu albo inwestuje w automatyzację. W przeciwnym razie staje się zespołem operacyjnym z nową nazwą.
Kondycję dyżurów się mierzy, a nie zakłada. Przydatne sygnały to liczba powiadomień na zmianę, odsetek powiadomień wymagających działania i czas potwierdzenia. Powiadomienie, które nie wymaga żadnej akcji, jest błędem w alertingu i trzeba je poprawić lub usunąć. Alerty oparte na objawach i burn rate SLO, jak w regułach powyżej, znacząco zmniejszają liczbę powiadomień w porównaniu z alertami na CPU, pamięć czy restarty pojedynczych podów.
Po incydencie następuje analiza opisana w rozdziale o kulturze postmortemów książki SRE. Postmortem dokumentuje wpływ w kategoriach SLO (ile budżetu zużyto), oś czasu, czynniki sprzyjające awarii oraz działania naprawcze z właścicielami i terminami. Nie wskazuje konkretnej osoby jako przyczyny. Na rozmowach często padają dwa pytania uzupełniające. Pierwsze: jak dopilnować, by działania naprawcze faktycznie zostały wykonane (śledzić je w tym samym backlogu co funkcje i przeglądać na cyklicznym spotkaniu). Drugie: kiedy postmortem jest obowiązkowy (każdy incydent, który zużył znaczną część budżetu, każde powiadomienie, które kogoś obudziło, każda utrata danych).
Cztery złote sygnały z książki SRE, czyli opóźnienie, ruch, błędy i nasycenie, dopełniają obraz monitoringu. Opóźnienie i błędy zazwyczaj stają się SLI. Ruch i nasycenie zasilają planowanie pojemności i dashboardy, a nie powiadomienia dla dyżurnych.
Pytania rekrutacyjne SRE i oczekiwane odpowiedzi
Poniższe pytania regularnie wracają w procesach rekrutacyjnych na stanowiska SRE i senior DevOps, wraz z sednem mocnej odpowiedzi. Moduł pytań rekrutacyjnych o zasadach SRE ćwiczy te same tematy, a moduł o alertingu i reagowaniu na incydenty obejmuje stronę dyżurów.
P: Czym różnią się SLI, SLO i SLA?
SLI to mierzony stosunek, SLO to wewnętrzny cel dla niego w danym oknie, SLA to zewnętrzna umowa z karami. SLO jest bardziej rygorystyczne niż SLA, aby zespół zareagował, zanim firma straci pieniądze.
P: Dlaczego nie ustawić SLO na 100%?
Ponieważ każda zmiana niesie ryzyko, więc cel 100% zabrania wydań. Użytkownicy nie są też w stanie dostrzec niezawodności wyższej niż ta, którą zapewnia ich własna sieć. Luka poniżej 100% to budżet błędów, który finansuje wydania.
P: Proszę zdefiniować SLO dla API obsługującego płatności.
Mocna odpowiedź wybiera dwa SLI (dostępność z wyłączeniem 4xx oraz opóźnienie poniżej progu, mierzone na load balancerze), kroczące okno 30 dni, cele oparte na danych z ostatniego kwartału, i wyjaśnia, jak wynikają z nich alerty i polityka budżetu błędów. Podanie wyłącznie „99,99% uptime” bez określenia, co jest mierzone, to klasyczna słaba odpowiedź.
P: Dlaczego alerty oparte na percentylu p99 opóźnienia są słabym alertem SLO?
Percentyl p99 w krótkim oknie jest zaszumiony i nie da się go agregować między instancjami. Przekształcenie opóźnienia w stosunek żądań poniżej progu czyni je addytywnym, porównywalnym z SLI dostępności i zgodnym z alertami burn rate.
P: Czym jest burn rate i dlaczego alerty używają dwóch okien?
Burn rate to zaobserwowany odsetek błędów podzielony przez ułamek budżetu. Wartość 1 oznacza, że budżet wystarczy dokładnie na całe okno. Okno długie odfiltrowuje krótkie skoki, okno krótkie pozwala alertowi szybko wygasnąć po przywróceniu usługi.
P: Czym jest toil i jak się go kontroluje?
To praca ręczna, powtarzalna, możliwa do automatyzacji, bez trwałej wartości i skalująca się wraz z usługą. Mierzy się go, ogranicza (Google stosuje próg 50%) i redukuje przez automatyzację lub przekazanie pracy zespołowi, który jest właścicielem usługi.
P: Co sprawia, że postmortem jest „blameless”?
Skupia się na warunkach systemowych, które dopuściły do awarii, zakłada, że ludzie działali rozsądnie w oparciu o dostępne informacje, i kończy się śledzonymi działaniami naprawczymi. Test jest prosty: czy zaangażowany inżynier podzieliłby się każdym szczegółem bez obaw?
Pytania o monitoring często padają zaraz po pytaniach o SLO. Przewodnik po pytaniach rekrutacyjnych z Prometheusa omawia PromQL, typy metryk i kardynalność, a strona technologii DevOps zawiera listę wszystkich modułów do szerszego przygotowania.
SLO i budżety błędów w praktyce: najważniejsze wnioski
- Każde SLI należy definiować jako stosunek zdarzeń poprawnych do ważnych, mierzony możliwie blisko użytkownika, z wyłączeniem 4xx z awarii w przypadku większości API
- Cel SLO warto wybierać na podstawie danych historycznych i kroczącego okna 28 lub 30 dni, utrzymując go bardziej rygorystycznym niż jakiekolwiek SLA wobec klienta
- Cel trzeba przeliczyć na budżet w minutach lub żądaniach i znać liczby na pamięć: 99,9% w 30 dni to 43 minuty
- Alerty powinny bazować na burn rate z parami okien (14,4 dla 1 h i 5 min, 6 dla 6 h i 30 min), a nie na surowym odsetku błędów czy CPU
- Reguły najlepiej generować Slothem lub podobnym narzędziem, gdy SLO ma więcej niż kilka usług, aby progi pozostały spójne
- Politykę budżetu błędów trzeba spisać i podpisać przed pierwszym przekroczeniem, łącznie z regułą zamrożenia i ścieżką eskalacji
- Toil, liczbę powiadomień i działania naprawcze z postmortemów należy śledzić z taką samą dyscypliną jak nowe funkcje
Zacznij ćwiczyć!
Sprawdź swoją wiedzę z naszymi symulatorami rozmów i testami technicznymi.
Znajdziesz błąd w DevOps?
Prawdziwy fragment kodu, ukryty błąd, jedna próba dziennie. Bez konta, żeby spróbować.

Autor:
Anthony Fillion-MailletZałożyciel SharpSkill
Programista fullstack od ponad 10 lat. Prowadzi SharpSkill i odpowiada za wszystko, co się tu ukazuje.
Zaktualizowano 7 listopada 2026
Tagi
Udostępnij
Powiązane artykuły

Pytania rekrutacyjne o Prometheusa 2026: Prometheus vs Grafana vs Datadog w porównaniu
Pytania rekrutacyjne o Prometheusa na stanowiska DevOps i SRE, z odpowiedziami o PromQL, typach metryk, kardynalności i HA, oraz porównanie Prometheus vs Grafana vs Datadog: architektura, alertowanie i ceny.
Freelance DevOps engineer w 2026: gdzie szukać kontraktów, stawki dzienne i jak się przygotować
Przewodnik po rynku freelance DevOps w 2026 roku. Platformy z ofertami kontraktowymi, stawki dzienne, wymagane umiejętności i przygotowanie do rozmów technicznych.
Praca dla inżyniera DevOps w 2026: gdzie szukać, widełki płacowe, jak się przygotować
Kompleksowy przewodnik po rynku pracy DevOps w 2026 roku. Gdzie szukać ofert, jakie są zarobki, co jest wymagane i jak przygotować się do rozmowy kwalifikacyjnej.