ETL vs ELT w 2026: Architektura Potoków Danych i Pytania Rekrutacyjne
ETL i ELT to dwa podejścia do architektury potoków danych. To porównanie wyjaśnia, kiedy stosować każdy wzorzec, jakie narzędzia go wspierają oraz jakie pytania rekrutacyjne dotyczące projektowania potoków spotykają inżynierowie danych.
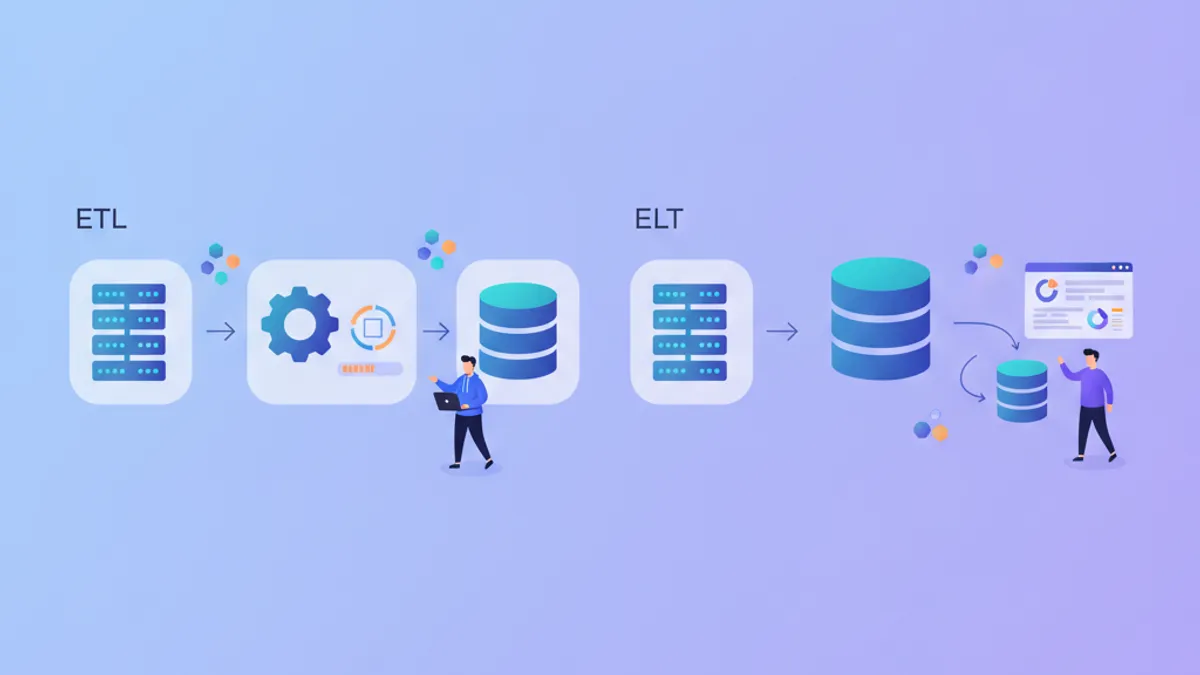
ETL vs ELT definiuje sposób, w jaki dane przemieszczają się z systemów źródłowych do środowisk analitycznych. Wybór między ekstrakcją, transformacją i ładowaniem (ETL) a ekstrakcją, ładowaniem i transformacją (ELT) wpływa na koszty infrastruktury, świeżość danych oraz umiejętności wymagane od zespołów inżynieryjnych.
ETL transformuje dane przed załadowaniem do systemu docelowego, wymagając dedykowanych zasobów obliczeniowych. ELT najpierw ładuje surowe dane, a następnie transformuje je wykorzystując moc obliczeniową docelowej hurtowni. Większość natywnych chmurowo stosów danych w 2026 roku preferuje ELT, ponieważ moc obliczeniowa skaluje się na żądanie.
Architektura ETL: Transformacja Przed Ładowaniem
ETL powstał, gdy hurtownie danych miały ograniczoną moc obliczeniową, a przestrzeń dyskowa była droga. Wzorzec miał sens: filtrowanie i agregacja danych poza hurtownią, ładowanie tylko tego, co było potrzebne do analizy. Oracle Warehouse Builder, Informatica PowerCenter i Talend zbudowały narzędzia wokół tego modelu.
Etap transformacji w ETL działa na serwerach pośrednich. Dane przemieszczają się ze źródła do obszaru przejściowego, są czyszczone i przekształcane, a następnie ładowane do miejsca docelowego. Takie podejście zmniejsza obciążenie hurtowni, ale tworzy wąskie gardło na warstwie transformacji.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL sprawdza się, gdy logika transformacji pozostaje stabilna, a wolumeny danych są przewidywalne. Wada ujawnia się, gdy wymagania się zmieniają: modyfikacja transformacji oznacza ponowne przetworzenie danych historycznych od podstaw.
Architektura ELT: Najpierw Ładowanie, Transformacja w Hurtowni
ELT przenosi transformację do hurtowni danych. Snowflake, BigQuery, Databricks i Redshift zapewniają niemal nieograniczoną moc obliczeniową, która skaluje się wraz ze złożonością zapytań. Ładowanie surowych danych w pierwszej kolejności zachowuje stan źródłowy; transformacje stają się modelami SQL, które można wersjonować i uruchamiać ponownie bez ponownej ekstrakcji.
Projekt dbt (data build tool) spopularyzował ELT, traktując transformacje SQL jako kod. Zamiast nieprzejrzystych zadań ETL, transformacje znajdują się w systemie kontroli wersji jako instrukcje SELECT, które odwołują się do surowych tabel i budują modele pochodne.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT zachowuje surowe dane, co umożliwia ponowne przetwarzanie, gdy zmienia się logika biznesowa. Jeśli obliczenie było błędne sześć miesięcy temu, poprawienie modelu dbt i uruchomienie pełnego odświeżenia koryguje dane historyczne. W przypadku ETL ta sama poprawka wymaga ponownej ekstrakcji ze źródeł, które mogą już nie posiadać oryginalnych rekordów.
Tabela Porównawcza: Kompromisy ETL vs ELT
| Czynnik | ETL | ELT |
|---|---|---|
| Lokalizacja obliczeń | Dedykowany serwer transformacji | Docelowa hurtownia |
| Przechowywanie surowych danych | Często usuwane po transformacji | Zachowane w strefie lądowania |
| Koszt ponownego przetwarzania | Ponowna ekstrakcja ze źródła | Ponowne uruchomienie modeli SQL |
| Elastyczność schematu | Ustalony w czasie transformacji | Możliwy schemat przy odczycie |
| Przykłady narzędzi | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Najlepsze dla | Stabilne wymagania, systemy legacy | Zmieniające się wymagania, chmurowe hurtownie |
| Opóźnienie | Wyższe (transformacja przed ładowaniem) | Niższe (ładowanie, potem transformacja) |
| Zarządzanie danymi | Łatwiejsze (dane filtrowane przed hurtownią) | Wymaga kontroli na poziomie hurtowni |
Gotowy na rozmowy o Data Engineering?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Podejścia Hybrydowe: Gdy ETL i ELT Się Łączą
Nowoczesne stosy danych rzadko używają czystego ETL lub ELT. Apache Airflow orkiestruje potoki, które mieszają oba wzorce. Wrażliwe dane mogą być anonimizowane przed ładowaniem (krok ETL), podczas gdy agregacje wykonywane są w hurtowni (ELT).
Fivetran i Airbyte ekstrahują i ładują surowe dane bez transformacji, a następnie dbt transformuje wewnątrz hurtowni. Jednak te narzędzia wspierają również lekkie transformacje podczas ekstrakcji: wybór kolumn, konwersja typów danych, haszowanie pól PII. To zaciera granicę między ETL a ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Powyższy potok ekstrahuje z Salesforce za pomocą Airbyte (który może haszować adresy email podczas synchronizacji), ładuje do Snowflake, a następnie uruchamia modele dbt dla transformacji biznesowych. Ani czysty ETL, ani czysty ELT, ale praktyczny.
Pytania Rekrutacyjne: ETL vs ELT dla Inżynierów Danych
Rozmowy techniczne na stanowiska inżynierii danych w firmach korzystających z nowoczesnych stosów danych badają zrozumienie architektury potoków. Te pytania pojawiają się często, zgodnie ze wzorcami z modułów przygotowania do rozmów ETL/ELT.
Pytanie 1: Kiedy Wybrałbyś ETL Zamiast ELT?
Dobre odpowiedzi identyfikują konkretne scenariusze:
- Wymagania zgodności: RODO lub HIPAA nakazują, że pewne dane nigdy nie mogą trafić do hurtowni w surowej formie. PII musi być anonimizowane lub usunięte przed ładowaniem.
- Ograniczenia starszych hurtowni: Systemy on-premises jak Teradata lub starsze konfiguracje Redshift z ustaloną mocą obliczeniową korzystają z pre-agregowanych ładowań.
- Koszty sieciowe: Ładowanie 10TB dziennie do chmurowej hurtowni, a następnie odrzucanie 90% po transformacji, marnuje przepustowość wyjściową. Pre-filtrowanie ma sens ekonomiczny.
Słabe odpowiedzi mówią "ETL jest przestarzały" lub nie podają konkretnych scenariuszy. Rekruterzy szukają niuansów.
Pytanie 2: Jak Radzisz Sobie ze Zmianami Schematu w Potoku ELT?
To testuje zrozumienie stref lądowania surowych danych. Oczekiwane tematy:
- Kolumny JSON lub semi-strukturalne, które absorbują nowe pola bez migracji schematu
- Modele staging, które jawnie wybierają kolumny, izolując modele downstream od zmian źródłowych
- Makra dbt lub asercje Dataform, które przerywają buildy, gdy oczekiwane kolumny znikają
- Monitorowanie dryfu schematu za pomocą narzędzi takich jak Monte Carlo lub Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Pytanie 3: Porównaj Orkiestrację ETL z Airflow vs Uruchamianie dbt dla ELT
Pytanie bada zrozumienie, że te narzędzia rozwiązują różne problemy:
- Airflow orkiestruje zadania: ekstrakcję, wywołania API, transfery plików, trenowanie modeli. Zarządza zależnościami między heterogenicznymi zadaniami.
- dbt transformuje dane wewnątrz hurtowni. Zarządza zależnościami między modelami SQL, uruchamia testy, generuje dokumentację.
Kompletny potok często używa obu: Airflow wyzwala synchronizacje Airbyte, czeka na zakończenie, a następnie wyzwala uruchomienia dbt. Wiedza, kiedy używać którego narzędzia, wyróżnia seniorów.
Pytanie 4: Twój Potok ELT Przetwarza 500M Wierszy Dziennie, a Analitycy Zgłaszają Wolne Zapytania
To otwarte pytanie testuje myślenie diagnostyczne:
- Sprawdź materializację modeli: Czy ciężkie modele to nadal widoki? Modele przyrostowe lub tabele mogą pomóc.
- Partycjonowanie i klastrowanie: Dla BigQuery, czy tabele faktów są partycjonowane według daty? Dla Snowflake, czy klastrowanie jest zoptymalizowane pod kątem typowych wzorców zapytań?
- Pushdown zapytań: Czy analitycy odpytują modele staging zamiast pre-agregowanych marts?
- Rozmiar hurtowni: Czy moc obliczeniowa jest odpowiednio skalowana w godzinach zapytań?
- Wymagania świeżości: Czy transformacja może działać w nocy zamiast w godzinach pracy?
Nie ma jednej poprawnej odpowiedzi. Rekruterzy oceniają systematyczne rozwiązywanie problemów.
Krajobraz Narzędzi w 2026 Roku
Rynek integracji danych skonsolidował się wokół kilku wzorców:
Ekstrakcja i ładowanie: Fivetran, Airbyte, Stitch i Meltano obsługują część EL. Te narzędzia łączą się z setkami źródeł i synchronizują z chmurowymi hurtowniami bez niestandardowego kodu.
Transformacja: dbt dominuje w transformacjach opartych na SQL. Alternatywy to Dataform (teraz część Google Cloud), SQLMesh (open source z wirtualnymi środowiskami danych) i Coalesce (wizualne modelowanie).
Orkiestracja: Airflow pozostaje domyślnym wyborem dla złożonych potoków. Dagster i Prefect oferują alternatywy z lepszym lokalnym developmentem i widokami zorientowanymi na assety.
Jakość: Great Expectations, testy dbt, Monte Carlo i Soda zapewniają monitorowanie jakości danych. Wychwytują problemy między ekstrakcją a konsumpcją downstream.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Zacznij ćwiczyć!
Sprawdź swoją wiedzę z naszymi symulatorami rozmów i testami technicznymi.
Wybór Architektury Potoku dla Nowych Projektów
Dla większości nowych projektów w 2026 roku ELT jest domyślnym wyborem. Moc obliczeniowa chmurowej hurtowni kosztuje mniej niż utrzymanie serwerów transformacji. Zachowanie surowych danych umożliwia wsteczne poprawki. Transformacje oparte na SQL są audytowalne i wersjonowane.
ETL pozostaje istotny dla:
- Środowisk regulacyjnych wymagających minimalizacji danych przed wejściem do hurtowni
- Strumieniowania w czasie rzeczywistym, gdzie transformacja musi nastąpić w momencie ingestion (Kafka Streams, Flink)
- Scenariuszy edge computing z ograniczoną przestrzenią docelową
- Integracji z systemami legacy, gdzie system źródłowy kontroluje format eksportu
Odpowiedź gotowa na rozmowę rekrutacyjną uznaje oba wzorce i wyjaśnia kompromisy bez ideologicznej preferencji.
Kluczowe Wnioski dla Architektury Potoków Danych
- ETL transformuje dane przed ładowaniem, zmniejszając obciążenie hurtowni, ale tworząc tarcie przy ponownym przetwarzaniu, gdy zmienia się logika
- ELT najpierw ładuje surowe dane, umożliwiając transformacje oparte na SQL, które można wersjonować, testować i uruchamiać ponownie na danych historycznych
- Nowoczesne stosy zazwyczaj łączą oba podejścia: lekkie transformacje ekstrakcyjne (haszowanie PII, konwersja typów) z agregacją w hurtowni
- dbt stał się standardem dla transformacji ELT, traktując modele SQL jako testowalny, udokumentowany kod
- Pytania rekrutacyjne badają wybór scenariusza, obsługę ewolucji schematu i kompromisy narzędziowe, a nie definicje z pamięci
- Zachowanie surowych danych w potokach ELT umożliwia poprawki obliczeń historycznych bez ponownej ekstrakcji ze źródeł
Znajdziesz błąd w Data Engineering?
Prawdziwy fragment kodu, ukryty błąd, jedna próba dziennie. Bez konta, żeby spróbować.

Autor:
Anthony Fillion-MailletZałożyciel SharpSkill
Programista fullstack od ponad 10 lat. Prowadzi SharpSkill i odpowiada za wszystko, co się tu ukazuje.
Zaktualizowano 14 września 2026
Tagi
Udostępnij
Powiązane artykuły
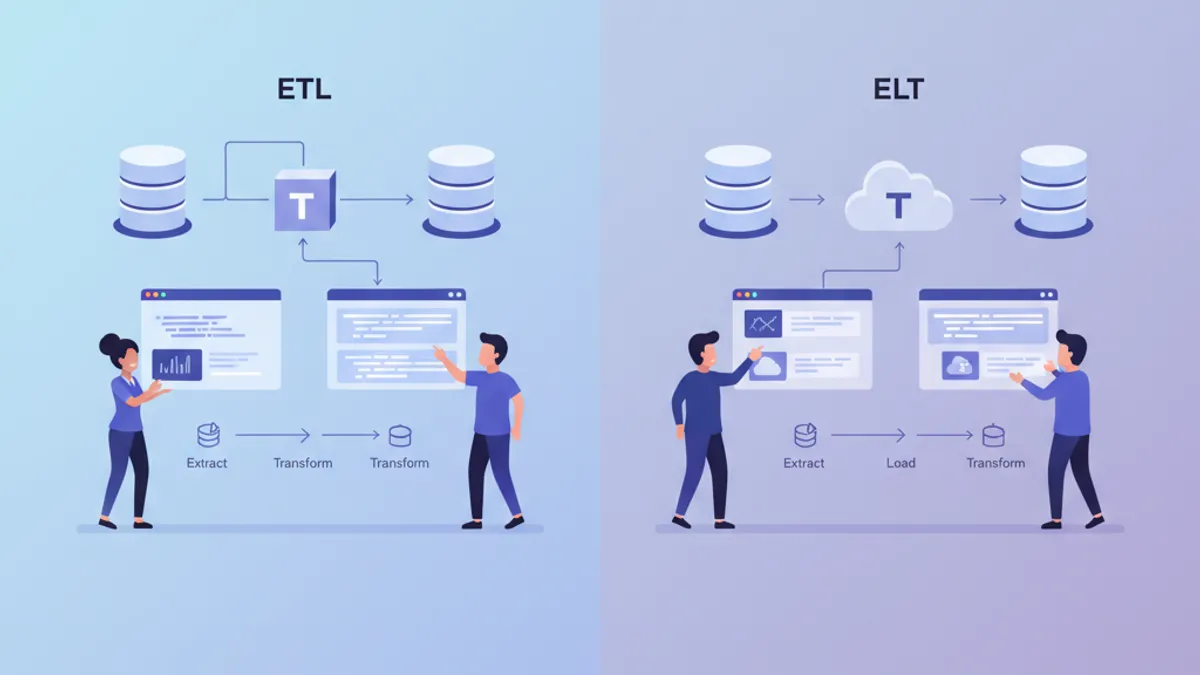
ETL vs ELT w 2026: Architektura potoków danych od podstaw
Porównanie ETL i ELT dla nowoczesnych potoków danych. Różnice architektoniczne, kompromisy wydajnościowe i zastosowania z Snowflake, BigQuery i dbt.
Apache Airflow w 2026: orkiestracja potoków danych, DAG-i i pytania rekrutacyjne
Kompleksowy przewodnik po Apache Airflow 3.2 w 2026 roku: tworzenie DAG-ów z Task SDK, dynamiczne mapowanie zadań, partycje assetów, natywne zadania asynchroniczne oraz pytania rekrutacyjne na stanowiska data engineering.
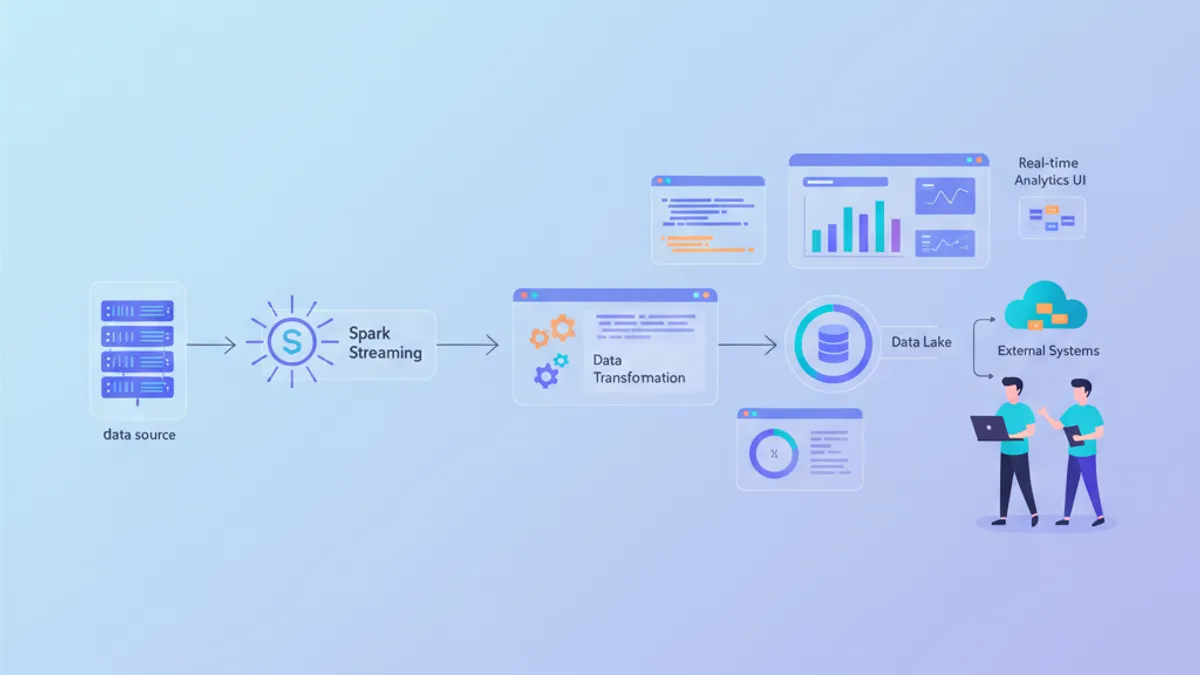
Apache Spark 4 w 2026 roku: Nowe funkcje, Structured Streaming i pytania rekrutacyjne
Kompleksowy przewodnik techniczny po Apache Spark 4 z omowieniem trybu ANSI SQL, typu danych VARIANT, Real-Time Mode Streaming, Spark Connect oraz najwazniejszych pytan rekrutacyjnych na stanowiska Data Engineering.