Excel Power Query w 2026: ETL dla analityków danych i pytania rekrutacyjne
Opanowanie Excel Power Query do operacji ETL, transformacji danych i podstaw języka M. Praktyczne przykłady oraz typowe pytania rekrutacyjne dla analityków danych.
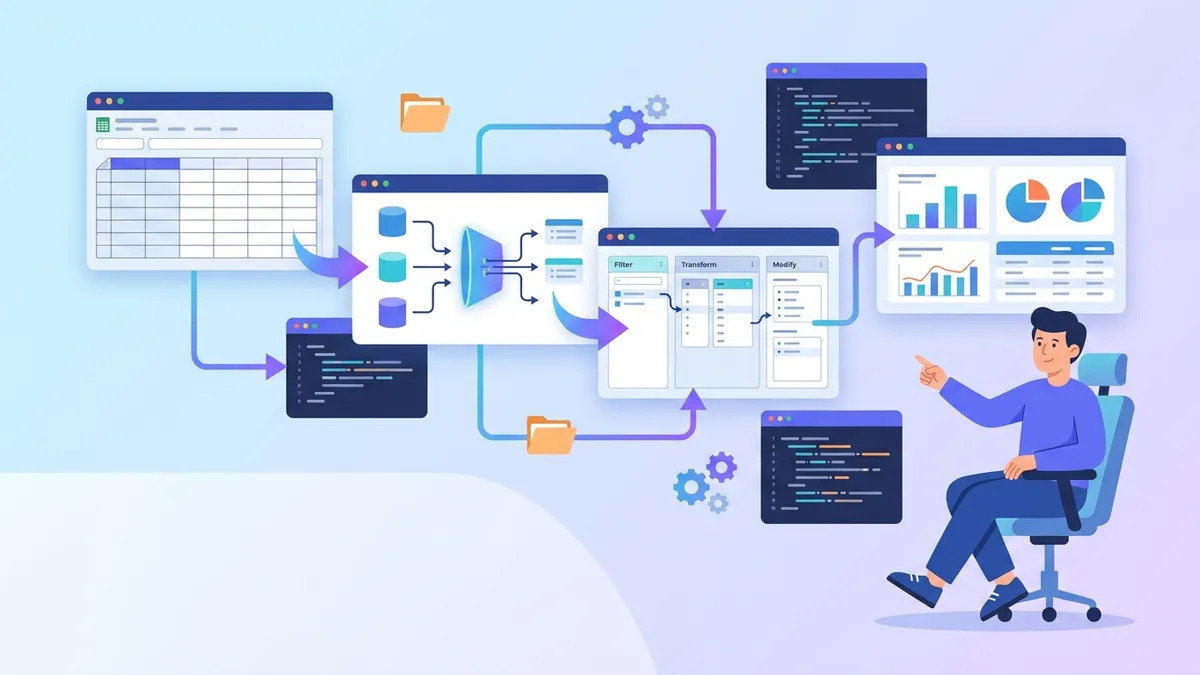
Excel Power Query zmienia sposób, w jaki analitycy danych realizują przepływy ETL (Extract, Transform, Load) bezpośrednio w Excelu. W odróżnieniu od ręcznego kopiowania lub złożonych makr VBA, Power Query oferuje wizualny interfejs wspierany przez język M, umożliwiając powtarzalne transformacje danych, które odświeżają się jednym kliknięciem.
Power Query jest wbudowany w Excel 365, Excel 2021, Excel 2019 oraz Excel 2016. We wcześniejszych wersjach był dostępny jako darmowy dodatek pod nazwą "Power Query for Excel". Ten sam silnik napędza przepływy danych w Power BI Desktop.
Co Power Query rozwiązuje dla analityków danych
Analitycy danych poświęcają znaczną ilość czasu na przygotowanie danych: łączenie plików z różnych źródeł, czyszczenie niespójnych formatów, filtrowanie nieistotnych wierszy i przekształcanie tabel do analizy. Power Query adresuje te zadania poprzez edytor zapytań, który rejestruje każdy krok transformacji. Gdy dane źródłowe się zmienią, cały pipeline wykonuje się automatycznie ponownie.
Przepływ pracy składa się z trzech etapów: połączenie ze źródłami danych, zastosowanie transformacji i załadowanie wyników do tabel Excela lub modelu danych. Każdy krok jest zapisywany w pasku formuły przy użyciu składni języka M, którą można bezpośrednio edytować w zaawansowanych scenariuszach.
To podejście różni się od tradycyjnych formuł Excela. Podczas gdy formuły przeliczają komórki, Power Query operuje na całych tabelach zanim trafią one do arkusza. Zapytanie konsolidujące 50 plików CSV, usuwające duplikaty i odwracające kolumny wykonuje się raz i produkuje czystą tabelę, zamiast budować złożone zagnieżdżone formuły spowalniające skoroszyt.
Łączenie ze źródłami danych za pomocą Pobierz dane
Power Query obsługuje połączenia z plikami (CSV, Excel, JSON, XML), bazami danych (SQL Server, MySQL, PostgreSQL, Oracle), usługami chmury (SharePoint, Azure, Salesforce) oraz stronami internetowymi. Typ połączenia determinuje, jakie opcje uwierzytelniania i importu się pojawią.
// Typowe źródła danych w Power Query
Dane > Pobierz dane > Z pliku > Z pliku CSV
Dane > Pobierz dane > Z bazy danych > Z bazy danych SQL Server
Dane > Pobierz dane > Z innych źródeł > Z sieci Web
Dane > Pobierz dane > Z folderu (wiele plików)
Opcja "Z folderu" jest szczególnie przydatna do konsolidacji wielu plików. Zamiast importować każdy plik osobno, Power Query skanuje folder, wyświetla listę wszystkich pasujących plików i łączy je w jedno zapytanie. Dodanie nowego pliku do folderu automatycznie włącza go przy następnym odświeżeniu.
Podczas łączenia z bazą danych SQL, Power Query może przesunąć logikę transformacji na serwer poprzez zwijanie zapytań (query folding). Filtry i selekcje kolumn tłumaczą się na klauzule SQL WHERE i SELECT, redukując ilość danych przesyłanych do Excela. Pasek formuły pokazuje opcję "Wyświetl zapytanie natywne" gdy zwijanie jest aktywne.
Podstawowe transformacje w Edytorze zapytań
Edytor zapytań zapewnia polecenia wstążki dla typowych operacji, ale zrozumienie bazowego kodu M pomaga gdy potrzebne są dostosowania. Każda transformacja dodaje krok do panelu "Zastosowane kroki", tworząc audytowalną sekwencję.
Filtrowanie i sortowanie wierszy
Filtrowanie usuwa wiersze, które nie spełniają kryteriów. Menu rozwijane nagłówka kolumny oferuje szybkie filtry, podczas gdy okno dialogowe "Filtruj wiersze" obsługuje złożone warunki z logiką AND/OR.
// Krok FilteredRows w języku M
let
    Source = Excel.CurrentWorkbook(){[Name="SalesData"]}[Content],
    FilteredRows = Table.SelectRows(Source, each [Region] = "EMEA" and [Amount] > 1000)
in
    FilteredRows
Funkcja Table.SelectRows przyjmuje tabelę i warunek. Słowo kluczowe each tworzy funkcję, gdzie _ reprezentuje bieżący wiersz, a dostęp do pól używa notacji nawiasowej [Region]. Wiele warunków łączy się operatorami and lub or.
Usuwanie i zmiana nazw kolumn
Źródła danych często zawierają kolumny niepotrzebne do analizy. Ich wczesne usunięcie redukuje zużycie pamięci i upraszcza dalsze kroki.
// Usuń kolumny, następnie zmień nazwy pozostałych
let
    Source = Excel.CurrentWorkbook(){[Name="RawData"]}[Content],
    RemovedColumns = Table.RemoveColumns(Source, {"TempID", "InternalNotes", "Debug"}),
    RenamedColumns = Table.RenameColumns(RemovedColumns, {{"Cust_Name", "CustomerName"}, {"Amt", "Amount"}})
in
    RenamedColumns
Lista kolumn używa nawiasów klamrowych {} dla wielu elementów. Zmiana nazw przyjmuje listę par, gdzie każda para zawiera starą i nową nazwę. Spójne konwencje nazewnictwa w zapytaniach ułatwiają łączenie zbiorów danych.
Dzielenie i scalanie kolumn
Kolumny tekstowe często wymagają parsowania. Kolumna "FullName" może wymagać podzielenia na imię i nazwisko, lub osobne kolumny daty i czasu mogą wymagać scalenia.
// Podziel FullName przez delimiter na dwie kolumny
let
    Source = Excel.CurrentWorkbook(){[Name="Contacts"]}[Content],
    SplitColumn = Table.SplitColumn(Source, "FullName", Splitter.SplitTextByDelimiter(" ", QuoteStyle.Csv), {"FirstName", "LastName"})
in
    SplitColumn
Funkcja Splitter.SplitTextByDelimiter obsługuje logikę parsowania. Dla bardziej złożonych wzorców, Splitter.SplitTextByEachDelimiter lub Splitter.SplitTextByPositions oferują dodatkową kontrolę. Gdy liczba wynikowych kolumn jest zmienna, Power Query tworzy kolumny dynamicznie.
Konwersje typów i jakość danych
Power Query wnioskuje typy kolumn przy imporcie, ale jawne przypisanie typów wychwytuje błędy wcześnie. Kolumna tekstowa zawierająca numeryczne ID powinna pozostać tekstem, jeśli wiodące zera mają znaczenie. Kolumny dat zaimportowane jako tekst powodują problemy z sortowaniem.
// Jawne przypisania typów
let
    Source = Csv.Document(File.Contents("C:\\Data\\transactions.csv")),
    TypedColumns = Table.TransformColumnTypes(Source, {
        {"TransactionID", type text},
        {"Date", type date},
        {"Amount", type number},
        {"IsProcessed", type logical}
    })
in
    TypedColumns
Słowo kluczowe type określa typ docelowy. Dostępne typy to text, number, date, datetime, datetimezone, time, duration, logical i binary. Błędy typów pojawiają się jako wartości "Error" w komórkach, czyniąc problemy z jakością danych widocznymi przed analizą.
Obsługa wartości null wymaga jawnej logiki. Funkcja Table.ReplaceValue zastępuje nulle wartościami domyślnymi, podczas gdy Table.SelectRows z [Column] <> null je odfiltrowuje.
Grupowanie i agregacja za pomocą Grupuj według
Agregowanie danych według kategorii jest częstym wymogiem. Transformacja "Grupuj według" zwija wiersze współdzielące te same wartości kluczy i stosuje funkcje agregujące.
// Grupuj sprzedaż według regionu i roku, oblicz sumę i liczbę
let
    Source = Excel.CurrentWorkbook(){[Name="Sales"]}[Content],
    Grouped = Table.Group(Source, {"Region", "Year"}, {
        {"TotalSales", each List.Sum([Amount]), type number},
        {"OrderCount", each Table.RowCount(_), Int64.Type},
        {"AvgOrderValue", each List.Average([Amount]), type number}
    })
in
    Grouped
Kolumny grupujące pojawiają się jako pierwsze, następnie definicje agregacji. Każda agregacja określa nazwę nowej kolumny, funkcję agregującą i opcjonalny typ wyniku. Słowo kluczowe each reprezentuje podtabelę dla każdej grupy, pozwalając na użycie dowolnej funkcji tabelowej lub listowej.
Zagnieżdżone agregacje umożliwiają obliczenia takie jak "procent sumy grupy" przez odwoływanie się zarówno do wartości wiersza, jak i agregatu grupy w kolejnym kroku.
Gotowy na rozmowy o Data Analytics?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Przestawianie i odwracanie przestawień do przekształcania danych
Przestawianie (pivot) konwertuje wartości wierszy na kolumny, tworząc układ krzyżowy. Odwracanie przestawień (unpivot) wykonuje operację odwrotną, konwertując kolumny na wiersze dla znormalizowanych struktur.
// Odwróć przestawienie kolumn miesięcznych na wiersze
let
    Source = Excel.CurrentWorkbook(){[Name="MonthlySales"]}[Content],
    // Oryginał: kolumny Product, Jan, Feb, Mar, Apr
    Unpivoted = Table.UnpivotOtherColumns(Source, {"Product"}, "Month", "Sales")
    // Wynik: kolumny Product, Month, Sales
in
    Unpivoted
Funkcja Table.UnpivotOtherColumns zachowuje określone kolumny na stałe i odwraca przestawienie pozostałych. Jest to bezpieczniejsze niż wymienianie wszystkich kolumn do odwrócenia, ponieważ dodanie nowych kolumn miesięcznych automatycznie je uwzględni. Dwa końcowe parametry nazywają kolumnę atrybutu ("Month") i kolumnę wartości ("Sales").
Przestawianie używa Table.Pivot z funkcją agregującą dla przypadków, gdy wiele wartości istnieje dla tej samej kombinacji wiersz-kolumna:
// Przestaw sprzedaż według regionu
let
    Source = Excel.CurrentWorkbook(){[Name="DetailedSales"]}[Content],
    Pivoted = Table.Pivot(Source, List.Distinct(Source[Region]), "Region", "Amount", List.Sum)
in
    Pivoted
Scalanie i dołączanie zapytań
Łączenie danych z wielu źródeł to miejsce, gdzie Power Query redukuje ręczny wysiłek. Scalanie wykonuje złączenie między dwiema tabelami na podstawie pasujących kolumn. Dołączanie układa tabele pionowo.
// Left join: Zamówienia ze szczegółami klienta
let
    Orders = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    Customers = Excel.CurrentWorkbook(){[Name="Customers"]}[Content],
    Merged = Table.NestedJoin(Orders, {"CustomerID"}, Customers, {"ID"}, "CustomerDetails", JoinKind.LeftOuter),
    Expanded = Table.ExpandTableColumn(Merged, "CustomerDetails", {"Name", "Email"})
in
    Expanded
Funkcja Table.NestedJoin tworzy zagnieżdżoną kolumnę tabelową zawierającą pasujące wiersze. Funkcja Table.ExpandTableColumn następnie spłaszcza zagnieżdżoną strukturę do zwykłych kolumn. Rodzaje złączeń obejmują Inner, LeftOuter, RightOuter, FullOuter, LeftAnti i RightAnti.
Dołączanie za pomocą Table.Combine wymaga pasujących nazw kolumn. Gdy schematy się różnią, Table.SelectColumns na każdym źródle przed połączeniem zapewnia spójność:
// Dołącz dwie tabele sprzedaży ze spójnymi kolumnami
let
    Sales2024 = Table.SelectColumns(Source2024, {"Date", "Product", "Amount"}),
    Sales2025 = Table.SelectColumns(Source2025, {"Date", "Product", "Amount"}),
    Combined = Table.Combine({Sales2024, Sales2025})
in
    Combined
Kolumny niestandardowe i logika warunkowa
Funkcja "Dodaj kolumnę > Kolumna niestandardowa" pozwala na pola obliczeniowe używające wyrażeń M. Logika warunkowa używa składni if-then-else.
// Dodaj obliczoną kolumnę z logiką warunkową
let
    Source = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    AddedColumn = Table.AddColumn(Source, "OrderCategory", each
        if [Amount] >= 10000 then "Enterprise"
        else if [Amount] >= 1000 then "Business"
        else "Consumer",
        type text
    )
in
    AddedColumn
Wyrażenie if musi zawierać zarówno gałąź then, jak i else. Zagnieżdżone warunki łączą się za pomocą else if. Ostatni parametr określa typ kolumny, poprawiając wydajność i zapobiegając problemom z wnioskowaniem typów.
Dla złożonych transformacji, funkcje pomocnicze zdefiniowane w bloku let utrzymują czytelność kodu:
let
    // Funkcja pomocnicza dla kwartału fiskalnego
    GetFiscalQuarter = (date as date) as text =>
        let
            month = Date.Month(date),
            fiscalQ = if month >= 4 and month <= 6 then "Q1"
                     else if month >= 7 and month <= 9 then "Q2"
                     else if month >= 10 and month <= 12 then "Q3"
                     else "Q4"
        in
            fiscalQ,

    Source = Excel.CurrentWorkbook(){[Name="Transactions"]}[Content],
    AddedQuarter = Table.AddColumn(Source, "FiscalQuarter", each GetFiscalQuarter([Date]), type text)
in
    AddedQuarter
Obsługa błędów w Power Query
Błędy transformacji pojawiają się jako wartości "Error" w komórkach, zamiast powodować niepowodzenie całego zapytania. Konstrukcja try-otherwise obsługuje błędy elegancko:
// Obsłuż potencjalne błędy dzielenia
let
    Source = Excel.CurrentWorkbook(){[Name="Metrics"]}[Content],
    AddedRatio = Table.AddColumn(Source, "Ratio", each
        try [Value1] / [Value2] otherwise null,
        type number
    )
in
    AddedRatio
Słowo kluczowe try próbuje wykonać wyrażenie i zwraca rekord z polami HasError i Value. Klauzula otherwise zapewnia wartość zastępczą, gdy HasError jest prawdziwe. Dla większej kontroli, dostęp do szczegółów błędu za pomocą try Expression:
// Przechwyć szczegóły błędu
let
    result = try SomeRiskyFunction(),
    output = if result[HasError] then "Error: " & result[Error][Message] else result[Value]
in
    output
Pytania rekrutacyjne z Power Query dla analityków danych
Rekruterzy oceniają zarówno praktyczne umiejętności, jak i zrozumienie, kiedy Power Query pasuje do przepływu pracy. Te pytania pojawiają się często na rozmowach kwalifikacyjnych dla analityków danych.
Czym jest zwijanie zapytań (query folding) i dlaczego ma znaczenie?
Zwijanie zapytań tłumaczy transformacje Power Query na natywne zapytania źródła danych. Podczas łączenia z SQL Server, krok filtrowania staje się klauzulą WHERE wykonywaną na serwerze, redukując transfer sieciowy. Nie wszystkie transformacje się zwijają: niestandardowe funkcje M, pewne manipulacje datami i operacje po kroku niezwijającym przerywają łańcuch. Status zwijania można sprawdzić klikając prawym przyciskiem na krok i szukając "Wyświetl zapytanie natywne".
Czym Power Query różni się od formuł Excela dla transformacji danych?
Formuły Excela operują komórka po komórce w arkuszu i przeliczają się przy każdej zmianie. Power Query operuje na tabelach zanim trafią do arkusza, przetwarzając dane masowo podczas odświeżania. Dla transformacji takich jak odwracanie przestawień, deduplikacja lub scalanie plików, Power Query wyraża logikę bardziej bezpośrednio niż zagnieżdżone INDEX-MATCH lub kolumny pomocnicze.
Kiedy wybrałbyś Power Query zamiast Power BI do ETL?
Power Query w Excelu sprawdza się w scenariuszach, gdzie analitycy potrzebują przekształconych danych w formie arkusza kalkulacyjnego do analizy ad-hoc, tabel przestawnych lub udostępniania użytkownikom bez dostępu do Power BI. Power BI zapewnia bogatszą wizualizację, większą pojemność danych i funkcje udostępniania korporacyjnego. Ten sam kod M działa w obu narzędziach, więc zapytania opracowane w Excelu mogą migrować do Power BI Desktop bez przepisywania.
Jak radzisz sobie z niezgodnościami typów danych podczas dołączania tabel?
Ustaw jawne typy na każdej tabeli źródłowej przed połączeniem za pomocą Table.Combine. Jeśli kolumna jest tekstem w jednym źródle i liczbą w drugim, dołączenie zawiedzie lub wygeneruje błędy. Użyj Table.TransformColumnTypes na obu źródłach, aby wymusić spójne typy. Wzorzec try-otherwise obsługuje przypadki brzegowe, gdzie konwersja zawodzi dla konkretnych wartości.
Wyjaśnij różnicę między Scalaniem a Dołączaniem w Power Query.
Scalanie wykonuje poziome złączenie na podstawie pasujących kolumn kluczowych, podobnie do SQL JOIN. Dołączanie wykonuje pionowe złączenie wierszy z wielu tabel, podobnie do SQL UNION ALL. Scalanie wymaga co najmniej jednej wspólnej kolumny do dopasowania. Dołączanie wymaga kolumn o tych samych nazwach, aby poprawnie się wyrównały.
Dla głębszego przygotowania w zakresie koncepcji SQL, które uzupełniają umiejętności Power Query, moduł funkcji okna SQL obejmuje wzorce rankingowe i agregacyjne, podczas gdy moduł podzapytań i CTE SQL adresuje techniki strukturyzacji zapytań.
Opcje ładowania i strategie odświeżania
Po transformacjach, przycisk "Zamknij i załaduj" oferuje wybór ładowania: załaduj do tabeli arkusza, załaduj tylko do modelu danych (Power Pivot) lub utwórz zapytanie tylko do połączenia. Zapytania tylko do połączenia służą jako kroki pośrednie dla innych zapytań bez zajmowania miejsca w arkuszu.
Zachowanie odświeżania zależy od miejsca docelowego ładowania. Tabele arkusza odświeżają się przyciskiem "Odśwież wszystko" lub mogą być ustawione na odświeżanie przy otwieraniu pliku. Tabele modelu danych uczestniczą w cyklu odświeżania modelu danych skoroszytu. Dla zapytań połączonych z zewnętrznymi bazami danych, monity o poświadczenia mogą się pojawić przy odświeżaniu, chyba że zapisane poświadczenia istnieją.
Odświeżanie w tle pozwala na używanie skoroszytu podczas ładowania danych, ale tworzy złożoność gdy formuły zależne polegają na odświeżonych danych. Opcja "Włącz odświeżanie w tle" we właściwościach zapytania kontroluje to zachowanie. Dla krytycznych raportów, wyłączenie odświeżania w tle zapewnia sekwencyjne wykonanie.
Rozważania wydajnościowe dla dużych zbiorów danych
Power Query może obsłużyć miliony wierszy, ale responsywność skoroszytu zależy od sposobu ładowania danych. Ładowanie do modelu danych zamiast tabel arkusza omija limit wierszy Excela i poprawia wydajność tabel przestawnych. Wczesne usuwanie niepotrzebnych kolumn redukuje zużycie pamięci.
Dla zapytań trwających kilka minut, "Podgląd danych" w Edytorze zapytań pokazuje tylko próbkę. Transformacje stosują się do pełnego zbioru danych podczas odświeżania. Błędy widoczne w podglądzie wskazują problemy, ale niektóre błędy pojawiają się tylko z pełnymi danymi. Uruchomienie testowego odświeżenia na podzbiorze waliduje zapytanie przed przetworzeniem wszystkiego.
Podczas konsolidacji wielu plików, funkcja binarnego łączenia Power Query przetwarza pliki równolegle. Zdefiniowanie funkcji transformującej jeden plik, a następnie wywołanie jej dla każdego wiersza na liście plików, zapewnia większą kontrolę niż domyślne podejście kombinacji.
Dokumentacja Microsoft dotycząca najlepszych praktyk Power Query szczegółowo opisuje techniki optymalizacji, w tym struktury zależności zapytań i użycie buforów.
Power Query dla powtarzalnych pipeline'ów ETL
Zarejestrowane kroki w Power Query tworzą dokumentację logiki transformacji. Gdy wymagania się zmienią, modyfikacja kroku automatycznie aktualizuje wszystkie kroki zależne. To kontrastuje z ad-hoc manipulacjami Excela, które wymagają odtworzenia od zera, gdy dane źródłowe się zmienią.
Zespoły mogą współdzielić zapytania eksportując połączenia lub przechowując kod M zapytania w kontroli wersji. Zaawansowany edytor (Widok > Zaawansowany edytor) wyświetla kompletny skrypt M, który można skopiować i wkleić do innego skoroszytu. W scenariuszach korporacyjnych, przepływy danych Power BI i Fabric zapewniają scentralizowane zarządzanie zapytaniami.
- Power Query obsługuje ETL w Excelu używając rejestrowanych, powtarzalnych kroków transformacji
- Język M leżący u podstaw wizualnego interfejsu umożliwia dostosowania wykraczające poza polecenia wstążki
- Zwijanie zapytań przesuwa filtry i projekcje do źródłowych baz danych dla lepszej wydajności
- Scalanie wykonuje złączenia między tabelami, Dołączanie układa tabele pionowo
- Przypisania typów i obsługa błędów zapobiegają cichym problemom z jakością danych
- Zapytania tylko do połączenia tworzą wielokrotnego użytku kroki pośrednie bez wyjścia do arkusza
- Pytania rekrutacyjne koncentrują się na zwijaniu zapytań, porównaniu z formułami oraz rozróżnieniu między scalaniem a dołączaniem
Zacznij ćwiczyć!
Sprawdź swoją wiedzę z naszymi symulatorami rozmów i testami technicznymi.
Znajdziesz błąd w Data Analytics?
Prawdziwy fragment kodu, ukryty błąd, jedna próba dziennie. Bez konta, żeby spróbować.
Autor:
Anthony Fillion-MailletZałożyciel SharpSkill
Programista fullstack od ponad 10 lat. Prowadzi SharpSkill i odpowiada za wszystko, co się tu ukazuje.
Zaktualizowano 20 września 2026
Tagi
Udostępnij
Powiązane artykuły
Pandas 3.0 w 2026: Nowe API, Przełomowe Zmiany i Pytania Rekrutacyjne
Pandas 3.0 wprowadza Copy-on-Write, PyArrow strings i pd.col(). Analiza breaking changes, wzorców migracji i pytań rekrutacyjnych z analizy danych.
Pytania na rozmowę kwalifikacyjną Data Analyst 2026: Kompletny przewodnik SQL, Python i analityki
Kompleksowy przewodnik po pytaniach rekrutacyjnych dla analityków danych obejmujący funkcje okienkowe SQL, operacje Python pandas, koncepcje statystyczne oraz scenariusze biznesowe zadawane przez firmy w 2026 roku.
Apache Superset w 2026: pulpity, SQL Lab i pytania rekrutacyjne
Szczegółowe omówienie Apache Superset: budowa pulpitów analitycznych, SQL Lab i szablony Jinja, porównanie z Tableau oraz pytania rekrutacyjne, które mają znaczenie.