Prinsip SRE 2026: Site Reliability Engineering, SLO, dan Pertanyaan Wawancara
Panduan prinsip SRE untuk 2026: cara memilih SLI, menetapkan SLO, menghitung error budget, menulis alert burn rate multi-window di Prometheus, dan menjawab pertanyaan wawancara SRE yang paling sering muncul.
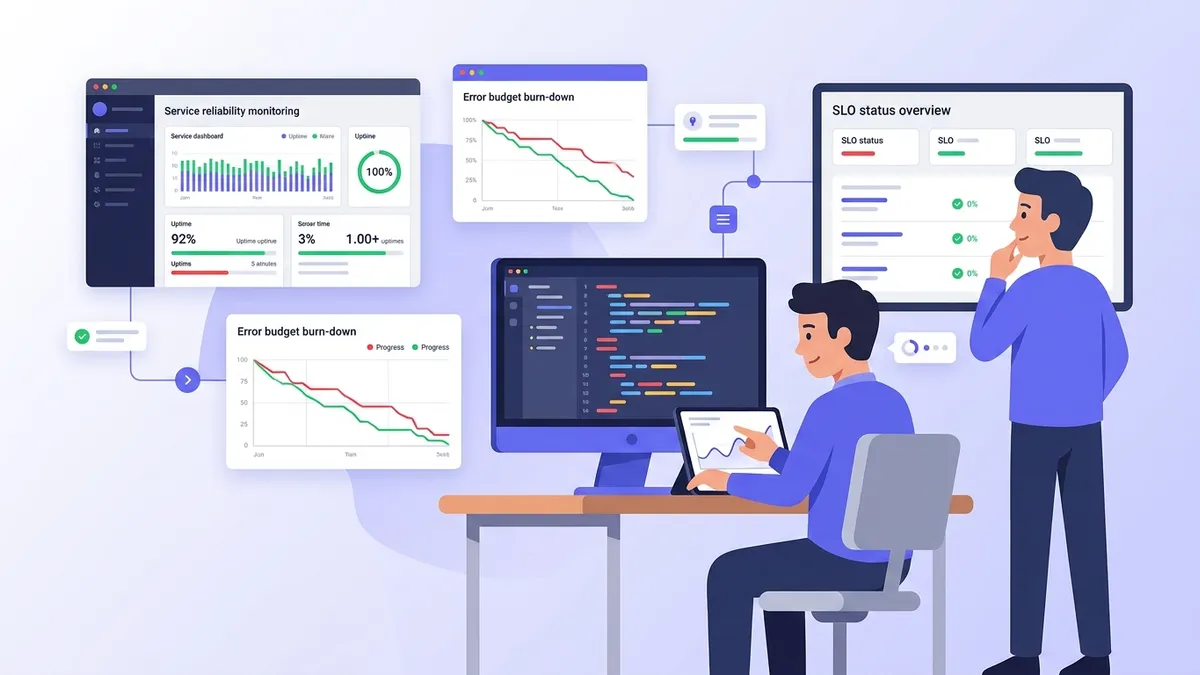
Prinsip SRE mengubah keandalan dari sekadar slogan menjadi angka yang disepakati bersama oleh tim engineering dan tim produk. Angka itu kemudian dipakai untuk memutuskan kapan sebuah fitur boleh dirilis dan kapan rilis harus ditahan. Site reliability engineering, yang lahir di Google dan kini diterapkan oleh hampir semua tim platform, bertumpu pada beberapa gagasan sederhana: ukur apa yang benar-benar dirasakan pengguna (SLI), tetapkan target di bawah 100% (SLO), gunakan selisihnya sebagai error budget, dan batasi pekerjaan manual yang menyita waktu tim. Pertanyaan wawancara SRE pada tahun 2026 menguji gagasan-gagasan ini secara langsung, biasanya dengan meminta kandidat merancang SLO untuk layanan nyata lalu menulis alert yang menjaganya.
SLI adalah hasil pengukuran: rasio antara event yang baik dan event yang valid, misalnya request sukses dibagi seluruh request. SLO adalah target internal untuk rasio tersebut dalam periode tertentu, misalnya 99,9% selama 30 hari. SLA adalah janji kontraktual kepada pelanggan yang disertai penalti, dan nilainya selalu lebih longgar daripada SLO.
Fondasi site reliability engineering
Buku SRE dari Google memandang keandalan sebagai fitur yang memiliki biaya. Setiap tambahan angka sembilan menuntut waktu engineering yang lebih besar dan memperlambat rilis. Di sisi lain, pengguna hampir tidak pernah merasakan perbedaan antara 99,99% dan 99,999%, karena jaringan, perangkat, dan penyedia internet mereka sendiri tidak seandal itu. Tujuannya adalah tingkat keandalan yang tepat, bukan setinggi mungkin.
Dari titik awal tersebut, muncul beberapa prinsip utama:
- Keandalan diukur dari sisi pengguna. Pemakaian CPU dan restart pod hanyalah penyebab. Checkout yang gagal dan halaman yang lambat dimuat adalah hal yang dialami pengguna, dan itulah yang ditangkap oleh SLI.
- Target 100% adalah target yang keliru. SLO 100% praktis melarang semua perubahan, sebab setiap deploy membawa risiko. Celah di bawah 100% disebut error budget, dan budget ini memang dimaksudkan untuk dibelanjakan pada rilis, eksperimen, dan migrasi.
- Toil dibatasi. Panduan Google dalam bab tentang menghilangkan toil menjaga pekerjaan operasional di bawah 50% waktu seorang SRE. Toil adalah pekerjaan manual, berulang, bisa diotomatisasi, dan bertambah seiring pertumbuhan layanan. Sisa waktunya dipakai untuk pekerjaan engineering yang menghapus toil tersebut.
- Postmortem bersifat blameless. Tinjauan insiden menanyakan kondisi sistem apa yang memungkinkan kegagalan terjadi, bukan siapa yang mengetik perintahnya. Engineer yang disalahkan cenderung menyembunyikan informasi, sedangkan tinjauan tanpa menyalahkan justru memunculkannya.
- Monitoring memberi alert berdasarkan gejala. Page dikirim ketika pengguna sedang atau akan segera terdampak, bukan ketika satu node terlihat janggal.
Dalam wawancara, poin kedua inilah yang membedakan SRE berpengalaman dari kandidat yang baru membaca bukunya. Jawaban level junior menganggap error budget sebagai toleransi terhadap kegagalan. Jawaban level senior memperlakukannya sebagai alat manajemen rilis: mekanisme yang membuat tim produk dan tim keandalan berdebat dengan data, bukan dengan opini.
Memilih SLI yang mencerminkan pengalaman pengguna
SLI yang baik berbentuk rasio antara 0 dan 1, dihitung dari event yang dikenali oleh pengguna. SRE workbook menyarankan beberapa pilihan sesuai jenis layanan:
| Jenis layanan | SLI yang umum | Titik pengukuran |
|---|---|---|
| API berbasis request | Ketersediaan, latensi | Log load balancer atau ingress, metrik server |
| Data pipeline | Kesegaran data, kebenaran, cakupan | Timestamp output pipeline, job validasi |
| Sistem penyimpanan | Durabilitas, latensi baca dan tulis | Lapisan storage, probe sintetis |
| Frontend | Waktu muat halaman, error yang terlihat di browser | Real user monitoring |
Pengukuran di load balancer menangkap kegagalan yang tidak pernah terlihat oleh aplikasi, misalnya pod yang crash dan tidak mengembalikan respons apa pun. Pengukuran di browser menangkap masalah CDN dan DNS, tetapi menambah noise dari koneksi seluler yang buruk. Kebanyakan tim memulai dari load balancer atau ingress karena datanya sudah tersedia.
Dengan Prometheus, dua SLI klasik untuk layanan HTTP adalah rasio ketersediaan dan rasio latensi. SLI latensi menghitung request yang lebih cepat dari ambang batas sebagai request baik, sehingga bentuknya tetap rasio, bukan persentil.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Ada dua detail yang sering ditanyakan dalam wawancara. Pertama, respons 4xx biasanya dihitung sebagai valid dan baik, karena 404 atau error validasi adalah kesalahan klien. Jika dihitung sebagai kegagalan, satu klien yang bermasalah bisa menghabiskan budget. Kedua, ambang latensi harus sama persis dengan batas bucket histogram. Jika tidak, query tidak mengembalikan hasil atau diam-diam memakai bucket yang salah. Prometheus 3.16, yang dirilis pada 5 November 2026, mendukung native histogram yang menghapus batasan bucket tetap, tetapi fitur ini perlu diaktifkan di sisi scrape.
Menetapkan target SLO dan menghitung error budget
Sebuah SLO terdiri dari SLI, target, dan jendela waktu. Jendela waktunya biasanya bergulir (rolling), 28 atau 30 hari, sehingga budget pulih secara bertahap alih-alih direset setiap tanggal satu. Target dipilih berdasarkan performa historis dan ekspektasi pengguna, bukan berdasarkan angka yang terlihat bagus di slide presentasi.
Tabel berikut menunjukkan batas setiap target dalam jendela 30 hari. Perhitungannya aritmetika biasa: budget = (1 - SLO) × 30 hari.
| Target SLO | Error budget | Downtime penuh yang diizinkan dalam 30 hari |
|---|---|---|
| 99% | 1% | 7 jam 12 menit |
| 99,5% | 0,5% | 3 jam 36 menit |
| 99,9% | 0,1% | 43 menit 12 detik |
| 99,95% | 0,05% | 21 menit 36 detik |
| 99,99% | 0,01% | 4 menit 19 detik |
Untuk SLO berbasis request, budget dinyatakan dalam jumlah request, bukan menit. Pada SLO 99,9% dengan 12 juta request dalam satu jendela, 12.000 request gagal masih diizinkan. Budget berbasis request lebih adil untuk layanan dengan trafik yang tidak merata, karena gangguan pada pukul 3 pagi menghabiskan budget lebih sedikit dibanding gangguan yang sama pada jam sibuk.
Tugas yang sering muncul dalam wawancara adalah menghitung sisa budget dan seberapa cepat budget itu terpakai. Skrip berikut merupakan contoh jawaban yang diharapkan ketika pewawancara meminta kode.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Burn rate sebesar 15 berarti layanan gagal pada 1,5% request, sementara SLO hanya mengizinkan 0,1%. Dengan laju tersebut, sisa budget sebesar 35% akan habis dalam waktu kurang dari 17 jam. Kondisi seperti ini cukup kuat untuk membangunkan engineer on-call.
Siap menguasai wawancara DevOps Anda?
Berlatih dengan simulator interaktif, flashcards, dan tes teknis kami.
Alert burn rate dengan beberapa jendela waktu
Alert yang langsung dipasang pada SLI ("error rate di atas 0,1%") akan memicu page untuk setiap lonjakan singkat, tetapi justru melewatkan kebocoran yang lambat. Bab SRE workbook tentang alerting pada SLO menyarankan alert multi-window dan multi-burn-rate. Setiap alert menjawab satu pertanyaan: apakah budget terpakai cukup cepat sehingga akan habis sebelum ada orang yang sempat memeriksanya?
Ambang referensi untuk jendela 30 hari adalah sebagai berikut:
| Tingkat keparahan | Jendela panjang | Jendela pendek | Burn rate | Budget terpakai saat alert menyala |
|---|---|---|---|---|
| Page | 1 jam | 5 menit | 14,4 | 2% |
| Page | 6 jam | 30 menit | 6 | 5% |
| Tiket | 3 hari | 6 jam | 1 | 10% |
Jendela panjang memberikan signifikansi: satu menit yang buruk tidak akan memicu page. Jendela pendek, yang panjangnya seperdua belas jendela panjang, membuat alert cepat padam setelah insiden selesai, sehingga page tidak terus menyala selama satu jam setelah perbaikan. Kedua kondisi harus terpenuhi pada saat yang sama.
Blok pertama mencatat rasio error pada setiap jendela agar ekspresi alert tetap ringan. Blok kedua mendefinisikan dua alert page untuk SLO 99,9%, dengan fraksi budget 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageMenulis aturan seperti ini secara manual untuk setiap layanan cepat menjadi pekerjaan yang repetitif, yang ironisnya termasuk toil. Sloth, generator SLO open source, menerima spesifikasi singkat lalu menghasilkan recording rule dan alert multi-burn-rate seperti di atas. Placeholder {{.window}} diganti dengan setiap jendela yang dibutuhkan Sloth.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Tim yang menginginkan format netral dari vendor dapat melihat spesifikasi OpenSLO, yang mendeskripsikan SLO dalam YAML tanpa terikat pada backend monitoring tertentu.
Error budget policy dan keputusan rilis
Error budget tanpa kebijakan hanyalah dashboard yang tidak ditindaklanjuti siapa pun. Contoh error budget policy dalam SRE workbook menjelaskan apa yang terjadi ketika budget habis, dan siapa yang sudah menyetujuinya sejak awal.
Kebijakan yang umum memuat empat bagian:
- Pemicu. Layanan telah melampaui error budget dalam jendela bergulir.
- Konsekuensi. Rilis fitur dihentikan, kecuali perbaikan keamanan dan perubahan yang meningkatkan keandalan, sampai layanan kembali memenuhi SLO.
- Jalur pengecualian. Insiden tunggal yang disebabkan dependensi di luar kendali tim boleh dikecualikan, asalkan keputusannya didokumentasikan.
- Eskalasi. Perbedaan pendapat dibawa ke peran yang sudah ditentukan, misalnya CTO, bukan diputuskan oleh pihak yang paling keras bersuara.
Kebijakan ini ditandatangani oleh tim produk dan engineering sebelum pelanggaran pertama terjadi. Justru di situlah nilainya: pembekuan rilis menjadi aturan yang sudah disepakati, bukan perdebatan di tengah insiden. Pewawancara juga sering menanyakan kebalikannya, yaitu apa yang terjadi jika budget hampir tidak pernah terpakai. Jawaban yang diharapkan: SLO mungkin terlalu longgar, atau tim merilis terlalu hati-hati, sehingga budget sebaiknya dipakai untuk rilis yang lebih cepat atau migrasi yang lebih berani.
Menyamakan SLO internal dengan SLA pelanggan tidak menyisakan margin: pelanggaran SLO pertama langsung berarti penalti kontrak. SLO harus lebih ketat daripada SLA, agar alert menyala dan pembekuan rilis dimulai selagi kontrak masih terpenuhi.
Mengurangi toil, mengelola on-call, dan postmortem blameless
Waktu seorang SRE terbagi antara operasional dan engineering. Operasional mencakup on-call, tiket, dan intervensi manual. Engineering mencakup otomatisasi, perencanaan kapasitas, dan fitur keandalan. Ketika toil melampaui batas 50%, tim SRE mengembalikan sebagian pekerjaan ke tim pengembang atau berinvestasi pada otomatisasi. Tanpa langkah tersebut, tim SRE hanya akan menjadi tim operasional dengan nama jabatan baru.
Kesehatan on-call diukur, bukan diasumsikan. Sinyal yang berguna antara lain jumlah page per shift, persentase page yang benar-benar membutuhkan tindakan, dan waktu hingga page diakui (time to acknowledge). Page yang tidak memerlukan tindakan adalah bug pada sistem alerting dan harus diperbaiki atau dihapus. Alert berbasis gejala pada burn rate SLO, seperti aturan di atas, menurunkan volume page secara signifikan dibanding alert pada CPU, memori, atau restart pod individual.
Ketika insiden terjadi, bab tentang budaya postmortem dalam buku SRE menjelaskan tinjauan yang mengikutinya. Postmortem mencatat dampak dalam satuan SLO (berapa banyak budget yang terpakai), kronologi kejadian, faktor-faktor penyebab, serta action item lengkap dengan penanggung jawab dan tenggat waktu. Dokumen ini tidak menyebut seseorang sebagai penyebab. Dua pertanyaan lanjutan sering muncul. Bagaimana memastikan action item benar-benar dikerjakan? Lacak di backlog yang sama dengan fitur dan tinjau dalam rapat rutin. Kapan postmortem wajib dibuat? Untuk setiap insiden yang menghabiskan porsi budget yang signifikan, setiap page yang membangunkan seseorang, dan setiap kehilangan data.
Empat golden signal dari buku SRE, yaitu latensi, trafik, error, dan saturasi, melengkapi gambaran monitoring. Latensi dan error biasanya menjadi SLI. Trafik dan saturasi lebih berguna untuk perencanaan kapasitas dan dashboard, bukan untuk page.
Pertanyaan wawancara SRE beserta jawaban yang diharapkan
Berikut pertanyaan yang hampir selalu muncul dalam proses rekrutmen SRE dan senior DevOps, beserta inti jawaban yang kuat. Modul wawancara prinsip SRE melatih topik yang sama secara lebih mendalam, sementara modul alerting dan incident response membahas sisi on-call.
T: Apa perbedaan antara SLI, SLO, dan SLA?
SLI adalah rasio yang diukur, SLO adalah target internal untuk rasio tersebut dalam sebuah jendela waktu, dan SLA adalah kontrak eksternal yang memiliki penalti. SLO dibuat lebih ketat daripada SLA agar tim bereaksi sebelum ada kerugian finansial.
T: Mengapa SLO tidak ditetapkan 100%?
Karena setiap perubahan membawa risiko, sehingga target 100% secara efektif melarang rilis. Pengguna juga tidak bisa merasakan keandalan yang melebihi keandalan jaringan mereka sendiri. Celah di bawah 100% adalah error budget, dan budget itulah yang mendanai rilis.
T: Rancang SLO untuk API checkout.
Jawaban yang kuat memilih dua SLI (ketersediaan tanpa menghitung 4xx sebagai gagal, dan latensi di bawah ambang batas, keduanya diukur di load balancer), jendela bergulir 30 hari, target berdasarkan data kuartal terakhir, lalu menjelaskan bagaimana alerting dan error budget policy diturunkan dari SLO tersebut. Jawaban lemah yang klasik hanya menyebut "uptime 99,99%" tanpa menjelaskan apa yang diukur.
T: Mengapa alert berbasis persentil seperti p99 latensi kurang cocok sebagai alert SLO?
p99 dalam jendela pendek sangat berisik dan tidak dapat diagregasi lintas instance. Mengubah latensi menjadi rasio request di bawah ambang batas membuatnya bisa dijumlahkan, sebanding dengan SLI ketersediaan, dan kompatibel dengan alert burn rate.
T: Jelaskan burn rate dan alasan alert memakai dua jendela.
Burn rate adalah rasio error yang teramati dibagi fraksi budget. Nilai 1 berarti budget habis tepat di akhir jendela. Jendela panjang menyaring lonjakan singkat, sedangkan jendela pendek membuat alert cepat padam setelah layanan pulih.
T: Apa itu toil dan bagaimana mengendalikannya?
Pekerjaan manual dan berulang yang bisa diotomatisasi, tidak memberi nilai jangka panjang, dan bertambah seiring skala layanan. Toil diukur, dibatasi (Google memakai angka 50%), lalu dikurangi melalui otomatisasi atau dengan mengembalikan pekerjaan ke tim pemilik layanan.
T: Apa yang membuat postmortem disebut blameless?
Postmortem berfokus pada kondisi sistem yang memungkinkan kegagalan, mengasumsikan setiap orang bertindak wajar berdasarkan informasi yang dimiliki saat itu, dan menghasilkan action item yang dilacak. Ujiannya sederhana: apakah engineer yang terlibat berani menceritakan setiap detail tanpa rasa takut?
Pertanyaan monitoring biasanya menyusul setelah pertanyaan SLO dalam wawancara yang sama. Panduan pertanyaan wawancara Prometheus membahas PromQL, tipe metrik, dan kardinalitas, sedangkan halaman teknologi DevOps mencantumkan seluruh modul untuk persiapan yang lebih luas.
Ringkasan: SLO dan error budget dalam praktik
- Definisikan setiap SLI sebagai rasio event baik terhadap event valid, diukur sedekat mungkin dengan pengguna, dan untuk sebagian besar API jangan hitung 4xx sebagai kegagalan
- Tentukan SLO dari data historis dengan jendela bergulir 28 atau 30 hari, dan pastikan selalu lebih ketat daripada SLA pelanggan
- Konversikan target menjadi budget dalam menit atau jumlah request, dan hafalkan angkanya: 99,9% selama 30 hari setara 43 menit
- Pasang alert pada burn rate dengan pasangan jendela (14,4 pada 1 jam dan 5 menit, 6 pada 6 jam dan 30 menit), bukan pada error rate mentah atau CPU
- Gunakan Sloth atau alat serupa begitu lebih dari dua atau tiga layanan memiliki SLO, agar ambang batas tetap konsisten
- Tulis dan tandatangani error budget policy sebelum pelanggaran pertama, termasuk aturan pembekuan rilis dan jalur eskalasi
- Lacak toil, volume page, dan action item postmortem dengan disiplin yang sama seperti pengembangan fitur
Mulai berlatih!
Uji pengetahuan Anda dengan simulator wawancara dan tes teknis kami.
Bisakah kamu menemukan bug di DevOps?
Satu potongan kode nyata, satu bug tersembunyi, satu percobaan per hari. Tanpa akun untuk mencoba.

Ditulis oleh
Anthony Fillion-MailletPendiri SharpSkill
Developer fullstack selama lebih dari 10 tahun. Ia menjalankan SharpSkill dan bertanggung jawab atas semua yang diterbitkan di sini.
Diperbarui 7 November 2026
Tag
Bagikan
Artikel terkait

Pertanyaan Wawancara Prometheus 2026: Perbandingan Prometheus vs Grafana vs Datadog
Pertanyaan wawancara Prometheus untuk posisi DevOps dan SRE, lengkap dengan jawaban seputar PromQL, tipe metrik, cardinality dan HA, serta perbandingan Prometheus vs Grafana vs Datadog dari sisi arsitektur, alerting dan harga.
Lowongan DevOps Engineer 2026: Tempat Mencari, Kisaran Gaji, Cara Mempersiapkan Diri
Panduan lengkap mencari lowongan DevOps engineer di tahun 2026 mencakup platform pencarian kerja terbaik, data gaji terkini, dan strategi persiapan wawancara yang efektif.
Keamanan Pipeline DevOps 2026: Praktik Terbaik DevSecOps dan Pertanyaan Wawancara
Panduan lengkap tentang keamanan pipeline DevOps di tahun 2026, mencakup praktik terbaik DevSecOps, implementasi CI/CD yang aman, dan pertanyaan wawancara teknis untuk persiapan karir.