RAG dan LLM di 2026: Retrieval-Augmented Generation untuk Wawancara Data Science
Retrieval-Augmented Generation (RAG) dijelaskan untuk wawancara data science pada 2026. Membahas basis data vektor, strategi chunking, model embedding, agentic RAG, Graph RAG, kepatuhan EU AI Act, dan arsitektur pipeline siap produksi.
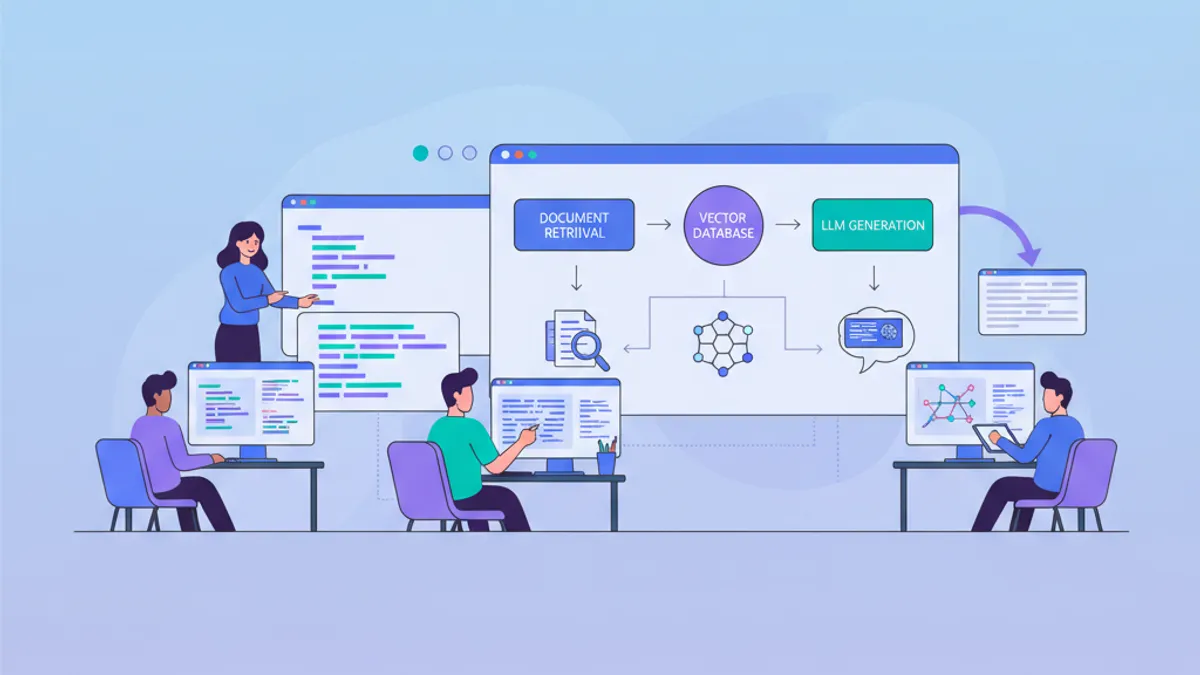
Retrieval-Augmented Generation (RAG) telah menjadi arsitektur standar untuk mengaitkan keluaran LLM ke data yang faktual dan terkini. Untuk wawancara data science dan AI engineering pada 2026, pertanyaan RAG kini muncul berdampingan dengan topik ML tradisional, menguji baik pemikiran perancangan sistem maupun keterampilan implementasi langsung.
Retrieval-Augmented Generation menggabungkan sistem pengambilan (pencarian vektor pada basis pengetahuan) dengan generator LLM, sehingga model menjawab berdasarkan dokumen nyata alih-alih mengandalkan data pelatihan yang dihafal.
Cara Kerja Pipeline RAG dari Awal hingga Akhir
Sistem RAG bekerja dalam dua fase: fase ingesti offline yang membangun basis pengetahuan, dan fase kueri online yang mengambil konteks relevan lalu menghasilkan jawaban.
Selama ingesti, dokumen mentah melewati pembersihan, chunking, dan embedding sebelum disimpan di basis data vektor. Selama inferensi, kueri pengguna mengikuti jalur embedding yang sama, dan pencarian tetangga terdekat mengambil potongan paling relevan. Potongan-potongan ini menjadi bagian dari prompt LLM, mengaitkan jawaban yang dihasilkan ke materi sumber.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Pipeline ini mencakup lingkaran inti RAG: chunk, embed, simpan, ambil, hasilkan. Parameter search_type="mmr" memastikan potongan yang diambil sekaligus relevan dan beragam, mengurangi redundansi pada jendela konteks.
Strategi Chunking yang Benar-Benar Penting
Chunking menentukan kualitas pengambilan lebih daripada komponen lain mana pun. Chunking yang buruk berarti retriever mengembalikan fragmen yang entah kekurangan konteks atau mengencerkan sinyal dengan konten yang tidak relevan.
Tiga pendekatan chunking mendominasi sistem produksi pada 2026:
Chunking ukuran tetap memecah teks pada jumlah token yang ditentukan (biasanya 256 hingga 512 token) dengan tumpang tindih (overlap). Sederhana untuk diterapkan, tetapi memotong kalimat dan gagasan di tengah jalan.
Chunking semantik mendeteksi batas topik dengan mengukur kemiripan embedding antar kalimat berurutan. Ketika kemiripan turun di bawah ambang batas, potongan baru dimulai. Setiap potongan membawa satu gagasan yang utuh, bukan irisan teks yang acak.
Late chunking menerapkan model transformer ke seluruh dokumen terlebih dahulu, menghasilkan embedding token kontekstual, lalu memecahnya menjadi potongan. Ini mempertahankan dependensi jangka panjang yang dirusak oleh chunking tradisional.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Wawasan wawancara yang penting: ukuran potongan adalah kompromi precision-recall. Potongan kecil (100 token) meningkatkan presisi pengambilan tetapi memfragmentasi konteks. Potongan besar (1000 token) mempertahankan konteks tetapi mengencerkan spesifisitas embedding. Sebagian besar sistem produksi berhenti di 256 hingga 512 token dengan tumpang tindih 10 hingga 20%.
Basis Data Vektor dan Model Embedding di Produksi
Basis data vektor menyimpan embedding dan mendukung pencarian approximate nearest-neighbor (ANN) yang cepat. Memilih kombinasi model embedding dan basis data vektor yang tepat berdampak langsung pada latensi dan akurasi pengambilan.
Model embedding pada 2026 telah mengerucut ke beberapa opsi berkinerja tinggi. text-embedding-3-large dari OpenAI (3072 dimensi) dan alternatif open-source seperti bge-m3 dari BAAI atau embed-v4 dari Cohere menawarkan pengambilan multibahasa yang kuat. Papan peringkat MTEB tetap menjadi tolok ukur standar untuk membandingkan kualitas embedding. Perlu dicatat bahwa text-embedding-3-large mendukung Matryoshka representation learning, memungkinkan pemotongan dimensi (ke 1024 atau 256) dengan kehilangan kualitas minimal, sehingga memangkas biaya penyimpanan secara signifikan.
Pasar basis data vektor telah terkonsolidasi pada 2026. Empat produk menguasai sebagian besar beban kerja RAG produksi:
| Basis Data | Pengindeksan | Terkelola | Keunggulan |
|---|---|---|---|
| Pinecone | Proprietari | Ya | Tanpa operasi, inferensi bawaan, pencarian hibrida |
| Weaviate | HNSW | Ya/Mandiri | Fusi BM25 + dense native dalam satu kueri |
| Qdrant | HNSW | Ya/Mandiri | Performa Rust, penyaringan payload, tier gratis terbaik |
| pgvector | IVF, HNSW | Mandiri | Integrasi PostgreSQL untuk stack yang sudah ada |
Untuk diskusi wawancara, poin krusialnya adalah memahami algoritma HNSW (Hierarchical Navigable Small World): ia membangun graf berlapis-lapis di mana setiap simpul terhubung ke tetangga terdekatnya, memungkinkan pencarian O(log n) dengan biaya penggunaan memori yang lebih tinggi.
Titik impas biaya adalah 60 hingga 80 juta kueri per bulan. Di atas angka ini, Qdrant atau Weaviate yang di-host sendiri pada infrastruktur biaya tetap secara konsisten lebih murah dari Pinecone Serverless sebesar 3x hingga 10x.
Siap menguasai wawancara Data Science & ML Anda?
Berlatih dengan simulator interaktif, flashcards, dan tes teknis kami.
Pengambilan Hibrida: Menggabungkan Pencarian Padat dan Jarang
Pencarian vektor murni gagal pada pencocokan kata kunci yang tepat dan istilah langka. Pencarian leksikal murni (BM25) melewatkan kemiripan semantik. Pengambilan hibrida menggabungkan keduanya, dan pada 2026 ini adalah default untuk sistem RAG produksi.
Pola standar menggunakan Reciprocal Rank Fusion (RRF) untuk menggabungkan hasil terperingkat dari kedua retriever:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Pengambilan hibrida menyelesaikan masalah "ketidakcocokan kosakata" ketika pengguna bertanya tentang "membatalkan langganan" tetapi dokumen relevan menggunakan istilah "kebijakan penghentian akun". BM25 menangkap tumpang tindih istilah yang tepat sementara pencarian vektor menangkap hubungan semantiknya.
Reranking: Filter Tahap Kedua
Pengambilan mengembalikan kandidat. Reranking menyortir mereka berdasarkan relevansi sebenarnya. Reranker cross-encoder seperti Cohere Rerank atau bge-reranker-v2.5-gemma2-lightweight memberi skor pada setiap pasangan kueri-dokumen secara bersamaan, menghasilkan skor relevansi yang jauh lebih akurat daripada kemiripan bi-encoder.
Pipeline pengambilan dua tahap (recall tahap pertama yang luas dengan 50 hingga 100 kandidat teratas via vektor + BM25, lalu reranking presisi ke 5 hingga 10 teratas untuk prompt) adalah standar di produksi. Ini menjaga latensi tetap terkendali: tahap pertama menggunakan pencarian ANN yang cepat, sementara cross-encoder yang mahal hanya memproses kumpulan kandidat kecil.
Cross-encoder lebih akurat daripada bi-encoder karena memproses kueri dan dokumen bersama-sama melalui semua lapisan transformer. Bi-encoder meng-embed keduanya secara independen, kehilangan sinyal interaksi yang halus. Komprominya adalah kecepatan: cross-encoder tidak dapat dipra-indeks.
Adaptive RAG: Merutekan Kueri ke Pipeline yang Tepat
Tidak setiap kueri membutuhkan kompleksitas pengambilan yang sama. Adaptive RAG melatih classifier kecil untuk merutekan setiap pertanyaan ke jalur optimal:
- Tanpa pengambilan untuk kueri faktual sederhana yang sudah diketahui model
- Pengambilan satu langkah untuk kueri tingkat menengah
- Pengambilan iteratif multi-langkah untuk penalaran kompleks
Pola ini menyeimbangkan biaya dan akurasi di berbagai beban kerja. Sistem produksi yang menangani 100.000 kueri per hari dapat memangkas biaya inferensi sebesar 40% dengan merutekan pertanyaan sederhana menjauhi pipeline multi-langkah yang mahal.
Classifier itu sendiri bisa berupa model kecil yang di-fine-tune atau prompt zero-shot yang menanyakan: "Apakah pertanyaan ini memerlukan pengetahuan eksternal untuk dijawab secara akurat?"
Speculative RAG: Menukar Latensi dengan Kecepatan
Speculative RAG menjalankan pengambilan secara paralel dengan pembuatan draf cepat. Jika draf menunjukkan keyakinan tinggi (diukur dengan logprob), langkah pengambilan dilewati sepenuhnya. Jika keyakinan rendah, konteks yang diambil digabungkan dengan draf dan regenerasi terjadi.
Pendekatan ini memangkas latensi rata-rata sebesar 30 hingga 40% pada kueri dengan keyakinan tinggi. Ini paling cocok untuk chatbot real-time, saran autocomplete, dan sistem layanan pelanggan di mana waktu respons lebih penting daripada penyertaan sumber yang menyeluruh pada setiap kueri.
Komprominya: speculative RAG kadang mengembalikan jawaban tanpa grounding ketika model terlalu percaya diri. Sistem produksi memasangkannya dengan kalibrasi kepercayaan dan fallback ke pengambilan penuh ketika ketidakpastian melebihi ambang batas.
Agentic RAG: Melampaui Pengambilan Sekali Tembak
RAG naif mengambil sekali lalu menghasilkan. Agentic RAG memperlakukan LLM sebagai agen penalar yang memutuskan kapan harus mengambil, apa yang harus diambil, dan apakah konteks yang diambil sudah cukup.
Pada 2026, agentic RAG adalah pola dominan untuk kueri kompleks yang memerlukan penalaran multi-langkah. Agen dapat:
- Menilai diri: Mengevaluasi apakah dokumen yang diambil menjawab pertanyaan
- Mengueri ulang: Merumuskan ulang kueri pencarian jika hasil awal tidak memadai
- Merutekan (routing): Memilih di antara berbagai sumber pengetahuan (vektor DB, basis data SQL, API)
- Memverifikasi: Memeriksa silang fakta di beberapa bagian yang diambil
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Pola ini (ambil, nilai, opsional rumuskan ulang dan coba lagi) dikenal sebagai Corrective RAG (CRAG). Perlu dicatat bahwa AgentExecutor LangChain sudah deprecated sejak 2026; proyek baru sebaiknya menggunakan create_react_agent() untuk pola bawaan atau StateGraph LangGraph untuk orkestrasi kustom. Untuk pembahasan lebih mendalam tentang pola LangChain untuk data scientist, lihat artikel khususnya.
Graph RAG: Pengambilan Pengetahuan Terstruktur
Graph RAG mengekstrak entitas dan hubungan dari dokumen ke dalam graf pengetahuan, lalu mengueri graf maupun penyimpanan vektor. Arsitektur ini mengurangi halusinasi pada kueri faktual dengan mengaitkan jawaban ke hubungan entitas yang eksplisit alih-alih kemiripan teks yang tidak terstruktur.
Pipeline ingesti mengekstrak triple (subjek, predikat, objek) dari setiap potongan dokumen. Pada waktu kueri, sistem mengidentifikasi entitas relevan dalam pertanyaan, menelusuri graf pengetahuan untuk fakta yang terhubung, dan menggabungkan konteks dari graf dengan bagian yang diambil secara vektor.
Graph RAG unggul pada pertanyaan penalaran multi-hop seperti "Tim mana yang memimpin proyek yang menggunakan framework yang disebutkan dalam dokumen X?" Kueri seperti ini memerlukan penghubungan fakta lintas beberapa dokumen, sesuatu yang sulit bagi pencarian vektor murni karena tidak ada satu potongan pun yang berisi jawaban lengkap.
Graph RAG secara signifikan meningkatkan akurasi faktual (pengurangan halusinasi hingga 40% pada kueri yang padat entitas) tetapi memerlukan pipeline ekstraksi entitas yang matang. Ekstraksi yang berisik menghasilkan graf yang berisik, yang dapat menurunkan hasil di bawah RAG naif. Perlu dicatat juga bahwa proyek GraphRAG Microsoft memasuki mode pemeliharaan pada 2026; ia akan menerima perbaikan bug tetapi tidak ada fitur baru.
Varian LazyGraphRAG dari Microsoft (dirilis Juni 2025) mengurangi biaya pengindeksan secara dramatis dengan menunda ringkasan hingga waktu kueri, menjadikannya cocok untuk analisis eksploratif atau data streaming di mana konstruksi graf di muka tidak praktis.
Kepatuhan EU AI Act untuk Sistem RAG
EU AI Act mulai berlaku secara luas pada Agustus 2026. Denda profil tinggi pertama di bawah Undang-Undang ini mengenai chatbot RAG konsorsium perbankan Eropa pada akhir Mei 2026, dan sebuah perusahaan manajemen kekayaan Frankfurt menerima penalti EUR 4,5 juta pada April 2026 untuk sistem RAG yang melayani klien yang gagal menjelaskan provenance data.
Arsitektur RAG secara alami memenuhi beberapa persyaratan kepatuhan: ketertelusuran sumber (potongan membawa referensi dokumen), transparansi jawaban (sitasi dapat ditampilkan), dan auditabilitas (log pengambilan ada secara bawaan). Namun, kepatuhan penuh memerlukan langkah-langkah tambahan:
Klasifikasi risiko: Chatbot publik termasuk dalam risiko terbatas (transparansi diperlukan). Sistem RAG medis atau hukum adalah risiko tinggi dengan kewajiban dokumentasi dan pengawasan yang lebih ketat.
Audit logging: Catat pertanyaan mana yang memicu potongan mana yang diambil dan jawaban mana yang dihasilkan. Log ini menjadi dasar ketertelusuran yang diperlukan.
Pengawasan manusia: Sistem risiko tinggi memerlukan validasi manusia pada kasus sensitif, kemampuan untuk mengoreksi output, dan mekanisme untuk menghapus data yang diindeks atas permintaan.
Residensi data: Host pengindeksan di EU dan gunakan BYOK (Bring Your Own Key) untuk memastikan data tidak transit melalui akun pihak ketiga di luar yurisdiksi.
Ketidakpatuhan dapat menelan biaya 7% dari pendapatan tahunan global. Untuk diskusi wawancara, poin pentingnya adalah bahwa kapabilitas sitasi bawaan RAG adalah keuntungan, tetapi tidak menggantikan lapisan tata kelola.
Mengevaluasi Sistem RAG: Metrik yang Penting
Evaluasi RAG terbagi menjadi metrik pengambilan dan metrik generasi. Keduanya harus diukur secara independen untuk mendiagnosis kegagalan.
Metrik pengambilan:
- Recall@k: Apakah dokumen relevan muncul di k hasil teratas?
- MRR (Mean Reciprocal Rank): Seberapa tinggi peringkat hasil relevan pertama?
- NDCG: Apakah peringkatnya cocok dengan urutan relevansi ideal?
Metrik generasi:
- Faithfulness: Apakah jawaban hanya menggunakan informasi dari konteks yang diambil? (Mengukur halusinasi)
- Relevansi jawaban: Apakah jawaban menjawab pertanyaan asli?
- Presisi konteks: Apakah potongan yang diambil benar-benar digunakan dalam jawaban?
Framework seperti Ragas dan DeepEval mengotomatiskan evaluasi ini menggunakan pola LLM-as-judge. Pertanyaan wawancara data science teratas semakin sering mencakup desain evaluasi RAG, jadi bersiaplah menjelaskan cara mengukur apakah sistem RAG bekerja dengan benar.
Mode Kegagalan Produksi dan Debugging
Sistem RAG gagal dengan cara yang dapat diprediksi. Mengetahui pola-pola ini penting baik untuk wawancara maupun penerapan dunia nyata.
Polusi jendela konteks terjadi ketika terlalu banyak potongan yang diambil mengencerkan sinyal relevan. LLM menerima 10 potongan tetapi hanya 2 yang berisi informasi berguna. Solusinya: gunakan reranker untuk menyaring, dan kurangi top-k dari retriever.
Artefak chunking muncul ketika pemisahan ukuran tetap memutus kalimat, tabel, atau blok kode di tengah elemen. Potongan yang diambil tidak lengkap secara sintaksis dan tidak berguna secara semantik. Chunking semantik atau pemisahan yang sadar-dokumen (menghormati heading, paragraf, code fence) menyelesaikan ini.
Embedding drift muncul ketika model embedding diperbarui tetapi penyimpanan vektor masih berisi embedding dari model lama. Kueri yang dikodekan dengan model baru mencari di ruang vektor yang dibangun oleh model lama, menurunkan kualitas pengambilan. Solusi: embed ulang seluruh korpus setelah setiap perubahan model.
Indeks usang memberikan informasi yang ketinggalan zaman karena pipeline ingesti tertinggal dari pembaruan dokumen. Dalam sistem machine learning, ini analog dengan training-serving skew, di mana sistem pengambilan melihat distribusi data yang berbeda dari yang ada di produksi.
Sumber
- Turing Post: 20 Advanced RAG Types to Know in 2026 - taksonomi komprehensif pola RAG
- LangChain and LangGraph 1.0 Milestones - deprecation AgentExecutor, pola baru
- Microsoft GraphRAG GitHub - status mode pemeliharaan
- IgnitionRAG EU AI Act Guide - persyaratan kepatuhan untuk sistem RAG
- MarkTechPost: Best Vector Databases in 2026 - konsolidasi pasar dan harga
Mulai berlatih!
Uji pengetahuan Anda dengan simulator wawancara dan tes teknis kami.
Poin Penting RAG untuk Wawancara Data Science
- RAG menggabungkan pengambilan (pencarian vektor pada basis pengetahuan) dengan generasi LLM untuk menghasilkan jawaban faktual yang berlandaskan tanpa melatih ulang model
- Strategi chunking memiliki dampak tertinggi pada kualitas pengambilan; chunking semantik dan late chunking mengungguli pemisahan ukuran tetap untuk sebagian besar kasus penggunaan
- Pengambilan hibrida (vektor padat + BM25 jarang) dengan Reciprocal Rank Fusion adalah default produksi, menyelesaikan masalah ketidakcocokan kosakata yang tidak dapat ditangani pencarian vektor murni
- Reranker cross-encoder menambahkan lapisan presisi setelah pengambilan luas, memproses hanya kumpulan kandidat kecil agar latensi tetap dapat diterima
- Adaptive RAG merutekan kueri ke kompleksitas pipeline yang tepat, memangkas biaya sebesar 40% pada beban kerja campuran
- Speculative RAG menukar grounding dengan kecepatan, memangkas latensi sebesar 30 hingga 40% pada kueri dengan keyakinan tinggi
- Agentic RAG (ambil, nilai, rumuskan ulang, coba lagi) dan Graph RAG (ekstraksi hubungan entitas) menangani kueri multi-hop kompleks yang gagal ditangani RAG naif
- Kepatuhan EU AI Act (Agustus 2026) memerlukan audit logging, pengawasan manusia, dan klasifikasi risiko untuk sistem RAG produksi
- Evaluasi harus memisahkan metrik pengambilan (Recall@k, MRR) dari metrik generasi (faithfulness, relevansi jawaban) untuk mendiagnosis di mana pipeline rusak
- Kegagalan produksi paling umum (polusi konteks, artefak chunking, embedding drift, indeks usang) semuanya memiliki solusi sederhana setelah teridentifikasi
Bisakah kamu menemukan bug di Data Science & ML?
Satu potongan kode nyata, satu bug tersembunyi, satu percobaan per hari. Tanpa akun untuk mencoba.

Ditulis oleh
Anthony Fillion-MailletPendiri SharpSkill
Developer fullstack selama lebih dari 10 tahun. Ia menjalankan SharpSkill dan bertanggung jawab atas semua yang diterbitkan di sini.
Diperbarui 24 Agustus 2026
Tag
Bagikan
Artikel terkait
Feature Engineering untuk Machine Learning: Teknik dan Pertanyaan Wawancara 2026
Pelajari teknik feature engineering untuk machine learning dengan contoh Python praktis. Membahas encoding, scaling, seleksi fitur, pipeline scikit-learn, dan pertanyaan wawancara data science.
Pekerjaan Freelance Data Scientist 2026: Tempat Mencari Kontrak, Tarif Harian, dan Persiapan
Panduan lengkap untuk data scientist yang ingin bekerja secara freelance di tahun 2026: platform pencarian kontrak, tarif harian rata-rata, dan strategi persiapan wawancara teknis.
Lowongan Data Scientist 2026: Tempat Mencari, Kisaran Gaji, dan Cara Mempersiapkan Diri
Lowongan data scientist tetap menjadi posisi teknis yang paling dicari di tahun 2026. Artikel ini membahas di mana mencari lowongan, kisaran gaji, dan cara mempersiapkan wawancara secara efektif.