ETL vs ELT 2026: Arsitektur Data Pipeline dan Pertanyaan Interview
Pelajari perbedaan ETL vs ELT, arsitektur data pipeline modern, serta pertanyaan interview data engineering yang sering muncul di tahun 2026.
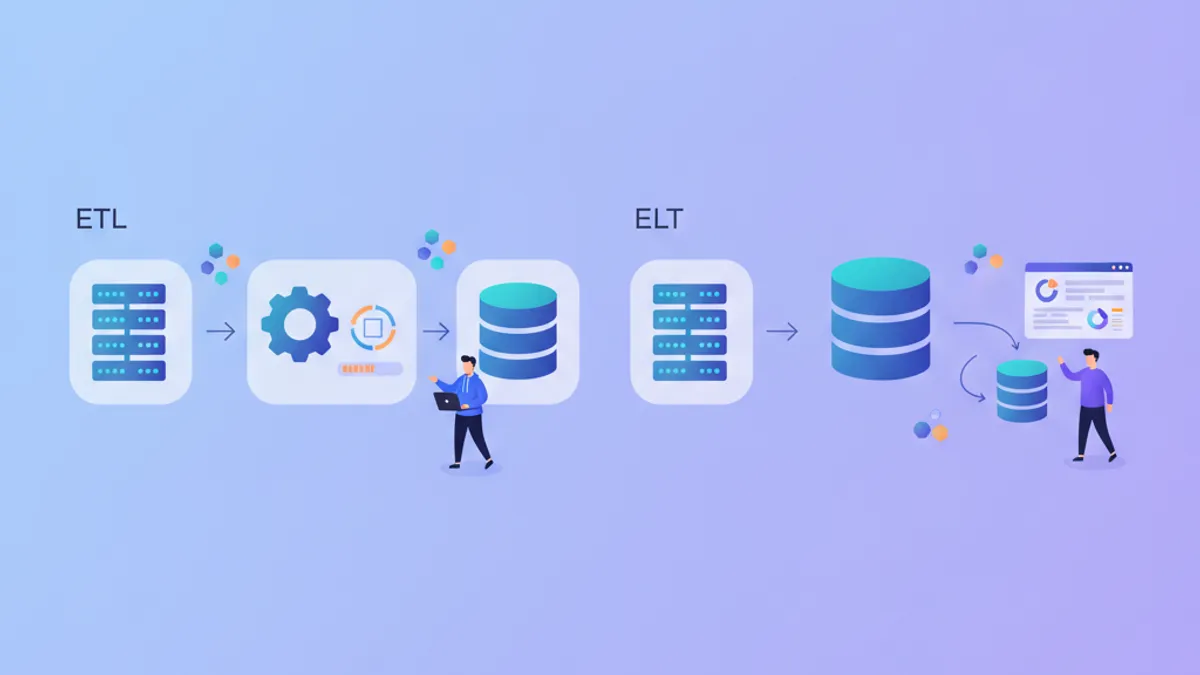
ETL dan ELT merupakan dua pendekatan fundamental dalam memindahkan data dari sistem sumber ke lingkungan analitik. Pilihan antara extract-transform-load (ETL) versus extract-load-transform (ELT) mempengaruhi biaya infrastruktur, kesegaran data, dan keahlian yang diperlukan dari tim engineering. Pemahaman mendalam tentang kedua arsitektur ini menjadi krusial bagi data engineer yang bekerja dengan data pipeline modern.
ETL mentransformasi data sebelum memuatnya ke sistem target, memerlukan sumber daya komputasi terpisah. ELT memuat data mentah terlebih dahulu, kemudian mentransformasinya menggunakan kekuatan pemrosesan warehouse tujuan. Sebagian besar data stack berbasis cloud pada 2026 memilih ELT karena kapasitas komputasi dapat diskalakan sesuai kebutuhan.
Arsitektur ETL: Transformasi Sebelum Loading
ETL muncul ketika data warehouse memiliki kapasitas komputasi terbatas dan penyimpanan mahal. Pola ini masuk akal pada masanya: filter dan agregasi data di luar warehouse, muat hanya yang diperlukan untuk analisis. Oracle Warehouse Builder, Informatica PowerCenter, dan Talend membangun tooling di sekitar model ini.
Tahap transformasi dalam ETL berjalan di server perantara. Data berpindah dari sumber ke area staging, dibersihkan dan dibentuk ulang, kemudian dimuat ke tujuan. Pendekatan ini mengurangi beban warehouse tetapi menciptakan bottleneck pada lapisan transformasi.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL bekerja dengan baik ketika logika transformasi stabil dan volume data tetap dapat diprediksi. Kelemahannya terlihat ketika kebutuhan berubah: memodifikasi transformasi berarti memproses ulang data historis dari awal.
Arsitektur ELT: Load Dulu, Transformasi di Warehouse
ELT memindahkan transformasi ke dalam data warehouse. Snowflake, BigQuery, Databricks, dan Redshift menyediakan komputasi yang hampir tidak terbatas dan dapat diskalakan sesuai kompleksitas query. Memuat data mentah terlebih dahulu mempertahankan state asli sumber; transformasi menjadi model SQL yang dapat diversi dan dijalankan ulang tanpa ekstraksi ulang.
Proyek dbt (data build tool) mempopulerkan ELT dengan memperlakukan transformasi SQL sebagai kode. Alih-alih pekerjaan ETL black-box, transformasi hidup dalam version control sebagai statement SELECT yang mereferensikan tabel mentah dan membangun model turunan.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT mempertahankan data mentah, yang memungkinkan pemrosesan ulang ketika logika bisnis berubah. Jika perhitungan salah enam bulan lalu, memperbaiki model dbt dan menjalankan full refresh akan mengoreksi data historis. Dengan ETL, perbaikan yang sama memerlukan ekstraksi ulang dari sumber yang mungkin sudah tidak memiliki record asli.
Tabel Perbandingan: Tradeoff ETL vs ELT
| Faktor | ETL | ELT |
|---|---|---|
| Lokasi komputasi | Server transformasi terpisah | Warehouse tujuan |
| Retensi data mentah | Sering dibuang setelah transformasi | Dipertahankan di landing zone |
| Biaya pemrosesan ulang | Ekstraksi ulang dari sumber | Jalankan ulang model SQL |
| Fleksibilitas skema | Tetap pada waktu transformasi | Schema-on-read dimungkinkan |
| Contoh tooling | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Cocok untuk | Kebutuhan stabil, sistem legacy | Kebutuhan berubah, cloud warehouse |
| Latensi | Lebih tinggi (transformasi sebelum load) | Lebih rendah (load lalu transformasi) |
| Data governance | Lebih mudah (data difilter sebelum warehouse) | Memerlukan kontrol level warehouse |
Siap menguasai wawancara Data Engineering Anda?
Berlatih dengan simulator interaktif, flashcards, dan tes teknis kami.
Pendekatan Hybrid: Ketika ETL dan ELT Digabungkan
Data stack modern jarang menggunakan ETL atau ELT murni. Apache Airflow mengorkestrasi pipeline yang mencampur kedua pola. Data sensitif mungkin dianonimkan sebelum loading (langkah ETL), sementara agregasi berjalan di warehouse (ELT).
Fivetran dan Airbyte mengekstrak dan memuat data mentah tanpa transformasi, kemudian dbt mentransformasi di dalam warehouse. Tetapi tool ini juga mendukung transformasi ringan selama ekstraksi: pemilihan kolom, koersi tipe data, hashing field PII. Hal ini mengaburkan batas ETL/ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Pipeline di atas mengekstrak dari Salesforce dengan Airbyte (yang dapat meng-hash alamat email selama sinkronisasi), memuat ke Snowflake, kemudian menjalankan model dbt untuk transformasi bisnis. Bukan ETL murni maupun ELT murni, tetapi praktis.
Pertanyaan Interview: ETL vs ELT untuk Data Engineer
Interview teknis untuk posisi data engineering di perusahaan yang menggunakan data stack modern menguji pemahaman arsitektur pipeline. Pertanyaan-pertanyaan ini sering muncul, berdasarkan pola dari modul persiapan interview ETL/ELT.
Pertanyaan 1: Kapan Memilih ETL Dibanding ELT?
Jawaban yang kuat mengidentifikasi skenario spesifik:
- Persyaratan compliance: GDPR atau HIPAA mengharuskan data tertentu tidak pernah mencapai warehouse dalam bentuk mentah. PII harus dianonimkan atau dihapus sebelum loading.
- Keterbatasan warehouse legacy: Sistem on-premises seperti Teradata atau konfigurasi Redshift lama dengan komputasi tetap mendapat manfaat dari load yang sudah diagregasi sebelumnya.
- Biaya jaringan: Memuat 10TB setiap hari ke cloud warehouse, kemudian membuang 90% setelah transformasi, membuang bandwidth egress. Pre-filtering lebih ekonomis.
Jawaban lemah mengatakan "ETL sudah ketinggalan zaman" atau gagal memberikan skenario konkret. Interviewer mencari nuansa.
Pertanyaan 2: Bagaimana Menangani Perubahan Skema dalam Pipeline ELT?
Pertanyaan ini menguji pemahaman tentang raw data landing zone. Topik yang diharapkan:
- Kolom JSON atau semi-terstruktur yang menyerap field baru tanpa migrasi skema
- Model staging yang secara eksplisit memilih kolom, mengisolasi model downstream dari perubahan sumber
- Macro dbt atau assersi Dataform yang menggagalkan build ketika kolom yang diharapkan hilang
- Monitoring untuk schema drift menggunakan tool seperti Monte Carlo atau Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Pertanyaan 3: Bandingkan Orkestrasi ETL dengan Airflow vs Menjalankan dbt untuk ELT
Pertanyaan ini menguji pemahaman bahwa tool ini memecahkan masalah berbeda:
- Airflow mengorkestrasi task: ekstraksi, panggilan API, transfer file, training model. Tool ini mengelola dependensi antar job heterogen.
- dbt mentransformasi data di dalam warehouse. Tool ini mengelola dependensi antar model SQL, menjalankan tes, menghasilkan dokumentasi.
Pipeline lengkap sering menggunakan keduanya: Airflow memicu sinkronisasi Airbyte, menunggu penyelesaian, kemudian memicu dbt run. Mengetahui kapan menggunakan tool mana membedakan kandidat senior.
Pertanyaan 4: Pipeline ELT Memproses 500M Baris Setiap Hari dan Analis Melaporkan Query Lambat
Pertanyaan terbuka ini menguji pemikiran diagnostik:
- Periksa materialisasi model: Apakah model berat masih berupa view? Model incremental atau tabel mungkin membantu.
- Partisi dan cluster: Untuk BigQuery, apakah tabel fakta dipartisi berdasarkan tanggal? Untuk Snowflake, apakah clustering dioptimalkan untuk pola query umum?
- Query pushdown: Apakah analis melakukan query ke model staging alih-alih mart yang sudah diagregasi?
- Ukuran warehouse: Apakah komputasi diskalakan dengan tepat selama jam query?
- Persyaratan freshness: Bisakah transformasi berjalan di malam hari alih-alih selama jam kerja?
Tidak ada satu jawaban benar. Interviewer mengevaluasi troubleshooting sistematis.
Lanskap Tooling pada 2026
Pasar integrasi data telah terkonsolidasi di sekitar beberapa pola:
Ekstraksi dan loading: Fivetran, Airbyte, Stitch, dan Meltano menangani bagian EL. Tool ini terhubung ke ratusan sumber dan menyinkronkan ke cloud warehouse tanpa kode kustom.
Transformasi: dbt mendominasi transformasi berbasis SQL. Alternatif termasuk Dataform (sekarang bagian dari Google Cloud), SQLMesh (open source dengan virtual data environment), dan Coalesce (visual modeling).
Orkestrasi: Airflow tetap menjadi default untuk pipeline kompleks. Dagster dan Prefect menawarkan alternatif dengan pengembangan lokal yang lebih baik dan tampilan asset-centric.
Kualitas: Great Expectations, tes dbt, Monte Carlo, dan Soda menyediakan monitoring kualitas data. Tool ini menangkap masalah antara ekstraksi dan konsumsi downstream.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Mulai berlatih!
Uji pengetahuan Anda dengan simulator wawancara dan tes teknis kami.
Memilih Arsitektur Pipeline untuk Proyek Baru
Untuk sebagian besar proyek greenfield pada 2026, ELT adalah default. Biaya komputasi cloud warehouse lebih murah daripada memelihara server transformasi. Preservasi data mentah memungkinkan perbaikan retroaktif. Transformasi berbasis SQL dapat diaudit dan dikontrol versinya.
ETL tetap relevan untuk:
- Lingkungan regulasi yang memerlukan minimisasi data sebelum masuk warehouse
- Streaming real-time di mana transformasi harus terjadi pada waktu ingesti (Kafka Streams, Flink)
- Skenario edge computing dengan penyimpanan downstream terbatas
- Integrasi legacy di mana sistem sumber mengontrol format ekspor
Jawaban yang siap interview mengakui kedua pola dan menjelaskan tradeoff tanpa preferensi ideologis.
Kesimpulan: Arsitektur Data Pipeline
- ETL mentransformasi data sebelum loading, mengurangi beban warehouse tetapi menciptakan friction pemrosesan ulang ketika logika berubah
- ELT memuat data mentah terlebih dahulu, memungkinkan transformasi berbasis SQL yang dapat diversi, diuji, dan dijalankan ulang terhadap data historis
- Stack modern biasanya menggabungkan keduanya: transformasi ekstraksi ringan (hashing PII, casting tipe) dengan agregasi berbasis warehouse
- dbt telah menjadi standar untuk transformasi ELT, memperlakukan model SQL sebagai kode yang dapat diuji dan didokumentasikan
- Pertanyaan interview menguji pemilihan skenario, penanganan evolusi skema, dan tradeoff tooling daripada definisi hafalan
- Preservasi data mentah dalam pipeline ELT memungkinkan perbaikan perhitungan historis tanpa ekstraksi ulang dari sumber
Bisakah kamu menemukan bug di Data Engineering?
Satu potongan kode nyata, satu bug tersembunyi, satu percobaan per hari. Tanpa akun untuk mencoba.

Ditulis oleh
Anthony Fillion-MailletPendiri SharpSkill
Developer fullstack selama lebih dari 10 tahun. Ia menjalankan SharpSkill dan bertanggung jawab atas semua yang diterbitkan di sini.
Diperbarui 14 September 2026
Bagikan
Artikel terkait
Great Expectations 2026: Validasi Kualitas Data dan Pertanyaan Wawancara
Panduan lengkap framework Great Expectations 1.22 untuk validasi kualitas data dalam pipeline Python, termasuk integrasi Airflow dan pertanyaan wawancara data engineering.

Apache Beam vs Spark 2026: Perbandingan Pipeline Terpadu dan Pertanyaan Interview
Panduan lengkap membandingkan Apache Beam 2.76 dan Spark 4.2 untuk data engineering. Pelajari perbedaan arsitektur, windowing, performa, dan pertanyaan interview yang sering muncul.

Apache Flink 2026: Pemrosesan Stream, Event Time, dan Pertanyaan Interview
Pelajari Apache Flink 2.3 untuk pemrosesan stream dengan semantik event time, watermark, dan windowing. Panduan lengkap dengan pertanyaan interview dan contoh kode produksi.