RAG y LLMs en 2026: Retrieval-Augmented Generation para Entrevistas de Data Science
Retrieval-Augmented Generation (RAG) explicado para entrevistas de data science en 2026. Bases vectoriales, chunking, embeddings, RAG agéntico, Graph RAG y cumplimiento del EU AI Act.
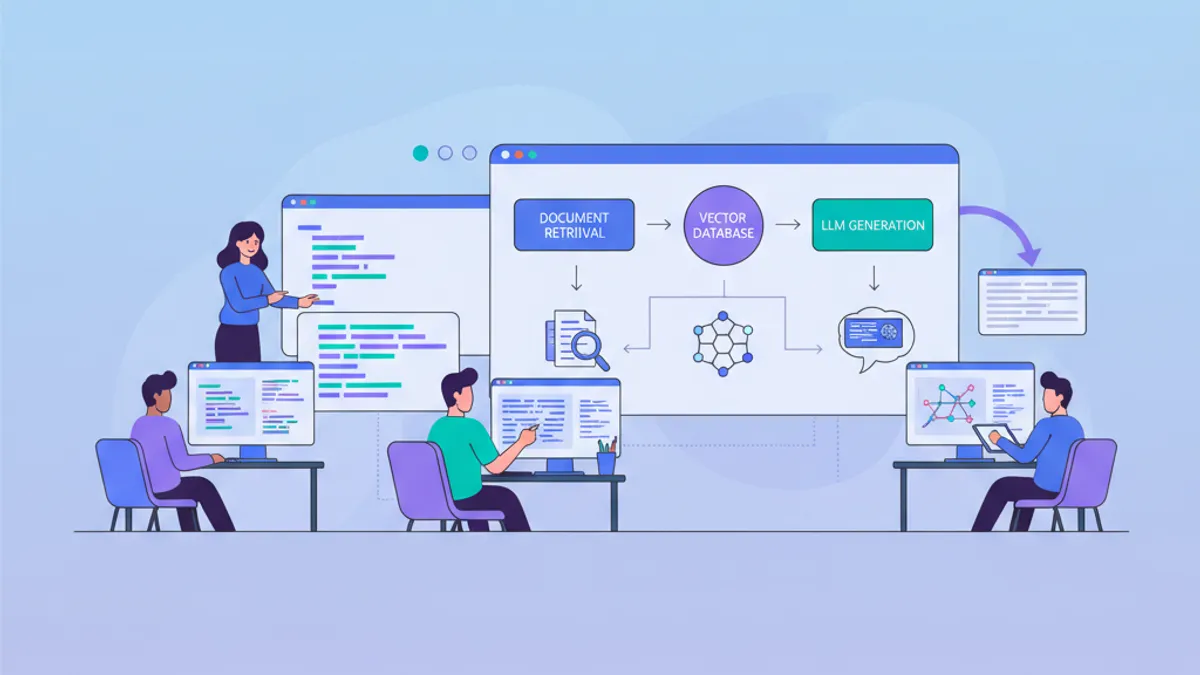
Retrieval-Augmented Generation (RAG) se ha convertido en la arquitectura estándar para fundamentar las salidas de LLMs en datos actualizados y factuales. En las entrevistas de data science e ingeniería de IA de 2026, las preguntas sobre RAG aparecen junto a los temas tradicionales de ML, evaluando tanto el pensamiento de diseño de sistemas como las habilidades de implementación práctica.
Retrieval-Augmented Generation combina un sistema de recuperación (búsqueda vectorial sobre una base de conocimientos) con un generador LLM, de modo que el modelo responde a partir de documentos reales en lugar de depender de datos memorizados durante el entrenamiento.
Cómo funciona el pipeline RAG de principio a fin
Un sistema RAG opera en dos fases: una fase de ingesta offline que construye la base de conocimientos, y una fase de consulta online que recupera contexto relevante y genera una respuesta.
Durante la ingesta, los documentos crudos pasan por limpieza, chunking y embedding antes de almacenarse en una base de datos vectorial. Durante la inferencia, la consulta del usuario sigue el mismo camino de embedding, y la búsqueda de vecinos más cercanos recupera los chunks más relevantes. Estos chunks se convierten en parte del prompt del LLM, fundamentando la respuesta generada en material fuente.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Este pipeline cubre el ciclo RAG básico: fragmentar, codificar, almacenar, recuperar y generar. El parámetro search_type="mmr" asegura que los chunks recuperados sean tanto relevantes como diversos, reduciendo la redundancia en la ventana de contexto.
Estrategias de chunking que realmente importan
El chunking determina la calidad de recuperación más que cualquier otro componente. Un mal chunking significa que el retriever devuelve fragmentos que carecen de contexto o diluyen la señal con contenido irrelevante.
Tres enfoques de chunking dominan los sistemas de producción en 2026:
Chunking de tamaño fijo divide el texto en un conteo de tokens establecido (típicamente de 256 a 512 tokens) con solapamiento. Simple de implementar, pero corta oraciones e ideas a mitad de pensamiento.
Chunking semántico detecta límites de tema midiendo la similitud de embedding entre oraciones consecutivas. Cuando la similitud cae por debajo de un umbral, comienza un nuevo chunk. Cada chunk contiene una idea coherente en lugar de una porción arbitraria de texto.
Late chunking aplica primero el modelo transformer al documento completo, produciendo embeddings de tokens contextuales, y luego divide en chunks. Esto preserva dependencias de largo alcance que el chunking tradicional destruye.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
El punto clave para entrevistas: el tamaño de chunk es un trade-off entre precisión y recall. Los chunks pequeños (100 tokens) mejoran la precisión de recuperación pero fragmentan el contexto. Los chunks grandes (1000 tokens) preservan el contexto pero diluyen la especificidad del embedding. La mayoría de los sistemas de producción se sitúan entre 256 y 512 tokens con 10 a 20% de solapamiento.
Bases de datos vectoriales y modelos de embedding en producción
La base de datos vectorial almacena embeddings y soporta búsqueda rápida de vecinos más cercanos aproximados (ANN). La elección de la combinación correcta de modelo de embedding y base de datos vectorial impacta directamente la latencia y precisión de recuperación.
Los modelos de embedding en 2026 han convergido en unas pocas opciones de alto rendimiento. El text-embedding-3-large de OpenAI (3072 dimensiones) y alternativas open-source como bge-m3 de BAAI o embed-v4 de Cohere ofrecen recuperación multilingüe de calidad. El MTEB leaderboard sigue siendo el benchmark estándar para comparar la calidad de embeddings. El modelo text-embedding-3-large soporta aprendizaje de representación Matryoshka, permitiendo truncar dimensiones (a 1024 o 256) con pérdida mínima de calidad, reduciendo significativamente los costos de almacenamiento.
El mercado de bases de datos vectoriales se ha consolidado en 2026. Cuatro productos representan la gran mayoría de las cargas de trabajo RAG en producción:
| Database | Indexing | Managed | Strength |
|---|---|---|---|
| Pinecone | Proprietary | Yes | Zero-ops, inferencia integrada, búsqueda híbrida |
| Weaviate | HNSW | Yes/Self | Fusión nativa BM25 + dense en una consulta |
| Qdrant | HNSW | Yes/Self | Rendimiento Rust, filtrado de payload, mejor tier gratuito |
| pgvector | IVF, HNSW | Self | Integración PostgreSQL para stacks existentes |
Para discusiones en entrevistas, el punto crítico es entender el algoritmo HNSW (Hierarchical Navigable Small World): construye un grafo multicapa donde cada nodo se conecta a sus vecinos más cercanos, permitiendo búsqueda O(log n) a costa de mayor uso de memoria.
El punto de inflexión de costos está entre 60 y 80 millones de consultas por mes. Por encima de esto, Qdrant o Weaviate auto-hospedados en infraestructura de costo fijo resultan consistentemente de 3 a 10 veces más baratos que Pinecone Serverless.
¿Listo para aprobar tus entrevistas de Data Science & ML?
Practica con nuestros simuladores interactivos, flashcards y tests técnicos.
Recuperación híbrida: combinando búsqueda densa y dispersa
La búsqueda vectorial pura falla en coincidencias exactas de palabras clave y términos raros. La búsqueda léxica pura (BM25) no captura la similitud semántica. La recuperación híbrida combina ambas, y en 2026 este es el estándar para sistemas RAG en producción.
El patrón estándar usa Reciprocal Rank Fusion (RRF) para fusionar resultados clasificados de ambos retrievers:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
La recuperación híbrida resuelve el problema de "desajuste de vocabulario" donde un usuario pregunta por "cancelar una suscripción" pero el documento relevante usa "política de terminación de cuenta". BM25 captura la coincidencia exacta de términos mientras que la búsqueda vectorial captura la relación semántica.
Reranking: el filtro de segunda etapa
La recuperación devuelve candidatos. El reranking los ordena por relevancia real. Los rerankers cross-encoder como Cohere Rerank o bge-reranker-v2.5-gemma2-lightweight evalúan cada par consulta-documento conjuntamente, produciendo puntuaciones de relevancia mucho más precisas que la similitud por bi-encoder.
El pipeline de recuperación en dos etapas (amplio recall en primera etapa con top 50 a 100 candidatos vía vector + BM25, luego reranking preciso a top 5 a 10 para el prompt) es estándar en producción. Esto mantiene la latencia manejable: la primera etapa usa búsqueda ANN rápida, mientras que el costoso cross-encoder solo procesa un conjunto pequeño de candidatos.
Los cross-encoders son más precisos que los bi-encoders porque procesan la consulta y el documento juntos a través de todas las capas del transformer. Los bi-encoders los codifican independientemente, perdiendo señales de interacción fina. El trade-off es velocidad: los cross-encoders no pueden ser pre-indexados.
RAG adaptativo: enrutando consultas al pipeline correcto
No todas las consultas necesitan la misma complejidad de recuperación. El RAG adaptativo entrena un pequeño clasificador para enrutar cada pregunta al camino óptimo:
- Sin recuperación para consultas factuales simples que el modelo ya conoce
- Recuperación de un solo paso para consultas moderadas
- Recuperación iterativa multi-paso para razonamiento complejo
Este patrón equilibra costo y precisión en cargas de trabajo mixtas. Un sistema de producción que maneja 100,000 consultas por día puede reducir los costos de inferencia en 40% enrutando preguntas simples lejos de los costosos pipelines multi-paso.
El clasificador mismo puede ser un pequeño modelo fine-tuneado o un prompt zero-shot que pregunta: "¿Esta pregunta requiere conocimiento externo para responder con precisión?"
RAG especulativo: intercambiando fundamentación por velocidad
El RAG especulativo ejecuta la recuperación en paralelo con una generación de borrador rápida. Si el borrador muestra alta confianza (medida por logprob), el paso de recuperación se salta completamente. Si la confianza es baja, el contexto recuperado se fusiona con el borrador y ocurre la regeneración.
Este enfoque reduce la latencia promedio de 30 a 40% en consultas de alta confianza. Funciona mejor para chatbots en tiempo real, sugerencias de autocompletado y sistemas de servicio al cliente donde el tiempo de respuesta importa más que una búsqueda exhaustiva en cada consulta.
El trade-off: el RAG especulativo ocasionalmente devuelve respuestas sin fundamentación cuando el modelo está demasiado confiado. Los sistemas de producción lo combinan con calibración de confianza y fallback a recuperación completa cuando la incertidumbre excede un umbral.
RAG agéntico: más allá de la recuperación de un solo paso
El RAG ingenuo recupera una vez y genera. El RAG agéntico trata al LLM como un agente de razonamiento que decide cuándo recuperar, qué recuperar y si el contexto recuperado es suficiente.
En 2026, el RAG agéntico es el patrón dominante para consultas complejas que requieren razonamiento multi-paso. El agente puede:
- Auto-evaluar: determinar si los documentos recuperados responden la pregunta
- Re-consultar: reformular la consulta de búsqueda si los resultados iniciales son insuficientes
- Enrutar: elegir entre diferentes fuentes de conocimiento (DB vectorial, base de datos SQL, API)
- Verificar: contrastar hechos entre múltiples pasajes recuperados
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Este patrón (recuperar, evaluar, opcionalmente reescribir y reintentar) se conoce como Corrective RAG (CRAG). El AgentExecutor de LangChain está deprecado desde 2026; los nuevos proyectos deben usar create_react_agent() para patrones preconstruidos o el StateGraph de LangGraph para orquestación personalizada. Para una cobertura más profunda de los patrones LangChain para data scientists, consulta el artículo dedicado.
Graph RAG: recuperación de conocimiento estructurado
Graph RAG extrae entidades y relaciones de documentos en un grafo de conocimiento, luego consulta tanto el grafo como la base vectorial. Esta arquitectura reduce la alucinación en consultas factuales al fundamentar respuestas en relaciones explícitas entre entidades en lugar de similitud de texto no estructurado.
El pipeline de ingesta extrae tripletas (sujeto, predicado, objeto) de cada chunk de documento. En tiempo de consulta, el sistema identifica entidades relevantes en la pregunta, atraviesa el grafo de conocimiento para obtener hechos conectados, y combina contexto recuperado del grafo con pasajes recuperados por vectores.
Graph RAG destaca en preguntas de razonamiento multi-salto como "¿Qué equipo lidera el proyecto que usa el framework mencionado en el documento X?" Estas consultas requieren conectar hechos a través de múltiples documentos, algo con lo que la búsqueda vectorial pura tiene dificultades porque ningún chunk único contiene la respuesta completa.
Graph RAG mejora significativamente la precisión factual (hasta 40% de reducción en alucinación en consultas con muchas entidades) pero requiere un pipeline maduro de extracción de entidades. Una extracción ruidosa produce un grafo ruidoso, lo que puede degradar los resultados por debajo del RAG ingenuo. El proyecto GraphRAG de Microsoft entró en modo mantenimiento en 2026; recibirá correcciones de bugs pero no nuevas características.
La variante LazyGraphRAG de Microsoft (lanzada en junio 2025) reduce drásticamente los costos de indexación al diferir la sumarización hasta el momento de consulta, haciéndola adecuada para análisis exploratorio o datos en streaming donde la construcción anticipada del grafo no es práctica.
Cumplimiento del EU AI Act para sistemas RAG
El EU AI Act se volvió ampliamente aplicable en agosto 2026. La primera multa de alto perfil bajo la Ley afectó a un consorcio bancario europeo cuyo chatbot RAG no cumplía con los requisitos de transparencia a finales de mayo 2026, y una firma de gestión patrimonial de Frankfurt recibió una penalización de 4.5 millones de euros en abril 2026 por un sistema RAG orientado al cliente que no explicaba la procedencia de los datos.
Las arquitecturas RAG satisfacen naturalmente varios requisitos de cumplimiento: trazabilidad de fuentes (los chunks llevan referencias de documentos), transparencia de respuestas (las citas pueden mostrarse), y auditabilidad (los logs de recuperación existen por construcción). Sin embargo, el cumplimiento completo requiere medidas adicionales:
Clasificación de riesgo: Un chatbot público cae bajo riesgo limitado (transparencia requerida). Un sistema RAG médico o legal es de alto riesgo con obligaciones más estrictas de documentación y supervisión.
Registro de auditoría: Registrar qué pregunta activó qué chunks recuperados y qué respuesta se generó. Este registro forma la base de la trazabilidad requerida.
Supervisión humana: Los sistemas de alto riesgo requieren validación humana en casos sensibles, la capacidad de corregir outputs, y mecanismos para borrar datos indexados bajo solicitud.
Residencia de datos: Hospedar la indexación en la UE y usar BYOK (Bring Your Own Key) para asegurar que los datos no transiten por cuentas de terceros fuera de la jurisdicción.
El incumplimiento puede costar 7% de los ingresos anuales globales. Para discusiones en entrevistas, el punto clave es que la capacidad inherente de citación de RAG es una ventaja, pero no sustituye la capa de gobernanza.
Evaluación de sistemas RAG: métricas que importan
La evaluación de RAG se divide en métricas de recuperación y métricas de generación. Ambas deben medirse independientemente para diagnosticar fallas.
Métricas de recuperación:
- Recall@k: ¿Aparecieron los documentos relevantes en los top k resultados?
- MRR (Mean Reciprocal Rank): ¿Qué tan alto está clasificado el primer resultado relevante?
- NDCG: ¿El ranking coincide con el ordenamiento de relevancia ideal?
Métricas de generación:
- Fidelidad: ¿La respuesta solo usa información del contexto recuperado? (Mide alucinación)
- Relevancia de respuesta: ¿La respuesta aborda la pregunta original?
- Precisión del contexto: ¿Los chunks recuperados se usan realmente en la respuesta?
Frameworks como Ragas y DeepEval automatizan estas evaluaciones usando patrones LLM-as-judge. Las principales preguntas de entrevista de data science incluyen cada vez más diseño de evaluación RAG, así que hay que estar preparado para explicar cómo medir si un sistema RAG está funcionando correctamente.
Modos de falla en producción y depuración
Los sistemas RAG fallan de maneras predecibles. Conocer estos patrones es esencial tanto para entrevistas como para despliegue real.
Contaminación de ventana de contexto ocurre cuando demasiados chunks recuperados diluyen la señal relevante. El LLM recibe 10 chunks pero solo 2 contienen información útil. La solución: usar un reranker para filtrar y reducir el top-k del retriever.
Artefactos de chunking ocurren cuando la división de tamaño fijo rompe oraciones, tablas o bloques de código a mitad de elemento. El chunk recuperado es sintácticamente incompleto y semánticamente inútil. El chunking semántico o la división consciente del documento (respetando headers, párrafos, code fences) resuelve esto.
Deriva de embedding emerge cuando el modelo de embedding se actualiza pero el almacén vectorial todavía contiene embeddings del modelo antiguo. Las consultas codificadas con el nuevo modelo buscan en un espacio vectorial construido por el antiguo, degradando la calidad de recuperación. Solución: re-embedear todo el corpus después de cualquier cambio de modelo.
Índices obsoletos entregan información desactualizada porque el pipeline de ingesta se rezagó respecto a las actualizaciones de documentos. En sistemas de machine learning, esto es análogo al training-serving skew, donde el sistema de recuperación ve una distribución de datos diferente a la que existe en producción.
Fuentes
- Turing Post: 20 Advanced RAG Types to Know in 2026 - taxonomía completa de patrones RAG
- LangChain and LangGraph 1.0 Milestones - deprecación de AgentExecutor, nuevos patrones
- Microsoft GraphRAG GitHub - estado de modo mantenimiento
- IgnitionRAG EU AI Act Guide - requisitos de cumplimiento para sistemas RAG
- MarkTechPost: Best Vector Databases in 2026 - consolidación del mercado y precios
¡Empieza a practicar!
Pon a prueba tu conocimiento con nuestros simuladores de entrevista y tests técnicos.
Puntos clave sobre RAG para entrevistas de Data Science
- RAG combina recuperación (búsqueda vectorial sobre una base de conocimientos) con generación LLM para producir respuestas fundamentadas y factuales sin reentrenar el modelo
- La estrategia de chunking tiene el mayor impacto en la calidad de recuperación; el chunking semántico y el late chunking superan la división de tamaño fijo en la mayoría de los casos de uso
- La recuperación híbrida (vectores densos + BM25 disperso) con Reciprocal Rank Fusion es el estándar de producción, resolviendo el problema de desajuste de vocabulario que la búsqueda vectorial pura no puede manejar
- Los rerankers cross-encoder añaden una capa de precisión después de la recuperación amplia, procesando solo un pequeño conjunto de candidatos para mantener la latencia aceptable
- El RAG adaptativo enruta consultas a la complejidad de pipeline apropiada, reduciendo costos en 40% en cargas de trabajo mixtas
- El RAG especulativo intercambia fundamentación por velocidad, reduciendo la latencia de 30 a 40% en consultas de alta confianza
- El RAG agéntico (recuperar, evaluar, reescribir, reintentar) y Graph RAG (extracción de relaciones entre entidades) manejan consultas complejas multi-salto donde el RAG ingenuo falla
- El cumplimiento del EU AI Act (agosto 2026) requiere registro de auditoría, supervisión humana y clasificación de riesgo para sistemas RAG en producción
- La evaluación debe separar métricas de recuperación (Recall@k, MRR) de métricas de generación (fidelidad, relevancia de respuesta) para diagnosticar dónde se rompe el pipeline
- Las fallas de producción más comunes (contaminación de contexto, artefactos de chunking, deriva de embedding, índices obsoletos) todas tienen correcciones directas una vez identificadas
¿Sabrías detectar el bug en Data Science & ML?
Un fragmento real, un bug oculto, un intento al día. Sin cuenta para probar.

Escrito por
Anthony Fillion-MailletFundador de SharpSkill
Desarrollador fullstack desde hace más de 10 años. Dirige SharpSkill y responde por todo lo que se publica aquí.
Actualizado el 24 de agosto de 2026
Etiquetas
Compartir
Artículos relacionados
Feature Engineering para Machine Learning: Tecnicas y Preguntas de Entrevista 2026
Domina el feature engineering para machine learning con ejemplos practicos en Python. Codificacion, escalado, seleccion de variables, pipelines de scikit-learn y preguntas de entrevista de data science.

XGBoost vs LightGBM en 2026: Gradient Boosting y Preguntas de Entrevista en Data Science
Domina XGBoost y LightGBM para entrevistas de data science. Compara algoritmos de gradient boosting, aprende optimización de hiperparámetros y prepárate con preguntas técnicas y ejemplos en Python.

Pipelines de Scikit-Learn en 2026: Feature Engineering y Preguntas de Entrevista
Domina los pipelines de scikit-learn para feature engineering y prepara tus entrevistas técnicas. Guía completa con ColumnTransformer, GridSearchCV y mejores prácticas de despliegue.