ETL vs ELT en 2026: Arquitectura de Pipelines de Datos y Preguntas de Entrevista
Análisis profundo de las arquitecturas ETL y ELT, comparación de patrones de pipelines de datos y preguntas de entrevista para ingenieros de datos en 2026.
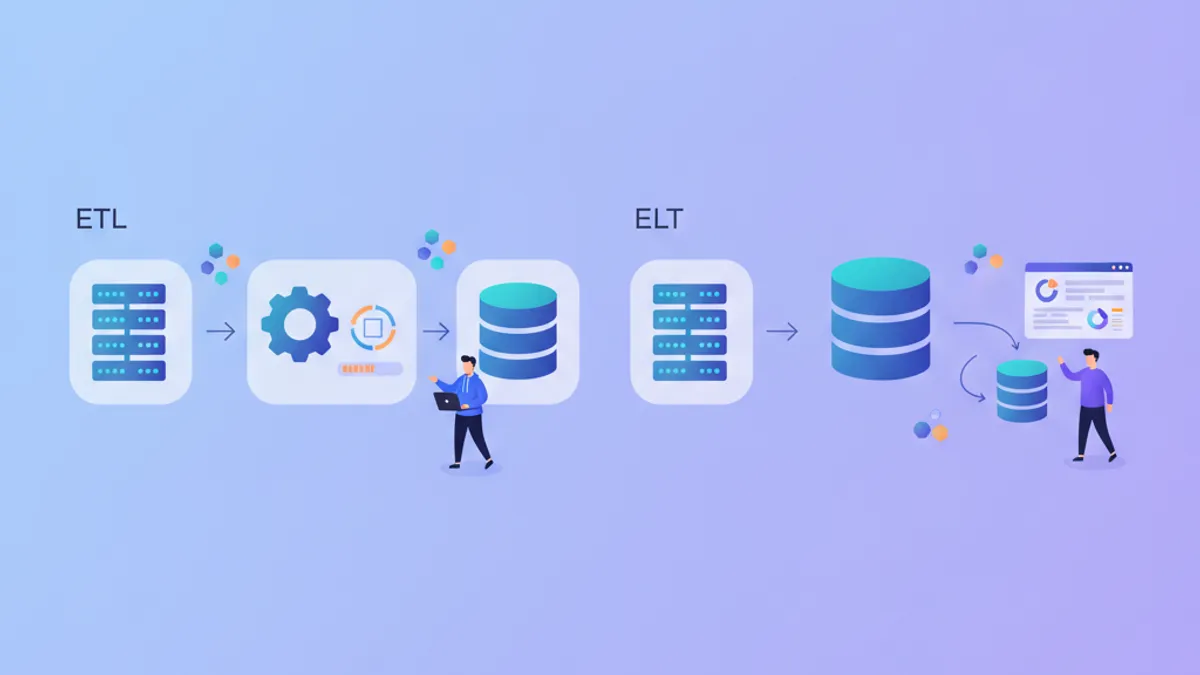
ETL vs ELT define cómo se mueven los datos desde los sistemas fuente hacia los entornos de análisis. La elección entre extraer, transformar y luego cargar (ETL) o extraer, cargar y luego transformar (ELT) afecta los costos de infraestructura, la frescura de los datos y las habilidades requeridas por los equipos de ingeniería.
ETL transforma los datos antes de cargarlos en el sistema destino, requiriendo recursos de cómputo dedicados. ELT carga los datos crudos primero y luego los transforma usando el poder de procesamiento del warehouse de destino. La mayoría de los stacks de datos cloud-nativos en 2026 favorecen ELT porque el cómputo escala bajo demanda.
Arquitectura ETL: Transformar Antes de Cargar
ETL surgió cuando los data warehouses tenían capacidad de cómputo limitada y el almacenamiento era costoso. El patrón tenía sentido: filtrar y agregar datos fuera del warehouse, cargar solo lo que el análisis requería. Oracle Warehouse Builder, Informatica PowerCenter y Talend construyeron herramientas alrededor de este modelo.
La etapa de transformación en ETL se ejecuta en servidores intermedios. Los datos se mueven desde la fuente a un área de staging, se limpian y remodelan, y luego se cargan en el destino. Este enfoque reduce la carga del warehouse pero crea un cuello de botella en la capa de transformación.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL funciona bien cuando la lógica de transformación permanece estable y los volúmenes de datos son predecibles. La desventaja aparece cuando los requisitos cambian: modificar las transformaciones significa reprocesar los datos históricos desde cero.
Arquitectura ELT: Cargar Primero, Transformar en el Warehouse
ELT traslada la transformación al data warehouse. Snowflake, BigQuery, Databricks y Redshift proporcionan cómputo casi ilimitado que escala con la complejidad de las consultas. Cargar datos crudos primero preserva el estado de la fuente; las transformaciones se convierten en modelos SQL que pueden versionarse y reejecutarse sin volver a extraer.
El proyecto dbt (data build tool) popularizó ELT tratando las transformaciones SQL como código. En lugar de jobs ETL de caja negra, las transformaciones residen en control de versiones como sentencias SELECT que referencian tablas crudas y construyen modelos derivados.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT preserva los datos crudos, lo que permite reprocesar cuando la lógica de negocio cambia. Si un cálculo estaba mal hace seis meses, corregir el modelo dbt y ejecutar un refresh completo corrige los datos históricos. Con ETL, la misma corrección requiere volver a extraer de fuentes que pueden ya no tener los registros originales.
Tabla Comparativa: Compromisos ETL vs ELT
| Factor | ETL | ELT |
|---|---|---|
| Ubicación del cómputo | Servidor de transformación dedicado | Warehouse de destino |
| Retención de datos crudos | A menudo descartados después de transformar | Preservados en zona de aterrizaje |
| Costo de reprocesamiento | Re-extraer de la fuente | Re-ejecutar modelos SQL |
| Flexibilidad de esquema | Fijo al momento de transformación | Schema-on-read posible |
| Ejemplos de herramientas | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Mejor para | Requisitos estables, sistemas legacy | Requisitos cambiantes, warehouses cloud |
| Latencia | Mayor (transformar antes de cargar) | Menor (cargar luego transformar) |
| Gobernanza de datos | Más fácil (datos filtrados antes del warehouse) | Requiere controles a nivel de warehouse |
¿Listo para aprobar tus entrevistas de Data Engineering?
Practica con nuestros simuladores interactivos, flashcards y tests técnicos.
Enfoques Híbridos: Cuando ETL y ELT se Combinan
Los stacks de datos modernos rara vez usan ETL o ELT puros. Apache Airflow orquesta pipelines que mezclan ambos patrones. Los datos sensibles pueden anonimizarse antes de cargar (un paso ETL), mientras que las agregaciones se ejecutan en el warehouse (ELT).
Fivetran y Airbyte extraen y cargan datos crudos sin transformación, luego dbt transforma dentro del warehouse. Pero estas herramientas también soportan transformaciones ligeras durante la extracción: selección de columnas, conversión de tipos de datos, hashing de campos PII. Esto difumina la frontera ETL/ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
El pipeline anterior extrae de Salesforce con Airbyte (que puede hashear direcciones de correo durante la sincronización), carga a Snowflake y luego ejecuta modelos dbt para transformaciones de negocio. Ni ETL puro ni ELT puro, pero práctico.
Preguntas de Entrevista: ETL vs ELT para Ingenieros de Datos
Las entrevistas técnicas para roles de ingeniería de datos en empresas que usan stacks de datos modernos evalúan la comprensión de la arquitectura de pipelines. Estas preguntas aparecen frecuentemente, basadas en patrones de módulos de preparación para entrevistas ETL/ELT.
Pregunta 1: ¿Cuándo Elegirías ETL Sobre ELT?
Las respuestas fuertes identifican escenarios específicos:
- Requisitos de cumplimiento: GDPR o HIPAA exigen que ciertos datos nunca lleguen al warehouse en forma cruda. Los PII deben anonimizarse o eliminarse antes de cargar.
- Restricciones de warehouse legacy: Sistemas on-premises como Teradata o configuraciones antiguas de Redshift con cómputo fijo se benefician de cargas pre-agregadas.
- Costos de red: Cargar 10TB diarios a un warehouse cloud, luego descartar el 90% después de transformar, desperdicia ancho de banda de egreso. El pre-filtrado tiene sentido económico.
Las respuestas débiles dicen "ETL está obsoleto" o fallan en dar escenarios concretos. Los entrevistadores buscan matices.
Pregunta 2: ¿Cómo Manejas Cambios de Esquema en un Pipeline ELT?
Esto prueba la comprensión de zonas de aterrizaje de datos crudos. Temas esperados:
- Columnas JSON o semi-estructuradas que absorben nuevos campos sin migración de esquema
- Modelos de staging que seleccionan columnas explícitamente, aislando modelos downstream de cambios en la fuente
- Macros dbt o assertions de Dataform que fallan los builds cuando columnas esperadas desaparecen
- Monitoreo de drift de esquema usando herramientas como Monte Carlo o Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Pregunta 3: Compara la Orquestación ETL con Airflow vs Ejecutar dbt para ELT
La pregunta evalúa la comprensión de que estas herramientas resuelven problemas diferentes:
- Airflow orquesta tareas: extracción, llamadas API, transferencias de archivos, entrenamiento de modelos. Gestiona dependencias entre jobs heterogéneos.
- dbt transforma datos dentro de un warehouse. Gestiona dependencias entre modelos SQL, ejecuta tests, genera documentación.
Un pipeline completo a menudo usa ambos: Airflow dispara sincronizaciones de Airbyte, espera su finalización y luego dispara ejecuciones de dbt. Saber cuándo usar cada herramienta distingue a los candidatos senior.
Pregunta 4: Tu Pipeline ELT Procesa 500M de Filas Diarias y los Analistas Reportan Consultas Lentas
Esta pregunta abierta prueba el pensamiento diagnóstico:
- Verificar materialización de modelos: ¿Los modelos pesados siguen siendo vistas? Los modelos incrementales o tablas podrían ayudar.
- Particionar y clusterizar: Para BigQuery, ¿las tablas de hechos están particionadas por fecha? Para Snowflake, ¿el clustering está optimizado para patrones de consulta comunes?
- Pushdown de consultas: ¿Los analistas consultan modelos de staging en lugar de marts pre-agregados?
- Dimensionamiento del warehouse: ¿El cómputo está escalado apropiadamente durante las horas de consulta?
- Requisitos de frescura: ¿La transformación podría ejecutarse de noche en lugar de durante el horario laboral?
No existe una única respuesta correcta. Los entrevistadores evalúan el troubleshooting sistemático.
Panorama de Herramientas en 2026
El mercado de integración de datos se ha consolidado alrededor de unos pocos patrones:
Extracción y carga: Fivetran, Airbyte, Stitch y Meltano manejan la porción EL. Estas herramientas se conectan a cientos de fuentes y sincronizan a warehouses cloud sin código personalizado.
Transformación: dbt domina la transformación basada en SQL. Las alternativas incluyen Dataform (ahora parte de Google Cloud), SQLMesh (open source con ambientes de datos virtuales) y Coalesce (modelado visual).
Orquestación: Airflow sigue siendo el estándar para pipelines complejos. Dagster y Prefect ofrecen alternativas con mejor desarrollo local y vistas centradas en assets.
Calidad: Great Expectations, tests de dbt, Monte Carlo y Soda proporcionan monitoreo de calidad de datos. Estas herramientas detectan problemas entre la extracción y el consumo downstream.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
¡Empieza a practicar!
Pon a prueba tu conocimiento con nuestros simuladores de entrevista y tests técnicos.
Seleccionando Arquitectura de Pipeline para Nuevos Proyectos
Para la mayoría de proyectos greenfield en 2026, ELT es el valor por defecto. El cómputo en warehouses cloud cuesta menos que mantener servidores de transformación. La preservación de datos crudos habilita correcciones retroactivas. Las transformaciones basadas en SQL son auditables y versionadas.
ETL sigue siendo relevante para:
- Entornos regulatorios que requieren minimización de datos antes de entrar al warehouse
- Streaming en tiempo real donde la transformación debe ocurrir en el momento de la ingesta (Kafka Streams, Flink)
- Escenarios de edge computing con almacenamiento downstream limitado
- Integraciones legacy donde el sistema fuente controla el formato de exportación
La respuesta lista para la entrevista reconoce ambos patrones y explica los compromisos sin preferencia ideológica.
Puntos Clave para Arquitectura de Pipelines de Datos
- ETL transforma datos antes de cargar, reduciendo la carga del warehouse pero creando fricción de reprocesamiento cuando la lógica cambia
- ELT carga datos crudos primero, habilitando transformaciones SQL que pueden versionarse, testearse y reejecutarse contra datos históricos
- Los stacks modernos típicamente combinan ambos: transformaciones de extracción ligeras (hashing de PII, conversión de tipos) con agregación basada en warehouse
- dbt se ha convertido en el estándar para transformación ELT, tratando modelos SQL como código testeable y documentado
- Las preguntas de entrevista evalúan selección de escenarios, manejo de evolución de esquema y compromisos de herramientas en lugar de definiciones memorizadas
- La preservación de datos crudos en pipelines ELT permite correcciones a cálculos históricos sin re-extraer de las fuentes
¿Sabrías detectar el bug en Data Engineering?
Un fragmento real, un bug oculto, un intento al día. Sin cuenta para probar.

Escrito por
Anthony Fillion-MailletFundador de SharpSkill
Desarrollador fullstack desde hace más de 10 años. Dirige SharpSkill y responde por todo lo que se publica aquí.
Actualizado el 14 de septiembre de 2026
Compartir
Artículos relacionados
Great Expectations en 2026: Validación de Calidad de Datos y Preguntas de Entrevista
Guía completa de Great Expectations 1.22 para validación de calidad de datos. Expectations, Checkpoints, integración con Airflow y preguntas de entrevista de data engineering.

Apache Beam vs Spark en 2026: Pipelines Unificados y Preguntas de Entrevista
Comparación detallada entre Apache Beam y Spark para pipelines de datos en 2026. Portabilidad, windowing, rendimiento y preguntas técnicas de entrevista.

Apache Flink en 2026: Procesamiento de Streams, Event Time y Preguntas de Entrevista
Guía completa de Apache Flink 2.3 para procesamiento de streams en tiempo real. Watermarks, ventanas, gestión de estado y preparación para entrevistas de data engineering.