C#-Blog 2026 entwickeln: Technisches Bloggen mit ASP.NET Core und Minimal APIs
Ein C#-Blog auf .NET 10 mit ASP.NET Core Minimal APIs: Markdown-Beiträge mit Front Matter, threadsicherer Speicher mit Hot Reload, Razor-Komponenten, Output Caching und RSS-Feed.
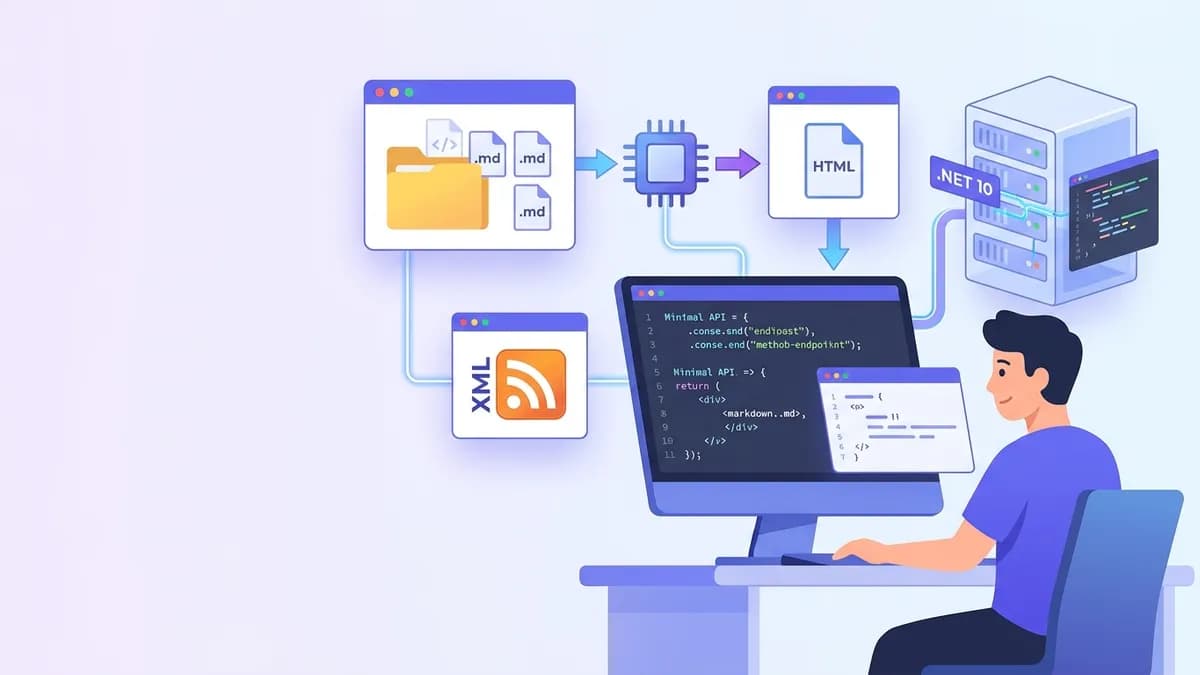
Ein C#-Blog auf Basis von ASP.NET Core Minimal APIs kommt mit erstaunlich wenigen Dateien aus: Markdown-Beiträge im Dateisystem, ein Singleton-Speicher, der sie einmal einliest, eine Handvoll Endpunkte, die HTML ausliefern, und ein RSS-Feed. Unter .NET 10, dem im November 2025 veröffentlichten Long-Term-Support-Release, stammen fast alle Bausteine direkt aus dem Framework. Ergänzt werden sie durch drei NuGet-Pakete. Ein CMS ist ebenso überflüssig wie eine Datenbank.
Ein leeres .NET-10-Webprojekt, Markdig für die Umwandlung von Markdown in HTML, YamlDotNet für die Front Matter, ein unveränderlicher In-Memory-Speicher für die Beiträge, der bei Dateiänderungen neu lädt, Minimal-API-Endpunkte mit RazorComponentResult-Seiten, Output Caching mit Tag-basierter Invalidierung und ein RSS-2.0-Feed über System.ServiceModel.Syndication. Die gesamte Engine bleibt unter 300 Zeilen C#.
Minimal API statt Static Site Generator: die Abwägung
Static Site Generators wie Hugo oder Jekyll erzeugen HTML-Dateien zur Build-Zeit. Das Ergebnis ist schnell und günstig zu hosten. Sobald jedoch Verhalten jenseits von Templates gefragt ist, etwa zeitgesteuerte Veröffentlichungen, eine JSON-Schnittstelle für eine mobile App, Feeds pro Tag oder eigene Analytics, landet die Logik in Plugins, die in Go, Ruby oder JavaScript geschrieben sind. Für ein .NET-Team ist das ein Fremdkörper.
Ein Blog auf ASP.NET Core belässt die Inhalte als reine Markdown-Dateien im Git-Repository, rendert sie beim ersten Aufruf und liefert das Ergebnis anschließend aus dem Arbeitsspeicher. Mit vorgeschaltetem Output Caching liegen die Kosten pro Anfrage nahe an denen einer statischen Datei. Der ausgeführte Code ist gewöhnliches C#, das sich debuggen, testen und erweitern lässt. Nebenbei berührt das Projekt Dependency Injection, die Request-Pipeline, Caching und Nebenläufigkeit, also genau die Themen, die in einem technischen .NET-Interview zur Sprache kommen.
| Aspekt | Static Site Generator | Blog mit ASP.NET Core Minimal APIs |
|---|---|---|
| Inhaltsformat | Markdown + Front Matter | Markdown + Front Matter |
| Zeitpunkt des Renderns | Beim Build | Beim ersten Aufruf, danach gecacht |
| Eigene Logik | Plugins, Templates | Normale C#-Endpunkte |
| Hosting | Beliebiger statischer Host oder CDN | Container, App Service, jeder VPS |
| Inhalte live aktualisieren | Neu bauen und deployen | Ein File Watcher lädt den Speicher neu |
Das ASP.NET-Core-Blogprojekt unter .NET 10 anlegen
Ausgangspunkt ist das leere Web-Template. dotnet new web erzeugt ein Projekt auf Basis des SDK Microsoft.NET.Sdk.Web, das .razor-Komponenten ohne zusätzliche Konfiguration kompiliert. Drei Pakete decken den Rest ab: Markdig für das CommonMark-Parsing, YamlDotNet für die Front Matter und System.ServiceModel.Syndication für den Feed.
# terminal
dotnet new web -n CSharpBlog --framework net10.0
cd CSharpBlog
dotnet add package Markdig
dotnet add package YamlDotNet
dotnet add package System.ServiceModel.Syndication
mkdir posts Posts Endpoints Components
In Program.cs laufen alle Fäden zusammen. Der Beitragsspeicher wird als Singleton registriert, weil die geparsten Beiträge von allen Anfragen gemeinsam genutzt werden. Das Output Caching steht in der Pipeline vor den Endpunkten, damit gecachte Antworten den Handler gar nicht erst erreichen.
var builder = WebApplication.CreateBuilder(args);

// Site settings bound from the "Blog" section of appsettings.json
builder.Services.Configure<BlogOptions>(builder.Configuration.GetSection("Blog"));

builder.Services.AddSingleton<PostStore>();   // one parsed snapshot shared by all requests
builder.Services.AddRazorComponents();        // enables RazorComponentResult rendering
builder.Services.AddOpenApi();                // OpenAPI 3.1 document for the JSON API
builder.Services.AddOutputCache(options =>
    options.AddBasePolicy(policy => policy.Expire(TimeSpan.FromHours(1))));

var app = builder.Build();

app.MapStaticAssets();   // CSS and images from wwwroot, fingerprinted since .NET 9
app.UseOutputCache();    // must run before the endpoints it caches
app.MapOpenApi();

app.MapBlogEndpoints();
app.MapFeedEndpoints();

app.Run();

public sealed class BlogOptions
{
    public string Title { get; set; } = "C# Notes";
    public string SiteUrl { get; set; } = "https://localhost:5001/";
}
Die Einstellung SiteUrl spielt später eine wichtige Rolle: Kanonische Links und Feed-Adressen werden aus der Konfiguration gebildet und niemals aus dem eingehenden Host-Header.
Markdown-Beiträge mit Front Matter in C# parsen
Jeder Beitrag ist eine Datei wie posts/output-caching-dotnet-10.md. Der Dateiname dient als Slug, ein YAML-Block am Dateianfang enthält die Metadaten:
---
title: Output caching in .NET 10
summary: How tag-based eviction keeps cached pages fresh.
date: 2026-11-10
tags: [aspnet-core, performance]
draft: false
---
Output caching stores the full response on the server...
Der Parser trennt den YAML-Block vom eigentlichen Text, deserialisiert die Metadaten in eine kleine Klasse und wandelt den Rumpf in HTML um. Vorher werden die Zeilenenden vereinheitlicht. Ohne diesen Schritt scheitert die Suche nach dem Trennzeichen ---, sobald ein Beitrag unter Windows mit CRLF gespeichert wurde.
using Markdig;
using YamlDotNet.Serialization;
using YamlDotNet.Serialization.NamingConventions;

public sealed record Post(string Slug, string Title, string Summary,
    DateTime PublishedOn, IReadOnlyList<string> Tags, bool Draft, string Html);

public static class PostParser
{
    // Built once and reused by every reload
    private static readonly MarkdownPipeline Pipeline =
        new MarkdownPipelineBuilder().UseAdvancedExtensions().Build();

    private static readonly IDeserializer Yaml = new DeserializerBuilder()
        .WithNamingConvention(CamelCaseNamingConvention.Instance)
        .IgnoreUnmatchedProperties()   // unknown keys do not crash the reload
        .Build();

    public static Post Parse(string slug, string text)
    {
        text = text.ReplaceLineEndings("\n");
        if (!text.StartsWith("---\n"))
            throw new FormatException($"{slug}: missing front matter");

        var end = text.IndexOf("\n---", 4, StringComparison.Ordinal);
        if (end < 0)
            throw new FormatException($"{slug}: unterminated front matter");

        var meta = Yaml.Deserialize<FrontMatter>(text[4..end]);
        var html = Markdown.ToHtml(text[(end + 4)..], Pipeline);

        return new Post(slug, meta.Title, meta.Summary, meta.Date, meta.Tags, meta.Draft, html);
    }

    private sealed class FrontMatter
    {
        public string Title { get; set; } = "";
        public string Summary { get; set; } = "";
        public DateTime Date { get; set; }
        public List<string> Tags { get; set; } = [];
        public bool Draft { get; set; }
    }
}
UseAdvancedExtensions() aktiviert Tabellen, Fußnoten, Aufgabenlisten, automatische IDs für Überschriften und die übrigen Markdig-Erweiterungen, die ein technischer Blog braucht. Standardmäßig reicht Markdig rohes HTML unverändert durch. Für Beiträge des Seitenbetreibers ist das vertretbar. Sobald jedoch Markdown von Nutzern gerendert wird, etwa in Kommentaren oder Gastbeiträgen, gehört DisableHtml() in die Pipeline, sonst entsteht eine Stored-XSS-Lücke.
Ein threadsicherer Singleton-Speicher mit Hot Reload
Der Speicher liest beim Start alle Dateien ein und hält das Ergebnis in einem FrozenDictionary, das seit .NET 8 verfügbar und auf lesende Zugriffe optimiert ist. Ändert sich eine Datei, baut der Speicher ein vollständig neues Dictionary auf und ersetzt die Referenz mit einer einzigen Zuweisung. Lesende Threads benötigen keine Sperre: Jede Anfrage sieht entweder den alten oder den neuen Stand, niemals eine halb befüllte Sammlung.
using System.Collections.Frozen;
using Microsoft.AspNetCore.OutputCaching;
using Microsoft.Extensions.FileProviders;
using Microsoft.Extensions.Primitives;

public sealed class PostStore
{
    private readonly PhysicalFileProvider _files;
    private readonly IOutputCacheStore _cache;
    private readonly ILogger<PostStore> _logger;
    private volatile FrozenDictionary<string, Post> _bySlug = FrozenDictionary<string, Post>.Empty;

    public PostStore(IWebHostEnvironment env, IOutputCacheStore cache, ILogger<PostStore> logger)
    {
        (_cache, _logger) = (cache, logger);
        _files = new PhysicalFileProvider(Path.Combine(env.ContentRootPath, "posts"));
        Reload();
        ChangeToken.OnChange(() => _files.Watch("*.md"), Reload);   // re-registers after each change
    }

    public Post? Find(string slug) => _bySlug.TryGetValue(slug, out var post) ? post : null;

    public IReadOnlyList<Post> Latest(int count) =>
        _bySlug.Values.OrderByDescending(p => p.PublishedOn).Take(count).ToList();

    private void Reload()
    {
        try
        {
            var snapshot = _files.GetDirectoryContents("")
                .Where(f => !f.IsDirectory && f.Name.EndsWith(".md", StringComparison.Ordinal))
                .Select(f => PostParser.Parse(Path.GetFileNameWithoutExtension(f.Name), File.ReadAllText(f.PhysicalPath!)))
                .Where(p => !p.Draft)
                .ToFrozenDictionary(p => p.Slug);

            _bySlug = snapshot;   // atomic reference swap
            _ = _cache.EvictByTagAsync("posts", CancellationToken.None).AsTask();
            _logger.LogInformation("Loaded {Count} posts", snapshot.Count);
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "Reload failed, keeping the previous snapshot");   // a typo never takes the site down
        }
    }
}
Drei Details machen diesen Code produktionstauglich. Das Feld ist als volatile markiert, sodass andere Threads nach dem Austausch zuverlässig die neue Referenz lesen. Der try/catch-Block behält den letzten gültigen Stand, wenn ein Beitrag fehlerhaftes YAML enthält: Ein Tippfehler in einer einzelnen Datei leert also nicht den ganzen Blog. Und der Aufruf von EvictByTagAsync verwirft alle gecachten Seiten mit dem Tag posts, damit neue Inhalte bereits bei der nächsten Anfrage erscheinen und nicht erst nach Ablauf der Stunde.
FileSystemWatcher stützt sich auf Benachrichtigungen des Betriebssystems, die über Docker-Bind-Mounts oder Netzlaufwerke nicht zuverlässig ankommen. Wird der Ordner posts in einen Container eingehängt, sollte die Umgebungsvariable DOTNET_USE_POLLING_FILE_WATCHER=true oder PhysicalFileProvider.UsePollingFileWatcher = true gesetzt werden. Viele Editoren speichern eine Datei zudem in mehreren Schreibvorgängen, wodurch Reload pro Speichern zwei- oder dreimal ausgelöst werden kann. Hier ist das unkritisch, denn jeder Durchlauf erzeugt denselben Stand.
Minimal-API-Endpunkte mit Route Groups und TypedResults
Die öffentlichen Seiten werden mit MapGroup unter /blog gebündelt. So gelten die Cache-Richtlinie und ihr Tag an einer zentralen Stelle für alle Endpunkte der Gruppe. Die Handler geben RazorComponentResult<T> zurück, das es seit .NET 8 gibt: Eine Razor-Komponente wird damit als vollständige HTTP-Antwort gerendert, ohne MVC, Razor Pages oder Blazor-Router.
using CSharpBlog.Components;   // namespace of PostPage and PostListPage
using Microsoft.AspNetCore.Http.HttpResults;

public static class BlogEndpoints
{
    public static IEndpointRouteBuilder MapBlogEndpoints(this IEndpointRouteBuilder app)
    {
        var blog = app.MapGroup("/blog").CacheOutput(p => p.Tag("posts"));

        blog.MapGet("/", (PostStore store) =>
            new RazorComponentResult<PostListPage>(new { Posts = store.Latest(20) }));

        blog.MapGet("/{slug:regex(^[a-z0-9-]+$)}", GetPost);   // rejects odd slugs before the handler

        app.MapGet("/api/posts", (PostStore store) =>
                TypedResults.Ok(store.Latest(50).Select(p => new PostSummary(p.Slug, p.Title, p.Summary, p.PublishedOn))))
            .CacheOutput(p => p.Tag("posts"))
            .WithName("ListPosts");

        return app;
    }

    // The union return type documents both outcomes for OpenAPI and for unit tests
    private static Results<RazorComponentResult<PostPage>, NotFound> GetPost(string slug, PostStore store) =>
        store.Find(slug) is { } post
            ? new RazorComponentResult<PostPage>(new { Post = post })
            : TypedResults.NotFound();
}

public sealed record PostSummary(string Slug, string Title, string Summary, DateTime PublishedOn);
Der Rückgabetyp Results<T1, T2> ist der eigentliche Unterschied zwischen TypedResults und den älteren Results-Hilfsmethoden. Der Compiler prüft, dass der Handler nur die deklarierten Ergebnisse liefert, der OpenAPI-Generator liest beide Statuscodes direkt aus der Signatur, und ein Unit-Test kann result.Result is NotFound prüfen, ohne einen Server zu starten. Der JSON-Endpunkt liegt bewusst außerhalb der Gruppe /blog, damit seine Adresse nicht mit einem Beitrags-Slug kollidiert.
Die Beitragsseite selbst ist eine gewöhnliche Razor-Komponente. MarkupString weist Razor an, die Ausgabe von Markdig als HTML einzufügen statt sie zu kodieren. Die kanonische Adresse stammt aus BlogOptions.
@* Components/PostPage.razor *@
@using Microsoft.Extensions.Options
@inject IOptions<BlogOptions> Options

<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="utf-8" />
    <title>@Post.Title | @Options.Value.Title</title>
    <meta name="description" content="@Post.Summary" />
    <link rel="canonical" href="@(new Uri(new Uri(Options.Value.SiteUrl), $"blog/{Post.Slug}"))" />
    <link rel="alternate" type="application/rss+xml" title="@Options.Value.Title" href="/feed.xml" />
    <link rel="stylesheet" href="/site.css" />
</head>
<body>
    <article>
        <h1>@Post.Title</h1>
        <time datetime="@(Post.PublishedOn.ToString("yyyy-MM-dd"))">@(Post.PublishedOn.ToString("d MMMM yyyy"))</time>
        @((MarkupString)Post.Html)
    </article>
</body>
</html>

@code {
    [Parameter, EditorRequired] public Post Post { get; set; } = default!;
}
PostListPage.razor folgt demselben Muster mit einem Parameter Posts und einer Schleife über Titel und Zusammenfassungen. Das anonyme Objekt, das an RazorComponentResult übergeben wird, ordnet seine Eigenschaftsnamen den Komponentenparametern zu. new { Post = post } muss also exakt zum Parameter Post passen; ein Tippfehler fällt erst zur Laufzeit auf.
Bereit für deine .NET-Interviews?
Übe mit unseren interaktiven Simulatoren, Flashcards und technischen Tests.
Output Caching für die Blogseiten
Output Caching, eingeführt mit ASP.NET Core 7, speichert die komplette Antwort auf dem Server und spielt sie erneut aus, ohne den Handler auszuführen oder die Komponente neu zu rendern. Darin unterscheidet es sich von der älteren Response-Caching-Middleware, die den HTTP-Regeln von Cache-Control folgt und es einem Client erlaubt, den Cache per no-cache-Header zu umgehen. Die Dokumentation zum Output Caching auf Microsoft Learn beschreibt die Standardregeln: Gecacht werden nur GET- und HEAD-Anfragen mit Status 200, Antworten mit gesetzten Cookies sowie authentifizierte Anfragen bleiben außen vor.
Erst die Tags machen Output Caching für eine Content-Seite wirklich brauchbar. Jeder Blog-Endpunkt trägt das Tag posts, und der Speicher invalidiert dieses Tag nach jedem Neuladen. Die einstündige Basisrichtlinie ist lediglich ein Sicherheitsnetz; in der Praxis bleiben die Seiten im Cache, bis sich tatsächlich Inhalte ändern.
Bei mehreren Instanzen gilt zu beachten, dass der In-Memory-Speicher pro Prozess existiert: Eine Invalidierung auf Instanz A lässt Instanz B mit veralteten Seiten zurück. ASP.NET Core bietet dafür einen Redis-basierten Speicher über das Paket Microsoft.AspNetCore.OutputCaching.StackExchangeRedis und AddStackExchangeRedisOutputCache, der Einträge und Invalidierungen über alle Instanzen hinweg teilt. Für eine einzelne kleine Instanz ist das nicht nötig.
Einen RSS-Feed in C# mit SyndicationFeed erzeugen
Technisch interessierte Leser abonnieren nach wie vor über Feedreader, und Aggregatoren entdecken neue Beiträge eher über den Feed als über die Sitemap. SyndicationFeed und Rss20FeedFormatter erzeugen einen Feed nach der RSS-2.0-Spezifikation, ohne dass XML von Hand geschrieben werden muss.
using System.ServiceModel.Syndication;
using System.Text;
using System.Xml;
using Microsoft.Extensions.Options;

public static class FeedEndpoints
{
    public static IEndpointRouteBuilder MapFeedEndpoints(this IEndpointRouteBuilder app)
    {
        app.MapGet("/feed.xml", (PostStore store, IOptions<BlogOptions> options) =>
        {
            var site = new Uri(options.Value.SiteUrl);   // never built from the Host header
            var items = store.Latest(20).Select(p =>
            {
                var date = new DateTimeOffset(DateTime.SpecifyKind(p.PublishedOn, DateTimeKind.Utc));
                return new SyndicationItem(p.Title, p.Summary, new Uri(site, $"blog/{p.Slug}"), p.Slug, date)
                {
                    PublishDate = date   // RSS pubDate comes from PublishDate, not LastUpdatedTime
                };
            });

            var feed = new SyndicationFeed(options.Value.Title, "Articles on C# and .NET", site, items);

            using var buffer = new MemoryStream();
            using (var writer = XmlWriter.Create(buffer, new XmlWriterSettings { Encoding = new UTF8Encoding(false) }))
                new Rss20FeedFormatter(feed).WriteTo(writer);   // writer flushes on dispose

            return TypedResults.Bytes(buffer.ToArray(), "application/rss+xml; charset=utf-8");
        }).CacheOutput(p => p.Tag("posts"));

        return app;
    }
}
Absolute Adressen aus BlogOptions.SiteUrl statt aus HttpContext.Request.Host zu bilden, schließt eine Host-Header-Injection: Andernfalls würde eine einzige Anfrage mit gefälschtem Host-Wert gecacht und allen Abonnenten mit Links auf eine fremde Domain ausgeliefert. Das Argument UTF8Encoding(false) entfernt außerdem die Byte Order Mark, an der einige Feedreader scheitern.
Deployment und die Grenzen von Native AOT
dotnet publish -c Release erzeugt einen framework-abhängigen Build, der auf jedem Host mit .NET-10-Runtime läuft. Seit .NET 8 baut das SDK zudem Container-Images ohne Dockerfile: dotnet publish -c Release /t:PublishContainer erzeugt ein Image auf Basis des offiziellen ASP.NET-Core-Runtime-Images. Der Ordner posts kann entweder ins Image eingebacken werden, dann erfordert jede inhaltliche Änderung ein neues Deployment, oder als Volume eingehängt werden, dann greift der File Watcher.
Native AOT lockt mit kurzer Startzeit und geringem Speicherbedarf, passt aber nicht zu diesem Projekt. Die Kompatibilitätstabelle für Native AOT in ASP.NET Core führt Minimal APIs als teilweise unterstützt und Blazor Server als nicht unterstützt, und der Standard-Deserializer von YamlDotNet arbeitet mit Reflection. Ein Blog liefert gecachte Seiten aus einem langlebigen Prozess, die Startzeit fällt daher kaum ins Gewicht. Ein Umstieg auf AOT würde bedeuten, Razor-Komponenten durch String-Templates und YAML durch eine per Source Generator verarbeitete JSON-Front-Matter zu ersetzen, bei geringem Nutzen.
Welche .NET-Interviewfragen dieses Projekt abdeckt
Jeder Baustein der Engine entspricht einer Frage, die in ASP.NET-Core-Interviews regelmäßig auftaucht. Die .NET-Interviewfragen auf SharpSkill behandeln sie ausführlich, das Modul zu Minimal APIs konzentriert sich auf die Endpunkt-Seite.
„Ist ein Singleton-Service sicher, wenn viele Anfragen gleichzeitig darauf lesen?“ Nur wenn sein Zustand unveränderlich oder synchronisiert ist. Der Speicher oben setzt auf einen unveränderlichen Stand und einen Referenzaustausch über ein volatile-Feld: Leser sperren nie, und Schreiber blockieren keine Leser. Die klassische Falle ist ein Singleton mit einer List<T>, die während des Neuladens verändert wird und unter Last mitten in der Aufzählung eine InvalidOperationException wirft. Das Modul zu Dependency Injection behandelt zudem das Problem der Captive Dependency: Ein Singleton, das einen Scoped-Service wie einen DbContext erhält, hält diesen für die gesamte Laufzeit der Anwendung am Leben.
„Worin unterscheiden sich Output Caching und Response Caching?“ Output Caching wird vom Server gesteuert, unterstützt Tags und gezielte Invalidierung und ignoriert Cache-Header des Clients. Response Caching folgt der HTTP-Semantik und ist vor allem ein Hinweis an Proxys und Browser.
„Warum TypedResults statt Results?“ Konkrete Ergebnistypen ermöglichen eine Prüfung der möglichen Ausgänge zur Kompilierzeit, liefern automatisch OpenAPI-Metadaten und machen Handler als einfache Methoden testbar. Der ausführliche Vergleich mit Controllern findet sich im Artikel zu Architektur und Performance von Minimal APIs.
„Wo spielt die Reihenfolge der Middleware in dieser Anwendung eine Rolle?“ UseOutputCache muss vor den Endpunkten registriert werden, die gecacht werden sollen, und bei aktiviertem CORS nach UseCors. Wer darüber hinaus erklären kann, warum die Standardrichtlinie authentifizierte Anfragen nie cacht und was eine eigene IOutputCachePolicy prüfen muss, bevor sie es doch tut, zeigt Verständnis für die Pipeline statt einer auswendig gelernten Reihenfolge.
Fazit: ein C#-Blog mit ASP.NET Core in sieben Punkten
- Mit
dotnet new webunter .NET 10 starten und nur Markdig, YamlDotNet undSystem.ServiceModel.Syndicationhinzufügen; ein technischer Blog braucht weder CMS noch Datenbank. - Beiträge einmal in ein unveränderliches
FrozenDictionaryeinlesen und beim Neuladen den gesamten Stand austauschen, damit Leser nie sperren und eine defekte Datei die Seite nie leert. - HTML mit
RazorComponentResult<T>aus Minimal-API-Handlern rendern und Rückgabetypen alsResults<T1, T2>deklarieren, damit OpenAPI und Unit-Tests jeden Ausgang kennen. - Alle Content-Endpunkte hinter Output Caching mit gemeinsamem Tag legen und nach jedem Neuladen
EvictByTagAsyncaufrufen, statt auf kurze Ablaufzeiten zu setzen. - Kanonische Adressen und Feed-URLs aus der Konfiguration bilden, nie aus dem
Host-Header, undDisableHtml()in jeder Pipeline aktivieren, die Markdown von Nutzern rendert. DOTNET_USE_POLLING_FILE_WATCHER=truesetzen, wenn der Ordnerpostsin einen Container eingehängt wird.- Das Projekt als Interviewtraining nutzen: Threadsicherheit des Singletons, Wahl des Caches und Reihenfolge der Middleware sollten sich frei erklären lassen.
Fang an zu üben!
Teste dein Wissen mit unseren Interview-Simulatoren und technischen Tests.
Findest du den Bug in .NET?
Ein echter Codeausschnitt, ein versteckter Bug, ein Versuch pro Tag. Zum Ausprobieren ohne Konto.
Geschrieben von
Anthony Fillion-MailletGründer von SharpSkill
Seit über 10 Jahren Fullstack-Entwickler. Er leitet SharpSkill und verantwortet alles, was hier erscheint.
Aktualisiert am 17. November 2026
Tags
Teilen
Verwandte Artikel
.NET 10 im Jahr 2026: Neue Features, Native AOT und C# 14 fuer die Interview-Vorbereitung
.NET 10 erscheint als Long-Term-Support-Version mit Native-AOT-Verbesserungen, C# 14 Extension Members, dem field-Keyword und dateibasierten Apps. Ein vollstaendiger Leitfaden zu neuen Features, Leistungsgewinnen und interview-relevantem Wissen fuer .NET-Entwickler 2026.
DbContext Lebensdauer in ASP.NET Core: Performance versus Thread-Sicherheit bei Async-Operationen
DbContext Lebensdauer in ASP.NET Core optimal verwalten: Scoped versus Transient, Thread-Sicherheit bei async Operationen und Performance-Optimierung mit DbContext Pooling.
Clean Code Architecture C#: Vollständiger Leitfaden und Interview-Fragen 2026
Umfassender Leitfaden zur Clean Code Architecture in C# mit SOLID-Prinzipien, Schichtenarchitektur und den häufigsten technischen Interview-Fragen für .NET-Entwickler.