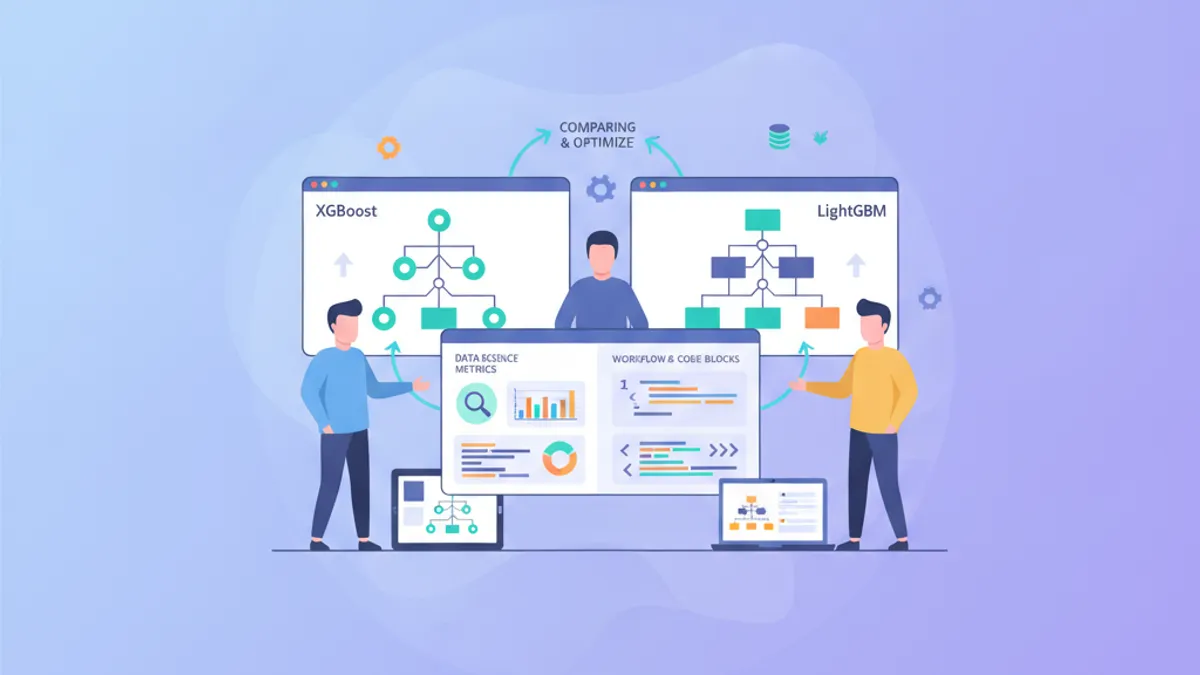
XGBoost vs LightGBM 2026: Gradient Boosting und Data-Science-Interviewfragen
XGBoost vs LightGBM im Vergleich: Hyperparameter-Tuning, kategorische Features und häufige Interview-Fragen für Data Scientists mit praktischen Python-Beispielen.
Umfassendes Data-Science- und Machine-Learning-Curriculum mit Python als Hauptsprache. Von der Datenmanipulation mit Pandas und NumPy bis zur Implementierung von Deep-Learning-Modellen mit TensorFlow/Keras, über klassisches ML mit Scikit-Learn. Beinhaltet auch MLOps-Fähigkeiten zum Deployen und Warten von Modellen in Produktion mit Docker, FastAPI und Cloud-Plattformen.
Modernes Python mit objektorientierter Programmierung und Best Practices
Datenmanipulation mit Pandas, NumPy und SQL (BigQuery)
Visualisierung mit Matplotlib, Seaborn und Plotly
Deskriptive und inferenzielle Statistik mit Statsmodel
Machine Learning mit Scikit-Learn und XGBoost (Regression, Klassifikation, Clustering)
Deep Learning mit TensorFlow und Keras (CNN, RNN, Transformers)
NLP und GenAI mit Hugging Face, LangChain und LLMs (GPT, Gemini)
MLOps mit MLflow, Docker, FastAPI und Streamlit
Entwicklungsumgebungen: Jupyter, Google Colab
Cloud-Deployment mit Google Compute, Cloud Storage und GPU
Die wichtigsten Konzepte, um diese Technologie zu verstehen und deine Interviews zu bestehen
Python: Typen, Datenstrukturen, OOP, Decorators, Generators, Context Managers
NumPy: Arrays, Broadcasting, Indexing, vektorisierte Operationen, lineare Algebra
Pandas: DataFrames, Series, Indexing, groupby, merge, pivot, Zeitreihen
SQL: SELECT, JOIN, GROUP BY, Window Functions, CTEs, Abfrageoptimierung
Visualisierung: Matplotlib (Figures, Axes, Subplots), Seaborn (statistische Plots), Plotly (interaktiv)
Statistik: Verteilungen, Hypothesentests, Konfidenzintervalle, Regression
Feature Engineering: Encoding, Skalierung, Feature-Auswahl, Feature-Erstellung
Überwachtes ML: Lineare/logistische Regression, Bäume, Random Forest, XGBoost, Metriken
Unüberwachtes ML: K-Means, hierarchisches Clustering, PCA, t-SNE
ML-Pipeline: Train/Test Split, Cross-Validation, Hyperparameter-Tuning, Overfitting
Deep Learning: Perzeptronen, Backpropagation, Aktivierungsfunktionen, Optimizer, Verlustfunktionen
CNN: Faltungen, Pooling, Architekturen (ResNet, VGG), Transfer Learning
RNN/LSTM: Sequenzen, Vanishing Gradient, Attention-Mechanismus, Transformers
NLP: Tokenisierung, Embeddings, word2vec, BERT, LLM-Feinabstimmung
MLOps: Versionierung (MLflow), Containerisierung (Docker), API (FastAPI), Monitoring
Cloud: Google Cloud (Compute, Storage, BigQuery), GPU-Training, Vertex AI
KI-Ethik: Bias, Erklärbarkeit (SHAP, LIME), Fairness, DSGVO
Ein Ausschnitt pro Tag. Finde den Bug, oder beweise, dass es keinen gibt.
Festanstellung und Freelance, mit Land, Remote und Gehalt, sofern veröffentlicht. Täglich aktualisiert, Abonnenten vorbehalten.
Entdecke unsere neuesten Artikel und Anleitungen zu Data Science & ML
XGBoost vs LightGBM im Vergleich: Hyperparameter-Tuning, kategorische Features und häufige Interview-Fragen für Data Scientists mit praktischen Python-Beispielen.
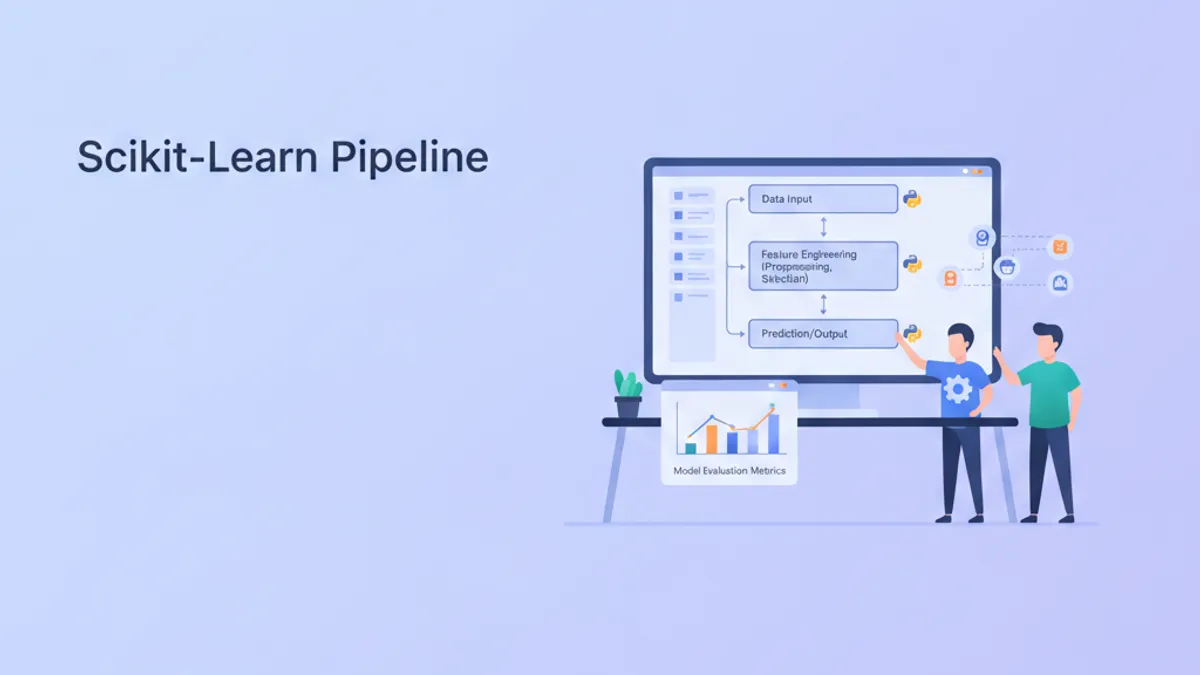
Scikit-learn Pipelines mit ColumnTransformer für Feature Engineering meistern. Preprocessing-Best-Practices und Vorbereitung auf ML-Interviews.
Leitfaden für statistische Konzepte in Data-Science-Interviews: Wahrscheinlichkeitsverteilungen, Hypothesentests, Konfidenzintervalle und häufige Fragen bei Google, Meta und Netflix.