SRE-Prinzipien 2026: Reliability Engineering, SLOs und Interviewfragen
SRE-Prinzipien für 2026 erklärt: SLIs auswählen, SLOs festlegen, Error Budgets berechnen, Burn-Rate-Alerts mit mehreren Zeitfenstern in Prometheus schreiben und die typischen SRE-Interviewfragen sicher beantworten.
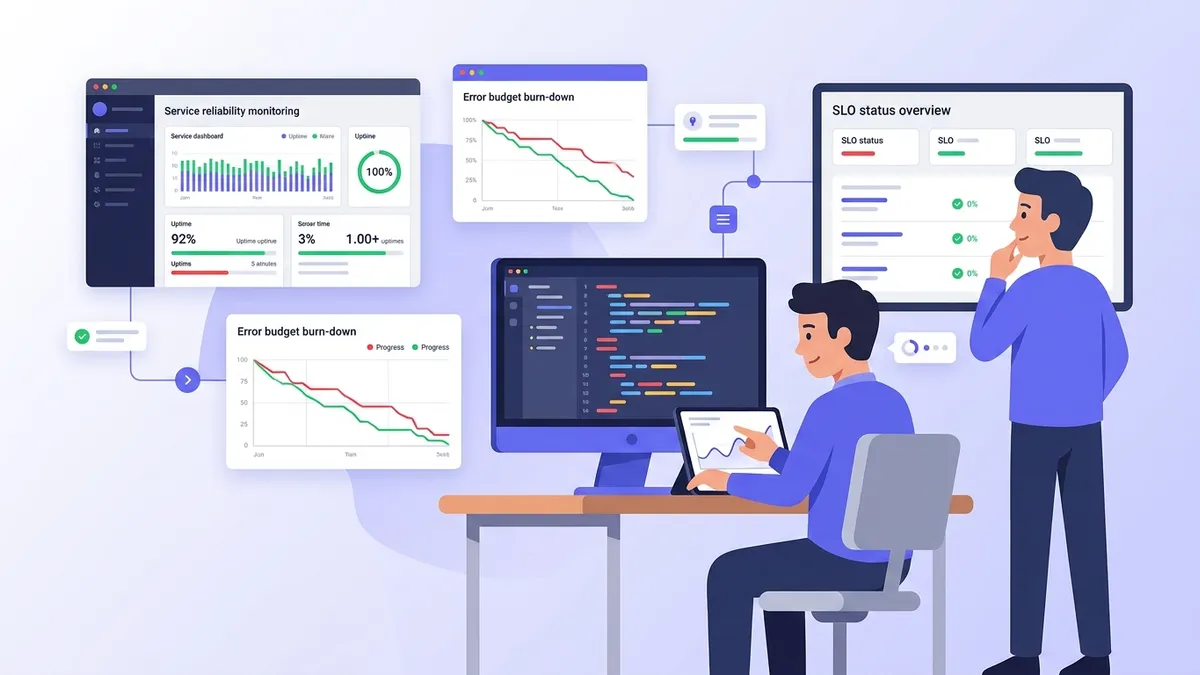
Zuverlässigkeit ist in vielen Teams ein Gefühl: Das System „läuft meistens“, bis es eben nicht mehr läuft. Die SRE-Prinzipien ersetzen dieses Gefühl durch eine Zahl, auf die sich Entwicklung und Produktmanagement vorab einigen, und leiten daraus ab, wann ausgeliefert und wann gebremst wird. Site Reliability Engineering, ursprünglich bei Google entstanden und heute fester Bestandteil der meisten Plattform-Teams, beruht auf wenigen Grundgedanken: messen, was Nutzer tatsächlich erleben (SLIs), ein Ziel unterhalb von 100 % setzen (SLOs), die Differenz bewusst als Error Budget ausgeben und manuelle Betriebsarbeit begrenzen. Genau diese Gedanken prüfen SRE-Interviewfragen im Jahr 2026, meist mit der Aufgabe, für einen realen Dienst ein SLO zu definieren und den passenden Alert zu schreiben.
Ein SLI ist eine Messgröße: das Verhältnis guter Ereignisse zu gültigen Ereignissen, etwa erfolgreiche Requests geteilt durch alle Requests. Ein SLO ist der interne Zielwert für dieses Verhältnis über ein Zeitfenster, zum Beispiel 99,9 % über 30 Tage. Ein SLA ist das vertragliche Versprechen gegenüber Kunden mit Vertragsstrafen und liegt immer unterhalb des SLO.
Die Grundprinzipien des Site Reliability Engineering
Das Google-SRE-Buch behandelt Zuverlässigkeit als Feature mit einem Preis. Jede zusätzliche Neun kostet Entwicklungszeit und verlangsamt Releases, während Nutzer den Unterschied zwischen 99,99 % und 99,999 % kaum bemerken: Ihr eigenes WLAN, ihr Mobilfunknetz und ihr Endgerät sind weniger zuverlässig als das. Angestrebt wird daher das passende Maß an Zuverlässigkeit, nicht das maximale.
Daraus ergeben sich einige zentrale Prinzipien:
- Zuverlässigkeit wird aus Nutzersicht gemessen. CPU-Last und Pod-Neustarts sind Ursachen. Abgebrochene Bestellungen und langsame Seiten sind das, was Nutzer erleben, und genau das bildet ein SLI ab.
- 100 % ist das falsche Ziel. Ein SLO von 100 % verbietet jede Änderung, denn jedes Deployment birgt ein Risiko. Der Abstand zu 100 % ist das Error Budget, und es ist dafür gedacht, für Releases, Experimente und Migrationen ausgegeben zu werden.
- Toil wird gedeckelt. Laut dem Kapitel zur Beseitigung von Toil soll operative Routinearbeit unter 50 % der Arbeitszeit eines SRE bleiben. Toil ist manuell, repetitiv, automatisierbar und wächst linear mit dem Dienst. Die übrige Zeit fließt in Engineering, das diese Arbeit abschafft.
- Postmortems sind blameless. Eine Incident-Analyse fragt, was im System den Fehler ermöglicht hat, nicht wer den Befehl eingetippt hat. Wer Schuldzuweisungen fürchtet, hält Informationen zurück; ein schuldfreies Review bringt sie ans Licht.
- Alerts reagieren auf Symptome. Ein Page wird ausgelöst, wenn Nutzer betroffen sind oder es gleich sein werden, nicht wenn ein einzelner Knoten auffällig aussieht.
Im Vorstellungsgespräch trennt vor allem der zweite Punkt erfahrene SREs von Kandidaten, die das Buch nur gelesen haben. Eine Junior-Antwort versteht das Error Budget als Fehlertoleranz. Eine Senior-Antwort beschreibt es als Werkzeug des Release-Managements: als Mechanismus, mit dem Produkt und Betrieb anhand von Daten statt Meinungen verhandeln.
SLIs auswählen, die das Nutzererlebnis abbilden
Ein gutes SLI ist ein Verhältnis zwischen 0 und 1, berechnet aus Ereignissen, die ein Nutzer wiedererkennen würde. Das SRE Workbook empfiehlt je nach Diensttyp eine kurze Auswahl:
| Diensttyp | Typische SLIs | Messpunkt |
|---|---|---|
| Request-basierte API | Verfügbarkeit, Latenz | Logs von Load Balancer oder Ingress, Server-Metriken |
| Datenpipeline | Aktualität, Korrektheit, Abdeckung | Zeitstempel der Pipeline-Ausgabe, Validierungsjobs |
| Speichersystem | Dauerhaftigkeit, Lese- und Schreiblatenz | Speicherschicht, synthetische Probes |
| Frontend | Ladezeit, im Browser sichtbare Fehlerrate | Real User Monitoring |
Die Messung am Load Balancer erfasst Fehler, die die Anwendung selbst nie bemerkt, etwa einen abgestürzten Pod, der gar nicht antwortet. Die Messung im Browser deckt CDN- und DNS-Probleme auf, bringt aber Rauschen durch schlechte Mobilverbindungen mit. Die meisten Teams starten am Load Balancer oder Ingress, weil die Daten dort ohnehin vorliegen.
Mit Prometheus sind die beiden klassischen SLIs eines HTTP-Dienstes ein Verfügbarkeitsverhältnis und ein Latenzverhältnis. Das Latenz-SLI zählt Requests unterhalb eines Schwellenwerts als gut. Dadurch wird es zu einem Verhältnis wie die anderen und nicht zu einem Perzentil.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Zwei Details kommen in Interviews regelmäßig zur Sprache. Erstens gelten 4xx-Antworten in der Regel als gültig und gut, denn ein 404 oder ein Validierungsfehler ist ein Fehler des Clients; würden sie als Ausfälle zählen, könnte ein fehlerhafter Client das Budget allein aufbrauchen. Zweitens muss der Latenzschwellenwert einer Bucket-Grenze des Histogramms entsprechen, sonst liefert die Abfrage nichts oder greift unbemerkt auf den falschen Bucket zurück. Prometheus 3.16, veröffentlicht am 5. November 2026, unterstützt native Histogramme, die diese Einschränkung fester Buckets aufheben, aber auf Scrape-Seite aktiviert werden müssen.
SLO-Ziele festlegen und das Error Budget berechnen
Ein SLO besteht aus einem SLI, einem Zielwert und einem Zeitfenster. Das Fenster ist meist rollierend, 28 oder 30 Tage, damit sich das Budget schrittweise erholt, statt am Monatsersten schlagartig zurückgesetzt zu werden. Der Zielwert ergibt sich aus der bisherigen Performance und den Erwartungen der Nutzer, nicht aus dem, was auf einer Folie gut aussieht.
Die folgende Tabelle zeigt, was jedes Ziel über ein 30-Tage-Fenster erlaubt. Es handelt sich um einfache Arithmetik: Das Budget beträgt (1 - SLO) × 30 Tage.
| SLO-Ziel | Error Budget | Erlaubter Totalausfall in 30 Tagen |
|---|---|---|
| 99 % | 1 % | 7 h 12 min |
| 99,5 % | 0,5 % | 3 h 36 min |
| 99,9 % | 0,1 % | 43 min 12 s |
| 99,95 % | 0,05 % | 21 min 36 s |
| 99,99 % | 0,01 % | 4 min 19 s |
Bei request-basierten SLOs wird das Budget in Requests statt in Minuten ausgedrückt: Bei 99,9 % und 12 Millionen Requests im Fenster sind 12.000 fehlgeschlagene Requests zulässig. Diese Variante ist für Dienste mit schwankendem Traffic fairer, weil ein Ausfall um 3 Uhr nachts weniger Budget kostet als derselbe Ausfall zur Spitzenlast.
Eine typische Interviewaufgabe besteht darin, das verbleibende Budget und die Geschwindigkeit seines Verbrauchs zu berechnen. Das folgende Skript entspricht der Art von Antwort, die erwartet wird, wenn ausdrücklich Code gefragt ist.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Eine Burn Rate von 15 bedeutet, dass 1,5 % der Requests fehlschlagen, während das SLO nur 0,1 % erlaubt. In diesem Tempo sind die verbleibenden 35 % des Budgets in weniger als 17 Stunden aufgebraucht. Das rechtfertigt es, jemanden aus dem Schlaf zu holen.
Bereit für deine DevOps-Interviews?
Übe mit unseren interaktiven Simulatoren, Flashcards und technischen Tests.
Burn-Rate-Alerting mit mehreren Zeitfenstern
Ein Alert direkt auf dem SLI („Fehlerrate über 0,1 %“) erzeugt Pages bei jeder kurzen Spitze und übersieht schleichende Verluste. Das Workbook-Kapitel zum Alerting auf SLOs empfiehlt stattdessen Alerts mit mehreren Fenstern und mehreren Burn Rates. Jeder Alert beantwortet genau eine Frage: Wird das Budget so schnell verbraucht, dass es aufgebraucht ist, bevor sich jemand darum kümmert?
Die Referenzwerte für ein 30-Tage-Fenster lauten:
| Schweregrad | Langes Fenster | Kurzes Fenster | Burn Rate | Verbrauchtes Budget beim Auslösen |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2 % |
| Page | 6 h | 30 min | 6 | 5 % |
| Ticket | 3 Tage | 6 h | 1 | 10 % |
Das lange Fenster sorgt für Aussagekraft: Eine einzelne schlechte Minute löst keinen Page aus. Das kurze Fenster, ein Zwölftel des langen, lässt den Alert nach dem Ende des Incidents schnell zurückfallen, sodass er nicht noch eine Stunde nach dem Fix weiterfeuert. Beide Bedingungen müssen gleichzeitig erfüllt sein.
Der erste Block speichert die Fehlerquote je Fenster als Recording Rule, damit die Alert-Ausdrücke günstig bleiben. Der zweite Block definiert die beiden Paging-Alerts für ein SLO von 99,9 %, bei dem der Budgetanteil 0,001 beträgt.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageDiese Regeln für jeden Dienst von Hand zu schreiben, wird schnell eintönig. Sloth, ein Open-Source-Generator für SLOs, erzeugt aus einer kurzen Spezifikation die oben gezeigten Recording Rules und Multi-Burn-Rate-Alerts. Der Platzhalter {{.window}} wird dabei durch jedes von Sloth benötigte Zeitfenster ersetzt.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Teams, die ein herstellerneutrales Format bevorzugen, greifen zur OpenSLO-Spezifikation, die SLOs unabhängig vom Monitoring-Backend in YAML beschreibt.
Error-Budget-Policy und Release-Entscheidungen
Ein Error Budget ohne Policy ist ein Dashboard, auf das niemand reagiert. Die Beispiel-Policy im SRE Workbook legt fest, was passiert, wenn das Budget aufgebraucht ist, und wer dem im Voraus zugestimmt hat.
Eine typische Policy umfasst:
- Den Auslöser. Der Dienst hat sein Error Budget im rollierenden Fenster überschritten.
- Die Konsequenz. Feature-Releases werden gestoppt, ausgenommen Sicherheitsfixes und Änderungen, die die Zuverlässigkeit verbessern, bis der Dienst wieder innerhalb seines SLO liegt.
- Den Ausnahmeweg. Ein einzelner Incident, verursacht durch eine Abhängigkeit außerhalb der Kontrolle des Teams, kann ausgeklammert werden, sofern die Entscheidung dokumentiert wird.
- Die Eskalation. Bei Uneinigkeit entscheidet eine benannte Rolle, etwa der CTO, und nicht derjenige, der am lautesten argumentiert.
Produkt und Engineering unterzeichnen die Policy vor dem ersten Verstoß. Genau darin liegt ihr Wert: Der Release-Stopp wird zur vorab vereinbarten Regel statt zum Streit mitten im Incident. Interviewer fragen häufig, was zu tun ist, wenn das Budget dauerhaft unangetastet bleibt. Die erwartete Antwort: Das SLO ist womöglich zu locker oder das Team liefert zu vorsichtig aus, und das Budget sollte für schnellere Releases oder riskantere Migrationen genutzt werden.
Wird das interne SLO mit dem Kunden-SLA gleichgesetzt, bleibt kein Puffer: Der erste Verstoß gegen das SLO ist bereits eine Vertragsverletzung. Das SLO muss strenger sein als das SLA, damit Alerts feuern und der Release-Stopp greift, solange der Vertrag noch eingehalten wird.
Toil reduzieren, On-Call organisieren, Postmortems ohne Schuldzuweisung
Die Arbeitszeit eines SRE teilt sich in Betrieb und Engineering. Zum Betrieb gehören Rufbereitschaft, Tickets und manuelle Eingriffe, zum Engineering Automatisierung, Kapazitätsplanung und Zuverlässigkeitsfeatures. Übersteigt Toil die 50-%-Grenze, gibt das SRE-Team Arbeit an das Entwicklungsteam zurück oder investiert in Automatisierung. Andernfalls wird es zu einem klassischen Betriebsteam mit neuem Namen.
Die Gesundheit der Rufbereitschaft wird gemessen, nicht angenommen. Aussagekräftige Kennzahlen sind Pages pro Schicht, der Anteil der Pages, die tatsächlich eine Aktion erforderten, und die Zeit bis zur Bestätigung. Ein Page ohne notwendige Aktion ist ein Fehler im Alerting und wird korrigiert oder gelöscht. Symptombasierte Alerts auf den SLO-Verbrauch, wie in den Regeln oben, senken das Page-Aufkommen deutlich im Vergleich zu Alerts auf CPU, Speicher oder einzelne Pod-Neustarts.
Nach einem Incident folgt das Review, wie es das Kapitel zur Postmortem-Kultur im SRE-Buch beschreibt. Ein Postmortem dokumentiert die Auswirkung in SLO-Begriffen (wie viel Budget verbraucht wurde), die Zeitleiste, die beitragenden Faktoren sowie Maßnahmen mit Verantwortlichen und Fristen. Eine Person als Ursache wird dabei nicht benannt. Zwei Nachfragen sind im Interview üblich: Wie wird sichergestellt, dass Maßnahmen tatsächlich umgesetzt werden (im selben Backlog wie Features führen und in einem festen Termin nachverfolgen)? Und wann ist ein Postmortem Pflicht (bei jedem Incident mit nennenswertem Budgetverbrauch, bei jedem nächtlichen Page, bei jedem Datenverlust)?
Die vier Golden Signals aus dem SRE-Buch, also Latenz, Traffic, Fehler und Sättigung, vervollständigen das Monitoring-Bild. Latenz und Fehler werden meist zu SLIs. Traffic und Sättigung fließen eher in Kapazitätsplanung und Dashboards ein als in Pages.
SRE-Interviewfragen mit erwarteten Antworten
Die folgenden Fragen tauchen in SRE- und Senior-DevOps-Interviews immer wieder auf, jeweils mit dem Kern einer starken Antwort. Das Interviewmodul zu SRE-Prinzipien vertieft dieselben Themen, und das Modul zu Alerting und Incident Response deckt die On-Call-Seite ab.
F: Was unterscheidet ein SLI, ein SLO und ein SLA?
Das SLI ist das gemessene Verhältnis, das SLO der interne Zielwert dafür über ein Zeitfenster, das SLA der externe Vertrag mit Strafen. Das SLO ist strenger als das SLA, damit das Team reagiert, bevor Geld verloren geht.
F: Warum nicht einfach ein SLO von 100 %?
Weil jede Änderung ein Risiko trägt und ein Ziel von 100 % damit Releases verbietet. Zudem können Nutzer keine Zuverlässigkeit wahrnehmen, die über der ihres eigenen Netzes liegt. Der Abstand zu 100 % ist das Error Budget, das Releases finanziert.
F: Wie sieht ein SLO für eine Checkout-API aus?
Eine starke Antwort wählt zwei SLIs (Verfügbarkeit ohne 4xx, Latenz unter einem Schwellenwert am Load Balancer), ein rollierendes 30-Tage-Fenster und Zielwerte auf Basis der Daten des letzten Quartals. Außerdem erklärt sie, wie Alerting und Error-Budget-Policy daraus folgen. Nur „99,99 % Uptime“ zu nennen, ohne zu sagen, was gemessen wird, ist die klassische schwache Antwort.
F: Warum eignen sich Alerts auf die p99-Latenz schlecht als SLO-Alert?
Ein p99 über ein kurzes Fenster ist verrauscht und lässt sich nicht über Instanzen hinweg aggregieren. Wird Latenz als Anteil der Requests unterhalb eines Schwellenwerts ausgedrückt, ist sie additiv, mit dem Verfügbarkeits-SLI vergleichbar und mit Burn-Rate-Alerts kompatibel.
F: Was ist die Burn Rate, und warum nutzen Alerts zwei Fenster?
Die Burn Rate ist die beobachtete Fehlerquote geteilt durch den Budgetanteil; ein Wert von 1 bedeutet, dass das Budget genau für das Fenster reicht. Das lange Fenster filtert kurze Spitzen heraus, das kurze lässt den Alert nach der Erholung schnell verschwinden.
F: Was ist Toil, und wie wird er unter Kontrolle gehalten?
Manuelle, repetitive, automatisierbare Arbeit ohne bleibenden Wert, die mit dem Dienst mitwächst. Toil wird gemessen, gedeckelt (Google nutzt 50 %) und durch Automatisierung oder durch Rückgabe an das verantwortliche Team reduziert.
F: Was macht ein Postmortem blameless?
Es konzentriert sich auf die Systembedingungen, die den Fehler ermöglicht haben, geht davon aus, dass alle Beteiligten mit den verfügbaren Informationen vernünftig gehandelt haben, und liefert nachverfolgte Maßnahmen. Der Prüfstein: Würde die beteiligte Person jedes Detail ohne Angst offenlegen?
Auf SLO-Fragen folgen im selben Gespräch oft Fragen zum Monitoring. Der Leitfaden zu Prometheus-Interviewfragen behandelt PromQL, Metriktypen und Kardinalität, und die DevOps-Technologieseite listet alle Module für eine breitere Vorbereitung auf.
SLOs und Error Budgets in der Praxis: das Wichtigste
- Jedes SLI als Verhältnis guter zu gültigen Ereignissen definieren, so nah am Nutzer gemessen, wie es die Daten erlauben, und 4xx bei den meisten APIs nicht als Fehler zählen
- Das SLO aus historischen Daten und einem rollierenden Fenster von 28 oder 30 Tagen ableiten und strenger halten als jedes Kunden-SLA
- Den Zielwert in ein Budget aus Minuten oder Requests umrechnen und die Zahlen auswendig kennen: 99,9 % über 30 Tage entsprechen 43 Minuten
- Auf die Burn Rate mit gekoppelten Fenstern alarmieren (14,4 über 1 h und 5 min, 6 über 6 h und 30 min), nicht auf die rohe Fehlerrate oder die CPU
- Regeln mit Sloth oder einem vergleichbaren Werkzeug generieren, sobald mehr als eine Handvoll Dienste SLOs hat, damit die Schwellenwerte konsistent bleiben
- Die Error-Budget-Policy vor dem ersten Verstoß schreiben und unterzeichnen, inklusive Release-Stopp und Eskalationsweg
- Toil, Page-Aufkommen und Postmortem-Maßnahmen mit derselben Sorgfalt verfolgen wie Features
Fang an zu üben!
Teste dein Wissen mit unseren Interview-Simulatoren und technischen Tests.
Findest du den Bug in DevOps?
Ein echter Codeausschnitt, ein versteckter Bug, ein Versuch pro Tag. Zum Ausprobieren ohne Konto.

Geschrieben von
Anthony Fillion-MailletGründer von SharpSkill
Seit über 10 Jahren Fullstack-Entwickler. Er leitet SharpSkill und verantwortet alles, was hier erscheint.
Aktualisiert am 7. November 2026
Tags
Teilen
Verwandte Artikel

Prometheus-Interviewfragen 2026: Prometheus vs Grafana vs Datadog im Vergleich
Prometheus-Interviewfragen für DevOps- und SRE-Rollen mit Antworten zu PromQL, Metriktypen, Cardinality und HA, dazu ein Vergleich von Prometheus, Grafana und Datadog bei Architektur, Alerting und Preisen.
Ansible vs Terraform 2026: Infrastructure as Code und DevOps-Interviewfragen
Ein umfassender Vergleich von Ansible und Terraform für DevOps-Interviews. State Management, deklarative vs prozedurale Ansätze und Best Practices für Infrastructure as Code.
Terraform-Interviewfragen: Der vollständige Leitfaden für Infrastructure as Code 2026
Umfassender Leitfaden zu Terraform-Interviewfragen mit State-Management, Moduldesign, CI/CD-Pipelines und fortgeschrittenen IaC-Konzepten für 2026.