Excel Power Query 2026: ETL für Datenanalysten und Interviewfragen
Umfassende Anleitung zu Excel Power Query für ETL-Workflows, M-Sprache und häufige Interviewfragen für Datenanalysten.
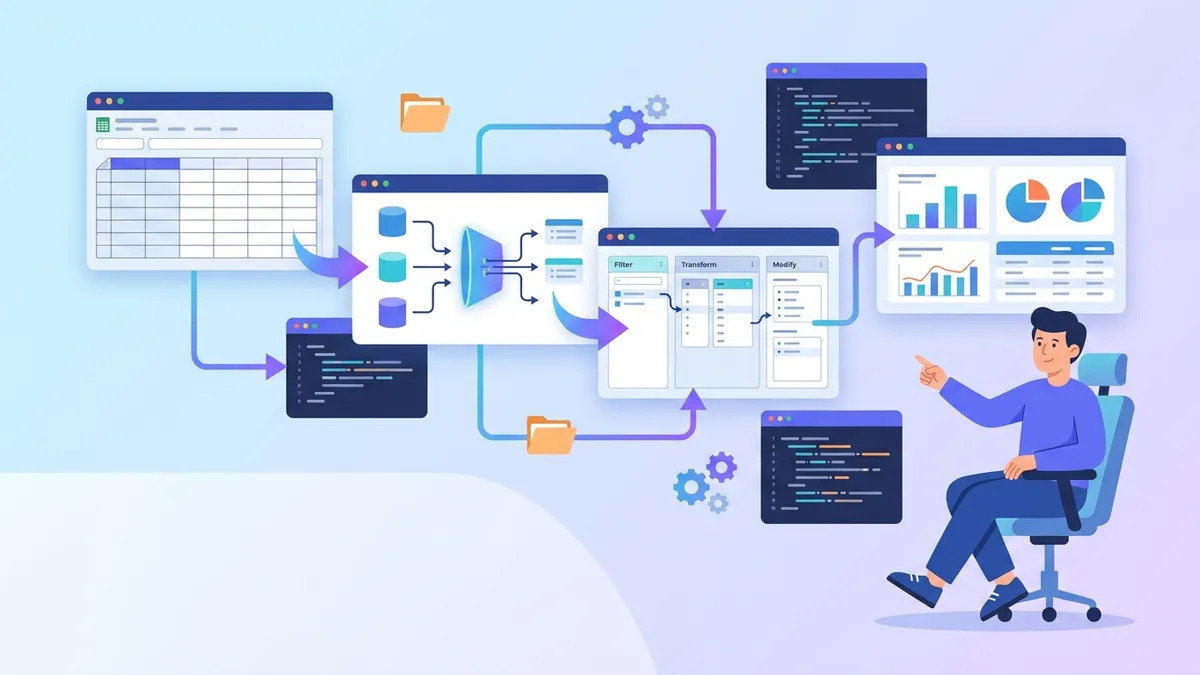
Excel Power Query verändert grundlegend, wie Datenanalysten ETL-Prozesse (Extract, Transform, Load) direkt in Excel durchführen. Im Gegensatz zu manuellem Kopieren oder komplexen VBA-Makros bietet Power Query eine visuelle Oberfläche, die von der M-Sprache unterstützt wird. Dies ermöglicht wiederholbare Datentransformationen, die sich mit einem einzigen Klick aktualisieren lassen.
Power Query ist in Excel 365, Excel 2021, Excel 2019 und Excel 2016 integriert. In früheren Versionen war es als kostenloses Add-In namens "Power Query für Excel" verfügbar. Dieselbe Engine treibt auch Power BI Desktop Dataflows an.
Welche Probleme Power Query für Datenanalysten löst
Datenanalysten verbringen erhebliche Zeit mit der Datenvorbereitung: Zusammenführen von Dateien aus verschiedenen Quellen, Bereinigen inkonsistenter Formate, Filtern irrelevanter Zeilen und Umstrukturieren von Tabellen für die Analyse. Power Query adressiert diese Aufgaben durch einen Query-Editor, der jeden Transformationsschritt aufzeichnet. Wenn sich die Quelldaten ändern, wird die gesamte Pipeline automatisch erneut ausgeführt.
Der Workflow folgt drei Phasen: Verbindung zu Datenquellen herstellen, Transformationen anwenden und Ergebnisse in Excel-Tabellen oder das Datenmodell laden. Jeder Schritt wird in einer Formelleiste mit M-Sprachsyntax aufgezeichnet, die für fortgeschrittene Szenarien direkt bearbeitet werden kann.
Dieser Ansatz unterscheidet sich von traditionellen Excel-Formeln. Während Formeln Zellen neu berechnen, arbeitet Power Query mit ganzen Tabellen, bevor sie das Arbeitsblatt erreichen. Eine Abfrage, die 50 CSV-Dateien konsolidiert, Duplikate entfernt und Spalten entpivotiert, wird einmal ausgeführt und erzeugt eine saubere Tabelle, anstatt komplexe verschachtelte Formeln zu erstellen, die die Arbeitsmappe verlangsamen.
Verbindung zu Datenquellen mit Daten abrufen
Power Query unterstützt Verbindungen zu Dateien (CSV, Excel, JSON, XML), Datenbanken (SQL Server, MySQL, PostgreSQL, Oracle), Cloud-Diensten (SharePoint, Azure, Salesforce) und Webseiten. Der Verbindungstyp bestimmt, welche Authentifizierungs- und Importoptionen erscheinen.
// Häufige Datenquellen in Power Query
Daten > Daten abrufen > Aus Datei > Aus CSV
Daten > Daten abrufen > Aus Datenbank > Aus SQL Server-Datenbank
Daten > Daten abrufen > Aus anderen Quellen > Aus dem Web
Daten > Daten abrufen > Aus Ordner (mehrere Dateien)
Die Option "Aus Ordner" ist besonders nützlich für die Konsolidierung mehrerer Dateien. Anstatt jede Datei einzeln zu importieren, durchsucht Power Query einen Ordner, listet alle passenden Dateien auf und kombiniert sie in einer einzigen Abfrage. Das Hinzufügen einer neuen Datei zum Ordner schließt diese automatisch bei der nächsten Aktualisierung ein.
Bei der Verbindung zu einer SQL-Datenbank kann Power Query Transformationslogik durch Query Folding an den Server übertragen. Filter und Spaltenauswahlen werden in SQL WHERE- und SELECT-Klauseln übersetzt, wodurch die an Excel übertragene Datenmenge reduziert wird. Die Formelleiste zeigt eine Option "Native Abfrage anzeigen", wenn Folding aktiv ist.
Kerntransformationen im Abfrage-Editor
Der Abfrage-Editor bietet Menüband-Befehle für häufige Operationen, aber das Verständnis des zugrundeliegenden M-Codes hilft, wenn Anpassungen erforderlich sind. Jede Transformation fügt einen Schritt zum Bereich "Angewendete Schritte" hinzu und erstellt eine überprüfbare Sequenz.
Filtern und Sortieren von Zeilen
Filtern entfernt Zeilen, die bestimmte Kriterien nicht erfüllen. Das Dropdown-Menü der Spaltenüberschrift bietet schnelle Filter, während der Dialog "Zeilen filtern" komplexe Bedingungen mit AND/OR-Logik unterstützt.
// FilteredRows-Schritt in M-Sprache
let
    Source = Excel.CurrentWorkbook(){[Name="SalesData"]}[Content],
    FilteredRows = Table.SelectRows(Source, each [Region] = "EMEA" and [Amount] > 1000)
in
    FilteredRows
Die Funktion Table.SelectRows nimmt eine Tabelle und eine Bedingung entgegen. Das Schlüsselwort each erstellt eine Funktion, in der _ die aktuelle Zeile repräsentiert, und der Feldzugriff verwendet Klammernotation [Region]. Mehrere Bedingungen werden mit and oder or Operatoren kombiniert.
Entfernen und Umbenennen von Spalten
Datenquellen enthalten oft Spalten, die für die Analyse nicht benötigt werden. Frühzeitiges Entfernen reduziert den Speicherverbrauch und vereinfacht nachfolgende Schritte.
// Spalten entfernen, dann verbleibende umbenennen
let
    Source = Excel.CurrentWorkbook(){[Name="RawData"]}[Content],
    RemovedColumns = Table.RemoveColumns(Source, {"TempID", "InternalNotes", "Debug"}),
    RenamedColumns = Table.RenameColumns(RemovedColumns, {{"Cust_Name", "CustomerName"}, {"Amt", "Amount"}})
in
    RenamedColumns
Die Spaltenliste verwendet geschweifte Klammern {} für mehrere Elemente. Umbenennung erfordert eine Liste von Paaren, wobei jedes Paar den alten Namen und neuen Namen enthält. Konsistente Namenskonventionen über Abfragen hinweg erleichtern das Kombinieren von Datensätzen.
Aufteilen und Zusammenführen von Spalten
Textspalten erfordern häufig Parsing. Eine "FullName"-Spalte muss möglicherweise in Vor- und Nachnamen aufgeteilt werden, oder separate Datums- und Zeitspalten müssen zusammengeführt werden.
// FullName durch Trennzeichen in zwei Spalten aufteilen
let
    Source = Excel.CurrentWorkbook(){[Name="Contacts"]}[Content],
    SplitColumn = Table.SplitColumn(Source, "FullName", Splitter.SplitTextByDelimiter(" ", QuoteStyle.Csv), {"FirstName", "LastName"})
in
    SplitColumn
Die Funktion Splitter.SplitTextByDelimiter übernimmt die Parsing-Logik. Für komplexere Muster bieten Splitter.SplitTextByEachDelimiter oder Splitter.SplitTextByPositions zusätzliche Kontrolle. Wenn die Anzahl der resultierenden Spalten variiert, erstellt Power Query Spalten dynamisch.
Typkonvertierungen und Datenqualität
Power Query leitet Spaltentypen beim Import ab, aber explizite Typzuweisung erkennt Fehler frühzeitig. Eine Textspalte mit numerischen IDs sollte Text bleiben, wenn führende Nullen wichtig sind. Als Text importierte Datumsspalten verursachen Sortierprobleme.
// Explizite Typzuweisungen
let
    Source = Csv.Document(File.Contents("C:\\Data\\transactions.csv")),
    TypedColumns = Table.TransformColumnTypes(Source, {
        {"TransactionID", type text},
        {"Date", type date},
        {"Amount", type number},
        {"IsProcessed", type logical}
    })
in
    TypedColumns
Das Schlüsselwort type gibt den Zieltyp an. Verfügbare Typen umfassen text, number, date, datetime, datetimezone, time, duration, logical und binary. Typfehler erscheinen als "Error"-Werte in Zellen, wodurch Datenqualitätsprobleme vor der Analyse sichtbar werden.
Die Behandlung von Nullwerten erfordert explizite Logik. Die Funktion Table.ReplaceValue ersetzt Nullwerte durch Standardwerte, während Table.SelectRows mit [Column] <> null sie herausfiltert.
Gruppierung und Aggregation mit Gruppieren nach
Das Aggregieren von Daten nach Kategorien ist eine häufige Anforderung. Die "Gruppieren nach"-Transformation fasst Zeilen mit denselben Schlüsselwerten zusammen und wendet Aggregatfunktionen an.
// Verkäufe nach Region und Jahr gruppieren, Summe und Anzahl berechnen
let
    Source = Excel.CurrentWorkbook(){[Name="Sales"]}[Content],
    Grouped = Table.Group(Source, {"Region", "Year"}, {
        {"TotalSales", each List.Sum([Amount]), type number},
        {"OrderCount", each Table.RowCount(_), Int64.Type},
        {"AvgOrderValue", each List.Average([Amount]), type number}
    })
in
    Grouped
Die Gruppierungsspalten erscheinen zuerst, gefolgt von Aggregationsdefinitionen. Jede Aggregation spezifiziert einen neuen Spaltennamen, eine Aggregationsfunktion und einen optionalen Ergebnistyp. Das Schlüsselwort each repräsentiert die Untertabelle für jede Gruppe und ermöglicht beliebige Tabellen- oder Listenfunktionen.
Verschachtelte Aggregationen ermöglichen Berechnungen wie "Prozentsatz der Gruppensumme", indem sowohl der Zeilenwert als auch das Gruppenaggregat in einem nachfolgenden Schritt referenziert werden.
Bereit für deine Data Analytics-Interviews?
Übe mit unseren interaktiven Simulatoren, Flashcards und technischen Tests.
Pivotieren und Entpivotieren zur Datenumstrukturierung
Pivotieren konvertiert Zeilenwerte in Spalten und erstellt ein Kreuztabellen-Layout. Entpivotieren macht das Gegenteil und konvertiert Spalten in Zeilen für normalisierte Strukturen.
// Monatsspalten in Zeilen entpivotieren
let
    Source = Excel.CurrentWorkbook(){[Name="MonthlySales"]}[Content],
    // Original: Product, Jan, Feb, Mar, Apr Spalten
    Unpivoted = Table.UnpivotOtherColumns(Source, {"Product"}, "Month", "Sales")
    // Ergebnis: Product, Month, Sales Spalten
in
    Unpivoted
Die Funktion Table.UnpivotOtherColumns behält angegebene Spalten fest und entpivotiert den Rest. Dies ist sicherer als alle zu entpivotierenden Spalten aufzulisten, da das Hinzufügen neuer Monatsspalten diese automatisch einschließt. Die beiden abschließenden Parameter benennen die Attributspalte ("Month") und Wertspalte ("Sales").
Pivotieren verwendet Table.Pivot mit einer Aggregationsfunktion für Fälle, in denen mehrere Werte für dieselbe Zeilen-Spalten-Kombination existieren:
// Verkäufe nach Region pivotieren
let
    Source = Excel.CurrentWorkbook(){[Name="DetailedSales"]}[Content],
    Pivoted = Table.Pivot(Source, List.Distinct(Source[Region]), "Region", "Amount", List.Sum)
in
    Pivoted
Zusammenführen und Anfügen von Abfragen
Das Kombinieren von Daten aus mehreren Quellen ist der Bereich, in dem Power Query manuellen Aufwand reduziert. Zusammenführen führt einen Join zwischen zwei Tabellen basierend auf übereinstimmenden Spalten durch. Anfügen stapelt Tabellen vertikal.
// Left Join: Bestellungen mit Kundendetails
let
    Orders = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    Customers = Excel.CurrentWorkbook(){[Name="Customers"]}[Content],
    Merged = Table.NestedJoin(Orders, {"CustomerID"}, Customers, {"ID"}, "CustomerDetails", JoinKind.LeftOuter),
    Expanded = Table.ExpandTableColumn(Merged, "CustomerDetails", {"Name", "Email"})
in
    Expanded
Die Funktion Table.NestedJoin erstellt eine verschachtelte Tabellenspalte mit übereinstimmenden Zeilen. Die Funktion Table.ExpandTableColumn flacht dann die verschachtelte Struktur in reguläre Spalten ab. Join-Arten umfassen Inner, LeftOuter, RightOuter, FullOuter, LeftAnti und RightAnti.
Anfügen mit Table.Combine erfordert übereinstimmende Spaltennamen. Wenn Schemata abweichen, stellt Table.SelectColumns auf jeder Quelle vor dem Kombinieren Konsistenz sicher:
// Zwei Verkaufstabellen mit konsistenten Spalten anfügen
let
    Sales2024 = Table.SelectColumns(Source2024, {"Date", "Product", "Amount"}),
    Sales2025 = Table.SelectColumns(Source2025, {"Date", "Product", "Amount"}),
    Combined = Table.Combine({Sales2024, Sales2025})
in
    Combined
Benutzerdefinierte Spalten und bedingte Logik
Die Funktion "Spalte hinzufügen > Benutzerdefinierte Spalte" ermöglicht berechnete Felder mit M-Ausdrücken. Bedingte Logik verwendet if-then-else-Syntax.
// Berechnete Spalte mit bedingter Logik hinzufügen
let
    Source = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    AddedColumn = Table.AddColumn(Source, "OrderCategory", each
        if [Amount] >= 10000 then "Enterprise"
        else if [Amount] >= 1000 then "Business"
        else "Consumer",
        type text
    )
in
    AddedColumn
Der if-Ausdruck muss sowohl then- als auch else-Zweige enthalten. Verschachtelte Bedingungen verketten sich mit else if. Der letzte Parameter spezifiziert den Spaltentyp und verbessert die Leistung sowie verhindert Typinferenzprobleme.
Für komplexe Transformationen halten Hilfsfunktionen, die im let-Block definiert werden, den Code lesbar:
let
    // Hilfsfunktion für Geschäftsquartal
    GetFiscalQuarter = (date as date) as text =>
        let
            month = Date.Month(date),
            fiscalQ = if month >= 4 and month <= 6 then "Q1"
                     else if month >= 7 and month <= 9 then "Q2"
                     else if month >= 10 and month <= 12 then "Q3"
                     else "Q4"
        in
            fiscalQ,

    Source = Excel.CurrentWorkbook(){[Name="Transactions"]}[Content],
    AddedQuarter = Table.AddColumn(Source, "FiscalQuarter", each GetFiscalQuarter([Date]), type text)
in
    AddedQuarter
Fehlerbehandlung in Power Query
Transformationsfehler erscheinen als "Error"-Werte in Zellen, anstatt die gesamte Abfrage zum Scheitern zu bringen. Das try-otherwise-Konstrukt behandelt Fehler elegant:
// Potenzielle Divisionsfehler behandeln
let
    Source = Excel.CurrentWorkbook(){[Name="Metrics"]}[Content],
    AddedRatio = Table.AddColumn(Source, "Ratio", each
        try [Value1] / [Value2] otherwise null,
        type number
    )
in
    AddedRatio
Das Schlüsselwort try versucht den Ausdruck und gibt einen Datensatz mit HasError- und Value-Feldern zurück. Die otherwise-Klausel bietet einen Fallback, wenn HasError true ist. Für mehr Kontrolle kann auf die Fehlerdetails mit try Expression zugegriffen werden:
// Fehlerdetails erfassen
let
    result = try SomeRiskyFunction(),
    output = if result[HasError] then "Error: " & result[Error][Message] else result[Value]
in
    output
Power Query Interviewfragen für Datenanalysten
Interviewer bewerten sowohl praktische Fähigkeiten als auch das Verständnis dafür, wann Power Query in einen Workflow passt. Diese Fragen erscheinen häufig in Interviews für Datenanalysten.
Was ist Query Folding und warum ist es wichtig?
Query Folding übersetzt Power Query-Transformationen in native Abfragen für die Datenquelle. Bei der Verbindung zu SQL Server wird ein Filterschritt zu einer WHERE-Klausel, die auf dem Server ausgeführt wird, wodurch die Netzwerkübertragung reduziert wird. Nicht alle Transformationen werden gefaltet: benutzerdefinierte M-Funktionen, bestimmte Datumsmanipulationen und Operationen nach einem nicht-faltenden Schritt unterbrechen die Kette. Der Folding-Status kann überprüft werden, indem mit der rechten Maustaste auf einen Schritt geklickt und nach "Native Abfrage anzeigen" gesucht wird.
Wie unterscheidet sich Power Query von Excel-Formeln für Datentransformation?
Excel-Formeln arbeiten zellenweise innerhalb des Arbeitsblatts und berechnen bei jeder Änderung neu. Power Query arbeitet mit Tabellen, bevor sie das Arbeitsblatt erreichen, und verarbeitet Daten während der Aktualisierung in großen Mengen. Für Transformationen wie Entpivotieren, Deduplizierung oder das Zusammenführen von Dateien drückt Power Query die Logik direkter aus als verschachtelte INDEX-VERGLEICH oder Hilfsspalten.
Wann würde man Power Query anstelle von Power BI für ETL wählen?
Power Query in Excel eignet sich für Szenarien, in denen Analysten transformierte Daten in Tabellenform für Ad-hoc-Analysen, Pivot-Tabellen oder zum Teilen mit Benutzern benötigen, die keinen Power BI-Zugang haben. Power BI bietet reichhaltigere Visualisierung, größere Datenkapazität und Enterprise-Sharing-Funktionen. Derselbe M-Code funktioniert in beiden Tools, sodass in Excel entwickelte Abfragen ohne Neuentwicklung zu Power BI Desktop migriert werden können.
Wie werden Datentypkonflikte beim Anfügen von Tabellen behandelt?
Explizite Typen sollten auf jeder Quelltabelle vor dem Kombinieren mit Table.Combine festgelegt werden. Wenn eine Spalte in einer Quelle Text und in einer anderen Zahl ist, schlägt das Anfügen fehl oder erzeugt Fehler. Table.TransformColumnTypes wird auf beiden Quellen verwendet, um konsistente Typen zu erzwingen. Das try-otherwise-Muster behandelt Randfälle, in denen die Konvertierung für bestimmte Werte fehlschlägt.
Erklären Sie den Unterschied zwischen Zusammenführen und Anfügen in Power Query.
Zusammenführen führt einen horizontalen Join basierend auf übereinstimmenden Schlüsselspalten durch, ähnlich wie SQL JOIN. Anfügen führt eine vertikale Vereinigung von Zeilen aus mehreren Tabellen durch, ähnlich wie SQL UNION ALL. Zusammenführen erfordert mindestens eine gemeinsame Spalte zum Abgleich. Anfügen erfordert Spalten mit denselben Namen für eine korrekte Ausrichtung.
Für eine tiefere Vorbereitung zu SQL-Konzepten, die Power Query-Fähigkeiten ergänzen, behandelt das SQL-Fensterfunktionen-Modul Ranking- und Aggregationsmuster, während das SQL-Unterabfragen- und CTEs-Modul Techniken zur Abfragestrukturierung adressiert.
Ladeoptionen und Aktualisierungsstrategien
Nach den Transformationen bietet die Schaltfläche "Schließen & Laden" verschiedene Ladeoptionen: Laden in eine Arbeitsblatttabelle, nur ins Datenmodell laden (Power Pivot) oder eine Verbindungsabfrage erstellen. Verbindungsabfragen dienen als Staging-Schritte für andere Abfragen, ohne Arbeitsblattplatz zu belegen.
Das Aktualisierungsverhalten hängt vom Ladeziel ab. Arbeitsblatttabellen aktualisieren sich mit der Schaltfläche "Alle aktualisieren" oder können so eingestellt werden, dass sie beim Öffnen der Datei aktualisiert werden. Datenmodelltabellen nehmen am Aktualisierungszyklus des Datenmodells der Arbeitsmappe teil. Bei Abfragen, die mit externen Datenbanken verbunden sind, können Anmeldeaufforderungen bei der Aktualisierung erscheinen, wenn keine gespeicherten Anmeldedaten existieren.
Hintergrundaktualisierung ermöglicht die Weiterarbeit in der Arbeitsmappe während des Datenladens, schafft aber Komplexität, wenn nachgelagerte Formeln von aktualisierten Daten abhängen. Die Option "Hintergrundaktualisierung aktivieren" in den Abfrageeigenschaften steuert dieses Verhalten. Für kritische Berichte stellt das Deaktivieren der Hintergrundaktualisierung eine sequentielle Ausführung sicher.
Leistungsüberlegungen für große Datensätze
Power Query kann Millionen von Zeilen verarbeiten, aber die Reaktionsfähigkeit der Arbeitsmappe hängt davon ab, wie die Daten geladen werden. Das Laden ins Datenmodell anstelle von Arbeitsblatttabellen vermeidet Excels Zeilenlimit und verbessert die Pivot-Tabellen-Leistung. Das frühzeitige Entfernen unnötiger Spalten reduziert den Speicherbedarf.
Für Abfragen, die mehrere Minuten dauern, zeigt die "Datenvorschau" im Abfrage-Editor nur eine Stichprobe. Transformationen werden während der Aktualisierung auf den vollständigen Datensatz angewendet. In der Vorschau sichtbare Fehler weisen auf Probleme hin, aber einige Fehler erscheinen erst bei vollständigen Daten. Ein Testlauf der Aktualisierung auf einer Teilmenge validiert die Abfrage, bevor alles verarbeitet wird.
Beim Konsolidieren vieler Dateien verarbeitet Power Querys Binärkombinationsfunktion Dateien parallel. Das Definieren einer Funktion, die eine Datei transformiert, und dann deren Aufruf für jede Zeile in der Dateiliste, bietet mehr Kontrolle als der Standard-Kombinationsansatz.
Die Microsoft-Dokumentation zu Power Query Best Practices beschreibt Optimierungstechniken einschließlich Abfrageabhängigkeitsstrukturen und Puffernutzung.
Power Query für wiederholbare ETL-Pipelines
Die aufgezeichneten Schritte in Power Query erstellen eine Dokumentation der Transformationslogik. Wenn sich Anforderungen ändern, aktualisiert das Modifizieren eines Schritts automatisch alle nachfolgenden Schritte. Dies steht im Gegensatz zu Ad-hoc-Excel-Manipulationen, die bei Änderungen der Quelldaten von Grund auf neu erstellt werden müssen.
Teams können Abfragen teilen, indem sie Verbindungen exportieren oder den M-Code der Abfrage in der Versionskontrolle speichern. Der erweiterte Editor (Ansicht > Erweiterter Editor) zeigt das vollständige M-Skript an, das kopiert und in eine andere Arbeitsmappe eingefügt werden kann. Für Unternehmensszenarien bieten Power BI Dataflows und Fabric zentralisiertes Abfragemanagement.
- Power Query behandelt ETL innerhalb von Excel mit aufgezeichneten, wiederholbaren Transformationsschritten
- Die M-Sprache, die der visuellen Oberfläche zugrunde liegt, ermöglicht Anpassungen über Menüband-Befehle hinaus
- Query Folding überträgt Filter und Projektionen an Quelldatenbanken für bessere Leistung
- Zusammenführen führt Joins zwischen Tabellen durch, Anfügen stapelt Tabellen vertikal
- Typzuweisungen und Fehlerbehandlung verhindern stille Datenqualitätsprobleme
- Verbindungsabfragen erstellen wiederverwendbare Staging-Schritte ohne Arbeitsblattausgabe
- Interviewfragen konzentrieren sich auf Query Folding, Formelvergleiche und Unterschiede zwischen Zusammenführen und Anfügen
Fang an zu üben!
Teste dein Wissen mit unseren Interview-Simulatoren und technischen Tests.
Findest du den Bug in Data Analytics?
Ein echter Codeausschnitt, ein versteckter Bug, ein Versuch pro Tag. Zum Ausprobieren ohne Konto.
Geschrieben von
Anthony Fillion-MailletGründer von SharpSkill
Seit über 10 Jahren Fullstack-Entwickler. Er leitet SharpSkill und verantwortet alles, was hier erscheint.
Aktualisiert am 20. September 2026
Teilen
Verwandte Artikel
Data Analyst Bewerbungsfragen 2026: Umfassender Leitfaden für SQL, Python und Analytics
Die wichtigsten Interviewfragen für Data Analysts 2026 mit SQL-Window-Functions, Python-Pandas-Übungen und Business-Case-Beispielen für erfolgreiche Bewerbungsgespräche.
Data Analyst Vorstellungsgespräch Italien 2026: SQL, Python und Fallstudien für den italienischen Markt
Vorbereitungsguide für Data Analyst Interviews in Italien 2026. SQL Window Functions, Python Pandas mit italienischen Datenformaten und Case Studies von Mailänder Unternehmen.
Polars vs Pandas 2026: Performance, Syntax und Interviewfragen für Data Analysten
Ein umfassender Vergleich zwischen Polars und Pandas im Jahr 2026. Benchmark-Ergebnisse, Syntax-Unterschiede und typische Interviewfragen für Data Analysten und Data Engineers.