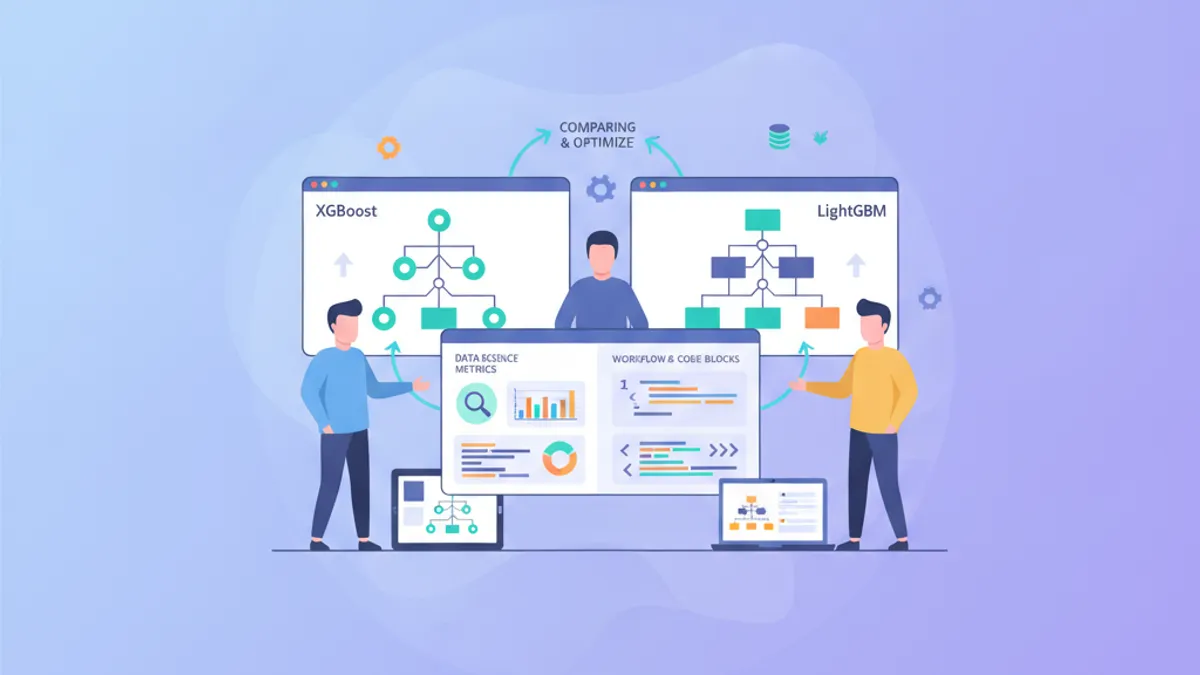
XGBoost vs LightGBM у 2026: Gradient Boosting та Питання на Співбесідах з Data Science
Комплексне порівняння XGBoost та LightGBM у 2026 році. Архітектурні відмінності, техніки оптимізації та підготовка до питань на співбесідах з machine learning.
Комплексна програма Data Science та Machine Learning з Python як основною мовою. Від маніпулювання даними з Pandas та NumPy до реалізації моделей Deep Learning з TensorFlow/Keras, через класичний ML з Scikit-Learn. Включає також навички MLOps для розгортання та підтримки моделей у продакшн з Docker, FastAPI та хмарними платформами.
Сучасний Python з об'єктно-орієнтованим програмуванням та кращими практиками
Маніпулювання даними з Pandas, NumPy та SQL (BigQuery)
Візуалізація з Matplotlib, Seaborn та Plotly
Описова та інференційна статистика з Statsmodel
Machine Learning з Scikit-Learn та XGBoost (регресія, класифікація, кластеризація)
Deep Learning з TensorFlow та Keras (CNN, RNN, Transformer)
NLP та GenAI з Hugging Face, LangChain та LLM (GPT, Gemini)
MLOps з MLflow, Docker, FastAPI та Streamlit
Середовища розробки: Jupyter, Google Colab
Хмарне розгортання з Google Compute, Cloud Storage та GPU
Найважливіші концепції для розуміння цієї технології та проходження співбесід
Python: типи, структури даних, ООП, декоратори, генератори, контекстні менеджери
NumPy: масиви, broadcasting, індексування, векторизовані операції, лінійна алгебра
Pandas: DataFrame, Series, індексування, groupby, merge, pivot, часові ряди
SQL: SELECT, JOIN, GROUP BY, window function, CTE, оптимізація запитів
Візуалізація: Matplotlib (figure, axes, subplot), Seaborn (статистичні графіки), Plotly (інтерактивні)
Статистика: розподіли, перевірка гіпотез, довірчі інтервали, регресія
Feature Engineering: кодування, масштабування, відбір ознак, створення ознак
Керований ML: лінійна/логістична регресія, дерева, Random Forest, XGBoost, метрики
Некерований ML: K-Means, ієрархічна кластеризація, PCA, t-SNE
ML Pipeline: поділ train/test, крос-валідація, налаштування гіперпараметрів, перенавчання
Deep Learning: перцептрон, зворотне поширення, функції активації, оптимізатори, функції втрат
CNN: згортки, pooling, архітектури (ResNet, VGG), transfer learning
RNN/LSTM: послідовності, зникаючий градієнт, механізм уваги, Transformer
NLP: токенізація, embedding, word2vec, BERT, тонке налаштування LLM
MLOps: версіонування (MLflow), контейнеризація (Docker), API (FastAPI), моніторинг
Хмара: Google Cloud (Compute, Storage, BigQuery), тренування на GPU, Vertex AI
Етика AI: упередженість, пояснюваність (SHAP, LIME), справедливість, GDPR
Один фрагмент на день. Знайди баг або доведи, що його немає.
Постійні позиції та фриланс, із країною, remote і зарплатою, коли її опубліковано. Оновлюються щодня, доступні лише підписникам.
Відкрий наші найновіші статті та посібники про Data Science & ML
Комплексне порівняння XGBoost та LightGBM у 2026 році. Архітектурні відмінності, техніки оптимізації та підготовка до питань на співбесідах з machine learning.
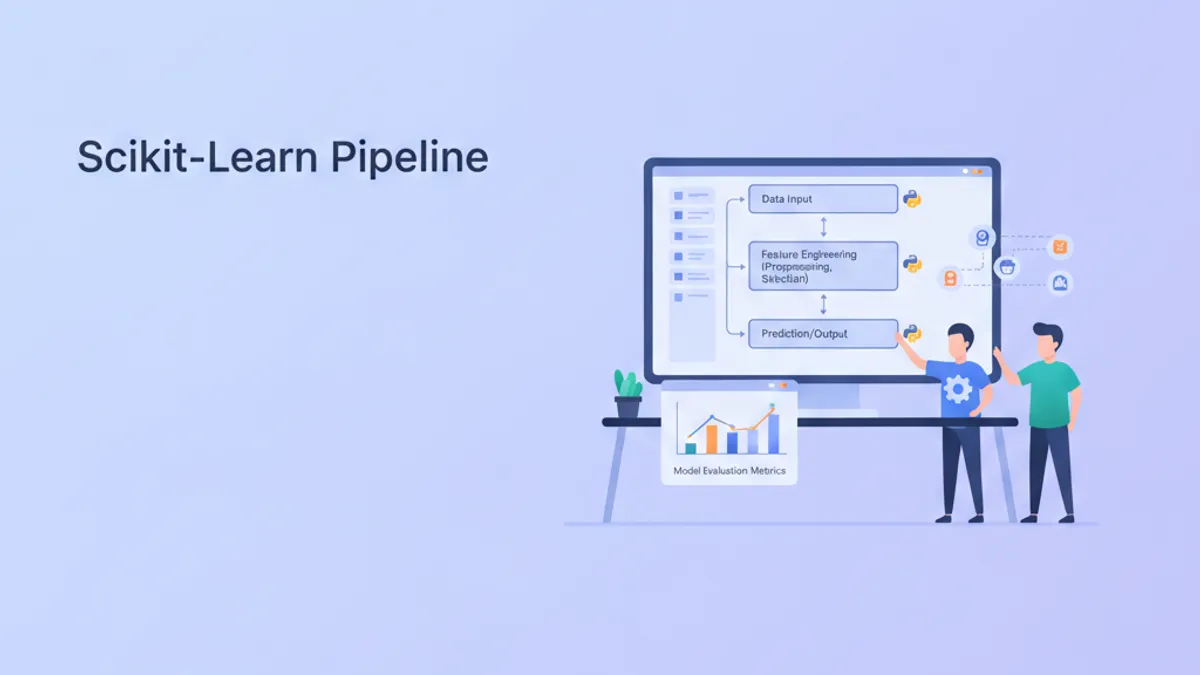
Повний посібник з Scikit-learn Pipeline та ColumnTransformer. Охоплює інженерію ознак, запобігання витоку даних та питання зі співбесід з машинного навчання.
Повний посібник зі статистики для data science: розподіли ймовірностей, перевірка гіпотез, довірчі інтервали та найпоширеніші питання на співбесідах з практичними прикладами на Python.