Data Engineering

Data Engineering

DATA

Комплексна програма Data Engineering, що охоплює весь ланцюжок виробництва даних. Від налаштування середовища з Docker та GCP до оркестрації pipeline з Airflow та dbt, через створення Data Warehouse з BigQuery та PostgreSQL. Навчись обробляти data streaming з PySpark, Pub/Sub та Apache Beam, та розгортати у продакшн з Kubernetes та Terraform. Опануй кращі практики CI/CD, моніторингу та сучасних архітектур даних.

Чому ти навчишся

Середовища розробки: Linux, Git, GitHub, VS Code, розширений Python

CI/CD та якість коду: Ruff, Pylint, Poetry, GitHub Actions

Контейнеризація з Docker та Docker Compose

API з FastAPI: проєктування, розгортання, документація

Data Lake: збір, зберігання, організація сирих даних

Data Warehouse з BigQuery: схеми, розділення, оптимізація

PostgreSQL: встановлення, адміністрування, порівняння з managed-рішеннями

Збір даних з Fivetran та Airbyte

Трансформація з dbt: моделі, тести, документація, модульність

Оркестрація з Apache Airflow: DAG, планування, моніторинг

Big Data з PySpark: масштабні трансформації

Data streaming: Google Pub/Sub, Apache Beam, Dataflow

Kubernetes: розгортання контейнерів, масштабування, продакшн-кластери

Infrastructure as Code з Terraform

Розширені бази даних: GraphDB, Document DB, Wide Column DB

Логування, моніторинг та спостережуваність pipeline

Ключові теми для опанування

Найважливіші концепції для розуміння цієї технології та проходження співбесід

1

Linux та Shell: основні команди, bash-скрипти, дозволи, cron-завдання

2

Git та GitHub: гілки, merge, rebase, pull request, CI/CD-процеси

3

Розширений Python: ООП, декоратори, генератори, контекстні менеджери, typing, async/await

4

CI/CD: linting (Ruff, Pylint), пакування (Poetry), тести, GitHub Actions, pipeline

5

Docker: Dockerfile, образи, контейнери, томи, мережі, multi-stage build

6

Docker Compose: багатоконтейнерні сервіси, залежності, healthcheck, локальна оркестрація

7

FastAPI: маршрути, моделі Pydantic, залежності, middleware, розгортання

8

Розширений SQL: window function, CTE, аналітичні запити, оптимізація, індексування

9

BigQuery: serverless-архітектура, розділення, кластеризація, витрати, UDF, федеративні запити

10

PostgreSQL: конфігурація, реплікація, індексування (B-tree, GIN, GiST), VACUUM, EXPLAIN ANALYZE

11

Моделювання даних: схема зірки, таблиці фактів/вимірів, нормалізація, SCD, data vault

12

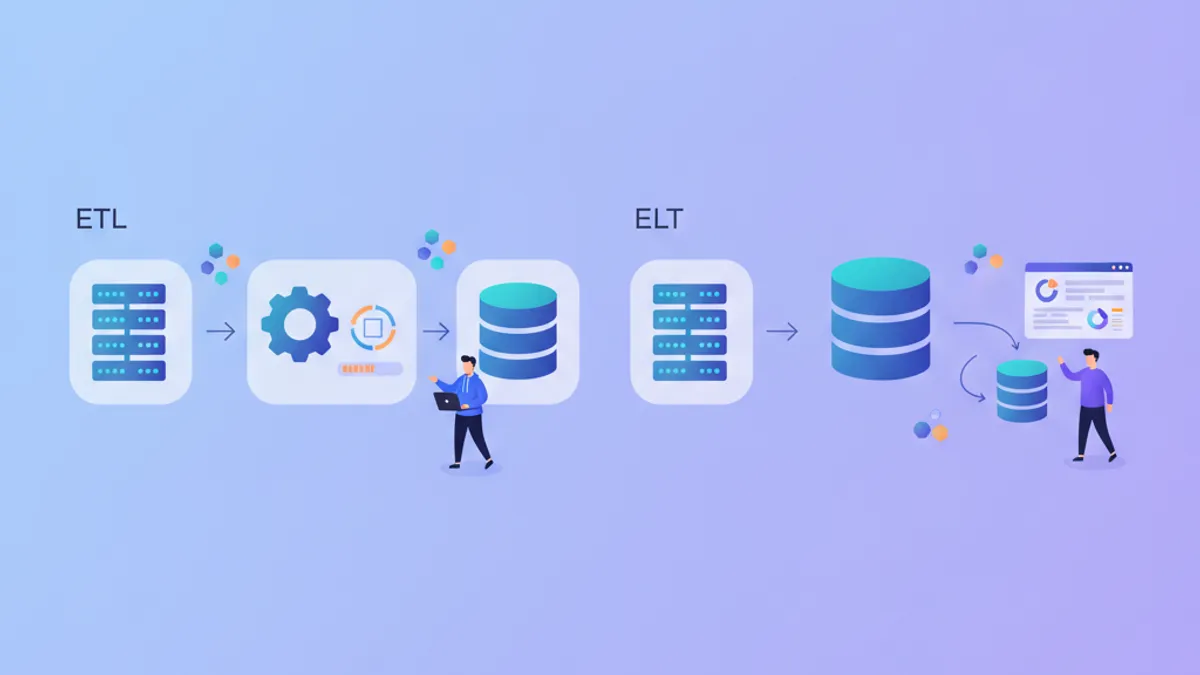
ELT vs ETL vs ETLT: патерни, компроміси, архітектурні рішення

13

Fivetran та Airbyte: конектори, режими синхронізації, CDC, еволюція схеми

14

dbt: моделі, джерела, ref, тести, snapshot, інкрементальні моделі, Jinja-макроси

15

Apache Airflow: DAG, оператори, сенсори, XCom, з'єднання, пули, залежності завдань

16

PySpark: RDD vs DataFrame, трансформації, дії, розділення, broadcast-змінні

17

Streaming: Pub/Sub (теми, підписки), Apache Beam (PCollection, трансформації, windowing), Dataflow

18

Kubernetes: pod, deployment, service, ingress, ConfigMap, Secret, Helm, масштабування

19

Terraform: провайдери, ресурси, стан, модулі, plan/apply, infrastructure as code

20

IAM та безпека: принцип мінімальних привілеїв, сервісні акаунти, ролі GCP

21

NoSQL бази даних: GraphDB (Neo4j), Document DB (MongoDB, Firestore), Wide Column (Cassandra, Bigtable)

22

Архітектура даних: Data Lake vs Data Warehouse vs Data Lakehouse, Data Mesh, Data Contract

23

Моніторинг та спостережуваність: логування, метрики, сповіщення, SLA/SLO/SLI, перевірки якості даних
Сьогоднішнє завдання Data Engineering

Один фрагмент на день. Знайди баг або доведи, що його немає.

Зіграти сьогодні

1 150 вакансій Data Engineering онлайн

Постійні позиції та фриланс, із країною, remote і зарплатою, коли її опубліковано. Оновлюються щодня, доступні лише підписникам.

Ринок Data Engineering

Нещодавні статті про Data Engineering

Відкрий наші найновіші статті та посібники про Data Engineering

Переглянути всі статті про Data Engineering