RAG та LLM у 2026: Retrieval-Augmented Generation для співбесід з data science
Retrieval-Augmented Generation (RAG) пояснений для співбесід з data science у 2026 році. Векторні бази, стратегії chunking, моделі векторизації, agentic RAG, Graph RAG та архітектура конвеєра, готового до продакшну.
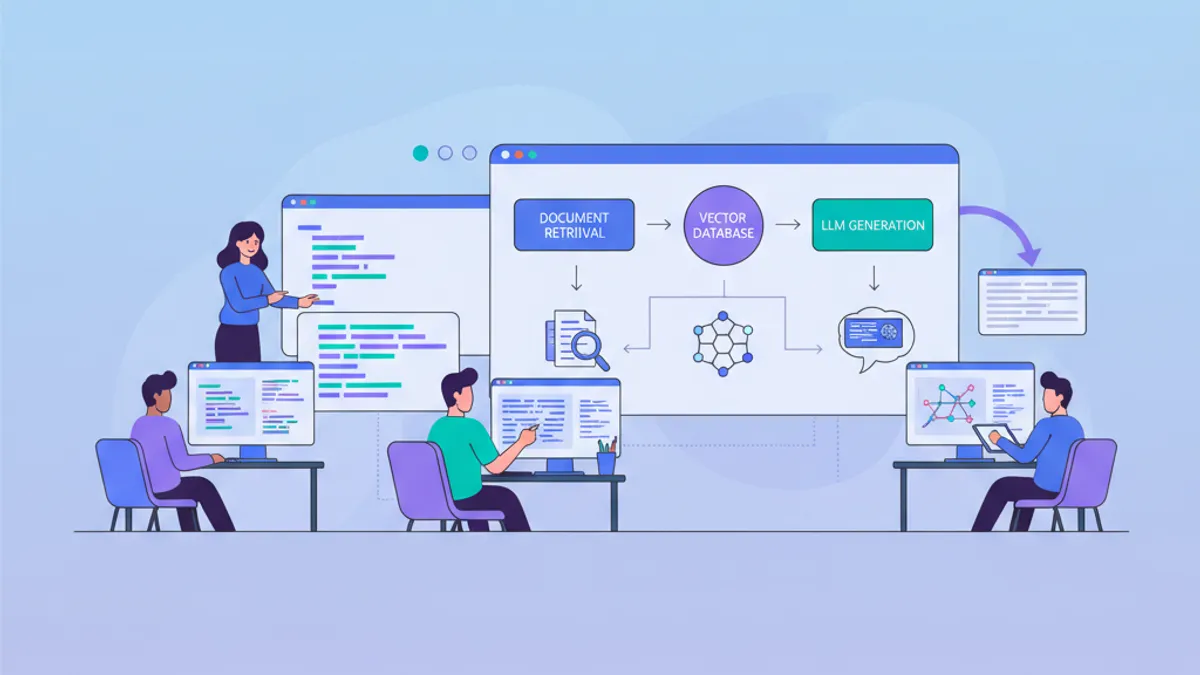
Retrieval-Augmented Generation (RAG) став стандартною архітектурою для прив'язки відповідей LLM до фактичних та актуальних даних. На співбесідах з data science та інженерії штучного інтелекту у 2026 році питання про RAG тепер з'являються поряд із класичними темами ML, перевіряючи як системне мислення, так і практичні навички реалізації.
Retrieval-Augmented Generation поєднує систему пошуку (векторний пошук по базі знань) із генератором LLM, тож модель відповідає на основі реальних документів, а не покладається на запам'ятовані тренувальні дані.
Як працює конвеєр RAG від початку до кінця
Система RAG працює у дві фази: офлайн-фаза інжесту, що будує базу знань, та онлайн-фаза запитів, що отримує релевантний контекст і генерує відповідь.
Під час інжесту сирі документи проходять очищення, розбиття на фрагменти (chunking) та векторизацію (embedding), перш ніж потрапити до векторної бази. Під час інференсу запит користувача йде тим самим шляхом векторизації, а пошук найближчих сусідів отримує найрелевантніші фрагменти. Ці фрагменти стають частиною промпта LLM, прив'язуючи згенеровану відповідь до вихідного матеріалу.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Цей конвеєр охоплює основний цикл RAG: розбий, векторизуй, збережи, отримай, згенеруй. Параметр search_type="mmr" гарантує, що отримані фрагменти є водночас релевантними та різноманітними, зменшуючи надлишковість у вікні контексту.
Стратегії chunking, які справді мають значення
Chunking визначає якість пошуку більше за будь-який інший компонент. Поганий chunking означає, що пошуковик повертає фрагменти, яким або бракує контексту, або вони розбавляють сигнал нерелевантним вмістом.
У продакшн-системах 2026 року домінують три підходи до chunking:
Chunking фіксованого розміру розбиває текст за встановленою кількістю токенів (зазвичай від 256 до 512 токенів) із перекриттям (overlap). Простий у реалізації, але розриває речення та думки посередині.
Семантичний chunking виявляє межі тем, вимірюючи схожість векторів між сусідніми реченнями. Коли схожість падає нижче порогу, починається новий фрагмент. Кожен фрагмент несе цілісну думку, а не довільний зріз тексту.
Пізній chunking (late chunking) спершу застосовує модель-трансформер до всього документа, створюючи контекстні вектори токенів, і лише потім розбиває на фрагменти. Це зберігає далекосяжні залежності, які традиційний chunking руйнує.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Ключове усвідомлення для співбесіди: розмір фрагмента це компроміс між точністю та повнотою (precision-recall). Малі фрагменти (100 токенів) підвищують точність пошуку, але фрагментують контекст. Великі фрагменти (1000 токенів) зберігають контекст, але розбавляють специфічність векторів. Більшість продакшн-систем зупиняється на 256 до 512 токенах із 10 до 20% перекриттям.
Векторні бази та моделі векторизації у продакшні
Векторна база зберігає вектори та підтримує швидкий приблизний пошук найближчих сусідів (ANN). Вибір правильної комбінації моделі векторизації та векторної бази безпосередньо впливає на затримку та точність пошуку.
Моделі векторизації у 2026 році зосередилися навколо кількох високопродуктивних варіантів. text-embedding-3-large від OpenAI (3072 виміри) та опенсорсні альтернативи, як-от bge-m3 від BAAI чи embed-v4 від Cohere, пропонують потужний багатомовний пошук. Лідерборд MTEB залишається стандартним бенчмарком для порівняння якості векторизації. Варто зазначити, що text-embedding-3-large підтримує Matryoshka representation learning, що дозволяє зменшення розмірності (до 1024 або 256) з мінімальною втратою якості, суттєво знижуючи витрати на зберігання.
Ринок векторних баз консолідувався у 2026 році. Чотири продукти обслуговують переважну більшість продакшн-навантажень RAG:
| База | Індексація | Керована | Сильна сторона |
|---|---|---|---|
| Pinecone | Власна | Так | Нуль операцій, вбудований інференс, гібридний пошук |
| Weaviate | HNSW | Так/Самостійно | Нативна фузія BM25 + dense в одному запиті |
| Qdrant | HNSW | Так/Самостійно | Продуктивність Rust, фільтрація payload, найкращий безкоштовний рівень |
| pgvector | IVF, HNSW | Самостійно | Інтеграція з PostgreSQL для існуючих стеків |
Для обговорень на співбесіді ключовим є розуміння алгоритму HNSW (Hierarchical Navigable Small World): він будує багатошаровий граф, де кожен вузол з'єднується з найближчими сусідами, забезпечуючи пошук O(log n) ціною вищого споживання пам'яті.
Точка перелому витрат становить 60 до 80 мільйонів запитів на місяць. Вище цього порогу самостійно розгорнутий Qdrant або Weaviate на інфраструктурі з фіксованою вартістю стабільно перевершує керований Pinecone Serverless у 3x до 10x разів.
Готовий до співбесід з Data Science & ML?
Практикуйся з нашими інтерактивними симуляторами, flashcards та технічними тестами.
Гібридний пошук: поєднання щільного та розрідженого пошуку
Чистий векторний пошук зазнає невдачі при точних збігах ключових слів та рідкісних термінах. Чистий лексичний пошук (BM25) пропускає семантичну схожість. Гібридний пошук поєднує обидва підходи, і у 2026 році це стандарт за замовчуванням для продакшн-систем RAG.
Стандартний патерн використовує Reciprocal Rank Fusion (RRF) для злиття ранжованих результатів обох пошуковиків:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Гібридний пошук вирішує проблему розбіжності словника, коли користувач запитує про скасування підписки, а релевантний документ використовує формулювання політика припинення облікового запису. BM25 ловить точний збіг термінів, тоді як векторний пошук вловлює семантичний зв'язок.
Реранкінг: фільтр другого етапу
Пошук повертає кандидатів. Реранкінг сортує їх за справжньою релевантністю. Реранкери типу cross-encoder, як-от Cohere Rerank чи bge-reranker-v2.5-gemma2-lightweight, оцінюють кожну пару запит-документ спільно, даючи значно точніші оцінки релевантності, ніж схожість bi-encoder.
Двоетапний конвеєр пошуку, широкий перший етап (топ 50 до 100 кандидатів через вектори + BM25), а потім точний реранкінг (топ 5 до 10 для промпта), є стандартом у продакшні. Це утримує затримку керованою: перший етап використовує швидкий пошук ANN, а дорогий cross-encoder обробляє лише невеликий набір кандидатів.
Cross-encoder точніші за bi-encoder, бо обробляють запит і документ разом крізь усі шари трансформера. Bi-encoder векторизують їх незалежно, втрачаючи тонкі сигнали взаємодії. Компромісом є швидкість: cross-encoder неможливо проіндексувати заздалегідь.
Адаптивний RAG: маршрутизація запитів до відповідного конвеєра
Не кожен запит потребує однакової складності пошуку. Адаптивний RAG тренує невеликий класифікатор, що направляє кожне питання до оптимального шляху:
- Без пошуку для простих фактологічних запитів, які модель уже знає
- Одноетапний пошук для помірних запитів
- Багатоетапний ітеративний пошук для складного міркування
Цей патерн балансує вартість і точність у змішаних навантаженнях. Продакшн-система, що обробляє 100 000 запитів на день, може знизити витрати на інференс на 40%, направляючи прості питання подалі від дорогих багатоетапних конвеєрів.
Сам класифікатор може бути невеликою дотюнованою моделлю або zero-shot промптом, що запитує: Чи потребує це питання зовнішніх знань для точної відповіді?
Спекулятивний RAG: обмін затримки на швидкість
Спекулятивний RAG запускає пошук паралельно зі швидкою генерацією чернетки. Якщо чернетка демонструє високу впевненість (виміряну через logprob), етап пошуку пропускається повністю. Якщо впевненість низька, отриманий контекст об'єднується з чернеткою і відбувається регенерація.
Цей підхід скорочує середню затримку на 30 до 40% при запитах з високою впевненістю. Найкраще працює для чат-ботів реального часу, пропозицій автодоповнення та систем обслуговування клієнтів, де час відповіді важливіший за вичерпне джерелування кожного запиту.
Компроміс: спекулятивний RAG іноді повертає відповіді без обґрунтування, коли модель надто впевнена. Продакшн-системи поєднують його з калібруванням впевненості та резервним повним пошуком, коли невизначеність перевищує поріг.
Agentic RAG: за межами одноразового пошуку
Наївний RAG отримує один раз і генерує. Agentic RAG розглядає LLM як агента-міркувальника, який вирішує, коли шукати, що шукати і чи достатнім є отриманий контекст.
У 2026 році agentic RAG є домінантним патерном для складних запитів, що потребують багатоетапного міркування. Агент може:
- Самооцінка: Оцінити, чи отримані документи відповідають на питання
- Повторний запит: Переформулювати пошуковий запит, якщо початкові результати недостатні
- Маршрутизація (routing): Обрати між різними джерелами знань (векторна БД, SQL-база, API)
- Перевірка: Перехресно звірити факти у кількох отриманих уривках
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Цей патерн (отримай, оціни, за потреби переформулюй і повтори) відомий як Corrective RAG (CRAG). Зверніть увагу, що AgentExecutor з LangChain є застарілим з 2026 року; нові проекти мають використовувати create_react_agent() для готових патернів або StateGraph з LangGraph для кастомної оркестрації. Детальніше про патерни LangChain для data scientists у присвяченій статті.
Graph RAG: пошук структурованих знань
Graph RAG витягує сутності та зв'язки з документів у граф знань, а потім запитує і граф, і векторне сховище. Ця архітектура зменшує галюцинації при фактологічних запитах, прив'язуючи відповіді до явних зв'язків між сутностями замість неструктурованої схожості тексту.
Конвеєр інжесту витягує трійки (суб'єкт, предикат, об'єкт) з кожного фрагмента документа. Під час запиту система визначає релевантні сутності у питанні, обходить граф знань у пошуках пов'язаних фактів і поєднує контекст із графа з уривками, отриманими векторно.
Graph RAG чудово справляється з питаннями, що потребують багатокрокового (multi-hop) міркування, як-от: Яка команда веде проєкт, що використовує фреймворк, згаданий у документі X? Це запити, що вимагають поєднання фактів із кількох документів. Чистий векторний пошук тут має труднощі, бо жоден окремий фрагмент не містить повної відповіді.
Graph RAG значно підвищує фактологічну точність (до 40% менше галюцинацій при запитах, насичених сутностями), але потребує зрілого конвеєра витягання сутностей. Зашумлене витягання дає зашумлений граф, що може погіршити результати нижче рівня наївного RAG. Також варто зазначити, що проект GraphRAG від Microsoft увійшов у режим підтримки у 2026 році; він отримуватиме виправлення помилок, але не нові функції.
Варіант LazyGraphRAG від Microsoft (випущений у червні 2025) кардинально знижує витрати на індексування, відкладаючи підсумовування до часу запиту, що робить його придатним для дослідницького аналізу або потокових даних, де попередня побудова графа непрактична.
Відповідність EU AI Act для систем RAG
EU AI Act почав широко застосовуватися у серпні 2026 року. Перший гучний штраф за законом отримав RAG-чатбот європейського банківського консорціуму наприкінці травня 2026 року, а франкфуртська компанія з управління активами отримала штраф у 4,5 мільйона євро у квітні 2026 року за клієнтську RAG-систему, що не пояснювала походження даних.
Архітектури RAG природно задовольняють кілька вимог відповідності: простежуваність джерел (фрагменти містять посилання на документи), прозорість відповідей (цитати можна показати) та можливість аудиту (логи пошуку існують за конструкцією). Проте повна відповідність потребує додаткових заходів:
Класифікація ризику: Публічний чат-бот належить до обмеженого ризику (потрібна прозорість). Медична або юридична RAG-система має високий ризик із суворішими вимогами до документації та нагляду.
Аудит-логування: Записування, який запит викликав які отримані фрагменти і яка відповідь була згенерована. Цей лог формує основу необхідної простежуваності.
Людський нагляд: Системи високого ризику потребують валідації людиною у чутливих випадках, можливості виправлення результатів та механізмів видалення проіндексованих даних на вимогу.
Резидентність даних: Розміщення індексування в ЄС та використання BYOK (Bring Your Own Key), щоб дані не проходили через акаунти третіх сторін поза юрисдикцією.
Невідповідність може коштувати 7% глобального річного доходу. Для обговорень на співбесіді ключовим є те, що вроджена здатність RAG до цитування є перевагою, але вона не замінює рівень управління.
Оцінювання систем RAG: метрики, що мають значення
Оцінювання RAG поділяється на метрики пошуку та метрики генерації. Обидва набори потрібно вимірювати незалежно, щоб діагностувати збої.
Метрики пошуку:
- Recall@k: Чи з'явилися релевантні документи у топ k результатів?
- MRR (Mean Reciprocal Rank): Наскільки високо ранжовано перший релевантний результат?
- NDCG: Чи відповідає ранжування ідеальному порядку релевантності?
Метрики генерації:
- Вірність (faithfulness): Чи використовує відповідь лише інформацію з отриманого контексту? (Вимірює галюцинації)
- Релевантність відповіді: Чи відповідь стосується початкового питання?
- Точність контексту: Чи дійсно отримані фрагменти використані у відповіді?
Фреймворки на кшталт Ragas та DeepEval автоматизують ці оцінки, використовуючи патерни LLM-як-суддя (LLM-as-judge). Найпопулярніші питання співбесід з data science дедалі частіше включають проєктування оцінювання RAG, тож варто очікувати питання про те, як виміряти, чи правильно працює система RAG.
Режими збоїв у продакшні та налагодження
Системи RAG зазнають невдач передбачувано. Знання цих патернів є необхідним як для співбесід, так і для реального розгортання.
Забруднення вікна контексту трапляється, коли забагато отриманих фрагментів розбавляють релевантний сигнал. LLM отримує 10 фрагментів, але лише 2 містять корисну інформацію. Виправлення: використовуйте реранкер для фільтрації та зменшіть top-k у пошуковику.
Артефакти chunking виникають, коли розбиття фіксованого розміру розриває речення, таблиці чи блоки коду посередині елемента. Отриманий фрагмент є синтаксично неповним і семантично марним. Це вирішує семантичний chunking або розбиття з урахуванням документа (з повагою до заголовків, абзаців, блоків коду).
Дрейф векторів (embedding drift) виникає, коли модель векторизації оновлюється, але векторне сховище досі містить вектори зі старої моделі. Запити, закодовані новою моделлю, шукають у векторному просторі, побудованому старою, погіршуючи якість пошуку. Рішення: повторно векторизуйте весь корпус після будь-якої зміни моделі.
Застарілі індекси видають неактуальну інформацію, бо конвеєр інжесту відстав від оновлень документів. У системах машинного навчання це аналогічно розбіжності тренування-обслуговування (training-serving skew), де система пошуку бачить інший розподіл даних, ніж той, що існує у продакшні.
Джерела
- Turing Post: 20 Advanced RAG Types to Know in 2026 - вичерпна таксономія патернів RAG
- LangChain and LangGraph 1.0 Milestones - застарілість AgentExecutor, нові патерни
- Microsoft GraphRAG GitHub - статус режиму підтримки
- IgnitionRAG EU AI Act Guide - вимоги відповідності для систем RAG
- MarkTechPost: Best Vector Databases in 2026 - консолідація ринку та ціни
Починай практикувати!
Перевір свої знання з нашими симуляторами співбесід та технічними тестами.
Ключові висновки щодо RAG на співбесідах з data science
- RAG поєднує пошук (векторний пошук по базі знань) із генерацією LLM, щоб давати прив'язані до фактів відповіді без перенавчання моделі
- Стратегія chunking має найбільший вплив на якість пошуку; семантичний та пізній chunking перевершують розбиття фіксованого розміру у більшості сценаріїв
- Гібридний пошук (щільні вектори + розріджений BM25) з Reciprocal Rank Fusion є продакшн-стандартом, що вирішує проблему розбіжності словника, з якою не справляється чистий векторний пошук
- Реранкери cross-encoder додають шар точності після широкого пошуку, обробляючи лише невеликий набір кандидатів, щоб тримати затримку прийнятною
- Адаптивний RAG направляє запити до відповідної складності конвеєра, знижуючи витрати на 40% при змішаних навантаженнях
- Спекулятивний RAG обмінює обґрунтування на швидкість, скорочуючи затримку на 30 до 40% при запитах з високою впевненістю
- Agentic RAG (отримай, оціни, переформулюй, повтори) та Graph RAG (витягання зв'язків між сутностями) опрацьовують складні багатокрокові запити, на яких наївний RAG зазнає невдачі
- Відповідність EU AI Act (серпень 2026) вимагає аудит-логування, людського нагляду та класифікації ризику для продакшн-систем RAG
- Оцінювання має відокремлювати метрики пошуку (Recall@k, MRR) від метрик генерації (вірність, релевантність відповіді), щоб діагностувати, де ламається конвеєр
- Найпоширеніші продакшн-збої (забруднення контексту, артефакти chunking, дрейф векторів, застарілі індекси) мають прості виправлення, щойно їх виявлено
Чи знайдеш ти помилку в Data Science & ML?
Справжній фрагмент коду, прихована помилка, одна спроба на день. Щоб спробувати, акаунт не потрібен.

Автор:
Anthony Fillion-MailletЗасновник SharpSkill
Fullstack-розробник понад 10 років. Керує SharpSkill і відповідає за все, що тут публікується.
Оновлено 24 серпня 2026 р.
Теги
Поділитися
Пов'язані статті
Feature Engineering для Machine Learning: техніки та питання на співбесідах 2026
Повний огляд технік feature engineering для машинного навчання: кодування категорій, масштабування ознак, відбір фіч, побудова pipeline та питання для співбесід у 2026 році.

XGBoost vs LightGBM у 2026: Gradient Boosting та Питання на Співбесідах з Data Science
Комплексне порівняння XGBoost та LightGBM у 2026 році. Архітектурні відмінності, техніки оптимізації та підготовка до питань на співбесідах з machine learning.

Scikit-Learn Pipeline у 2026: Інженерія Ознак та Питання на Співбесідах
Повний посібник з Scikit-learn Pipeline та ColumnTransformer. Охоплює інженерію ознак, запобігання витоку даних та питання зі співбесід з машинного навчання.