ETL проти ELT у 2026: Архітектура Конвеєрів Даних та Питання на Співбесідах
ETL та ELT представляють два підходи до архітектури конвеєрів даних. Це порівняння пояснює, коли використовувати кожен патерн, які інструменти їх підтримують та які питання про проектування конвеєрів ставлять дата-інженерам на співбесідах.
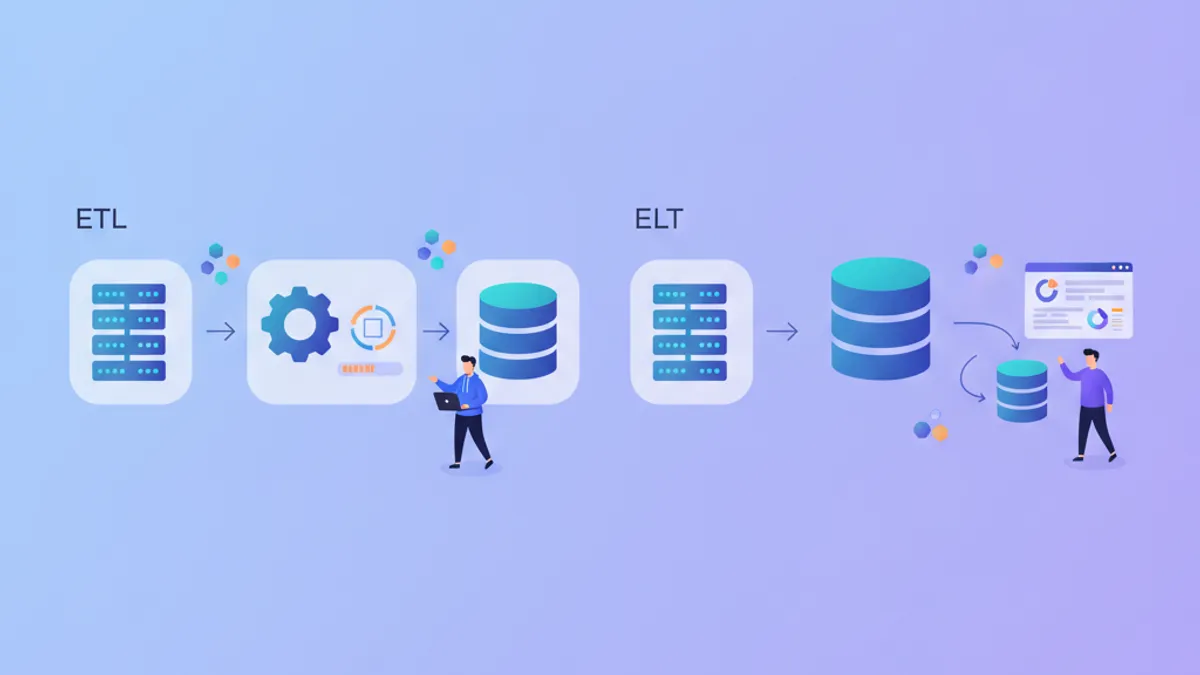
ETL та ELT визначають спосіб переміщення даних із систем-джерел до аналітичних середовищ. Вибір між екстракцією, трансформацією та завантаженням (ETL) і екстракцією, завантаженням та трансформацією (ELT) впливає на витрати на інфраструктуру, свіжість даних та навички, яких вимагають від інженерних команд.
ETL трансформує дані перед завантаженням у цільову систему, що вимагає виділених обчислювальних ресурсів. ELT спочатку завантажує сирі дані, а потім трансформує їх, використовуючи обчислювальну потужність цільового сховища даних. Більшість хмарних стеків даних у 2026 році надають перевагу ELT, оскільки обчислювальні ресурси масштабуються за запитом.
Архітектура ETL: Трансформація Перед Завантаженням
ETL виник, коли сховища даних мали обмежену обчислювальну потужність, а зберігання було дорогим. Цей патерн мав сенс: фільтрувати та агрегувати дані поза сховищем, завантажувати лише те, що потрібно для аналізу. Oracle Warehouse Builder, Informatica PowerCenter та Talend створили інструменти навколо цієї моделі.
Етап трансформації в ETL виконується на проміжних серверах. Дані переміщуються з джерела до проміжної зони, очищуються та перетворюються, а потім завантажуються до місця призначення. Такий підхід знижує навантаження на сховище, але створює вузьке місце на рівні трансформації.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL добре працює, коли логіка трансформації залишається стабільною, а обсяги даних передбачувані. Недолік проявляється при зміні вимог: модифікація трансформацій означає повторну обробку історичних даних з нуля.
Архітектура ELT: Спочатку Завантаження, Трансформація у Сховищі
ELT переносить трансформацію до сховища даних. Snowflake, BigQuery, Databricks та Redshift забезпечують майже необмежену обчислювальну потужність, яка масштабується зі складністю запитів. Завантаження сирих даних спочатку зберігає стан джерела; трансформації стають SQL-моделями, які можна версіонувати та повторно запускати без повторної екстракції.
Проект dbt (data build tool) популяризував ELT, розглядаючи SQL-трансформації як код. Замість непрозорих ETL-завдань трансформації живуть у системі контролю версій як оператори SELECT, що посилаються на сирі таблиці та будують похідні моделі.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT зберігає сирі дані, що дозволяє повторну обробку при зміні бізнес-логіки. Якщо розрахунок був неправильним шість місяців тому, виправлення dbt-моделі та запуск повного оновлення коригує історичні дані. У випадку ETL така ж корекція вимагає повторної екстракції з джерел, які можуть вже не мати оригінальних записів.
Порівняльна Таблиця: Компроміси ETL та ELT
| Фактор | ETL | ELT |
|---|---|---|
| Місце обчислень | Виділений сервер трансформації | Цільове сховище даних |
| Збереження сирих даних | Часто видаляються після трансформації | Зберігаються в зоні приземлення |
| Вартість повторної обробки | Повторна екстракція з джерела | Повторний запуск SQL-моделей |
| Гнучкість схеми | Фіксується під час трансформації | Можлива схема при читанні |
| Приклади інструментів | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Найкраще для | Стабільні вимоги, застарілі системи | Змінні вимоги, хмарні сховища |
| Затримка | Вища (трансформація перед завантаженням) | Нижча (завантаження, потім трансформація) |
| Управління даними | Простіше (дані фільтруються перед сховищем) | Потребує контролів на рівні сховища |
Готовий до співбесід з Data Engineering?
Практикуйся з нашими інтерактивними симуляторами, flashcards та технічними тестами.
Гібридні Підходи: Коли ETL та ELT Поєднуються
Сучасні стеки даних рідко використовують чистий ETL або ELT. Apache Airflow оркеструє конвеєри, що поєднують обидва патерни. Чутливі дані можуть анонімізуватися перед завантаженням (крок ETL), тоді як агрегації виконуються у сховищі (ELT).
Fivetran та Airbyte екстрактують і завантажують сирі дані без трансформації, а потім dbt трансформує всередині сховища. Однак ці інструменти також підтримують легкі трансформації під час екстракції: вибір стовпців, приведення типів даних, хешування полів PII. Це розмиває межу між ETL та ELT.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
Наведений конвеєр екстрактує з Salesforce через Airbyte (який може хешувати email-адреси під час синхронізації), завантажує до Snowflake, а потім запускає dbt-моделі для бізнес-трансформацій. Ні чистий ETL, ні чистий ELT, але практичний.
Питання на Співбесідах: ETL та ELT для Дата-Інженерів
Технічні співбесіди на позиції дата-інженерії в компаніях, що використовують сучасні стеки даних, перевіряють розуміння архітектури конвеєрів. Ці питання часто зустрічаються, базуючись на патернах з модулів підготовки до співбесід ETL/ELT.
Питання 1: Коли Вибрати ETL Замість ELT?
Сильні відповіді визначають конкретні сценарії:
- Вимоги відповідності: GDPR або HIPAA вимагають, щоб певні дані ніколи не потрапляли до сховища в сирому вигляді. PII повинна бути анонімізована або видалена перед завантаженням.
- Обмеження застарілих сховищ: On-premises системи як Teradata або старі конфігурації Redshift з фіксованою обчислювальною потужністю виграють від попередньо агрегованих завантажень.
- Мережеві витрати: Завантаження 10ТБ щодня до хмарного сховища, а потім відкидання 90% після трансформації марнує пропускну здатність виходу. Попередня фільтрація має економічний сенс.
Слабкі відповіді говорять "ETL застарілий" або не наводять конкретних сценаріїв. Інтерв'юери шукають нюанси.
Питання 2: Як Керувати Змінами Схеми в ELT-Конвеєрі?
Це тестує розуміння зон приземлення сирих даних. Очікувані теми:
- JSON або напівструктуровані стовпці, що поглинають нові поля без міграції схеми
- Staging-моделі, що явно вибирають стовпці, ізолюючи downstream-моделі від змін джерела
- Макроси dbt або assertions Dataform, що завершують збірки невдачею при зникненні очікуваних стовпців
- Моніторинг дрейфу схеми за допомогою інструментів на кшталт Monte Carlo або Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Питання 3: Порівняйте Оркестрацію ETL з Airflow та Запуск dbt для ELT
Питання перевіряє розуміння того, що ці інструменти вирішують різні проблеми:
- Airflow оркеструє завдання: екстракцію, API-виклики, передачу файлів, навчання моделей. Він керує залежностями між гетерогенними завданнями.
- dbt трансформує дані всередині сховища. Він керує залежностями між SQL-моделями, запускає тести, генерує документацію.
Повний конвеєр часто використовує обидва: Airflow запускає синхронізації Airbyte, чекає на завершення, потім запускає dbt. Знання, коли використовувати який інструмент, відрізняє старших спеціалістів.
Питання 4: Ваш ELT-Конвеєр Обробляє 500М Рядків Щодня, а Аналітики Повідомляють про Повільні Запити
Це відкрите питання тестує діагностичне мислення:
- Перевірте матеріалізацію моделей: Чи важкі моделі все ще є view? Інкрементальні моделі або таблиці можуть допомогти.
- Партиціонування та кластеризація: Для BigQuery, чи fact-таблиці партиціоновані за датою? Для Snowflake, чи кластеризація оптимізована для типових патернів запитів?
- Pushdown запитів: Чи аналітики запитують staging-моделі замість попередньо агрегованих marts?
- Розмір сховища: Чи обчислювальні ресурси масштабовані належним чином у години запитів?
- Вимоги до свіжості: Чи може трансформація виконуватися вночі замість робочих годин?
Єдиної правильної відповіді не існує. Інтерв'юери оцінюють системне усунення неполадок.
Ландшафт Інструментів у 2026 Році
Ринок інтеграції даних консолідувався навколо кількох патернів:
Екстракція та завантаження: Fivetran, Airbyte, Stitch та Meltano обслуговують частину EL. Ці інструменти підключаються до сотень джерел і синхронізуються з хмарними сховищами без написання коду.
Трансформація: dbt домінує в SQL-трансформаціях. Альтернативи включають Dataform (тепер частина Google Cloud), SQLMesh (відкритий код з віртуальними середовищами даних) та Coalesce (візуальне моделювання).
Оркестрація: Airflow залишається стандартом для складних конвеєрів. Dagster та Prefect пропонують альтернативи з кращою локальною розробкою та asset-центричними представленнями.
Якість: Great Expectations, тести dbt, Monte Carlo та Soda забезпечують моніторинг якості даних. Вони виявляють проблеми між екстракцією та downstream-споживанням.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Починай практикувати!
Перевір свої знання з нашими симуляторами співбесід та технічними тестами.
Вибір Архітектури Конвеєра для Нових Проектів
Для більшості нових проектів у 2026 році ELT є стандартом. Обчислювальні ресурси хмарного сховища коштують менше, ніж підтримка серверів трансформації. Збереження сирих даних дозволяє ретроспективні виправлення. SQL-трансформації можна аудитувати та версіонувати.
ETL залишається актуальним для:
- Регуляторних середовищ, що вимагають мінімізації даних перед входом до сховища
- Потокової обробки в реальному часі, де трансформація повинна відбуватися під час інгестії (Kafka Streams, Flink)
- Сценаріїв граничних обчислень з обмеженим downstream-сховищем
- Інтеграцій із застарілими системами, де система-джерело контролює формат експорту
Відповідь, готова до співбесіди, визнає обидва патерни та пояснює компроміси без ідеологічних переваг.
Ключові Висновки для Архітектури Конвеєрів Даних
- ETL трансформує дані перед завантаженням, знижуючи навантаження на сховище, але створюючи тертя при повторній обробці, коли логіка змінюється
- ELT спочатку завантажує сирі дані, дозволяючи SQL-трансформації, які можна версіонувати, тестувати та повторно запускати на історичних даних
- Сучасні стеки зазвичай поєднують обидва підходи: легкі трансформації екстракції (хешування PII, приведення типів) з агрегацією у сховищі
- dbt став стандартом для ELT-трансформацій, розглядаючи SQL-моделі як тестований, задокументований код
- Питання на співбесідах досліджують вибір сценарію, управління еволюцією схеми та компроміси інструментів, а не визначення з пам'яті
- Збереження сирих даних у ELT-конвеєрах дозволяє виправляти історичні розрахунки без повторної екстракції з джерел
Чи знайдеш ти помилку в Data Engineering?
Справжній фрагмент коду, прихована помилка, одна спроба на день. Щоб спробувати, акаунт не потрібен.

Автор:
Anthony Fillion-MailletЗасновник SharpSkill
Fullstack-розробник понад 10 років. Керує SharpSkill і відповідає за все, що тут публікується.
Оновлено 14 вересня 2026 р.
Теги
Поділитися
Пов'язані статті
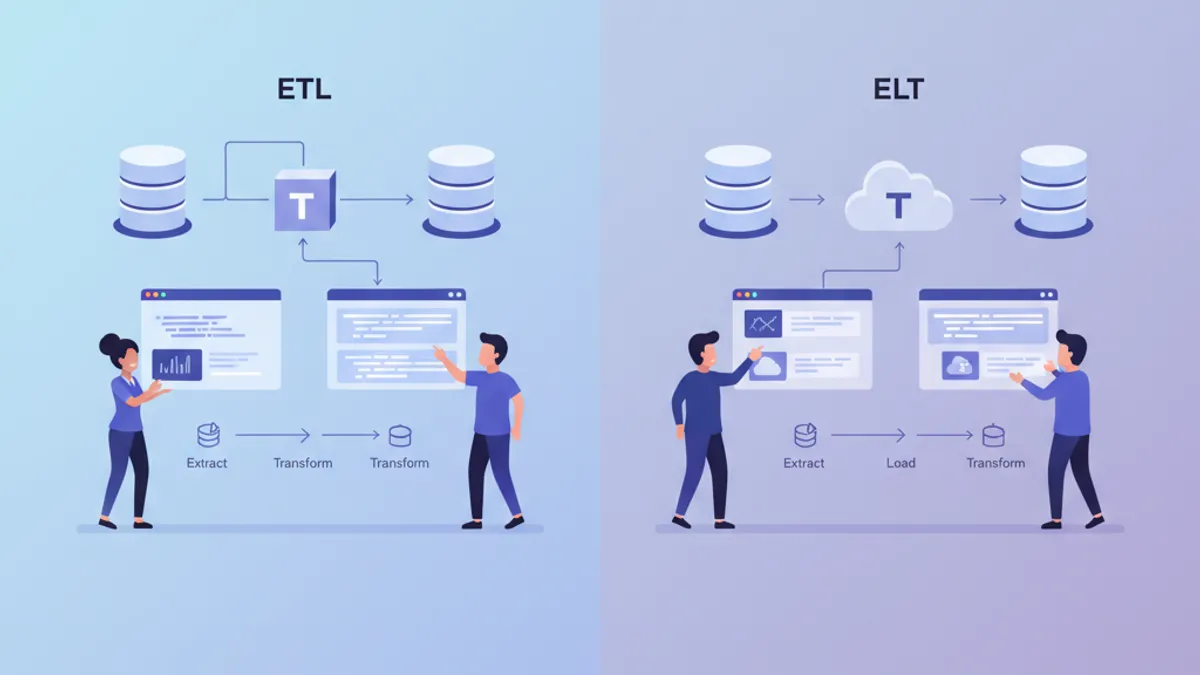
ETL проти ELT у 2026: Архітектура пайплайнів даних
Порівняння ETL та ELT для сучасних пайплайнів даних. Архітектурні відмінності, компроміси продуктивності та застосування зі Snowflake, BigQuery і dbt.
Apache Airflow у 2026 році: оркестрація конвеєрів даних, DAG та питання для співбесіди
Повний посібник з Apache Airflow 3.2: створення DAG за допомогою Task SDK, динамічне мапування задач, партиціоновані ассети, нативна підтримка async та питання для підготовки до співбесіди з data engineering у 2026 році.
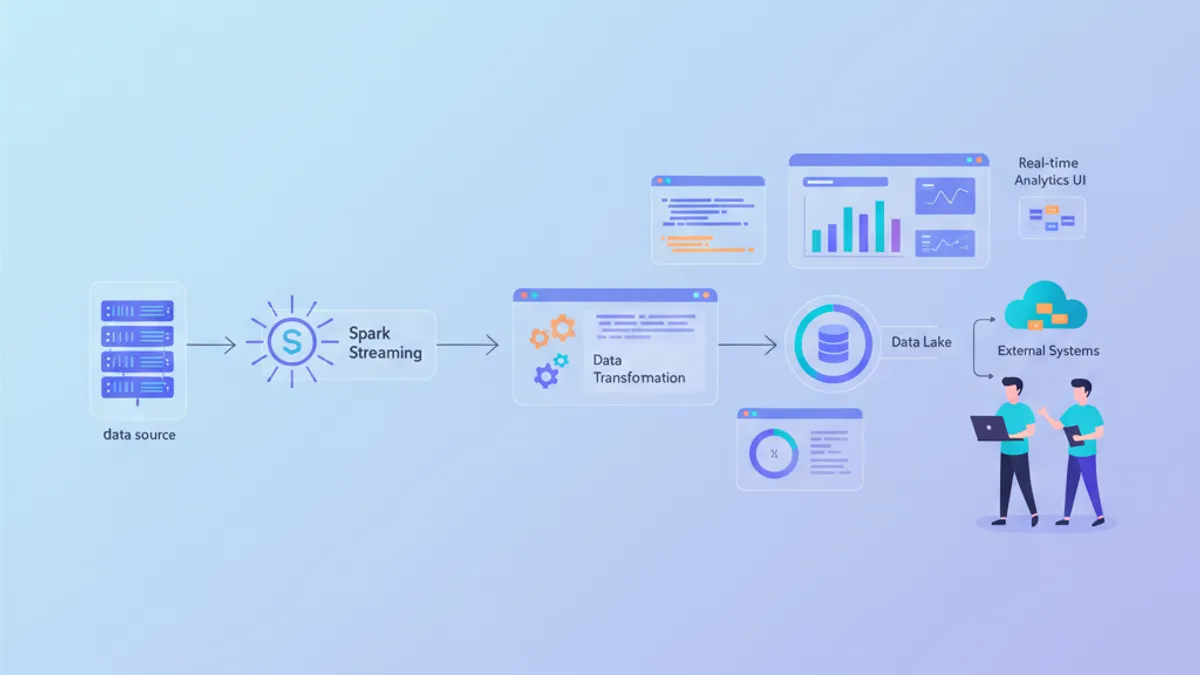
Apache Spark 4 у 2026 році: нові можливості, Structured Streaming та питання для співбесіди
Технічний огляд Apache Spark 4 з ANSI SQL, типом даних VARIANT, Real-Time Mode Streaming, Spark Connect та найважливішими питаннями для співбесіди на позиції Data Engineering.