Apache Spark з Python: Покрокова Побудова Конвеєрів Даних
Практичний посібник з PySpark, що охоплює операції з DataFrame, побудову ETL-конвеєрів та можливості Spark 4.0. Містить готові до продакшену приклади коду для дата-інженерів, які готуються до технічних співбесід.
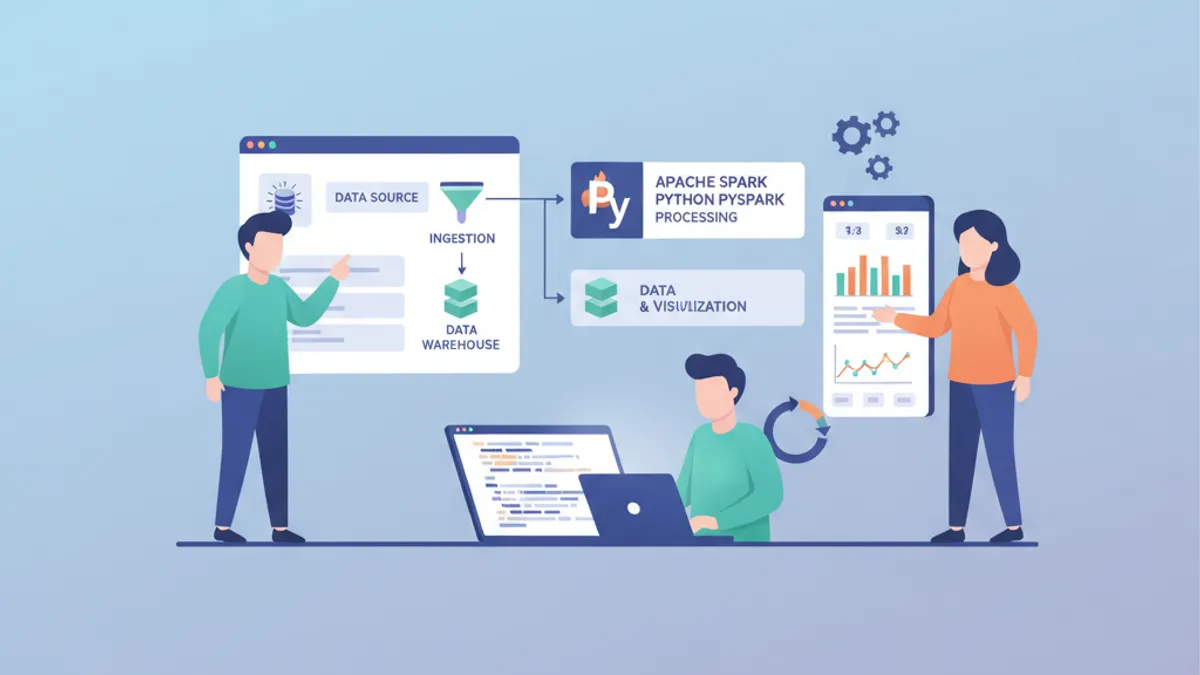
Apache Spark залишається домінуючим рушієм розподіленої обробки для масштабних конвеєрів даних у 2026 році. У поєднанні з PySpark він пропонує Python-native API, що обслуговує як пакетні, так і потокові робочі навантаження на кластерах будь-якого розміру без втрати продуктивності.
Цей посібник крок за кроком проведе через побудову повного ETL-конвеєра даних у PySpark — від прийому необроблених даних до чистого результату — з використанням можливостей Spark 4.0, зокрема Python Data Source API та вбудованих графіків DataFrame.
DataFrame у PySpark є незмінними (immutable). Кожна трансформація повертає новий DataFrame, залишаючи оригінал без змін. Ця архітектура забезпечує ліниве обчислення Spark: трансформації виконуються лише тоді, коли дія (наприклад, .show(), .write() або .collect()) ініціює план обчислень.
Налаштування Середовища PySpark 4.0
Перед побудовою будь-якого конвеєра сесію Spark необхідно належним чином налаштувати. Spark 4.0 за замовчуванням вмикає режим ANSI, який забезпечує суворішу семантику SQL — числові переповнення тепер генерують виключення замість тихого перенесення значень.
# spark_setup.py
from pyspark.sql import SparkSession

spark = (
    SparkSession.builder
    .appName("ETLPipeline")
    .config("spark.sql.adaptive.enabled", "true")       # AQE for runtime optimization
    .config("spark.sql.shuffle.partitions", "200")       # Tune based on cluster size
    .config("spark.serializer", "org.apache.spark.serializer.KryoSerializer")
    .getOrCreate()
)

# Verify Spark version
print(spark.version)  # 4.0.0
Adaptive Query Execution (AQE), увімкнене вище, динамічно оптимізує розділи shuffle та стратегії з'єднань під час виконання. Spark 4.0 забезпечує прискорення на 20-50% на типових ETL-навантаженнях порівняно зі Spark 3.x, переважно завдяки вдосконаленням AQE та оптимізатора Catalyst.
Зчитування Необроблених Даних через DataFrame API
DataFrame у PySpark абстрагують розподілені обчислення за звичним табличним інтерфейсом. Зчитування з різних джерел — CSV, Parquet, JSON, баз даних — відбувається за єдиним шаблоном.
# read_sources.py
from pyspark.sql.types import StructType, StructField, StringType, DoubleType, TimestampType

# Define schema explicitly — avoids slow schema inference on large files
order_schema = StructType([
    StructField("order_id", StringType(), nullable=False),
    StructField("customer_id", StringType(), nullable=False),
    StructField("product_code", StringType(), nullable=True),
    StructField("amount", DoubleType(), nullable=True),
    StructField("order_date", TimestampType(), nullable=True),
    StructField("region", StringType(), nullable=True),
])

# Read CSV with explicit schema
raw_orders = (
    spark.read
    .schema(order_schema)                    # Skip inference, enforce types
    .option("header", "true")                # First row contains column names
    .option("mode", "DROPMALFORMED")         # Skip rows that don't match schema
    .csv("s3a://data-lake/raw/orders/")
)

# Read Parquet — schema is embedded in the file format
products = spark.read.parquet("s3a://data-lake/raw/products/")

raw_orders.printSchema()
raw_orders.show(5, truncate=False)
Явне визначення схеми є найкращою практикою для продакшену. Виведення схеми потребує повного сканування джерела даних, що є витратним на великих наборах даних і може некоректно визначити типи (наприклад, інтерпретуючи поштові індекси як цілі числа).
Очищення та Трансформація DataFrame
Необроблені дані завжди потребують очищення. Трансформації PySpark природно з'єднуються в ланцюги через DataFrame API, і оскільки DataFrame є незмінними, кожен крок створює новий DataFrame без модифікації оригіналу.
# clean_orders.py
from pyspark.sql import functions as F

cleaned_orders = (
    raw_orders
    .filter(F.col("order_id").isNotNull())                     # Remove null primary keys
    .filter(F.col("amount") > 0)                               # Filter invalid amounts
    .withColumn("customer_id", F.trim(F.upper(F.col("customer_id"))))  # Normalize IDs
    .withColumn("order_date", F.to_date(F.col("order_date")))  # Cast to date type
    .withColumn("year_month",                                   # Extract partition key
        F.date_format(F.col("order_date"), "yyyy-MM"))
    .dropDuplicates(["order_id"])                               # Deduplicate by order ID
)

print(f"Raw: {raw_orders.count()} rows -> Cleaned: {cleaned_orders.count()} rows")
Порядок трансформацій має значення. Нормалізація customer_id перед дедуплікацією забезпечує послідовне зіставлення. Вилучення year_month після парсингу дати дозволяє уникнути значень null у стовпці розділення.
Виклик .collect() завантажує весь розподілений DataFrame у пам'ять драйвера. На наборах даних, що перевищують обсяг оперативної пам'яті драйвера, це спричиняє OutOfMemoryError. Натомість слід використовувати .show(), .take() або .toPandas() на попередньо відфільтрованих підмножинах.
З'єднання та Агрегація Даних з Кількох Джерел
Реальні конвеєри поєднують дані з кількох джерел. PySpark підтримує всі стандартні типи з'єднань, а AQE у Spark 4.0 автоматично обирає broadcast join для малих таблиць без ручних підказок.
# enrich_orders.py
# Join orders with product catalog
enriched = (
    cleaned_orders
    .join(products, on="product_code", how="left")      # Keep all orders, even unmatched
    .select(
        "order_id",
        "customer_id",
        "product_code",
        F.col("name").alias("product_name"),              # Rename for clarity
        "amount",
        F.col("category"),                                # From products table
        "order_date",
        "year_month",
    )
)

# Aggregate: monthly revenue per product category
monthly_revenue = (
    enriched
    .groupBy("year_month", "category")
    .agg(
        F.sum("amount").alias("total_revenue"),            # Sum all order amounts
        F.countDistinct("order_id").alias("order_count"),  # Unique orders
        F.avg("amount").alias("avg_order_value"),          # Average basket size
    )
    .orderBy(F.desc("total_revenue"))
)

monthly_revenue.show(10)
З'єднання типу left зберігає всі замовлення, навіть коли код продукту не має відповідника в каталозі — поширений сценарій під час міграції даних або коли каталоги продуктів відстають від транзакційних систем.
Готовий до співбесід з Data Engineering?
Практикуйся з нашими інтерактивними симуляторами, flashcards та технічними тестами.
Запис Оптимізованих Результатів з Партиціонуванням
Останній крок ETL-конвеєра — запис трансформованих даних до цільового шару зберігання. Партиціонування результатів за часто запитуваними стовпцями суттєво скорочує час зчитування для нижчестоящих споживачів.
# write_output.py
# Write enriched data partitioned by year_month
(
    enriched
    .repartition("year_month")                             # Align partitions with output
    .write
    .mode("overwrite")                                     # Replace existing partition data
    .partitionBy("year_month")                             # Physical directory partitioning
    .parquet("s3a://data-lake/curated/enriched_orders/")
)

# Write aggregated metrics as a single compact file
(
    monthly_revenue
    .coalesce(1)                                           # Single output file for small results
    .write
    .mode("overwrite")
    .parquet("s3a://data-lake/curated/monthly_revenue/")
)

print("Pipeline complete — output written to curated layer")
Використання .repartition() перед .partitionBy() гарантує, що кожна фізична партиція містить прийнятну кількість файлів. Без цього Spark може створити сотні дрібних файлів на партицію — поширений анти-патерн, відомий як "проблема маленьких файлів", що знижує продуктивність зчитування на HDFS та об'єктних сховищах.
Spark 4.0: Python Data Source API для Власних Конекторів
Spark 4.0 впроваджує Python Data Source API, усуваючи попередню вимогу писати власні конектори на Java або Scala. Це спрощує інтеграцію з пропрієтарними системами, REST API та нішевими форматами файлів.
# custom_source.py
from pyspark.sql.datasource import DataSource, DataSourceReader
from pyspark.sql.types import StructType, StructField, StringType, IntegerType

class APIDataSource(DataSource):
    """Custom data source reading from an internal REST API."""

    @classmethod
    def name(cls) -> str:
        return "internal_api"                              # Registered source name

    def schema(self) -> StructType:
        return StructType([                                # Define output schema
            StructField("id", IntegerType()),
            StructField("name", StringType()),
            StructField("status", StringType()),
        ])

    def reader(self, schema: StructType) -> "APIDataSourceReader":
        return APIDataSourceReader(self.options)           # Pass options to reader

class APIDataSourceReader(DataSourceReader):
    def __init__(self, options):
        self.endpoint = options.get("endpoint", "")        # API endpoint URL

    def read(self, partition):
        import requests                                    # Import inside read for serialization
        response = requests.get(self.endpoint)
        for record in response.json():
            yield (record["id"], record["name"], record["status"])

# Register and use the custom source
spark.dataSource.register(APIDataSource)
api_df = spark.read.format("internal_api").option("endpoint", "https://api.internal/users").load()
api_df.show()
Python Data Source API підтримує як пакетне, так і потокове зчитування. Для продакшен-використання додавання обробки помилок всередині read() та реалізація паралелізму на рівні партицій значно підвищує пропускну здатність.
Spark Connect відокремлює клієнтські застосунки від кластера Spark. Легковаговий клієнт PySpark (pyspark-client) важить лише 1,5 МБ порівняно з повним пакетом PySpark на 355 МБ. Це дозволяє запускати завдання Spark з будь-якого IDE чи блокнота без локальної інсталяції Spark.
Контрольний Список Оптимізації Продуктивності Конвеєрів PySpark
Побудова працюючого конвеєра — лише частина завдання. Досягнення продуктивності у великому масштабі вимагає уваги до партиціонування, кешування та стратегій з'єднань.
| Техніка | Коли Застосовувати | Вплив |
|---|---|---|
| Явні схеми | Кожна операція зчитування | Усуває сканування для виведення схеми |
| Відсікання партицій | Фільтрація партиціонованих наборів даних | Повністю пропускає нерелевантні партиції |
| Broadcast join | Мала таблиця (< 10 МБ) з'єднується з великою | Уникає витратного shuffle |
| Кешування | DataFrame повторно використовується у кількох діях | Запобігає повторним обчисленням |
| Coalesce vs Repartition | Зменшення кількості партицій | coalesce уникає повного shuffle |
| AQE | Завжди (за замовчуванням у Spark 4.0) | Оптимізація з'єднань та shuffle під час виконання |
Моніторинг продуктивності конвеєра через Spark UI залишається обов'язковим. Візуалізація DAG розкриває межі shuffle, а вкладка SQL демонструє фізичний план, обраний оптимізатором Catalyst.
Висновок
- PySpark 4.0 надає зрілий Python-орієнтований API для побудови ETL-конвеєрів будь-якого масштабу з підтримкою ANSI SQL за замовчуванням
- Явне визначення схем, правильне партиціонування та AQE усувають найпоширеніші вузькі місця продуктивності у продакшен-конвеєрах
- Нове Python Data Source API знімає бар'єр Java/Scala для власних конекторів — REST API, пропрієтарні формати та потокові джерела можна інтегрувати на чистому Python
- Порядок трансформацій має значення: нормалізація ідентифікаторів перед дедуплікацією, парсинг дат перед вилученням ключів партиціонування
- Питання для співбесід з дата-інженерії часто охоплюють внутрішні механізми Spark, такі як ліниве обчислення, механіка shuffle та стратегії партиціонування — розуміння цих основ конвеєрів безпосередньо готує до таких розмов
- Для глибшого розуміння архітектурних рішень щодо конвеєрів варто ознайомитися з патернами ETL та ELT
Починай практикувати!
Перевір свої знання з нашими симуляторами співбесід та технічними тестами.
Чи знайдеш ти помилку в Data Engineering?
Справжній фрагмент коду, прихована помилка, одна спроба на день. Щоб спробувати, акаунт не потрібен.

Автор:
Anthony Fillion-MailletЗасновник SharpSkill
Fullstack-розробник понад 10 років. Керує SharpSkill і відповідає за все, що тут публікується.
Оновлено 12 квітня 2026 р.
Теги
Поділитися
Пов'язані статті
Apache Spark 4 у 2026 році: нові можливості, Structured Streaming та питання для співбесіди
Технічний огляд Apache Spark 4 з ANSI SQL, типом даних VARIANT, Real-Time Mode Streaming, Spark Connect та найважливішими питаннями для співбесіди на позиції Data Engineering.
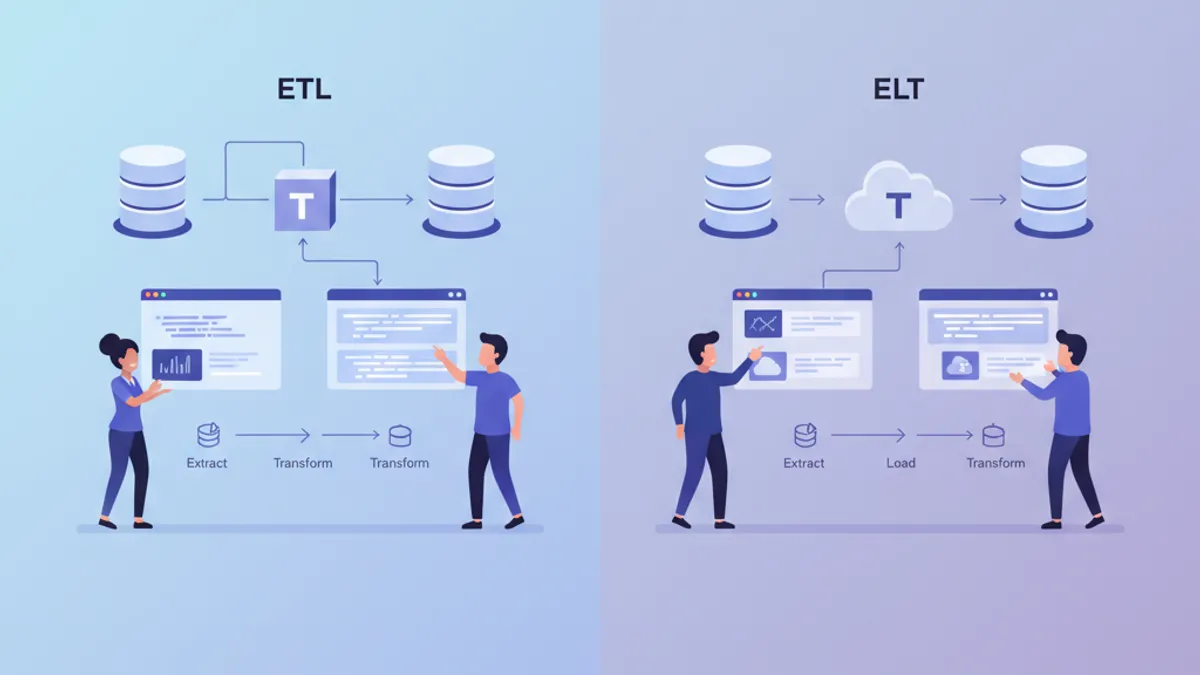
ETL проти ELT у 2026: Архітектура пайплайнів даних
Порівняння ETL та ELT для сучасних пайплайнів даних. Архітектурні відмінності, компроміси продуктивності та застосування зі Snowflake, BigQuery і dbt.
ETL проти ELT у 2026: Архітектура Конвеєрів Даних та Питання на Співбесідах
ETL та ELT представляють два підходи до архітектури конвеєрів даних. Це порівняння пояснює, коли використовувати кожен патерн, які інструменти їх підтримують та які питання про проектування конвеєрів ставлять дата-інженерам на співбесідах.