Princípios de SRE em 2026: engenharia de confiabilidade, SLOs e perguntas de entrevista
Princípios de SRE explicados para 2026: como escolher SLIs, definir SLOs, calcular o orçamento de erros, escrever alertas de burn rate com múltiplas janelas no Prometheus e responder às perguntas de entrevista de SRE mais comuns.
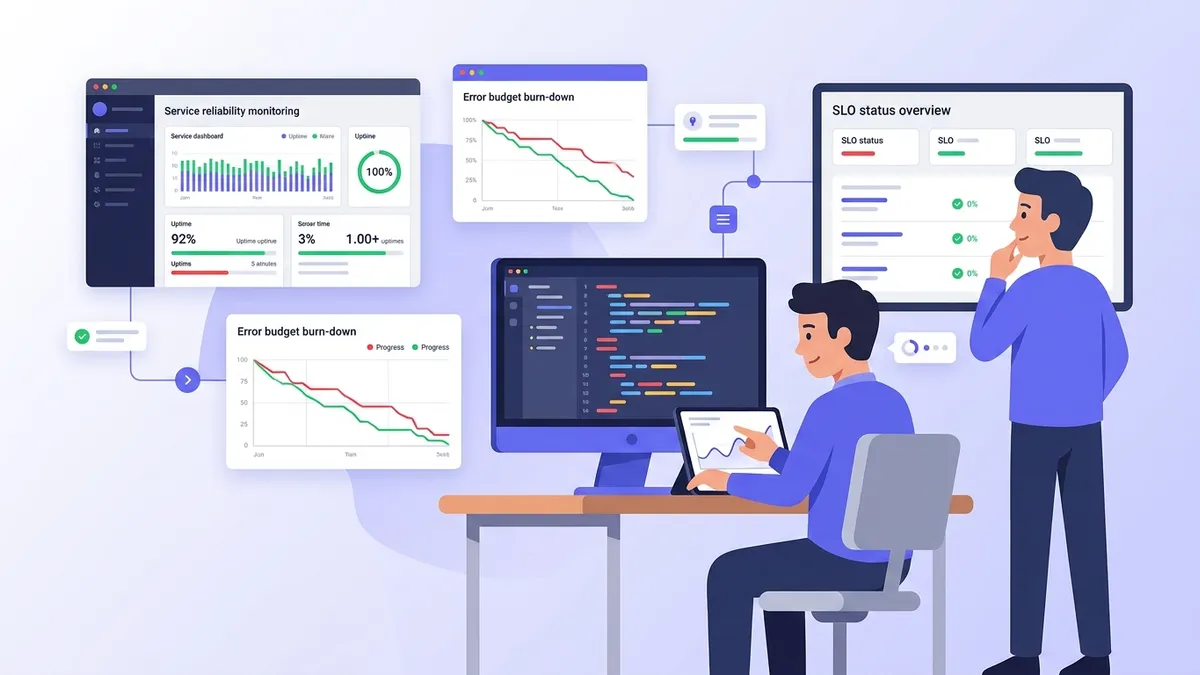
Os princípios de SRE transformam a confiabilidade, um objetivo que costuma ficar vago, em um número com o qual produto e engenharia concordam, e depois usam esse número para decidir quando entregar e quando segurar. O site reliability engineering, como foi definido pelo Google e como hoje é praticado na maioria dos times de plataforma, se apoia em poucas ideias: medir o que o usuário vivencia (SLIs), definir uma meta abaixo de 100% (SLOs), gastar essa diferença como orçamento de erros e limitar o trabalho manual que mantém os sistemas funcionando. As perguntas de entrevista de SRE em 2026 testam exatamente esses conceitos, quase sempre pedindo que o candidato defina o SLO de um serviço real e escreva o alerta que o protege.
Um SLI é uma medição: a razão entre eventos bons e eventos válidos, como requisições bem-sucedidas sobre o total de requisições. Um SLO é a meta interna para essa razão em uma janela de tempo, por exemplo 99,9% em 30 dias. Um SLA é a promessa contratual feita aos clientes, com multas, e é sempre mais folgado que o SLO.
Os princípios fundamentais do site reliability engineering
O livro de SRE do Google trata a confiabilidade como uma funcionalidade que tem custo. Cada nove adicional consome mais tempo de engenharia e desacelera as entregas, enquanto os usuários raramente percebem diferença entre 99,99% e 99,999%, já que a própria rede, o dispositivo e o provedor de internet deles são menos confiáveis do que isso. O objetivo é o nível certo de confiabilidade, e não o máximo.
A partir dessa premissa, surgem alguns princípios:
- A confiabilidade é medida do lado do usuário. Uso de CPU e reinícios de pods são causas. Checkouts que falham e páginas lentas são o que o usuário sente, e é isso que um SLI captura.
- 100% é a meta errada. Um SLO de 100% proíbe qualquer mudança, já que todo deploy carrega risco. A margem abaixo de 100% é o orçamento de erros, e ele existe para ser gasto em releases, experimentos e migrações.
- O toil tem teto. A diretriz do capítulo sobre eliminação de toil mantém o trabalho operacional abaixo de 50% do tempo de um SRE. Toil é o trabalho manual, repetitivo, automatizável e que cresce linearmente com o serviço. O restante do tempo vai para a engenharia que o elimina.
- Postmortems não buscam culpados. A análise de um incidente pergunta o que no sistema permitiu a falha, e não quem digitou o comando. Um engenheiro culpabilizado esconde informações; uma análise sem culpa as traz à tona.
- O monitoramento alerta sobre sintomas. O plantão é acionado quando os usuários estão sendo afetados ou prestes a ser, e não quando um único nó apresenta um comportamento estranho.
Em entrevistas, o segundo ponto é o que separa um SRE experiente de alguém que apenas leu o livro. Uma resposta júnior trata o orçamento de erros como tolerância a falhas. Uma resposta sênior o trata como uma ferramenta de gestão de releases: é o mecanismo que permite que produto e confiabilidade discutam com dados, e não com opiniões.
Como escolher SLIs que reflitam a experiência do usuário
Um bom SLI é uma razão entre 0 e 1, calculada a partir de eventos que o usuário reconheceria. O SRE workbook recomenda um cardápio curto de acordo com o tipo de serviço:
| Tipo de serviço | SLIs típicos | Onde medir |
|---|---|---|
| API orientada a requisições | Disponibilidade, latência | Logs do load balancer ou do ingress, métricas do servidor |
| Pipeline de dados | Atualidade, corretude, cobertura | Timestamps de saída do pipeline, jobs de validação |
| Sistema de armazenamento | Durabilidade, latência de leitura e escrita | Camada de armazenamento, sondas sintéticas |
| Frontend | Tempo de carregamento, taxa de erros no navegador | Real user monitoring |
Medir no load balancer captura falhas que a aplicação nunca enxerga, como um pod travado que não devolve nada. Medir no navegador revela problemas de CDN e DNS, mas adiciona o ruído de conexões móveis ruins. A maioria dos times começa pelo load balancer ou pelo ingress, porque os dados já estão disponíveis ali.
Com Prometheus, os dois SLIs clássicos de um serviço HTTP são uma razão de disponibilidade e uma razão de latência. O SLI de latência conta como boas as requisições atendidas abaixo de um limite, o que o torna uma razão como as outras, e não um percentil.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Dois detalhes aparecem com frequência em entrevistas. Primeiro, respostas 4xx geralmente contam como válidas e boas, porque um 404 ou um erro de validação é falha do cliente; contá-las como falhas permite que um cliente mal configurado consuma todo o orçamento. Segundo, o limite de latência precisa coincidir com uma fronteira de bucket do histograma; caso contrário, a consulta não retorna nada ou usa silenciosamente o bucket errado. O Prometheus 3.16, lançado em 5 de novembro de 2026, suporta histogramas nativos, que eliminam a restrição de buckets fixos, mas precisam ser habilitados no lado do scrape.
Como definir a meta do SLO e calcular o orçamento de erros
Um SLO combina um SLI, uma meta e uma janela. A janela costuma ser móvel, de 28 ou 30 dias, para que o orçamento se recupere aos poucos em vez de zerar no primeiro dia do mês. A meta é escolhida a partir do desempenho histórico e da expectativa dos usuários, e não do que fica bonito em um slide.
A tabela abaixo mostra o que cada meta permite em uma janela de 30 dias. É aritmética simples: o orçamento é (1 - SLO) × 30 dias.
| Meta do SLO | Orçamento de erros | Indisponibilidade total permitida em 30 dias |
|---|---|---|
| 99% | 1% | 7 h 12 min |
| 99,5% | 0,5% | 3 h 36 min |
| 99,9% | 0,1% | 43 min 12 s |
| 99,95% | 0,05% | 21 min 36 s |
| 99,99% | 0,01% | 4 min 19 s |
Em SLOs baseados em requisições, o orçamento é expresso em requisições, e não em minutos: com 99,9% e 12 milhões de requisições na janela, 12.000 requisições com falha são permitidas. Esse modelo é mais justo para serviços com tráfego irregular, porque uma queda às 3 da manhã consome menos orçamento do que a mesma queda no horário de pico.
Um exercício comum em entrevistas é calcular o orçamento restante e a velocidade com que ele está sendo consumido. O script abaixo é o tipo de resposta esperada quando a pergunta pede código.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Um burn rate de 15 significa que o serviço falha em 1,5% das requisições enquanto o SLO permite 0,1%. Nesse ritmo, os 35% de orçamento restantes acabam em menos de 17 horas, o que justifica acordar alguém.
Pronto para mandar bem nas entrevistas de DevOps?
Pratique com nossos simuladores interativos, flashcards e testes tecnicos.
Alertas de burn rate com múltiplas janelas
Alertar diretamente sobre o SLI ("taxa de erro acima de 0,1%") gera acionamentos a cada pico curto e deixa passar vazamentos lentos. O capítulo do workbook sobre alertas baseados em SLOs recomenda, em vez disso, alertas com múltiplas janelas e múltiplos burn rates. Cada alerta responde a uma única pergunta: o orçamento está sendo gasto rápido o bastante para acabar antes que alguém olhe para ele?
Os limites de referência para uma janela de 30 dias são:
| Severidade | Janela longa | Janela curta | Burn rate | Orçamento consumido quando dispara |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2% |
| Page | 6 h | 30 min | 6 | 5% |
| Ticket | 3 dias | 6 h | 1 | 10% |
A janela longa garante relevância estatística: um minuto ruim não aciona ninguém. A janela curta, equivalente a um doze avos da longa, faz o alerta se resolver rapidamente depois que o incidente acaba, para que o acionamento não continue tocando por uma hora após a correção. As duas condições precisam ser verdadeiras ao mesmo tempo.
O primeiro bloco registra a razão de erros em cada janela, para que as expressões de alerta fiquem baratas. O segundo bloco define os dois alertas de page para um SLO de 99,9%, em que a fração do orçamento é 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageEscrever essas regras à mão para cada serviço se torna repetitivo. O Sloth, um gerador de SLOs open source, recebe uma especificação curta e produz as regras de gravação e os alertas multi-burn-rate mostrados acima. O marcador {{.window}} é substituído por cada janela de que o Sloth precisa.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Times que querem um formato neutro em relação a fornecedores olham para a especificação OpenSLO, que descreve SLOs em YAML de forma independente do backend de monitoramento.
Política de orçamento de erros e decisões de release
Um orçamento de erros sem política é um dashboard que ninguém usa para agir. O exemplo de política de orçamento de erros do workbook detalha o que acontece quando o orçamento acaba e quem aprovou isso com antecedência.
Uma política típica contém:
- O gatilho. O serviço ultrapassou seu orçamento de erros na janela móvel.
- A consequência. Os releases de funcionalidades param, exceto correções de segurança e mudanças que melhoram a confiabilidade, até que o serviço volte a cumprir o SLO.
- O caminho de exceção. Um incidente isolado causado por uma dependência fora do controle do time pode ser desconsiderado, desde que a decisão seja documentada.
- A escalação. Divergências vão para um papel definido, como o CTO, e não para quem argumenta mais alto.
A política é assinada por produto e engenharia antes da primeira violação, e esse é justamente o ponto: o congelamento vira uma regra combinada previamente, e não uma briga no meio de um incidente. Entrevistadores costumam perguntar o que acontece quando o orçamento nunca é tocado. A resposta esperada é que o SLO pode estar folgado demais, ou que o time está entregando com cautela excessiva, e que o orçamento deveria ser usado em releases mais rápidos ou em migrações mais arriscadas.
Definir o SLO interno igual ao SLA do cliente não deixa margem: a primeira violação do SLO já representa uma multa contratual. O SLO deve ser mais rigoroso que o SLA, para que os alertas disparem e o congelamento comece enquanto o contrato ainda está sendo cumprido.
Redução de toil, plantão e postmortems sem culpa
O tempo de um SRE se divide entre operações e engenharia. Operações incluem plantão, tickets e intervenções manuais. Engenharia inclui automação, planejamento de capacidade e funcionalidades de confiabilidade. Quando o toil passa do limite de 50%, o time de SRE devolve trabalho ao time de desenvolvimento ou investe em automação; do contrário, vira um time de operações com um novo nome.
A saúde do plantão é medida, e não presumida. Os sinais úteis são acionamentos por turno, a proporção de acionamentos que exigiram alguma ação e o tempo até o reconhecimento. Um acionamento que não exige nenhuma ação é um bug no sistema de alertas e deve ser corrigido ou removido. Alertas baseados em sintomas e no burn rate do SLO, como as regras acima, reduzem bastante o volume em comparação com alertas de CPU, memória ou reinícios de pods individuais.
Quando um incidente acontece, o capítulo sobre cultura de postmortem do livro de SRE descreve a análise que vem em seguida. Um postmortem registra o impacto em termos de SLO (quanto do orçamento foi consumido), a linha do tempo, os fatores contribuintes e os itens de ação com responsáveis e prazos. Ele evita apontar uma pessoa como causa. Duas perguntas de acompanhamento são comuns em entrevistas: como garantir que os itens de ação sejam de fato concluídos (acompanhá-los no mesmo backlog das funcionalidades e revisá-los em uma reunião recorrente) e quando um postmortem é obrigatório (qualquer incidente que tenha consumido uma parte relevante do orçamento, qualquer acionamento que tenha acordado alguém, qualquer perda de dados).
Os quatro sinais de ouro do livro de SRE, latência, tráfego, erros e saturação, completam o quadro de monitoramento. Latência e erros normalmente viram SLIs. Tráfego e saturação alimentam o planejamento de capacidade e os dashboards, e não os acionamentos.
Perguntas de entrevista de SRE com respostas esperadas
Estas são as perguntas que se repetem em processos seletivos para SRE e DevOps sênior, com o essencial de uma boa resposta. O módulo de entrevista sobre princípios de SRE aprofunda os mesmos temas, e o módulo de alertas e resposta a incidentes cobre a parte de plantão.
P: Qual a diferença entre SLI, SLO e SLA?
O SLI é a razão medida, o SLO é a meta interna para ela em uma janela e o SLA é o contrato externo com multas. O SLO é mais rigoroso que o SLA para que o time reaja antes de haver prejuízo financeiro.
P: Por que não definir o SLO em 100%?
Porque toda mudança carrega risco, então uma meta de 100% proíbe releases. Além disso, os usuários não conseguem perceber uma confiabilidade superior à da própria rede. A margem abaixo de 100% é o orçamento de erros, que financia os releases.
P: Defina um SLO para uma API de checkout.
Uma resposta forte escolhe dois SLIs (disponibilidade excluindo 4xx e latência abaixo de um limite, medidas no load balancer), uma janela móvel de 30 dias, metas baseadas nos dados do último trimestre, e explica como os alertas e a política de orçamento de erros derivam deles. Citar apenas "99,99% de uptime" sem dizer o que é medido é a resposta fraca clássica.
P: Por que alertas sobre a latência p99 são alertas ruins de SLO?
Um p99 em uma janela curta é ruidoso e não pode ser agregado entre instâncias. Transformar a latência em uma razão de requisições abaixo de um limite a torna aditiva, comparável ao SLI de disponibilidade e compatível com alertas de burn rate.
P: Explique o burn rate e por que os alertas usam duas janelas.
Burn rate é a razão de erros observada dividida pela fração do orçamento; o valor 1 significa que o orçamento dura exatamente a janela. A janela longa filtra picos curtos, e a janela curta permite que o alerta se resolva rapidamente após a recuperação.
P: O que é toil e como mantê-lo sob controle?
Trabalho manual, repetitivo, automatizável, sem valor duradouro e que escala com o serviço. Ele é medido, limitado (o Google usa 50%) e reduzido por meio de automação ou devolvendo o trabalho ao time responsável.
P: O que torna um postmortem livre de culpa?
Ele se concentra nas condições do sistema que permitiram a falha, parte do princípio de que as pessoas agiram de forma razoável com as informações que tinham e gera itens de ação acompanhados. O teste: o engenheiro envolvido compartilharia cada detalhe sem medo?
Perguntas de monitoramento costumam vir logo depois das perguntas sobre SLO na mesma entrevista. O guia de perguntas de entrevista sobre Prometheus cobre PromQL, tipos de métricas e cardinalidade, e a página da tecnologia DevOps reúne todos os módulos para uma preparação mais ampla.
SLOs e orçamentos de erros na prática: o que fixar
- Definir cada SLI como uma razão entre eventos bons e eventos válidos, medida o mais perto do usuário que os dados permitirem, excluindo 4xx das falhas na maioria das APIs
- Escolher o SLO a partir de dados históricos e de uma janela móvel de 28 ou 30 dias, mantendo-o mais rigoroso que qualquer SLA com clientes
- Converter a meta em um orçamento em minutos ou requisições e saber os números de cor: 99,9% em 30 dias equivale a 43 minutos
- Alertar sobre o burn rate com janelas pareadas (14,4 em 1 h e 5 min, 6 em 6 h e 30 min), e não sobre a taxa de erro bruta ou o CPU
- Gerar as regras com o Sloth ou uma ferramenta semelhante assim que mais de dois serviços tiverem SLOs, para manter os limites consistentes
- Redigir e assinar a política de orçamento de erros antes da primeira violação, incluindo a regra de congelamento e o caminho de escalação
- Acompanhar o toil, o volume de acionamentos e os itens de ação dos postmortems com o mesmo rigor aplicado às funcionalidades
Comece a praticar!
Teste seus conhecimentos com nossos simuladores de entrevista e testes tecnicos.
Você saberia encontrar o bug em DevOps?
Um trecho real, um bug escondido, uma tentativa por dia. Sem conta para testar.

Escrito por
Anthony Fillion-MailletFundador da SharpSkill
Desenvolvedor fullstack há mais de 10 anos. Dirige a SharpSkill e responde por tudo o que é publicado aqui.
Atualizado em 7 de novembro de 2026
Tags
Compartilhar
Artigos relacionados

Perguntas de Entrevista sobre Prometheus 2026: Prometheus vs Grafana vs Datadog Comparados
Perguntas de entrevista sobre Prometheus para vagas de DevOps e SRE, com respostas sobre PromQL, tipos de métrica, cardinalidade e HA, além de um comparativo Prometheus vs Grafana vs Datadog de arquitetura, alertas e preços.
Ansible vs Terraform em 2026: Infrastructure as Code e Perguntas de Entrevista DevOps
Comparativo completo entre Ansible e Terraform para Infrastructure as Code em 2026. Entender gerenciamento de configuração vs provisionamento, quando usar cada ferramenta, e preparar-se para entrevistas DevOps.
Docker Compose em 2026: Aplicações Multi-Container, Redes e Perguntas de Entrevista DevOps
Guia completo sobre Docker Compose em 2026 cobrindo aplicações multi-container, configuração avançada de redes e perguntas frequentes em entrevistas DevOps.