Solid Queue i Solid Cache w Rails 8: Kompleksowy przewodnik przed rozmową techniczną 2026
Solid Queue i Solid Cache w Rails 8: zadania wsadowe, tryb fiberów, Active Job Continuations i kluczowe pytania rekrutacyjne na 2026 rok.
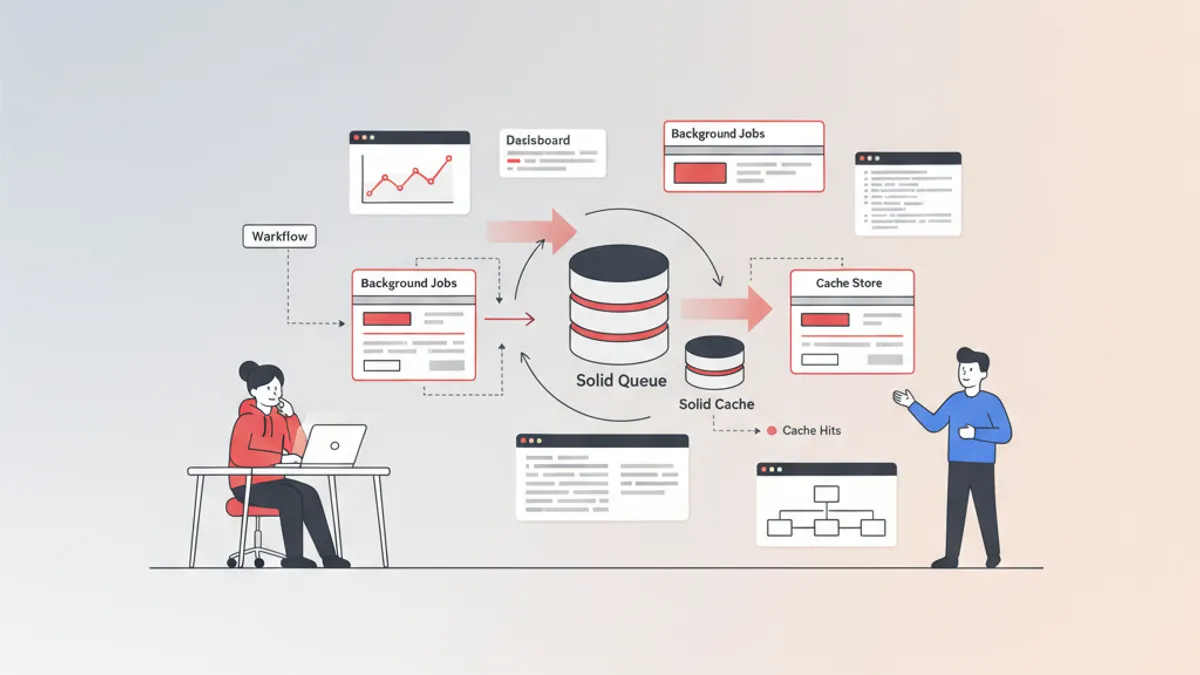
Wraz z premierą Rails 8 nastąpiła fundamentalna zmiana w podejściu do infrastruktury aplikacji Ruby on Rails. Solid Queue i Solid Cache — dwa nowe komponenty dostarczane domyślnie z frameworkiem — zastępują Redis jako silnik kolejek zadań oraz system buforowania. Zamiast utrzymywać dodatkową usługę in-memory, aplikacja opiera się wyłącznie na relacyjnej bazie danych, co radykalnie upraszcza stos technologiczny.
Rails 8 wprowadza trzy komponenty oparte na bazie danych: Solid Queue (zadania w tle), Solid Cache (buforowanie) oraz Solid Cable (WebSocket). Razem eliminują one konieczność konfigurowania i utrzymywania Redis w większości projektów. To zagadnienie pojawia się regularnie na rozmowach technicznych dotyczących Rails 8.
Mechanizm działania Solid Queue — jak baza danych zastępuje Redis
Solid Queue to silnik Active Job oparty na relacyjnej bazie danych. Zadania przechowywane są bezpośrednio w PostgreSQL, MySQL lub SQLite. Kluczowym mechanizmem jest klauzula SQL FOR UPDATE SKIP LOCKED — dostępna w PostgreSQL od wersji 9.5 i MySQL od wersji 8 — która pozwala wielu procesom jednocześnie pobierać zadania z tej samej tabeli bez wzajemnego blokowania.
Architektura składa się z trzech elementów:
- Workers — odpytują tabelę
solid_queue_ready_executionsi rezerwują zadania za pomocąSKIP LOCKED - Dispatchers — przenoszą zaplanowane zadania z
solid_queue_scheduled_executionsdo tabeli gotowych, gdy nadejdzie ich czas wykonania - Schedulers — obsługują cykliczne zadania zdefiniowane w konfiguracji
# config/solid_queue.yml
production:
  dispatchers:
    - polling_interval: 1
      batch_size: 500
  workers:
    - queues: "*"
      threads: 5
      polling_interval: 0.1
      processes: 2
Powyższa konfiguracja uruchamia dwa procesy workerów, każdy z 5 wątkami, odpytujące bazę co 100 ms. Dispatcher sprawdza zaplanowane zadania co sekundę, przetwarzając partie po 500 rekordów.
Transakcyjne kolejkowanie zadań — gwarancja spójności danych
Jednym z najsilniejszych argumentów za Solid Queue jest transakcyjne kolejkowanie. Gdy zadanie zostaje dodane do kolejki wewnątrz transakcji bazodanowej, staje się widoczne dopiero po pomyślnym zatwierdzeniu tej transakcji. Silniki oparte na Redis nie mogą tego zagwarantować — zadanie mogłoby zostać wykonane zanim transakcja, która je utworzyła, dobiegnie końca, co prowadzi do odwoływania się do nieistniejących jeszcze rekordów.
# app/jobs/send_welcome_email_job.rb
class SendWelcomeEmailJob < ApplicationJob
  self.enqueue_after_transaction_commit = true

  queue_as :default

  def perform(user_id)
    user = User.find(user_id)
    UserMailer.welcome(user).deliver_now
  end
end

# app/models/user.rb
class User < ApplicationRecord
  after_create do
    SendWelcomeEmailJob.perform_later(id)
    # Job only enqueued after the CREATE transaction commits
    # No risk of the job running before the user record exists
  end
end
Gdy opcja enqueue_after_transaction_commit jest aktywna, zadanie trafia do kolejki dopiero po zatwierdzeniu transakcji. Jeśli transakcja zostanie wycofana, zadanie nigdy nie zostaje dodane. Eliminuje to całą klasę wyścigów (race conditions), które regularnie dotykają systemy oparte na Redis.
Kontrola współbieżności i priorytetyzacja kolejek
Solid Queue oferuje wbudowane mechanizmy kontroli współbieżności — funkcjonalność, którą Sidekiq udostępnia wyłącznie w płatnej wersji Enterprise. Opcja limits_concurrency ogranicza liczbę jednocześnie uruchomionych zadań danego typu.
# app/jobs/api_sync_job.rb
class ApiSyncJob < ApplicationJob
  limits_concurrency to: 3, key: ->(account_id) { "api_sync_#{account_id}" }

  def perform(account_id)
    account = Account.find(account_id)
    ExternalApi.sync(account)
  end
end
Ten kod gwarantuje, że jednocześnie działają maksymalnie 3 zadania synchronizacji dla danego konta. Zablokowane zadania trafiają do tabeli solid_queue_blocked_executions i automatycznie zostają uruchomione, gdy zwolni się miejsce.
Priorytetyzacja działa na dwóch poziomach: numeryczny priorytet poszczególnych zadań (niższy numer oznacza wyższy priorytet) oraz kolejność kolejek w konfiguracji workera. Oba mechanizmy można łączyć, uzyskując precyzyjną kontrolę nad porządkiem wykonywania.
Często zadawane pytanie na rozmowach dotyczących Rails 8 dotyczy porównania Solid Queue z Sidekiq. Kluczowa różnica: Solid Queue zapewnia gwarancje transakcyjne i wbudowaną kontrolę współbieżności bez dodatkowych kosztów. Sidekiq wygrywa pod względem surowej przepustowości przy dużych wolumenach (ponad 10 000 zadań na minutę), ponieważ Redis operuje w pamięci RAM. W przypadku 95% aplikacji wydajność Solid Queue jest w pełni wystarczająca. Szczegółowe benchmarki dostępne są w artykule porównanie rozwiązań do zadań w tle w Rails.
Zadania wsadowe (batches) do operacji grupowych
Solid Queue 1.7.0 wprowadził zadania wsadowe, pozwalające grupować zadania i śledzić je jako zestaw. Funkcja ta umożliwia uruchamianie callbacków po zakończeniu wszystkich zadań w partii — wzorzec wcześniej wymagający Sidekiq Pro.
# app/jobs/batch_import_job.rb
class BatchImportJob < ApplicationJob
  def perform(file_id)
    file = ImportFile.find(file_id)

    SolidQueue::Batch.enqueue(
      on_finish: BatchFinishedJob,
      on_success: NotifyUserJob,
      on_failure: AlertOpsJob
    ) do |batch|
      file.rows.each_slice(100) do |rows|
        ProcessRowsJob.perform_later(rows.map(&:id))
      end
    end
  end
end
Batch śledzi wszystkie zadania dodane do kolejki w ramach swojego bloku. Gdy wszystkie zadania się zakończą, wywoływany jest on_finish niezależnie od sukcesu czy niepowodzenia. Jeśli wszystkie zadania zakończą się sukcesem, uruchamiany jest on_success. Jeśli którekolwiek zadanie zawiedzie, wywoływany jest on_failure. Umożliwia to przepływy pracy takie jak przetwarzanie importów, gdzie końcowy krok musi poczekać na zakończenie wszystkich części.
Zadania utworzone poza batchem, ale dodane do kolejki wewnątrz niego, dołączają do tego batcha. Batch, który kończy się bez żadnych zadań, kończy się natychmiast, uruchamiając swoje callbacki od razu.
Tryb wykonywania na fiberach dla obciążeń I/O
Solid Queue 1.6.0 dodał wykonywanie workerów oparte na fiberach przy użyciu gema Async. Ten tryb uruchamia zadania na fiberach zamiast wątków, co jest korzystne dla obciążeń związanych z I/O, takich jak wywołania API LLM, gdzie większość czasu upływa na oczekiwaniu na odpowiedzi.
# config/solid_queue.yml
production:
  workers:
    - queues: [llm_calls, external_apis]
      fibers: 100
      polling_interval: 0.5
Ze 100 fiberami można uruchomić 100 równoczesnych zadań związanych z I/O w jednym procesie przy minimalnym zużyciu pamięci. W porównaniu do 100 wątków, które zużywałyby znacznie więcej pamięci i napotykały rywalizację o GVL (Global VM Lock), jest to znacznie wydajniejsze rozwiązanie.
Tryb fiberów wymaga skonfigurowania Rails do izolacji fiberów:
# config/application.rb
config.active_support.isolation_level = :fiber
Zadania obciążające CPU powinny nadal używać wątków, ponieważ fibery nie przynoszą korzyści, gdy praca nie oddaje sterowania do I/O.
Active Job Continuations w Rails 8.1
Rails 8.1 wprowadził Active Job Continuations, pozwalające długotrwałym zadaniom na wstrzymywanie i wznawianie z punktów kontrolnych. Rozwiązuje to problem zadań restartujących się od początku przy przerwaniach spowodowanych wdrożeniami lub restartami kontenerów.
# app/jobs/process_import_job.rb
class ProcessImportJob < ApplicationJob
  include ActiveJob::Continuable

  def perform(import_id)
    @import = Import.find(import_id)

    step :validate do
      @import.validate!
    end

    step :process_records do |step|
      @import.records.find_each(start: step.cursor) do |record|
        record.process
        step.advance!(from: record.id)
      end
    end

    step :finalize do
      @import.mark_complete!
    end
  end
end
Metoda step definiuje odrębne etapy. Jeśli zadanie zostanie przerwane, wznawia się od ostatniego ukończonego kroku. Wewnątrz kroku step.cursor śledzi postęp: step.advance!(from: record.id) zapisuje pozycję kursora. Przy wznowieniu find_each(start: step.cursor) kontynuuje od miejsca, gdzie przetwarzanie zostało przerwane.
Continuations wymagają, aby adapter kolejki implementował metodę stopping?. Solid Queue obsługuje to od wersji 1.2.0. Delayed Job i Resque nie obsługują łagodnego przerywania bez dodatkowej pracy.
Kursor może być dowolną wartością możliwą do serializacji. Dla zagnieżdżonych pętli można użyć tablicy:
step :process_nested, start: [0, 0] do |step|
  Account.find_each(start: step.cursor[0]) do |account|
    account.records.find_each(start: step.cursor[1]) do |record|
      record.process
      step.set!([account.id, record.id + 1])
    end
    step.set!([account.id + 1, 0])
  end
end
Zadania cykliczne bez crona
Solid Queue zastępuje harmonogramy oparte na cronie wbudowanym schedulerem. Zadania cykliczne definiowane są w pliku konfiguracyjnym YAML i zarządzane przez dedykowany proces.
# config/recurring.yml
production:
  cleanup_expired_sessions:
    class: CleanupExpiredSessionsJob
    schedule: every 6 hours
  daily_report:
    class: DailyReportJob
    schedule: every day at 6am
    queue: reports
  weekly_digest:
    class: WeeklyDigestJob
    schedule: every Monday at 9am
Proces schedulera odczytuje ten plik i dodaje odpowiednie zadania do kolejki w zdefiniowanych interwałach. W odróżnieniu od crona, działa w ramach tego samego procesu nadzorcy (supervisor) i współdzieli połączenie z bazą danych. Obsługa stref czasowych została dodana w Solid Queue 1.5.0.
Wdrożenie z integracją Puma
Rails 8 z Kamal oferuje bezproblemowe wdrożenie Solid Queue. Ustawienie zmiennej SOLID_QUEUE_IN_PUMA=1 informuje serwer Puma, aby uruchamiał i nadzorował procesy Solid Queue równolegle z serwerem webowym.
# config/puma.rb (Rails 8 default)
plugin :solid_queue if ENV["SOLID_QUEUE_IN_PUMA"]
Ten model wdrożenia w jednym procesie upraszcza orkiestrację kontenerów. Jeden obraz Docker obsługuje zarówno serwer webowy, jak i przetwarzanie zadań — idealne rozwiązanie dla małych i średnich aplikacji.
Gotowy na rozmowy o Ruby on Rails?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Solid Cache — buforowanie oparte na bazie danych, które skaluje się dzięki SSD
Solid Cache to implementacja ActiveSupport::Cache::Store oparta na bazie danych, która wykorzystuje wydajność nowoczesnych dysków SSD do zastąpienia Redis i Memcached. Założenie jest proste: dyski SSD oferują jedynie nieznacznie wolniejsze odczyty niż pamięć RAM, ale zapewniają wielokrotnie większą pojemność za ułamek ceny. Solid Cache działa produkcyjnie w Basecamp, obsługując 10 TB z 60-dniową retencją i zmniejszając czas renderowania P95 o połowę.
Solid Cache stosuje strategię usuwania FIFO (First In, First Out) zamiast LRU (Least Recently Used). Choć FIFO jest teoretycznie mniej efektywne, znacznie większa przestrzeń dyskowa kompensuje tę różnicę — wpisy pozostają w cache zdecydowanie dłużej, co w praktyce redukuje liczbę chybień.
# config/environments/production.rb
config.cache_store = :solid_cache_store

# config/solid_cache.yml
production:
  databases:
    - cache
  store_options:
    max_age: 604800        # 1 week in seconds
    max_size: 256           # Max entry size in KB
    namespace: "app_v1"
    expiry_batch_size: 100  # Entries cleaned per expiry cycle
Architektura cache i mechanizm wygasania wpisów
Solid Cache śledzi operacje zapisu za pomocą wewnętrznego licznika. Gdy licznik osiągnie 50% skonfigurowanej wartości expiry_batch_size, uruchamiane jest zadanie czyszczące przeterminowane wpisy. To podejście amortyzowane pozwala uniknąć przerw typu stop-the-world, które zdarzają się przy eksmisji LRU w instancjach Redis z ograniczoną pamięcią.
Tabela solid_cache_entries przechowuje wszystkie dane cache:
# db/cache_schema.rb (generated by installer)
create_table :solid_cache_entries do |t|
  t.binary :key, null: false, limit: 1024
  t.binary :value, null: false, limit: 262144  # 256 KB default
  t.datetime :created_at, null: false
  t.index :key, unique: true
  t.index :created_at  # For FIFO expiry
end
Domyślnie odczyt i zapis w tej tabeli korzystają z tej samej puli połączeń co reszta aplikacji. W przypadku aplikacji o dużym ruchu zaleca się skonfigurowanie osobnej bazy danych dla danych cache, aby operacje buforowania nie wpływały na wydajność głównej bazy.
Osobna baza danych dla cache w środowisku produkcyjnym
Izolacja Solid Cache na dedykowanej bazie danych jest prosta i zalecana dla obciążeń produkcyjnych generujących znaczny ruch cache.
# config/database.yml
production:
  primary:
    <<: *default
    database: myapp_production
  cache:
    <<: *default
    database: myapp_cache_production
    migrations_paths: db/cache_migrate
Taka separacja zapewnia, że miliony operacji zapisu cache nie zaśmiecają dziennika WAL (Write-Ahead Log) głównej bazy danych ani nie rywalizują o sloty w puli połączeń z zapytaniami aplikacyjnymi.
Bez osobnej bazy danych operacje odczytu i zapisu Solid Cache uczestniczą w każdej otaczającej transakcji ActiveRecord. Oznacza to, że długotrwała transakcja wstrzymuje zatwierdzenie wpisów cache. W środowisku produkcyjnym zawsze należy skonfigurować dedykowaną bazę danych dla cache.
Sharding i szyfrowanie danych cache
Solid Cache obsługuje rozkład danych cache na wiele baz danych (sharding) w celu rozłożenia obciążenia. Wspiera również szyfrowane atrybuty — dane w cache pozostają zaszyfrowane w spoczynku, co stanowi wymóg zgodności dla aplikacji przetwarzających dane wrażliwe.
# config/solid_cache.yml
production:
  databases:
    - cache_shard_1
    - cache_shard_2
    - cache_shard_3
  store_options:
    max_age: 1209600  # 2 weeks
Wpisy są rozdzielane pomiędzy shardy za pomocą spójnego hashowania (consistent hashing) na kluczu cache. Dodanie lub usunięcie sharda powoduje tymczasowy wzrost chybień w cache w trakcie redystrybucji, ale nie prowadzi do utraty danych.
Monitoring za pomocą Mission Control Jobs
Mission Control Jobs to panel webowy do inspekcji i zarządzania zadaniami Solid Queue. Wyświetla workery, kolejki oraz stany zadań (w trakcie, zakończone, zablokowane, nieudane) poprzez montowany silnik Rails.
# config/routes.rb
Rails.application.routes.draw do
  mount MissionControl::Jobs::Engine, at: "/jobs"
end

# Gemfile
gem "mission_control-jobs", ">= 1.0.1"
Mission Control udostępnia również API konsolowe do masowych operacji na nieudanych zadaniach:
# Rails console
ActiveJob.jobs.failed.where(job_class: "ApiSyncJob").retry_all
ActiveJob.jobs.failed.where(job_class: "BrokenJob").discard_all
Programatyczny dostęp do zadań jest niezbędny przy obsłudze awarii na dużą skalę, bez konieczności ręcznego klikania w interfejsie graficznym.
Źródła
- Rails 8.0 Release Notes — oficjalna dokumentacja dotycząca Solid Queue i Solid Cache jako domyślnych komponentów
- Solid Queue GitHub Releases — changelog dla batchy (v1.7.0), trybu fiberów (v1.6.0) i wsparcia continuations (v1.2.0)
- Active Job Continuations PR — szczegóły implementacji w Rails 8.1
- Introducing Solid Queue (37signals) — uzasadnienie projektowe i wykorzystanie produkcyjne w HEY
Najczęstsze pytania na rozmowach technicznych
Rozmowy kwalifikacyjne dotyczące Rails 8 coraz częściej koncentrują się na stosie Solid. Poniżej przedstawiono pytania, które pojawiają się najczęściej, wraz z oczekiwanym poziomem szczegółowości odpowiedzi.
P: W jaki sposób Solid Queue realizuje współbieżne przetwarzanie zadań bez Redis?
Solid Queue wykorzystuje klauzulę FOR UPDATE SKIP LOCKED. Pozwala ona wielu workerom jednocześnie odpytywać tę samą tabelę bez wzajemnego blokowania. Każdy worker blokuje partię wierszy, przetwarza je i usuwa rekordy wykonań. Pozostałe workery pomijają zablokowane wiersze i rezerwują inne zadania.
P: Jaki problem rozwiązuje transakcyjne kolejkowanie?
Zapobiega wykonywaniu zadań zanim transakcja bazodanowa, która je wyzwoliła, zostanie zatwierdzona. Bez tego mechanizmu zadanie mogłoby odwoływać się do rekordu, który został wycofany, powodując błąd ActiveRecord::RecordNotFound.
P: Dlaczego Solid Cache stosuje FIFO zamiast LRU? FIFO jest prostsze w implementacji w bazie danych i eliminuje narzut zapisu związany z aktualizacją znaczników czasu dostępu przy każdym odczycie. Kompensacją jest pojemność dysku SSD — wpisy żyją dłużej, więc współczynnik trafień pozostaje wysoki mimo mniej optymalnej strategii eksmisji.
P: Jak działają zadania wsadowe (batches) w Solid Queue?
Zadania dodane do kolejki wewnątrz bloku SolidQueue::Batch.enqueue są śledzone razem. Batch wywołuje on_finish gdy wszystkie zadania się zakończą, on_success jeśli wszystkie zakończą się sukcesem, lub on_failure jeśli którekolwiek zawiedzie. Umożliwia to przepływy pracy takie jak importy wsadowe, gdzie końcowy krok zależy od ukończenia wszystkich części.
P: Czym są Active Job Continuations i kiedy należy ich używać? Continuations pozwalają długotrwałym zadaniom zapisywać punkty kontrolne postępu i wznawiać się po przerwaniu. Należy ich używać dla zadań przetwarzających duże zbiory danych, takich jak importy lub aktualizacje wsadowe, gdzie restart od początku przy każdym wdrożeniu marnowałby znaczną ilość czasu i zasobów.
P: Kiedy aplikacja powinna nadal korzystać z Redis zamiast stosu Solid? Redis pozostaje lepszym wyborem dla aplikacji przetwarzających ponad 10 000 zadań na minutę, obciążeń wymagających odczytów cache poniżej milisekundy lub aplikacji, które już używają Redis do innych celów (Pub/Sub, rate limiting, sesje). Stos Solid stawia na prostotę, nie na szczytową przepustowość.
Więcej pytań i ćwiczeń dostępnych jest w modułach ActiveJob i zadania w tle oraz Strategie buforowania na platformie SharpSkill.
Gotowy na rozmowy o Ruby on Rails?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Co warto zapamiętać o Solid Queue i Solid Cache w Rails 8
- Solid Queue zastępuje kolejki zadań oparte na Redis rozwiązaniem bazodanowym, wykorzystując
FOR UPDATE SKIP LOCKEDdo współbieżnego przetwarzania - Transakcyjne kolejkowanie eliminuje wyścigi między zapisem do bazy a wykonaniem zadania — gwarancja, której Redis nie jest w stanie zapewnić
- Zadania wsadowe (v1.7.0) umożliwiają operacje grupowe z callbackami zakończenia — funkcja wcześniej dostępna tylko w Sidekiq Pro
- Tryb wykonywania na fiberach (v1.6.0) zwiększa przepustowość dla obciążeń I/O, takich jak wywołania API LLM
- Active Job Continuations (Rails 8.1) pozwalają długotrwałym zadaniom zapisywać punkty kontrolne i wznawiać się po przerwaniu
- Wbudowana kontrola współbieżności, zadania cykliczne i integracja z Puma są dostępne w Solid Queue bez dodatkowych opłat
- Solid Cache wykorzystuje buforowanie FIFO wspierane przez SSD z opcjonalnym shardingiem i szyfrowaniem, usuwając Memcached i Redis ze stosu infrastrukturalnego
- Osobna konfiguracja bazy danych dla Solid Cache zapobiega wpływowi operacji cache na wydajność głównej bazy
- Mission Control Jobs zapewnia monitoring produkcyjny oraz masowe zarządzanie zadaniami przez panel webowy i API konsolowe
- Dla większości aplikacji Rails 8 w 2026 roku stos Solid jest zalecanym ustawieniem domyślnym — Redis pozostaje wyborem wyłącznie dla skrajnych przypadków wysokiej przepustowości przekraczającej 10 000 zadań na minutę
Zacznij ćwiczyć!
Sprawdź swoją wiedzę z naszymi symulatorami rozmów i testami technicznymi.
Znajdziesz błąd w Ruby on Rails?
Prawdziwy fragment kodu, ukryty błąd, jedna próba dziennie. Bez konta, żeby spróbować.

Autor:
Anthony Fillion-MailletZałożyciel SharpSkill
Programista fullstack od ponad 10 lat. Prowadzi SharpSkill i odpowiada za wszystko, co się tu ukazuje.
Zaktualizowano 10 października 2026
Tagi
Udostępnij
Powiązane artykuły
Ruby on Rails 8: Przewodnik po Nowych Funkcjach i Migracji 2026
Rails 8 wprowadza Solid Trifecta, natywne uwierzytelnianie, Kamal 2 oraz Propshaft. Kompleksowy przewodnik z przykładami kodu i krokami migracji z Rails 7.
Zadania w Tle w Rails 2026: Sidekiq vs Good Job — Porównanie i Pytania Rekrutacyjne
Kompleksowe porównanie Sidekiq, Good Job i Solid Queue w Rails 8. Analiza wydajności, funkcjonalności oraz najczęstsze pytania rekrutacyjne dotyczące background jobs w Ruby on Rails.
Praca dla freelancerów Ruby on Rails w 2026: gdzie szukać zleceń, stawki dzienne i przygotowanie do projektów
Kompletny przewodnik po rynku freelance dla programistów Ruby on Rails w 2026 roku. Dowiedz się, gdzie szukać kontraktów, jakie są stawki dzienne i jak przygotować się do rozmów z klientami.