RAG i LLM w 2026: Retrieval-Augmented Generation na rozmowach z data science
Retrieval-Augmented Generation (RAG) wyjaśniony pod kątem rozmów z data science w 2026 roku. Bazy wektorowe, strategie chunkingu, modele osadzeń, agentic RAG, Graph RAG i architektura pipeline'u gotowego do produkcji.
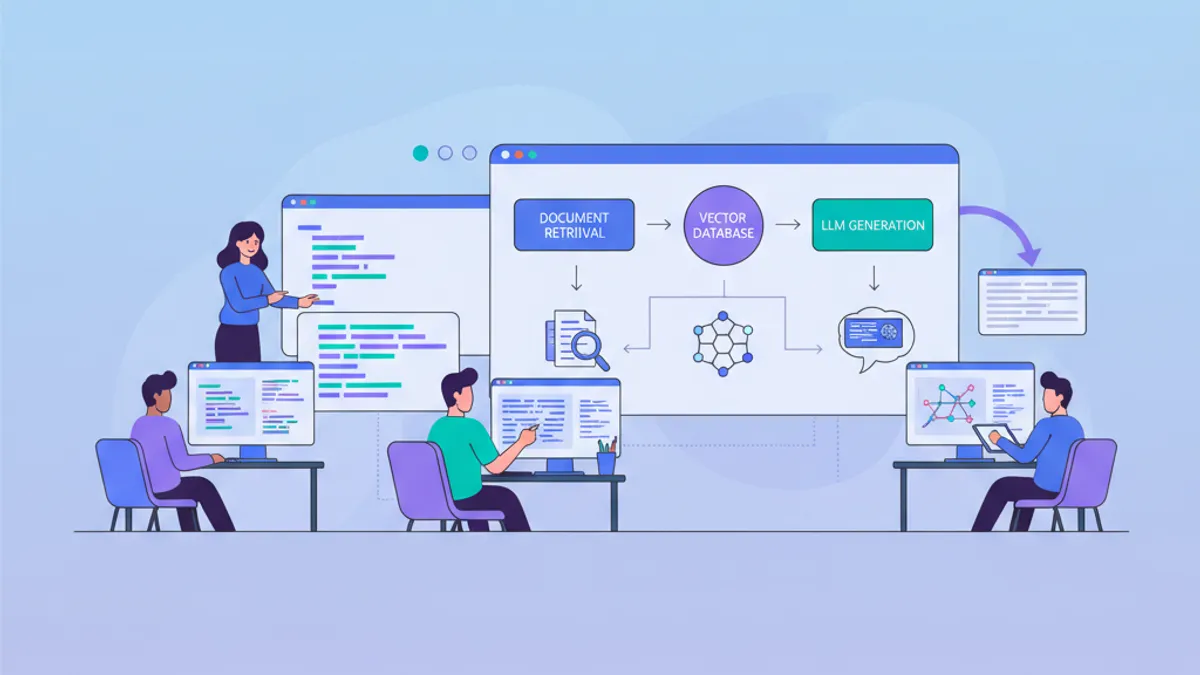
Retrieval-Augmented Generation (RAG) stało się standardową architekturą do osadzania wyników modeli LLM w faktach i aktualnych danych. Na rozmowach z zakresu data science i inżynierii AI w 2026 roku pytania o RAG pojawiają się obok klasycznych tematów ML, sprawdzając zarówno myślenie w kategoriach projektowania systemów, jak i praktyczne umiejętności implementacyjne.
Retrieval-Augmented Generation łączy system wyszukiwania (przeszukiwanie wektorowe bazy wiedzy) z generatorem LLM, dzięki czemu model odpowiada na podstawie rzeczywistych dokumentów, a nie zapamiętanych danych treningowych.
Jak działa pipeline RAG od początku do końca
System RAG działa w dwóch fazach: offline'owej fazie ingestii, która buduje bazę wiedzy, oraz online'owej fazie zapytań, która pobiera odpowiedni kontekst i generuje odpowiedź.
Podczas ingestii surowe dokumenty przechodzą przez czyszczenie, dzielenie na fragmenty (chunking) i osadzanie (embedding), zanim trafią do bazy wektorowej. Podczas wnioskowania zapytanie użytkownika podąża tą samą ścieżką osadzania, a wyszukiwanie najbliższych sąsiadów pobiera najbardziej trafne fragmenty. Fragmenty te stają się częścią promptu LLM, osadzając wygenerowaną odpowiedź w materiale źródłowym.
# rag_pipeline.py
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

# Offline: ingest documents into the vector store
def build_index(documents: list[str]) -> Chroma:
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=512,       # tokens per chunk
        chunk_overlap=64,     # overlap preserves context at boundaries
        separators=["\n\n", "\n", ". ", " "]
    )
    chunks = splitter.create_documents(documents)
    embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
    return Chroma.from_documents(chunks, embeddings)

# Online: retrieve + generate
def query(vectorstore: Chroma, question: str) -> str:
    retriever = vectorstore.as_retriever(
        search_type="mmr",    # Maximal Marginal Relevance for diversity
        search_kwargs={"k": 5, "fetch_k": 20}
    )
    prompt = ChatPromptTemplate.from_template(
        "Answer based on this context only:\n{context}\n\nQuestion: {question}"
    )
    chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | prompt
        | ChatOpenAI(model="gpt-5.5", temperature=0)
    )
    return chain.invoke(question).content
Ten pipeline obejmuje główną pętlę RAG: podziel, osadź, zapisz, pobierz, wygeneruj. Parametr search_type="mmr" zapewnia, że pobrane fragmenty są zarówno trafne, jak i zróżnicowane, redukując redundancję w oknie kontekstu.
Strategie chunkingu, które naprawdę mają znaczenie
Chunking wpływa na jakość wyszukiwania bardziej niż jakikolwiek inny komponent. Słaby chunking oznacza, że wyszukiwarka zwraca fragmenty, które albo nie mają kontekstu, albo rozcieńczają sygnał nieistotną treścią.
W systemach produkcyjnych w 2026 roku dominują trzy podejścia do chunkingu:
Chunking o stałym rozmiarze dzieli tekst po ustalonej liczbie tokenów (zwykle od 256 do 512 tokenów) z zakładką (overlap). Prosty w implementacji, ale dzieli zdania i myśli w połowie.
Chunking semantyczny wykrywa granice tematów, mierząc podobieństwo osadzeń między kolejnymi zdaniami. Gdy podobieństwo spada poniżej progu, zaczyna się nowy fragment. Każdy fragment niesie spójną myśl, a nie przypadkowy wycinek tekstu.
Późny chunking (late chunking) najpierw stosuje model transformera do całego dokumentu, tworząc kontekstowe osadzenia tokenów, a dopiero potem dzieli na fragmenty. Zachowuje to zależności dalekiego zasięgu, które tradycyjny chunking niszczy.
# semantic_chunking.py
import numpy as np
from sentence_transformers import SentenceTransformer

def semantic_chunk(text: str, threshold: float = 0.3) -> list[str]:
    """Split text where semantic similarity drops below threshold."""
    model = SentenceTransformer("all-MiniLM-L6-v2")
    sentences = text.split(". ")
    embeddings = model.encode(sentences)

    chunks, current_chunk = [], [sentences[0]]

    for i in range(1, len(sentences)):
        # Cosine similarity between consecutive sentences
        sim = np.dot(embeddings[i-1], embeddings[i]) / (
            np.linalg.norm(embeddings[i-1]) * np.linalg.norm(embeddings[i])
        )
        if sim < threshold:       # topic shift detected
            chunks.append(". ".join(current_chunk))
            current_chunk = [sentences[i]]
        else:
            current_chunk.append(sentences[i])

    chunks.append(". ".join(current_chunk))  # final chunk
    return chunks
Kluczowy wniosek na rozmowę: rozmiar fragmentu to kompromis między precyzją a czułością (precision-recall). Małe fragmenty (100 tokenów) poprawiają precyzję wyszukiwania, ale fragmentują kontekst. Duże fragmenty (1000 tokenów) zachowują kontekst, ale rozcieńczają specyficzność osadzeń. Większość systemów produkcyjnych ląduje na 256 do 512 tokenach z 10 do 20% zakładką.
Bazy wektorowe i modele osadzeń w produkcji
Baza wektorowa przechowuje osadzenia i obsługuje szybkie przybliżone wyszukiwanie najbliższych sąsiadów (ANN). Dobór odpowiedniej kombinacji modelu osadzeń i bazy wektorowej bezpośrednio wpływa na opóźnienie i dokładność wyszukiwania.
Modele osadzeń w 2026 roku skupiły się wokół kilku wysokowydajnych opcji. text-embedding-3-large od OpenAI (3072 wymiary) oraz rozwiązania open-source, takie jak bge-m3 od BAAI czy embed-v4 od Cohere, oferują mocne wyszukiwanie wielojęzyczne. Ranking MTEB pozostaje standardowym benchmarkiem do porównywania jakości osadzeń. Warto zauważyć, że text-embedding-3-large obsługuje Matryoshka representation learning, co pozwala na redukcję wymiarów (do 1024 lub 256) przy minimalnej utracie jakości, znacząco obniżając koszty przechowywania.
Rynek baz wektorowych skonsolidował się w 2026 roku. Cztery produkty obsługują zdecydowaną większość produkcyjnych obciążeń RAG:
| Baza | Indeksowanie | Zarządzana | Mocna strona |
|---|---|---|---|
| Pinecone | Własnościowe | Tak | Zero-ops, wbudowane wnioskowanie, wyszukiwanie hybrydowe |
| Weaviate | HNSW | Tak/własna | Natywna fuzja BM25 + dense w jednym zapytaniu |
| Qdrant | HNSW | Tak/własna | Wydajność Rusta, filtrowanie payload, najlepszy darmowy tier |
| pgvector | IVF, HNSW | Własna | Integracja z PostgreSQL dla istniejących stacków |
W kontekście rozmowy kwalifikacyjnej kluczowe jest zrozumienie algorytmu HNSW (Hierarchical Navigable Small World): buduje on wielowarstwowy graf, w którym każdy węzeł łączy się z najbliższymi sąsiadami, umożliwiając wyszukiwanie O(log n) kosztem większego zużycia pamięci.
Punkt przełomowy kosztów to 60 do 80 milionów zapytań miesięcznie. Powyżej tego progu samodzielnie hostowany Qdrant lub Weaviate na infrastrukturze o stałym koszcie konsekwentnie podbija zarządzany Pinecone Serverless od 3x do 10x.
Gotowy na rozmowy o Data Science & ML?
Ćwicz z naszymi interaktywnymi symulatorami, flashcards i testami technicznymi.
Wyszukiwanie hybrydowe: łączenie wyszukiwania gęstego i rzadkiego
Czyste wyszukiwanie wektorowe zawodzi przy dokładnych dopasowaniach słów kluczowych i rzadkich terminach. Czyste wyszukiwanie leksykalne (BM25) pomija podobieństwo semantyczne. Wyszukiwanie hybrydowe łączy oba podejścia i w 2026 roku jest to domyślne rozwiązanie dla produkcyjnych systemów RAG.
Standardowy wzorzec wykorzystuje Reciprocal Rank Fusion (RRF) do scalania uszeregowanych wyników z obu wyszukiwarek:
# hybrid_retrieval.py
from rank_bm25 import BM25Okapi
import numpy as np

def reciprocal_rank_fusion(
    dense_results: list[str],
    sparse_results: list[str],
    k: int = 60
) -> list[str]:
    """Merge dense (vector) and sparse (BM25) results using RRF."""
    scores: dict[str, float] = {}

    for rank, doc_id in enumerate(dense_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    for rank, doc_id in enumerate(sparse_results):
        scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank + 1)

    # Sort by combined RRF score, highest first
    return sorted(scores.keys(), key=lambda d: scores[d], reverse=True)
Wyszukiwanie hybrydowe rozwiązuje problem niedopasowania słownictwa, gdy użytkownik pyta o anulowanie subskrypcji, a właściwy dokument używa sformułowania polityka rozwiązania konta. BM25 wychwytuje dokładne pokrycie terminów, podczas gdy wyszukiwanie wektorowe ujmuje relację semantyczną.
Reranking: filtr drugiego etapu
Wyszukiwanie zwraca kandydatów. Reranking sortuje ich według rzeczywistej trafności. Rerankery typu cross-encoder, takie jak Cohere Rerank czy bge-reranker-v2.5-gemma2-lightweight, oceniają każdą parę zapytanie-dokument wspólnie, dając znacznie dokładniejsze oceny trafności niż podobieństwo bi-enkodera.
Dwuetapowy pipeline wyszukiwania, z szerokim pierwszym etapem (top 50 do 100 kandydatów przez wektory + BM25), a następnie precyzyjnym rerankingiem (top 5 do 10 do promptu), jest standardem w produkcji. Utrzymuje to opóźnienie pod kontrolą: pierwszy etap używa szybkiego wyszukiwania ANN, a kosztowny cross-encoder przetwarza tylko mały zbiór kandydatów.
Cross-enkodery są dokładniejsze niż bi-enkodery, ponieważ przetwarzają zapytanie i dokument razem przez wszystkie warstwy transformera. Bi-enkodery osadzają je niezależnie, tracąc subtelne sygnały interakcji. Kompromisem jest szybkość: cross-enkoderów nie da się wstępnie zindeksować.
Adaptive RAG: kierowanie zapytań do odpowiedniego pipeline'u
Nie każde zapytanie wymaga tej samej złożoności wyszukiwania. Adaptive RAG trenuje mały klasyfikator, który kieruje każde pytanie do optymalnej ścieżki:
- Bez wyszukiwania dla prostych zapytań faktograficznych, które model już zna
- Jednoetapowe wyszukiwanie dla umiarkowanych zapytań
- Wieloetapowe iteracyjne wyszukiwanie dla złożonego rozumowania
Ten wzorzec równoważy koszt i dokładność w mieszanych obciążeniach. System produkcyjny obsługujący 100 000 zapytań dziennie może obniżyć koszty wnioskowania o 40%, kierując proste pytania z dala od kosztownych wieloetapowych pipeline'ów.
Sam klasyfikator może być małym dostrojonym modelem lub promptem zero-shot, który pyta: Czy to pytanie wymaga zewnętrznej wiedzy, aby odpowiedzieć dokładnie?
Speculative RAG: wymiana opóźnienia na szybkość
Speculative RAG uruchamia wyszukiwanie równolegle z szybką generacją wersji roboczej. Jeśli wersja robocza wykazuje wysoką pewność (mierzoną przez logprob), etap wyszukiwania jest całkowicie pomijany. Jeśli pewność jest niska, pobrany kontekst łączy się z wersją roboczą i następuje regeneracja.
To podejście skraca średnie opóźnienie o 30 do 40% przy zapytaniach o wysokiej pewności. Sprawdza się najlepiej w chatbotach czasu rzeczywistego, sugestiach autouzupełniania i systemach obsługi klienta, gdzie czas odpowiedzi jest ważniejszy niż wyczerpujące źródłowanie każdego zapytania.
Kompromis: speculative RAG czasami zwraca odpowiedzi bez osadzenia w faktach, gdy model jest zbyt pewny siebie. Systemy produkcyjne łączą go z kalibracją pewności i rezerwowym pełnym wyszukiwaniem, gdy niepewność przekracza próg.
Agentic RAG: poza jednorazowym wyszukiwaniem
Naiwny RAG wyszukuje raz i generuje. Agentic RAG traktuje LLM jako agenta rozumującego, który decyduje, kiedy wyszukiwać, czego wyszukiwać i czy pobrany kontekst jest wystarczający.
W 2026 roku agentic RAG jest dominującym wzorcem dla złożonych zapytań wymagających wieloetapowego rozumowania. Agent może:
- Samoocena: Ocenić, czy pobrane dokumenty odpowiadają na pytanie
- Ponowne zapytanie: Przeformułować zapytanie, jeśli początkowe wyniki są niewystarczające
- Routing: Wybrać między różnymi źródłami wiedzy (baza wektorowa, baza SQL, API)
- Weryfikacja: Skontrolować fakty w wielu pobranych fragmentach
# agentic_rag.py
from langgraph.graph import StateGraph, END
from langgraph.prebuilt import create_react_agent
from typing import TypedDict

class RAGState(TypedDict):
    question: str
    documents: list[str]
    generation: str
    retries: int

def retrieve(state: RAGState) -> RAGState:
    """Retrieve documents from vector store."""
    docs = vectorstore.similarity_search(state["question"], k=5)
    return {"documents": [d.page_content for d in docs]}

def grade_documents(state: RAGState) -> str:
    """Decide if documents are relevant enough to answer."""
    prompt = f"Are these documents relevant to: {state['question']}?\n"
    prompt += "\n".join(state["documents"])
    relevance = llm.invoke(prompt)  # returns 'relevant' or 'not_relevant'
    return "generate" if "relevant" in relevance.content else "rewrite"

def rewrite_query(state: RAGState) -> RAGState:
    """Reformulate the query for better retrieval."""
    new_query = llm.invoke(
        f"Rewrite this query for better search results: {state['question']}"
    )
    return {"question": new_query.content, "retries": state["retries"] + 1}

# Build the agent graph using LangGraph 1.2+
workflow = StateGraph(RAGState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("rewrite", rewrite_query)
workflow.add_node("generate", generate_answer)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade", grade_documents,
    {"generate": "generate", "rewrite": "rewrite"})
workflow.add_edge("rewrite", "retrieve")  # retry loop
workflow.add_edge("generate", END)
Ten wzorzec (wyszukaj, oceń, opcjonalnie przeformułuj i ponów) znany jest jako Corrective RAG (CRAG). Warto zauważyć, że AgentExecutor z LangChain jest przestarzały od 2026 roku; nowe projekty powinny używać create_react_agent() dla gotowych wzorców lub StateGraph z LangGraph dla niestandardowej orkiestracji. Więcej informacji o wzorcach LangChain dla data scientists znajduje się w dedykowanym artykule.
Graph RAG: wyszukiwanie wiedzy strukturalnej
Graph RAG wyodrębnia encje i relacje z dokumentów do grafu wiedzy, a następnie odpytuje zarówno graf, jak i bazę wektorową. Ta architektura redukuje halucynacje przy zapytaniach faktograficznych, osadzając odpowiedzi w jawnych relacjach między encjami zamiast w niestrukturalnym podobieństwie tekstu.
Pipeline ingestii wyodrębnia trójki (podmiot, predykat, obiekt) z każdego fragmentu dokumentu. W czasie zapytania system identyfikuje istotne encje w pytaniu, przemierza graf wiedzy w poszukiwaniu powiązanych faktów i łączy kontekst pobrany z grafu z fragmentami pobranymi wektorowo.
Graph RAG sprawdza się przy pytaniach wymagających rozumowania wieloetapowego (multi-hop), takich jak: Który zespół prowadzi projekt korzystający z frameworku wspomnianego w dokumencie X? To zapytania wymagające łączenia faktów z wielu dokumentów. Czyste wyszukiwanie wektorowe ma tu trudności, ponieważ żaden pojedynczy fragment nie zawiera kompletnej odpowiedzi.
Graph RAG znacząco poprawia dokładność faktograficzną (nawet o 40% mniej halucynacji przy zapytaniach bogatych w encje), ale wymaga dojrzałego pipeline'u ekstrakcji encji. Zaszumiona ekstrakcja tworzy zaszumiony graf, co może pogorszyć wyniki poniżej naiwnego RAG. Warto też zauważyć, że projekt GraphRAG od Microsoftu wszedł w tryb konserwacji w 2026 roku; będzie otrzymywał poprawki błędów, ale nie nowe funkcje.
Wariant LazyGraphRAG od Microsoftu (wydany w czerwcu 2025) drastycznie obniża koszty indeksowania, odkładając podsumowanie do czasu zapytania, co czyni go odpowiednim dla analizy eksploracyjnej lub danych strumieniowych, gdzie wstępna konstrukcja grafu jest niepraktyczna.
Zgodność z EU AI Act dla systemów RAG
EU AI Act zaczął szeroko obowiązywać w sierpniu 2026 roku. Pierwsza głośna kara na mocy ustawy dotknęła chatbota RAG europejskiego konsorcjum bankowego pod koniec maja 2026 roku, a frankfurcka firma zarządzająca majątkiem otrzymała karę 4,5 miliona euro w kwietniu 2026 roku za system RAG dla klientów, który nie wyjaśniał pochodzenia danych.
Architektury RAG w naturalny sposób spełniają kilka wymogów zgodności: identyfikowalność źródeł (fragmenty zawierają odniesienia do dokumentów), przejrzystość odpowiedzi (cytowania można wyświetlić) oraz auditowalność (logi wyszukiwania istnieją z natury konstrukcji). Jednak pełna zgodność wymaga dodatkowych środków:
Klasyfikacja ryzyka: Publiczny chatbot należy do kategorii ograniczonego ryzyka (wymagana przejrzystość). Medyczny lub prawny system RAG to wysokie ryzyko z surowszymi wymaganiami dokumentacyjnymi i nadzorczymi.
Logowanie audytowe: Rejestrowanie, które pytanie wywołało które pobrane fragmenty i jaka odpowiedź została wygenerowana. Ten log stanowi podstawę wymaganej identyfikowalności.
Nadzór człowieka: Systemy wysokiego ryzyka wymagają walidacji przez człowieka w wrażliwych przypadkach, możliwości korygowania wyników oraz mechanizmów usuwania zindeksowanych danych na żądanie.
Rezydencja danych: Hostowanie indeksowania w UE i korzystanie z BYOK (Bring Your Own Key), aby zapewnić, że dane nie przechodzą przez konta zewnętrzne poza jurysdykcją.
Niezgodność może kosztować 7% globalnego rocznego przychodu. W kontekście rozmów kwalifikacyjnych kluczowe jest to, że wrodzona zdolność RAG do cytowania jest atutem, ale nie zastępuje warstwy zarządzania.
Ocena systemów RAG: metryki, które mają znaczenie
Ocena RAG dzieli się na metryki wyszukiwania i metryki generowania. Oba zestawy trzeba mierzyć niezależnie, aby diagnozować awarie.
Metryki wyszukiwania:
- Recall@k: Czy istotne dokumenty pojawiły się w top k wyników?
- MRR (Mean Reciprocal Rank): Jak wysoko uszeregowany jest pierwszy istotny wynik?
- NDCG: Czy uszeregowanie odpowiada idealnej kolejności trafności?
Metryki generowania:
- Wierność (faithfulness): Czy odpowiedź korzysta wyłącznie z informacji z pobranego kontekstu? (Mierzy halucynacje)
- Trafność odpowiedzi: Czy odpowiedź odnosi się do pierwotnego pytania?
- Precyzja kontekstu: Czy pobrane fragmenty są rzeczywiście wykorzystane w odpowiedzi?
Frameworki takie jak Ragas i DeepEval automatyzują te oceny, wykorzystując wzorce LLM-jako-sędzia (LLM-as-judge). Najczęstsze pytania na rozmowach z data science coraz częściej obejmują projektowanie oceny RAG, więc należy spodziewać się pytania o to, jak zmierzyć, czy system RAG działa poprawnie.
Tryby awarii w produkcji i debugowanie
Systemy RAG zawodzą w przewidywalny sposób. Znajomość tych wzorców jest niezbędna zarówno na rozmowach, jak i w rzeczywistym wdrożeniu.
Zanieczyszczenie okna kontekstu następuje, gdy zbyt wiele pobranych fragmentów rozcieńcza istotny sygnał. LLM otrzymuje 10 fragmentów, ale tylko 2 zawierają przydatne informacje. Rozwiązanie: użyj rerankera do filtrowania i zmniejsz top-k w wyszukiwarce.
Artefakty chunkingu powstają, gdy dzielenie o stałym rozmiarze przerywa zdania, tabele lub bloki kodu w połowie elementu. Pobrany fragment jest składniowo niekompletny i semantycznie bezużyteczny. Rozwiązuje to chunking semantyczny lub dzielenie świadome dokumentu (z poszanowaniem nagłówków, akapitów, bloków kodu).
Dryf osadzeń (embedding drift) pojawia się, gdy model osadzeń zostaje zaktualizowany, ale baza wektorowa nadal zawiera osadzenia ze starego modelu. Zapytania zakodowane nowym modelem przeszukują przestrzeń wektorową zbudowaną przez stary, pogarszając jakość wyszukiwania. Rozwiązanie: ponownie osadź cały korpus po każdej zmianie modelu.
Przestarzałe indeksy dostarczają nieaktualnych informacji, ponieważ pipeline ingestii pozostał w tyle za aktualizacjami dokumentów. W systemach uczenia maszynowego jest to analogiczne do rozbieżności trening-serwowanie (training-serving skew), gdzie system wyszukiwania widzi inny rozkład danych niż ten istniejący w produkcji.
Źródła
- Turing Post: 20 Advanced RAG Types to Know in 2026 - kompleksowa taksonomia wzorców RAG
- LangChain and LangGraph 1.0 Milestones - wycofanie AgentExecutor, nowe wzorce
- Microsoft GraphRAG GitHub - status trybu konserwacji
- IgnitionRAG EU AI Act Guide - wymagania zgodności dla systemów RAG
- MarkTechPost: Best Vector Databases in 2026 - konsolidacja rynku i ceny
Zacznij ćwiczyć!
Sprawdź swoją wiedzę z naszymi symulatorami rozmów i testami technicznymi.
Co warto zapamiętać o RAG na rozmowach z data science
- RAG łączy wyszukiwanie (przeszukiwanie wektorowe bazy wiedzy) z generowaniem LLM, aby tworzyć osadzone w faktach odpowiedzi bez ponownego trenowania modelu
- Strategia chunkingu ma największy wpływ na jakość wyszukiwania; chunking semantyczny i późny chunking przewyższają dzielenie o stałym rozmiarze w większości zastosowań
- Wyszukiwanie hybrydowe (gęste wektory + rzadkie BM25) z Reciprocal Rank Fusion to produkcyjny standard, rozwiązujący problem niedopasowania słownictwa, z którym czyste wyszukiwanie wektorowe nie radzi sobie
- Rerankery cross-encoder dodają warstwę precyzji po szerokim wyszukiwaniu, przetwarzając tylko mały zbiór kandydatów, aby utrzymać akceptowalne opóźnienie
- Adaptive RAG kieruje zapytania do odpowiedniej złożoności pipeline'u, obniżając koszty o 40% przy mieszanych obciążeniach
- Speculative RAG wymienia osadzenie w faktach na szybkość, redukując opóźnienie o 30 do 40% przy zapytaniach o wysokiej pewności
- Agentic RAG (wyszukaj, oceń, przeformułuj, ponów) i Graph RAG (ekstrakcja relacji encji) obsługują złożone zapytania wieloetapowe, na których naiwny RAG zawodzi
- Zgodność z EU AI Act (sierpień 2026) wymaga logowania audytowego, nadzoru człowieka i klasyfikacji ryzyka dla produkcyjnych systemów RAG
- Ocena musi oddzielać metryki wyszukiwania (Recall@k, MRR) od metryk generowania (wierność, trafność odpowiedzi), aby diagnozować, gdzie pipeline się załamuje
- Najczęstsze awarie produkcyjne (zanieczyszczenie kontekstu, artefakty chunkingu, dryf osadzeń, przestarzałe indeksy) mają proste rozwiązania, gdy zostaną zidentyfikowane
Znajdziesz błąd w Data Science & ML?
Prawdziwy fragment kodu, ukryty błąd, jedna próba dziennie. Bez konta, żeby spróbować.

Autor:
Anthony Fillion-MailletZałożyciel SharpSkill
Programista fullstack od ponad 10 lat. Prowadzi SharpSkill i odpowiada za wszystko, co się tu ukazuje.
Zaktualizowano 24 sierpnia 2026
Tagi
Udostępnij
Powiązane artykuły
Feature Engineering w Machine Learning: Techniki, Pipelines i Pytania Rekrutacyjne 2026
Kompletny przewodnik po feature engineering w uczeniu maszynowym: kodowanie zmiennych, skalowanie, transformacje, selekcja cech i pytania rekrutacyjne na 2026 rok.
XGBoost vs LightGBM w 2026: Gradient Boosting i Pytania Rekrutacyjne z Data Science
Kompleksowe porównanie XGBoost i LightGBM w 2026 roku. Poznaj kluczowe różnice w architekturze, optymalizacji i zastosowaniach oraz przygotuj się do pytań rekrutacyjnych z machine learning.
Praca freelance data scientist w 2026: gdzie szukać zleceń, stawki dzienne i przygotowanie do rozmów
Przewodnik po pracy freelance data scientist w 2026 roku. Gdzie znajdziesz kontrakty, jakie są stawki dzienne oraz jak przygotować się do rozmów technicznych.