SRE-principes in 2026: reliability engineering, SLO's en sollicitatievragen
SRE-principes uitgelegd voor 2026: SLI's kiezen, SLO's vastleggen, het error budget berekenen, burn rate-alerts met meerdere vensters in Prometheus schrijven en de SRE-sollicitatievragen beantwoorden die in elk gesprek terugkomen.
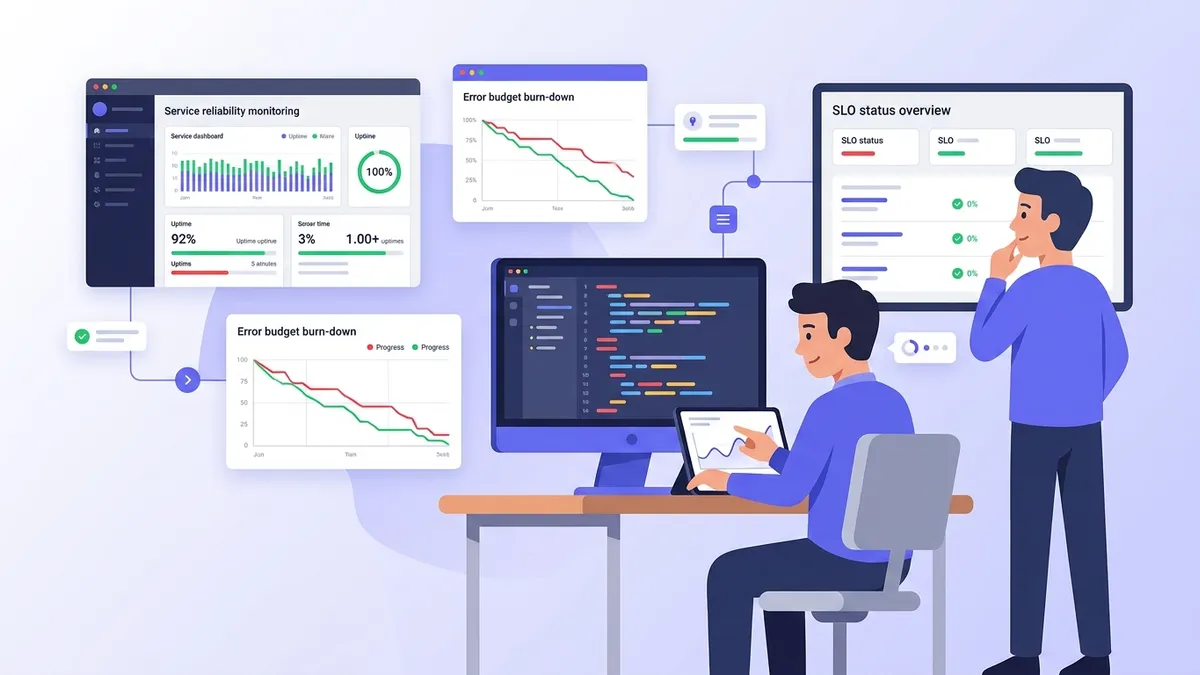
Betrouwbaarheid blijft in veel teams een vaag streven: het platform moet "gewoon werken", tot een storing het tegendeel bewijst. De SRE-principes maken van dat streven een getal waarover development en product het vooraf eens zijn, en gebruiken dat getal om te bepalen wanneer er wordt gereleased en wanneer er op de rem wordt getrapt. Site reliability engineering, ontstaan bij Google en inmiddels gangbaar in de meeste platformteams, rust op een handvol ideeën: meten wat gebruikers werkelijk ervaren (SLI's), een doel onder de 100% vastleggen (SLO's), het verschil bewust besteden als error budget en het handmatige werk dat systemen draaiende houdt aan banden leggen. SRE-sollicitatievragen in 2026 toetsen precies deze ideeën, meestal door de kandidaat een SLO te laten definiëren voor een echte dienst en de bijbehorende alert te laten schrijven.
Een SLI is een meting: de verhouding tussen goede en geldige gebeurtenissen, zoals geslaagde requests gedeeld door alle requests. Een SLO is het interne doel voor die verhouding over een tijdvenster, bijvoorbeeld 99,9% over 30 dagen. Een SLA is de contractuele belofte aan klanten, met boetes, en ligt altijd lager dan de SLO.
De kernprincipes van site reliability engineering
Het Google SRE-boek benadert betrouwbaarheid als een feature met een prijskaartje. Elke extra negen kost engineeringtijd en vertraagt releases, terwijl gebruikers het verschil tussen 99,99% en 99,999% nauwelijks merken: hun eigen wifi, mobiele provider en apparaat zijn minder betrouwbaar dan dat. Het doel is daarom het juiste niveau van betrouwbaarheid, niet het hoogst haalbare.
Daaruit volgen een paar principes:
- Betrouwbaarheid wordt gemeten vanuit de gebruiker. CPU-gebruik en herstartende pods zijn oorzaken. Mislukte betalingen en trage pagina's zijn wat gebruikers ervaren, en dat is wat een SLI vastlegt.
- 100% is het verkeerde doel. Een SLO van 100% verbiedt elke wijziging, want elke deploy brengt risico mee. De ruimte onder de 100% is het error budget, en dat is bedoeld om uit te geven aan releases, experimenten en migraties.
- Toil krijgt een plafond. De richtlijn van Google in het hoofdstuk over het elimineren van toil houdt operationeel werk onder de 50% van de tijd van een SRE. Toil is handmatig, repetitief, automatiseerbaar en groeit lineair mee met de dienst. De rest van de tijd gaat naar engineering die dat werk overbodig maakt.
- Postmortems zijn blameless. Een incidentanalyse vraagt wat in het systeem de storing mogelijk maakte, niet wie het commando intypte. Een engineer die de schuld krijgt, houdt informatie achter; een review zonder schuldvraag brengt die juist boven water.
- Monitoring alarmeert op symptomen. Een page gaat af wanneer gebruikers last hebben of dat zo meteen krijgen, niet wanneer één node er vreemd uitziet.
In een sollicitatiegesprek onderscheidt vooral het tweede punt een ervaren SRE van iemand die alleen het boek heeft gelezen. Een junior antwoord ziet het error budget als foutmarge. Een senior antwoord beschrijft het als instrument voor releasemanagement: het mechanisme waarmee product en betrouwbaarheid op basis van data discussiëren in plaats van op basis van meningen.
SLI's kiezen die de gebruikerservaring weerspiegelen
Een goede SLI is een verhouding tussen 0 en 1, berekend uit gebeurtenissen die een gebruiker zou herkennen. Het SRE-workbook geeft per type dienst een korte keuzelijst:
| Type dienst | Gangbare SLI's | Meetpunt |
|---|---|---|
| Request-gedreven API | Beschikbaarheid, latency | Logs van load balancer of ingress, servermetrics |
| Datapipeline | Actualiteit, correctheid, dekking | Tijdstempels van de pipeline-output, validatiejobs |
| Opslagsysteem | Duurzaamheid, lees- en schrijflatency | Opslaglaag, synthetische probes |
| Frontend | Laadtijd, foutpercentage in de browser | Real user monitoring |
Meten bij de load balancer vangt storingen op die de applicatie zelf nooit ziet, zoals een gecrashte pod die helemaal niets terugstuurt. Meten in de browser brengt CDN- en DNS-problemen aan het licht, maar voegt ruis toe door slechte mobiele verbindingen. De meeste teams beginnen bij de load balancer of ingress, omdat de data daar al beschikbaar is.
Met Prometheus zijn de twee klassieke SLI's voor een HTTP-dienst een beschikbaarheidsratio en een latencyratio. De latency-SLI telt requests die sneller zijn dan een drempelwaarde als goed. Daardoor wordt het een verhouding zoals de andere, in plaats van een percentiel.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Twee details komen in gesprekken vaak terug. Ten eerste gelden 4xx-responses doorgaans als geldig en goed, omdat een 404 of een validatiefout de fout van de client is; tellen ze als storing, dan kan één slecht geconfigureerde client het hele budget opmaken. Ten tweede moet de latencydrempel overeenkomen met een bucketgrens van het histogram, anders levert de query niets op of gebruikt hij ongemerkt de verkeerde bucket. Prometheus 3.16, uitgebracht op 5 november 2026, ondersteunt native histogrammen, die de beperking van vaste buckets opheffen maar aan de scrape-kant moeten worden ingeschakeld.
SLO-doelen vastleggen en het error budget berekenen
Een SLO combineert een SLI, een doel en een tijdvenster. Het venster is meestal voortschrijdend, 28 of 30 dagen, zodat het budget geleidelijk herstelt in plaats van op de eerste van de maand in één keer te resetten. Het doel wordt gekozen op basis van historische prestaties en de verwachtingen van gebruikers, niet op basis van wat goed staat op een slide.
De onderstaande tabel laat zien wat elk doel toestaat over een venster van 30 dagen. Het gaat om eenvoudige rekenkunde: het budget is (1 - SLO) × 30 dagen.
| SLO-doel | Error budget | Toegestane volledige uitval in 30 dagen |
|---|---|---|
| 99% | 1% | 7 h 12 min |
| 99,5% | 0,5% | 3 h 36 min |
| 99,9% | 0,1% | 43 min 12 s |
| 99,95% | 0,05% | 21 min 36 s |
| 99,99% | 0,01% | 4 min 19 s |
Bij request-gebaseerde SLO's wordt het budget uitgedrukt in requests in plaats van minuten: bij 99,9% en 12 miljoen requests in het venster zijn 12.000 mislukte requests toegestaan. Dat is eerlijker voor diensten met wisselend verkeer, omdat een storing om 3 uur 's nachts minder budget kost dan dezelfde storing tijdens piekuren.
Een veelvoorkomende opdracht in gesprekken is het berekenen van het resterende budget en de snelheid waarmee het opraakt. Het onderstaande script is het soort antwoord dat wordt verwacht wanneer expliciet om code wordt gevraagd.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Een burn rate van 15 betekent dat 1,5% van de requests faalt, terwijl de SLO slechts 0,1% toestaat. In dat tempo is de resterende 35% van het budget binnen 17 uur verdwenen, en dat rechtvaardigt het om iemand wakker te maken.
Klaar om je DevOps gesprekken te halen?
Oefen met onze interactieve simulatoren, flashcards en technische tests.
Burn rate-alerting met meerdere vensters
Alarmeren rechtstreeks op de SLI ("foutpercentage boven 0,1%") levert pages op bij elke korte piek en mist langzame lekken. Het workbook-hoofdstuk over alerting op SLO's raadt daarom alerts aan met meerdere vensters en meerdere burn rates. Elke alert beantwoordt één vraag: raakt het budget zo snel op dat het verdwenen is voordat iemand ernaar kijkt?
De referentiewaarden voor een venster van 30 dagen zijn:
| Ernst | Lang venster | Kort venster | Burn rate | Verbruikt budget bij afgaan |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2% |
| Page | 6 h | 30 min | 6 | 5% |
| Ticket | 3 dagen | 6 h | 1 | 10% |
Het lange venster zorgt voor zeggingskracht: één slechte minuut leidt niet tot een page. Het korte venster, een twaalfde van het lange, laat de alert snel terugvallen zodra het incident voorbij is, zodat hij niet nog een uur na de fix blijft afgaan. Beide voorwaarden moeten tegelijk waar zijn.
Het eerste blok legt de foutratio per venster vast als recording rule, zodat de alertexpressies goedkoop blijven. Het tweede blok definieert de twee paging-alerts voor een SLO van 99,9%, waarbij de budgetfractie 0,001 is.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageDeze regels voor elke dienst met de hand schrijven wordt al snel eentonig. Sloth, een open source SLO-generator, maakt van een korte specificatie de recording rules en multi-burn rate-alerts hierboven. De placeholder {{.window}} wordt vervangen door elk venster dat Sloth nodig heeft.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
Teams die een leveranciersonafhankelijk formaat willen, kijken naar de OpenSLO-specificatie, die SLO's in YAML beschrijft, los van de monitoringbackend.
Error budget-beleid en releasebeslissingen
Een error budget zonder beleid is een dashboard waar niemand iets mee doet. Het voorbeeldbeleid in het SRE-workbook beschrijft wat er gebeurt wanneer het budget op is, en wie daar vooraf mee heeft ingestemd.
Een gangbaar beleid bevat:
- De trigger. De dienst heeft zijn error budget over het voortschrijdende venster overschreden.
- Het gevolg. Feature-releases stoppen, met uitzondering van beveiligingsfixes en wijzigingen die de betrouwbaarheid verbeteren, totdat de dienst weer binnen zijn SLO valt.
- De uitzonderingsroute. Eén incident veroorzaakt door een afhankelijkheid buiten de invloed van het team kan worden uitgesloten, mits de beslissing wordt vastgelegd.
- De escalatie. Bij onenigheid beslist een benoemde rol, zoals de CTO, en niet degene die het hardst roept.
Product en engineering ondertekenen het beleid vóór de eerste overschrijding, en daar zit precies de waarde: de releasestop wordt een vooraf afgesproken regel in plaats van een conflict midden in een incident. Interviewers vragen vaak wat er moet gebeuren wanneer het budget structureel onaangeroerd blijft. Het verwachte antwoord: de SLO is mogelijk te ruim, of het team released te voorzichtig, en het budget hoort te worden besteed aan snellere releases of gewaagdere migraties.
Wie de interne SLO gelijkstelt aan de SLA met de klant, houdt geen marge over: de eerste overschrijding van de SLO is meteen een contractuele boete. De SLO moet strenger zijn dan de SLA, zodat alerts afgaan en de releasestop ingaat terwijl het contract nog wordt nagekomen.
Toil terugdringen, on-call en blameless postmortems
De tijd van een SRE is verdeeld tussen operations en engineering. Operations omvat on-call, tickets en handmatige ingrepen; engineering omvat automatisering, capaciteitsplanning en betrouwbaarheidsfeatures. Groeit toil boven de richtlijn van 50%, dan geeft het SRE-team werk terug aan het ontwikkelteam of investeert het in automatisering. Anders wordt het een operationsteam met een nieuwe naam.
De gezondheid van on-call wordt gemeten, niet aangenomen. Bruikbare signalen zijn het aantal pages per dienst, het aandeel pages dat daadwerkelijk actie vereiste en de tijd tot bevestiging. Een page zonder benodigde actie is een bug in de alerting en wordt gerepareerd of verwijderd. Symptoomgerichte alerts op SLO-verbruik, zoals in de regels hierboven, verlagen het aantal pages flink ten opzichte van alerts op CPU, geheugen of herstarts van individuele pods.
Na een incident volgt de review die het hoofdstuk over postmortemcultuur van het SRE-boek beschrijft. Een postmortem legt de impact vast in SLO-termen (hoeveel budget er is verbruikt), de tijdlijn, de bijdragende factoren en de actiepunten met eigenaren en deadlines. Er wordt geen persoon als oorzaak aangewezen. Twee vervolgvragen komen vaak terug: hoe wordt gegarandeerd dat actiepunten echt worden uitgevoerd (ze in dezelfde backlog als features bijhouden en in een vast overleg bespreken) en wanneer is een postmortem verplicht (bij elk incident dat een flink deel van het budget kostte, bij elke page die iemand uit bed haalde, bij elk dataverlies)?
De vier golden signals uit het SRE-boek, namelijk latency, traffic, errors en saturation, maken het monitoringbeeld compleet. Latency en errors worden meestal SLI's. Traffic en saturation voeden eerder capaciteitsplanning en dashboards dan pages.
SRE-sollicitatievragen met verwachte antwoorden
Dit zijn de vragen die in gesprekken voor SRE- en senior DevOps-functies steeds terugkomen, met de kern van een sterk antwoord. De interviewmodule over SRE-principes oefent dezelfde onderwerpen, en de module over alerting en incident response behandelt de on-call-kant.
V: Wat is het verschil tussen een SLI, een SLO en een SLA?
De SLI is de gemeten verhouding, de SLO het interne doel daarvoor over een venster, de SLA het externe contract met boetes. De SLO is strenger dan de SLA, zodat het team reageert voordat er geld verloren gaat.
V: Waarom niet gewoon een SLO van 100%?
Omdat elke wijziging risico meebrengt, waardoor een doel van 100% releases verbiedt. Bovendien kunnen gebruikers geen betrouwbaarheid waarnemen die hoger ligt dan die van hun eigen netwerk. De ruimte onder de 100% is het error budget, en dat financiert releases.
V: Definieer een SLO voor een checkout-API.
Een sterk antwoord kiest twee SLI's (beschikbaarheid zonder 4xx, latency onder een drempel gemeten bij de load balancer), een voortschrijdend venster van 30 dagen en doelen gebaseerd op de data van het afgelopen kwartaal, en legt uit hoe alerting en error budget-beleid daaruit voortvloeien. Alleen "99,99% uptime" noemen zonder te zeggen wat er wordt gemeten, is het klassieke zwakke antwoord.
V: Waarom zijn alerts op p99-latency een slechte SLO-alert?
Een p99 over een kort venster is onrustig en laat zich niet over instanties heen aggregeren. Door latency uit te drukken als aandeel requests onder een drempel wordt die optelbaar, vergelijkbaar met de beschikbaarheids-SLI en geschikt voor burn rate-alerts.
V: Wat is de burn rate, en waarom gebruiken alerts twee vensters?
De burn rate is de waargenomen foutratio gedeeld door de budgetfractie; een waarde van 1 betekent dat het budget precies het hele venster meegaat. Het lange venster filtert korte pieken weg, het korte venster laat de alert na herstel snel verdwijnen.
V: Wat is toil, en hoe houdt een team het onder controle?
Handmatig, repetitief, automatiseerbaar werk zonder blijvende waarde dat meegroeit met de dienst. Het wordt gemeten, begrensd (Google hanteert 50%) en teruggedrongen door automatisering of door het werk terug te geven aan het verantwoordelijke team.
V: Wat maakt een postmortem blameless?
Het richt zich op de systeemomstandigheden die de storing mogelijk maakten, gaat ervan uit dat mensen redelijk handelden met de informatie die ze hadden, en levert actiepunten op die worden opgevolgd. De toets: zou de betrokken engineer elk detail delen zonder angst?
Na SLO-vragen volgen in hetzelfde gesprek vaak vragen over monitoring. De gids met Prometheus-sollicitatievragen behandelt PromQL, metrictypen en cardinaliteit, en de DevOps-technologiepagina toont alle modules voor een bredere voorbereiding.
SLO's en error budgets in de praktijk: de kern
- Definieer elke SLI als verhouding tussen goede en geldige gebeurtenissen, gemeten zo dicht bij de gebruiker als de data toelaat, en tel 4xx bij de meeste API's niet als storing
- Kies de SLO op basis van historische data en een voortschrijdend venster van 28 of 30 dagen, en houd hem strenger dan elke SLA met klanten
- Reken het doel om naar een budget in minuten of requests en ken de getallen uit het hoofd: 99,9% over 30 dagen is 43 minuten
- Alarmeer op burn rate met gekoppelde vensters (14,4 over 1 h en 5 min, 6 over 6 h en 30 min), niet op het ruwe foutpercentage of de CPU
- Genereer regels met Sloth of een vergelijkbare tool zodra meer dan een paar diensten SLO's hebben, zodat de drempels consistent blijven
- Schrijf en onderteken het error budget-beleid vóór de eerste overschrijding, inclusief de releasestop en de escalatieroute
- Volg toil, het aantal pages en postmortem-actiepunten met dezelfde discipline als features
Begin met oefenen!
Test je kennis met onze gespreksimulatoren en technische tests.
Zie jij de bug in DevOps?
Een echt codefragment, een verborgen bug, één poging per dag. Zonder account uit te proberen.

Geschreven door
Anthony Fillion-MailletOprichter van SharpSkill
Al meer dan 10 jaar fullstack-ontwikkelaar. Hij leidt SharpSkill en staat in voor alles wat hier verschijnt.
Bijgewerkt op 7 november 2026
Tags
Delen
Gerelateerde artikelen

Prometheus-sollicitatievragen 2026: Prometheus vs Grafana vs Datadog vergeleken
Prometheus-sollicitatievragen voor DevOps- en SRE-functies, met antwoorden over PromQL, metrictypes, cardinaliteit en hoge beschikbaarheid, plus een vergelijking van Prometheus, Grafana en Datadog op architectuur, alerting en prijs.
Ansible vs Terraform 2026: Infrastructure as Code en DevOps Sollicitatievragen
Uitgebreide vergelijking van Ansible en Terraform voor DevOps sollicitatiegesprekken. State management, declaratieve vs procedurele benaderingen en best practices voor Infrastructure as Code.
Terraform-sollicitatievragen: De complete gids voor Infrastructure as Code 2026
Uitgebreide gids over Terraform-sollicitatievragen met state management, moduleontwerp, CI/CD-pipelines en geavanceerde IaC-concepten voor 2026.