ETL vs ELT in 2026: Data Pipeline Architectuur en Technische Sollicitatievragen
ETL en ELT vertegenwoordigen twee fundamentele benaderingen van data pipeline architectuur. Deze vergelijking analyseert wanneer elk patroon te gebruiken, welke tools beschikbaar zijn en welke vragen Data Engineers tegenkomen in technische sollicitatiegesprekken.
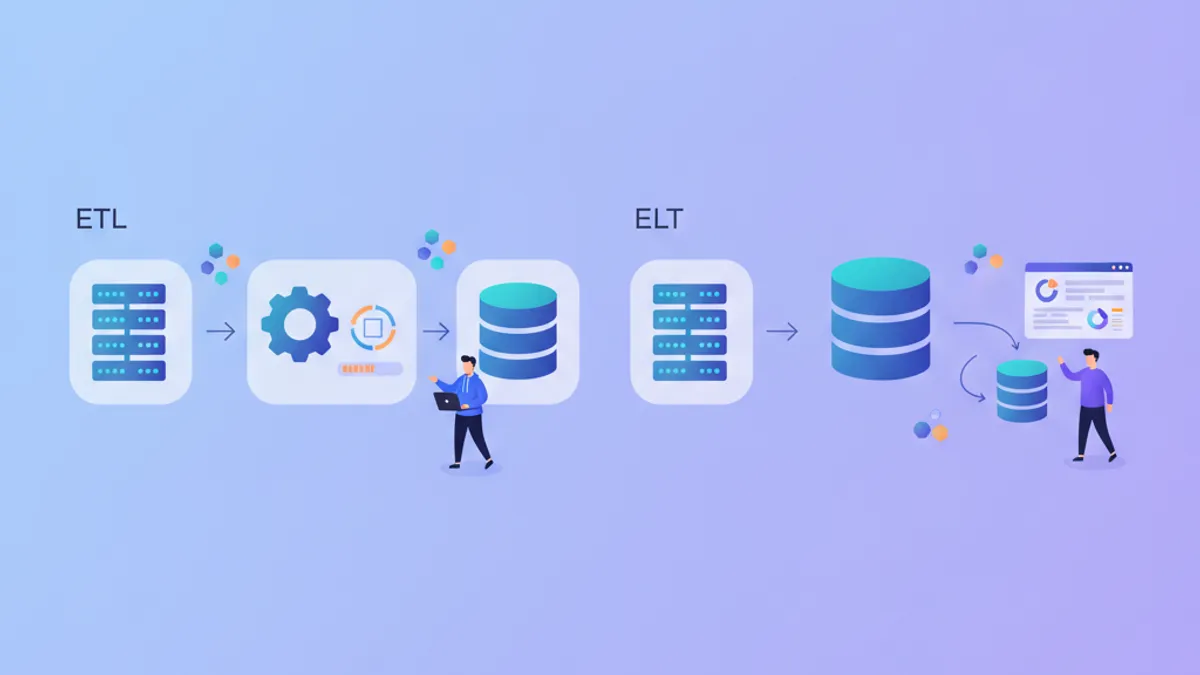
ETL vs ELT definieert hoe data van bronsystemen naar analyse-omgevingen verplaatst wordt. De keuze tussen Extract-Transform-Load (ETL) en Extract-Load-Transform (ELT) beïnvloedt infrastructuurkosten, data-versheid en de vereiste vaardigheden van engineering teams.
ETL transformeert data voordat het in het doelsysteem wordt geladen, wat dedicated rekenkracht vereist. ELT laadt eerst ruwe data en transformeert deze vervolgens met de verwerkingskracht van het bestemmingswarehouse. De meeste cloud-native data stacks in 2026 geven de voorkeur aan ELT omdat rekencapaciteit op aanvraag schaalt.
ETL Architectuur: Transformatie voor het Laden
ETL ontstond toen data warehouses beperkte rekencapaciteit hadden en opslag duur was. Het patroon was logisch: data filteren en aggregeren buiten het warehouse, alleen laden wat voor analyse nodig was. Oracle Warehouse Builder, Informatica PowerCenter en Talend bouwden tooling rond dit model.
De transformatiefase in ETL draait op tussenliggende servers. Data verplaatst zich van bron naar een staging-gebied, wordt opgeschoond en hervormd, dan in de bestemming geladen. Deze aanpak vermindert de warehouse-belasting maar creëert een bottleneck op de transformatielaag.
# etl_pipeline.py
# Traditional ETL pattern with intermediate transformation

import pandas as pd
from sqlalchemy import create_engine

def extract_from_source(connection_string: str, query: str) -> pd.DataFrame:
    """Pull data from source database."""
    engine = create_engine(connection_string)
    return pd.read_sql(query, engine)

def transform_data(df: pd.DataFrame) -> pd.DataFrame:
    """Clean and reshape data before loading.

    This runs on the ETL server, not the warehouse.
    """
    # Remove duplicates based on business key
    df = df.drop_duplicates(subset=['customer_id', 'order_date'])

    # Convert date strings to proper datetime
    df['order_date'] = pd.to_datetime(df['order_date'])

    # Calculate derived metrics
    df['order_total'] = df['quantity'] * df['unit_price']
    df['order_month'] = df['order_date'].dt.to_period('M')

    # Filter to relevant records only
    df = df[df['order_status'] != 'cancelled']

    return df

def load_to_warehouse(df: pd.DataFrame, warehouse_conn: str, table: str):
    """Load transformed data to destination."""
    engine = create_engine(warehouse_conn)
    df.to_sql(table, engine, if_exists='append', index=False)

# Pipeline execution
raw_orders = extract_from_source(SOURCE_CONN, "SELECT * FROM orders")
clean_orders = transform_data(raw_orders)
load_to_warehouse(clean_orders, WAREHOUSE_CONN, 'fact_orders')
ETL werkt goed wanneer transformatielogica stabiel blijft en datavolumes voorspelbaar zijn. Het nadeel manifesteert zich wanneer vereisten veranderen: modificaties aan transformaties vereisen herverwerking van historische data vanaf nul.
ELT Architectuur: Eerst Laden, Dan Transformeren in het Warehouse
ELT verplaatst transformatie naar het data warehouse. Snowflake, BigQuery, Databricks en Redshift bieden vrijwel onbeperkte rekencapaciteit die schaalt met query-complexiteit. Eerst ruwe data laden bewaart de bronstatus; transformaties worden SQL-modellen die geversioneerd en opnieuw uitgevoerd kunnen worden zonder her-extractie.
Het dbt-project (data build tool) populariseerde ELT door SQL-transformaties als code te behandelen. In plaats van black-box ETL-jobs leven transformaties in version control als SELECT-statements die ruwe tabellen refereren en afgeleide modellen bouwen.
-- models/staging/stg_orders.sql
-- dbt model: first transformation layer on raw data

with source as (
    -- Reference the raw table loaded by the extraction tool
    select * from {{ source('salesforce', 'orders') }}
),

renamed as (
    select
        id as order_id,
        customer_id,
        cast(order_date as date) as order_date,
        quantity,
        unit_price,
        order_status,
        -- Calculate derived fields in SQL
        quantity * unit_price as order_total,
        date_trunc('month', cast(order_date as date)) as order_month
    from source
    where order_status != 'cancelled'
)

select * from renamed-- models/marts/fct_monthly_revenue.sql
-- Aggregated fact table built from staging model
with orders as (
select * from {{ ref('stg_orders') }}
),
monthly_agg as (
select
order_month,
count(distinct customer_id) as unique_customers,
count(order_id) as total_orders,
sum(order_total) as revenue
from orders
group by order_month
)
select * from monthly_aggELT bewaart ruwe data, wat herverwerking mogelijk maakt wanneer businesslogica verandert. Als een berekening zes maanden geleden fout was, corrigeert het repareren van het dbt-model en een volledige refresh de historische data. Bij ETL vereist dezelfde correctie her-extractie uit bronnen die mogelijk de originele records niet meer hebben.
Vergelijkingstabel: ETL vs ELT Trade-offs
| Factor | ETL | ELT |
|---|---|---|
| Locatie rekenkracht | Dedicated transformatieserver | Bestemmingswarehouse |
| Bewaring ruwe data | Vaak weggegooid na transformatie | Bewaard in landing zone |
| Herverwerkingskosten | Her-extractie uit bron | SQL-modellen opnieuw uitvoeren |
| Schema-flexibiliteit | Vastgelegd tijdens transformatie | Schema-on-read mogelijk |
| Tooling-voorbeelden | Informatica, Talend, SSIS | dbt, Dataform, SQLMesh |
| Optimaal voor | Stabiele vereisten, legacy-systemen | Veranderende vereisten, cloud warehouses |
| Latentie | Hoger (transform voor load) | Lager (load dan transform) |
| Data governance | Eenvoudiger (data gefilterd voor warehouse) | Vereist warehouse-level controles |
Klaar om je Data Engineering gesprekken te halen?
Oefen met onze interactieve simulatoren, flashcards en technische tests.
Hybride Benaderingen: Wanneer ETL en ELT Combineren
Moderne data stacks gebruiken zelden puur ETL of ELT. Apache Airflow orkestreert pipelines die beide patronen combineren. Gevoelige data kan worden geanonimiseerd voor het laden (een ETL-stap), terwijl aggregaties in het warehouse draaien (ELT).
Fivetran en Airbyte extraheren en laden ruwe data zonder transformatie, vervolgens transformeert dbt binnen het warehouse. Maar deze tools ondersteunen ook lichtgewicht transformaties tijdens extractie: kolomselectie, datatype-conversie, hashing van PII-velden. Dit vervaagt de ETL/ELT-grens.
# airflow/dags/hybrid_pipeline.py
# DAG combining extraction, lightweight ETL, and warehouse ELT

from airflow import DAG
from airflow.providers.airbyte.operators.airbyte import AirbyteTriggerSyncOperator
from airflow.providers.dbt.cloud.operators.dbt import DbtCloudRunJobOperator
from datetime import datetime

with DAG(
    dag_id='hybrid_etl_elt_pipeline',
    start_date=datetime(2026, 1, 1),
    schedule='@daily',
    catchup=False
) as dag:

    # Step 1: Extract and load with Airbyte
    # Minor transforms happen here: type casting, PII hashing
    sync_salesforce = AirbyteTriggerSyncOperator(
        task_id='sync_salesforce_orders',
        airbyte_conn_id='airbyte_default',
        connection_id='salesforce-to-snowflake',
        asynchronous=False
    )

    # Step 2: Transform in warehouse with dbt
    # Heavy aggregations, joins, business logic
    run_dbt_models = DbtCloudRunJobOperator(
        task_id='run_dbt_transformations',
        dbt_cloud_conn_id='dbt_cloud',
        job_id=12345,
        wait_for_termination=True
    )

    sync_salesforce >> run_dbt_models
De bovenstaande pipeline extraheert uit Salesforce met Airbyte (dat e-mailadressen kan hashen tijdens synchronisatie), laadt naar Snowflake, voert vervolgens dbt-modellen uit voor business-transformaties. Noch puur ETL noch puur ELT, maar praktisch.
Sollicitatievragen: ETL vs ELT voor Data Engineers
Technische sollicitatiegesprekken voor data engineering-rollen bij bedrijven die moderne data stacks gebruiken toetsen het begrip van pipeline-architectuur. Deze vragen komen vaak voor, gebaseerd op patronen uit ETL/ELT-sollicitatievoorbereiding modules.
Vraag 1: Wanneer Zou Men ETL Verkiezen Boven ELT?
Sterke antwoorden identificeren specifieke scenario's:
- Compliance-vereisten: AVG of HIPAA schrijven voor dat bepaalde data nooit in ruwe vorm het warehouse bereikt. PII moet worden geanonimiseerd of verwijderd voor het laden.
- Legacy-warehouse beperkingen: On-premises systemen zoals Teradata of oudere Redshift-configuraties met vaste rekencapaciteit profiteren van voorgeaggregeerde ladingen.
- Netwerkkosten: Dagelijks 10TB laden naar een cloud-warehouse en vervolgens 90% weggooien na transformatie verspilt egress-bandbreedte. Voorfilteren is economisch zinvol.
Zwakke antwoorden zeggen "ETL is verouderd" of geven geen concrete scenario's. Interviewers zoeken naar nuances.
Vraag 2: Hoe Worden Schemawijzigingen Behandeld in een ELT Pipeline?
Dit test het begrip van ruwe data landing zones. Verwachte onderwerpen:
- JSON of semi-gestructureerde kolommen die nieuwe velden absorberen zonder schemamigratie
- Staging-modellen die expliciet kolommen selecteren, downstream-modellen isoleren van bronwijzigingen
- dbt-macros of Dataform-assertions die builds laten falen wanneer verwachte kolommen verdwijnen
- Monitoring voor schema drift met tools zoals Monte Carlo of Great Expectations
-- Schema evolution handling in dbt
-- Use VARIANT/JSON columns to absorb unknown fields

with raw_events as (
    select
        event_id,
        event_payload,  -- JSON column from source
        received_at
    from {{ source('app', 'raw_events') }}
),

parsed as (
    select
        event_id,
        event_payload:user_id::string as user_id,
        event_payload:event_type::string as event_type,
        -- New fields appear in JSON without breaking the model
        event_payload:metadata::variant as metadata,
        received_at
    from raw_events
)

select * from parsed
Vraag 3: Vergelijk Orkestratie van ETL met Airflow en het Uitvoeren van dbt voor ELT
Deze vraag toetst het begrip dat deze tools verschillende problemen oplossen:
- Airflow orkestreert taken: extractie, API-calls, bestandsoverdrachten, modeltraining. Het beheert afhankelijkheden tussen heterogene jobs.
- dbt transformeert data binnen een warehouse. Het beheert afhankelijkheden tussen SQL-modellen, voert tests uit, genereert documentatie.
Een complete pipeline gebruikt vaak beide: Airflow triggert Airbyte-syncs, wacht op voltooiing, triggert dan dbt-runs. Weten wanneer welke tool te gebruiken onderscheidt senior kandidaten.
Vraag 4: De ELT Pipeline Verwerkt Dagelijks 500M Rijen en Analisten Melden Trage Queries
Deze open vraag test diagnostisch denken:
- Controleer model-materialisatie: Zijn zware modellen nog steeds views? Incrementele modellen of tabellen kunnen helpen.
- Partitionering en clustering: Voor BigQuery, zijn fact-tabellen gepartitioneerd op datum? Voor Snowflake, is clustering geoptimaliseerd voor veelvoorkomende querypatronen?
- Query pushdown: Bevragen analisten staging-modellen in plaats van voorgeaggregeerde marts?
- Warehouse-sizing: Is de rekencapaciteit passend geschaald tijdens query-uren?
- Freshness-vereisten: Kan transformatie 's nachts draaien in plaats van tijdens kantooruren?
Er is geen enkel juist antwoord. Interviewers evalueren systematische troubleshooting.
Tooling Landschap in 2026
De data-integratiemarkt heeft zich geconsolideerd rond enkele patronen:
Extractie en laden: Fivetran, Airbyte, Stitch en Meltano behandelen het EL-gedeelte. Deze tools verbinden met honderden bronnen en synchroniseren naar cloud warehouses zonder custom code.
Transformatie: dbt domineert SQL-gebaseerde transformatie. Alternatieven zijn Dataform (nu onderdeel van Google Cloud), SQLMesh (open source met virtuele data-omgevingen) en Coalesce (visuele modellering).
Orkestratie: Airflow blijft de standaard voor complexe pipelines. Dagster en Prefect bieden alternatieven met betere lokale ontwikkeling en asset-centrische views.
Kwaliteit: Great Expectations, dbt-tests, Monte Carlo en Soda bieden data quality monitoring. Deze detecteren problemen tussen extractie en downstream-consumptie.
# great_expectations checkpoint for ELT quality gates
# Runs after dbt completes, before downstream dashboards refresh

import great_expectations as gx

context = gx.get_context()

checkpoint = context.checkpoints.get("daily_orders_checkpoint")

result = checkpoint.run(
    batch_parameters={"year": 2026, "month": 9},
    expectation_suite_name="orders_suite"
)

if not result.success:
    # Block downstream refresh, alert data team
    raise ValueError(f"Data quality check failed: {result.describe()}")
Begin met oefenen!
Test je kennis met onze gespreksimulatoren en technische tests.
Pipeline Architectuur Selecteren voor Nieuwe Projecten
Voor de meeste greenfield-projecten in 2026 is ELT de standaard. Cloud warehouse compute kost minder dan het onderhouden van transformatieservers. Bewaring van ruwe data maakt retroactieve correcties mogelijk. SQL-gebaseerde transformaties zijn auditeerbaar en version-controlled.
ETL blijft relevant voor:
- Gereguleerde omgevingen die dataminimalisatie vereisen voor warehouse-entry
- Real-time streaming waar transformatie tijdens ingestie moet plaatsvinden (Kafka Streams, Flink)
- Edge computing-scenario's met beperkte downstream opslag
- Legacy-integraties waar het bronsysteem het exportformaat bepaalt
Het sollicitatie-klare antwoord erkent beide patronen en legt de trade-offs uit zonder ideologische voorkeur.
Kernpunten voor Data Pipeline Architectuur
- ETL transformeert data voor het laden, vermindert warehouse-belasting maar creëert herverwerkingsfrictie wanneer logica verandert
- ELT laadt eerst ruwe data, maakt SQL-gebaseerde transformaties mogelijk die geversioneerd, getest en opnieuw uitgevoerd kunnen worden tegen historische data
- Moderne stacks combineren typisch beide: lichtgewicht extractie-transformaties (PII-hashing, type-casting) met warehouse-gebaseerde aggregatie
- dbt is de standaard geworden voor ELT-transformatie, behandelt SQL-modellen als testbare, gedocumenteerde code
- Sollicitatievragen toetsen scenario-selectie, schema-evolutie-afhandeling en tooling trade-offs in plaats van uit het hoofd geleerde definities
- Bewaring van ruwe data in ELT-pipelines maakt correcties aan historische berekeningen mogelijk zonder her-extractie uit bronnen
Zie jij de bug in Data Engineering?
Een echt codefragment, een verborgen bug, één poging per dag. Zonder account uit te proberen.

Geschreven door
Anthony Fillion-MailletOprichter van SharpSkill
Al meer dan 10 jaar fullstack-ontwikkelaar. Hij leidt SharpSkill en staat in voor alles wat hier verschijnt.
Bijgewerkt op 14 september 2026
Tags
Delen
Gerelateerde artikelen
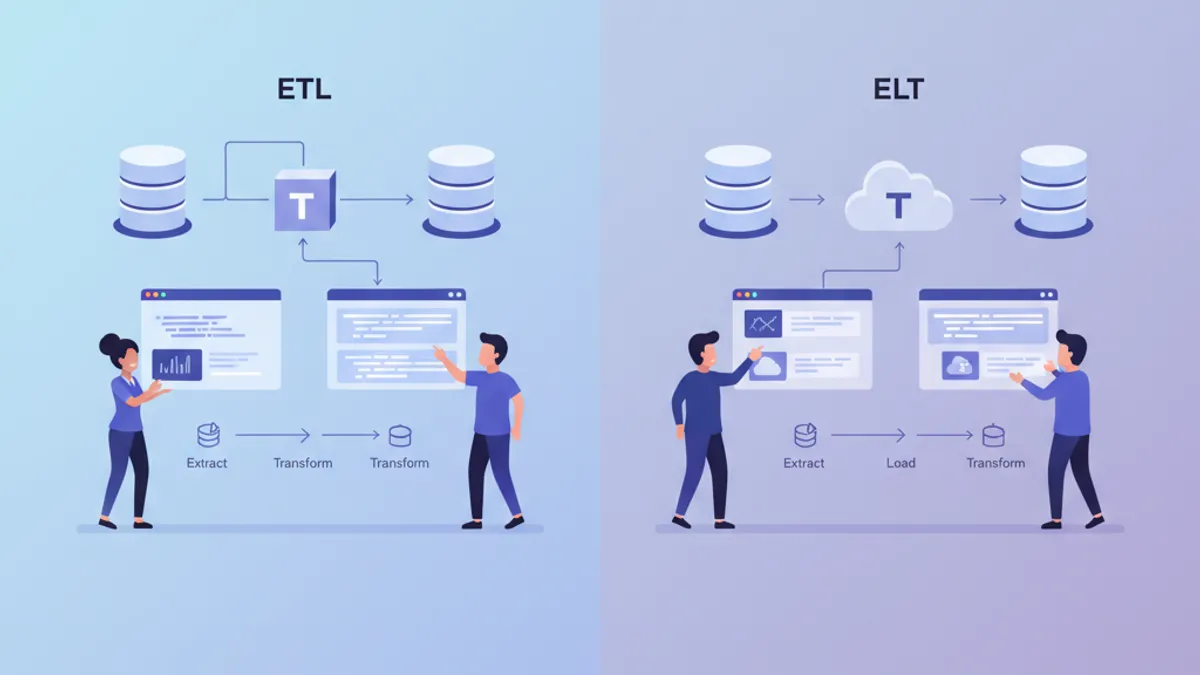
ETL vs ELT in 2026: Architectuur van datapipelines uitgelegd
ETL vs ELT vergelijking voor moderne datapipelines. Architectuurverschillen, prestatie-afwegingen en wanneer welke aanpak te gebruiken met Snowflake, BigQuery en dbt in 2026.

Apache Spark 4.2 vs Databricks in 2026: Architectuur, Prestaties en Sollicitatievragen
Vergelijking van Apache Spark 4.2 en Databricks in 2026. Architectuurverschillen, prestatiekenmerken en veelgestelde sollicitatievragen voor data engineering functies.
Apache Airflow in 2026: Pipeline Orchestratie, DAGs en Sollicitatievragen
Leer Apache Airflow 3.2 beheersen met de Task SDK, dynamische task mapping, asset partities en native async ondersteuning. Inclusief vergelijking met Prefect en Dagster, productietips en veelgestelde sollicitatievragen.