Creare un blog in C# nel 2026: blogging tecnico con ASP.NET Core e Minimal APIs
Un blog in C# su .NET 10 con le Minimal APIs di ASP.NET Core: articoli Markdown con front matter, store thread-safe con ricaricamento a caldo, componenti Razor, output caching e feed RSS.
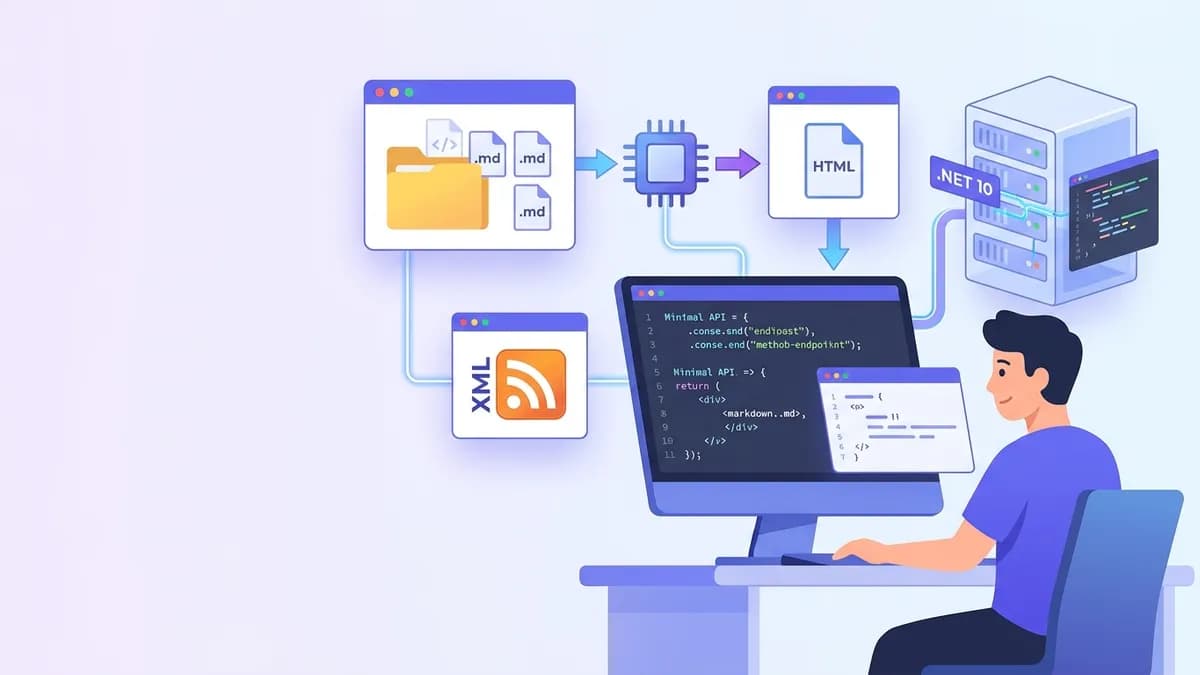
Un blog in C# costruito con le Minimal APIs di ASP.NET Core sta in pochi file: articoli in Markdown su disco, uno store singleton che li analizza una sola volta, qualche endpoint che restituisce HTML e un feed RSS. Con .NET 10, la versione a supporto esteso (LTS) rilasciata a novembre 2025, quasi tutti i componenti fanno già parte del framework e il resto arriva da tre pacchetti NuGet ben mantenuti. Non servono né un CMS né un database.
Un progetto web .NET 10 vuoto, Markdig per convertire il Markdown in HTML, YamlDotNet per il front matter, uno store in memoria immutabile ricaricato a ogni modifica dei file, endpoint Minimal API che restituiscono pagine RazorComponentResult, output caching con invalidazione per tag e un feed RSS 2.0 generato da System.ServiceModel.Syndication. L'intero motore resta sotto le 300 righe di C#.
Perché un motore di blog con Minimal APIs e non un generatore di siti statici
I generatori di siti statici come Hugo o Jekyll producono file HTML in fase di build. Sono veloci ed economici da ospitare, ma qualsiasi comportamento che vada oltre i template (articoli programmati, un'API JSON per un'app mobile, feed per singolo tag, integrazioni di analytics) finisce in un plugin scritto in un linguaggio che lo sviluppatore .NET non usa tutti i giorni.
Un blog ASP.NET Core conserva i contenuti come semplici file Markdown nel repository Git, li renderizza alla prima richiesta e serve poi il risultato dalla memoria. Con l'output caching davanti, il costo di ogni richiesta si avvicina a quello di un file statico, e il codice eseguito è C# ordinario: si può fare debug, testarlo ed estenderlo. È inoltre un progetto compatto che mette in gioco dependency injection, pipeline delle richieste, caching e concorrenza, cioè proprio gli argomenti di un colloquio tecnico su .NET.
| Aspetto | Generatore di siti statici | Blog con ASP.NET Core Minimal APIs |
|---|---|---|
| Formato dei contenuti | Markdown + front matter | Markdown + front matter |
| Momento del rendering | In fase di build | Alla prima richiesta, poi in cache |
| Logica personalizzata | Plugin, template | Endpoint in C# standard |
| Hosting | Qualsiasi host statico o CDN | Container, App Service, qualsiasi VPS |
| Aggiornamento a caldo | Nuova build e nuovo deploy | Un file watcher ricarica lo store |
Creare il progetto del blog ASP.NET Core su .NET 10
Il punto di partenza è il template web vuoto. dotnet new web crea un progetto basato sull'SDK Microsoft.NET.Sdk.Web, che compila i componenti .razor senza configurazione aggiuntiva. Tre pacchetti coprono il resto: Markdig per il parsing CommonMark, YamlDotNet per il front matter e System.ServiceModel.Syndication per il feed.
# terminal
dotnet new web -n CSharpBlog --framework net10.0
cd CSharpBlog
dotnet add package Markdig
dotnet add package YamlDotNet
dotnet add package System.ServiceModel.Syndication
mkdir posts Posts Endpoints Components
Program.cs collega tutti i pezzi. Lo store degli articoli è registrato come singleton perché gli articoli analizzati sono condivisi da tutte le richieste, mentre l'output caching si trova nella pipeline prima degli endpoint, così le risposte in cache non eseguono affatto l'handler.
var builder = WebApplication.CreateBuilder(args);

// Site settings bound from the "Blog" section of appsettings.json
builder.Services.Configure<BlogOptions>(builder.Configuration.GetSection("Blog"));

builder.Services.AddSingleton<PostStore>();   // one parsed snapshot shared by all requests
builder.Services.AddRazorComponents();        // enables RazorComponentResult rendering
builder.Services.AddOpenApi();                // OpenAPI 3.1 document for the JSON API
builder.Services.AddOutputCache(options =>
    options.AddBasePolicy(policy => policy.Expire(TimeSpan.FromHours(1))));

var app = builder.Build();

app.MapStaticAssets();   // CSS and images from wwwroot, fingerprinted since .NET 9
app.UseOutputCache();    // must run before the endpoints it caches
app.MapOpenApi();

app.MapBlogEndpoints();
app.MapFeedEndpoints();

app.Run();

public sealed class BlogOptions
{
    public string Title { get; set; } = "C# Notes";
    public string SiteUrl { get; set; } = "https://localhost:5001/";
}
L'impostazione SiteUrl diventa importante più avanti: i link canonici e gli indirizzi del feed vengono costruiti a partire dalla configurazione, mai dall'header Host della richiesta in arrivo.
Analizzare articoli Markdown con front matter in C#
Ogni articolo è un file come posts/output-caching-dotnet-10.md. Il nome del file diventa lo slug, mentre un blocco YAML in testa contiene i metadati:
---
title: Output caching in .NET 10
summary: How tag-based eviction keeps cached pages fresh.
date: 2026-11-10
tags: [aspnet-core, performance]
draft: false
---
Output caching stores the full response on the server...
Il parser separa il blocco YAML dal corpo, deserializza i metadati in una piccola classe e converte il corpo in HTML. Le terminazioni di riga vengono normalizzate per prime: in caso contrario, un articolo salvato su Windows rompe la ricerca del delimitatore ---.
using Markdig;
using YamlDotNet.Serialization;
using YamlDotNet.Serialization.NamingConventions;

public sealed record Post(string Slug, string Title, string Summary,
    DateTime PublishedOn, IReadOnlyList<string> Tags, bool Draft, string Html);

public static class PostParser
{
    // Built once and reused by every reload
    private static readonly MarkdownPipeline Pipeline =
        new MarkdownPipelineBuilder().UseAdvancedExtensions().Build();

    private static readonly IDeserializer Yaml = new DeserializerBuilder()
        .WithNamingConvention(CamelCaseNamingConvention.Instance)
        .IgnoreUnmatchedProperties()   // unknown keys do not crash the reload
        .Build();

    public static Post Parse(string slug, string text)
    {
        text = text.ReplaceLineEndings("\n");
        if (!text.StartsWith("---\n"))
            throw new FormatException($"{slug}: missing front matter");

        var end = text.IndexOf("\n---", 4, StringComparison.Ordinal);
        if (end < 0)
            throw new FormatException($"{slug}: unterminated front matter");

        var meta = Yaml.Deserialize<FrontMatter>(text[4..end]);
        var html = Markdown.ToHtml(text[(end + 4)..], Pipeline);

        return new Post(slug, meta.Title, meta.Summary, meta.Date, meta.Tags, meta.Draft, html);
    }

    private sealed class FrontMatter
    {
        public string Title { get; set; } = "";
        public string Summary { get; set; } = "";
        public DateTime Date { get; set; }
        public List<string> Tags { get; set; } = [];
        public bool Draft { get; set; }
    }
}
UseAdvancedExtensions() attiva tabelle, note a piè di pagina, liste di attività, identificatori automatici sui titoli e le altre estensioni di Markdig utili a un blog tecnico. Per impostazione predefinita Markdig lascia passare l'HTML grezzo. È accettabile per articoli scritti dal proprietario del sito, ma qualsiasi Markdown fornito dagli utenti (commenti, articoli ospiti) richiede DisableHtml() sulla propria pipeline per evitare un XSS persistente.
Uno store singleton thread-safe con ricaricamento a caldo
All'avvio lo store legge tutti i file e conserva il risultato in un FrozenDictionary (disponibile da .NET 8), ottimizzato per letture frequenti. Quando un file cambia, lo store costruisce un dizionario completamente nuovo e sostituisce il riferimento con una sola assegnazione. I lettori non acquisiscono mai un lock: ogni richiesta vede la vecchia istantanea oppure la nuova, mai una collezione costruita a metà.
using System.Collections.Frozen;
using Microsoft.AspNetCore.OutputCaching;
using Microsoft.Extensions.FileProviders;
using Microsoft.Extensions.Primitives;

public sealed class PostStore
{
    private readonly PhysicalFileProvider _files;
    private readonly IOutputCacheStore _cache;
    private readonly ILogger<PostStore> _logger;
    private volatile FrozenDictionary<string, Post> _bySlug = FrozenDictionary<string, Post>.Empty;

    public PostStore(IWebHostEnvironment env, IOutputCacheStore cache, ILogger<PostStore> logger)
    {
        (_cache, _logger) = (cache, logger);
        _files = new PhysicalFileProvider(Path.Combine(env.ContentRootPath, "posts"));
        Reload();
        ChangeToken.OnChange(() => _files.Watch("*.md"), Reload);   // re-registers after each change
    }

    public Post? Find(string slug) => _bySlug.TryGetValue(slug, out var post) ? post : null;

    public IReadOnlyList<Post> Latest(int count) =>
        _bySlug.Values.OrderByDescending(p => p.PublishedOn).Take(count).ToList();

    private void Reload()
    {
        try
        {
            var snapshot = _files.GetDirectoryContents("")
                .Where(f => !f.IsDirectory && f.Name.EndsWith(".md", StringComparison.Ordinal))
                .Select(f => PostParser.Parse(Path.GetFileNameWithoutExtension(f.Name), File.ReadAllText(f.PhysicalPath!)))
                .Where(p => !p.Draft)
                .ToFrozenDictionary(p => p.Slug);

            _bySlug = snapshot;   // atomic reference swap
            _ = _cache.EvictByTagAsync("posts", CancellationToken.None).AsTask();
            _logger.LogInformation("Loaded {Count} posts", snapshot.Count);
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "Reload failed, keeping the previous snapshot");   // a typo never takes the site down
        }
    }
}
Tre dettagli rendono questo codice adatto alla produzione. Il campo volatile garantisce che gli altri thread leggano il riferimento più recente dopo lo scambio. Il blocco try/catch mantiene l'ultima istantanea valida quando un articolo contiene YAML non valido, così un errore di battitura in un solo file non svuota il blog. Infine, la chiamata a EvictByTagAsync elimina tutte le pagine in cache con il tag posts, e il nuovo contenuto compare già alla richiesta successiva invece che allo scadere dell'ora.
FileSystemWatcher si basa sulle notifiche del sistema operativo, che non attraversano in modo affidabile i bind mount di Docker o le condivisioni di rete. In un container che monta la cartella posts conviene impostare la variabile d'ambiente DOTNET_USE_POLLING_FILE_WATCHER=true oppure PhysicalFileProvider.UsePollingFileWatcher = true. Molti editor salvano inoltre un file in più scritture, quindi Reload può scattare due o tre volte per ogni salvataggio: qui è innocuo, perché ogni esecuzione produce la stessa istantanea.
Endpoint Minimal API con route group e TypedResults
Le pagine pubbliche sono raggruppate sotto /blog con MapGroup, che applica la policy di output cache e il relativo tag a tutti gli endpoint in un unico punto. Gli handler restituiscono RazorComponentResult<T>, disponibile da .NET 8, che renderizza un componente Razor come risposta HTTP completa senza MVC, Razor Pages né router Blazor.
using CSharpBlog.Components;   // namespace of PostPage and PostListPage
using Microsoft.AspNetCore.Http.HttpResults;

public static class BlogEndpoints
{
    public static IEndpointRouteBuilder MapBlogEndpoints(this IEndpointRouteBuilder app)
    {
        var blog = app.MapGroup("/blog").CacheOutput(p => p.Tag("posts"));

        blog.MapGet("/", (PostStore store) =>
            new RazorComponentResult<PostListPage>(new { Posts = store.Latest(20) }));

        blog.MapGet("/{slug:regex(^[a-z0-9-]+$)}", GetPost);   // rejects odd slugs before the handler

        app.MapGet("/api/posts", (PostStore store) =>
                TypedResults.Ok(store.Latest(50).Select(p => new PostSummary(p.Slug, p.Title, p.Summary, p.PublishedOn))))
            .CacheOutput(p => p.Tag("posts"))
            .WithName("ListPosts");

        return app;
    }

    // The union return type documents both outcomes for OpenAPI and for unit tests
    private static Results<RazorComponentResult<PostPage>, NotFound> GetPost(string slug, PostStore store) =>
        store.Find(slug) is { } post
            ? new RazorComponentResult<PostPage>(new { Post = post })
            : TypedResults.NotFound();
}

public sealed record PostSummary(string Slug, string Title, string Summary, DateTime PublishedOn);
Il tipo di ritorno Results<T1, T2> è ciò che distingue TypedResults dai vecchi helper Results. Il compilatore verifica che l'handler restituisca solo gli esiti dichiarati, il generatore OpenAPI legge entrambi i codici di stato dalla firma e un test unitario può verificare result.Result is NotFound senza avviare un server. L'endpoint JSON resta fuori dal gruppo /blog, così il suo URL non entra in conflitto con gli slug degli articoli.
La pagina dell'articolo è un normale componente Razor. MarkupString indica a Razor di emettere l'output di Markdig come HTML invece di codificarlo, e l'URL canonico proviene da BlogOptions.
@* Components/PostPage.razor *@
@using Microsoft.Extensions.Options
@inject IOptions<BlogOptions> Options

<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="utf-8" />
    <title>@Post.Title | @Options.Value.Title</title>
    <meta name="description" content="@Post.Summary" />
    <link rel="canonical" href="@(new Uri(new Uri(Options.Value.SiteUrl), $"blog/{Post.Slug}"))" />
    <link rel="alternate" type="application/rss+xml" title="@Options.Value.Title" href="/feed.xml" />
    <link rel="stylesheet" href="/site.css" />
</head>
<body>
    <article>
        <h1>@Post.Title</h1>
        <time datetime="@(Post.PublishedOn.ToString("yyyy-MM-dd"))">@(Post.PublishedOn.ToString("d MMMM yyyy"))</time>
        @((MarkupString)Post.Html)
    </article>
</body>
</html>

@code {
    [Parameter, EditorRequired] public Post Post { get; set; } = default!;
}
PostListPage.razor segue lo stesso schema, con un parametro Posts e un ciclo su titoli e riassunti. L'oggetto anonimo passato a RazorComponentResult associa i nomi delle proprie proprietà ai parametri del componente: new { Post = post } deve quindi corrispondere esattamente al parametro Post, altrimenti l'errore emerge solo a runtime.
Pronto a superare i tuoi colloqui su .NET?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Output caching per le pagine del blog ASP.NET Core
L'output caching, introdotto in ASP.NET Core 7, memorizza sul server la risposta completa e la riproduce senza eseguire l'handler né renderizzare di nuovo il componente. Si distingue dal vecchio middleware di response caching, che segue la semantica HTTP di Cache-Control e consente al client di aggirare la cache con un header no-cache. La documentazione sull'output caching su Microsoft Learn descrive le regole predefinite: vengono messe in cache solo le richieste GET e HEAD con stato 200, mentre le risposte che impostano cookie o provengono da richieste autenticate sono escluse.
Sono i tag a rendere l'output caching adatto a un sito di contenuti. Ogni endpoint del blog porta il tag posts e lo store invalida quel tag dopo ogni ricaricamento. La policy di base di un'ora è solo una rete di sicurezza: nella pratica le pagine restano in cache finché il contenuto non cambia.
In un deploy su più istanze, lo store in memoria è per processo: un'invalidazione su un'istanza lascia le altre con pagine obsolete. ASP.NET Core offre uno store basato su Redis tramite il pacchetto Microsoft.AspNetCore.OutputCaching.StackExchangeRedis e AddStackExchangeRedisOutputCache, che condivide voci in cache e invalidazioni tra le istanze. Una singola istanza di piccole dimensioni non ne ha bisogno.
Generare un feed RSS in C# con SyndicationFeed
Il pubblico tecnico continua a seguire i blog tramite lettori di feed, e gli aggregatori scoprono i nuovi articoli dal feed più che dalla sitemap. SyndicationFeed e Rss20FeedFormatter producono un feed conforme alla specifica RSS 2.0 senza scrivere XML a mano.
using System.ServiceModel.Syndication;
using System.Text;
using System.Xml;
using Microsoft.Extensions.Options;

public static class FeedEndpoints
{
    public static IEndpointRouteBuilder MapFeedEndpoints(this IEndpointRouteBuilder app)
    {
        app.MapGet("/feed.xml", (PostStore store, IOptions<BlogOptions> options) =>
        {
            var site = new Uri(options.Value.SiteUrl);   // never built from the Host header
            var items = store.Latest(20).Select(p =>
            {
                var date = new DateTimeOffset(DateTime.SpecifyKind(p.PublishedOn, DateTimeKind.Utc));
                return new SyndicationItem(p.Title, p.Summary, new Uri(site, $"blog/{p.Slug}"), p.Slug, date)
                {
                    PublishDate = date   // RSS pubDate comes from PublishDate, not LastUpdatedTime
                };
            });

            var feed = new SyndicationFeed(options.Value.Title, "Articles on C# and .NET", site, items);

            using var buffer = new MemoryStream();
            using (var writer = XmlWriter.Create(buffer, new XmlWriterSettings { Encoding = new UTF8Encoding(false) }))
                new Rss20FeedFormatter(feed).WriteTo(writer);   // writer flushes on dispose

            return TypedResults.Bytes(buffer.ToArray(), "application/rss+xml; charset=utf-8");
        }).CacheOutput(p => p.Tag("posts"));

        return app;
    }
}
Costruire gli URL assoluti da BlogOptions.SiteUrl anziché da HttpContext.Request.Host chiude una vulnerabilità di host header injection: senza questa precauzione, una singola richiesta con un valore Host contraffatto verrebbe messa in cache e servita a tutti gli iscritti con link verso un altro dominio. L'argomento UTF8Encoding(false) elimina il byte order mark, che alcuni lettori di feed rifiutano.
Pubblicare il blog tecnico C# e i limiti di Native AOT
dotnet publish -c Release produce una build framework-dependent che gira su qualsiasi host con il runtime .NET 10. Da .NET 8 l'SDK crea anche immagini container senza Dockerfile: dotnet publish -c Release /t:PublishContainer genera un'immagine basata sull'immagine runtime ufficiale di ASP.NET Core. La cartella posts può essere inclusa nell'immagine (ogni modifica ai contenuti richiede un nuovo deploy) oppure montata come volume (le modifiche vengono rilevate dal file watcher).
Native AOT è allettante per tempi di avvio e consumo di memoria, ma questo progetto non è un buon candidato. La tabella di compatibilità di Native AOT per ASP.NET Core indica le Minimal APIs come parzialmente supportate e Blazor Server come non supportato, e il deserializzatore predefinito di YamlDotNet si basa sulla reflection. Un blog serve pagine in cache da un processo di lunga durata, quindi il tempo di avvio conta poco. Passare ad AOT significherebbe sostituire i componenti Razor con template di stringhe e lo YAML con un front matter JSON gestito da source generator, per un guadagno modesto.
Le domande da colloquio .NET che questo progetto prepara
Ogni parte del motore corrisponde a una domanda ricorrente nei colloqui su ASP.NET Core. Le domande di colloquio .NET su SharpSkill le trattano in profondità, e il modulo sulle Minimal APIs si concentra sul lato degli endpoint.
«Un servizio singleton è sicuro se molte richieste lo leggono contemporaneamente?» Solo se il suo stato è immutabile o sincronizzato. Lo store descritto sopra usa un'istantanea immutabile e uno scambio di riferimento volatile: i lettori non acquisiscono lock e chi scrive non blocca chi legge. La trappola classica è un singleton che contiene una List<T> modificata durante il ricaricamento, che sotto carico lancia InvalidOperationException a metà enumerazione. Il modulo sulla dependency injection affronta anche il problema della captive dependency: un singleton che riceve un servizio scoped, come un DbContext, lo mantiene in vita per tutta la durata dell'applicazione.
«Qual è la differenza tra output caching e response caching?» L'output caching è controllato dal server, supporta tag e invalidazione e ignora gli header di cache del client. Il response caching segue la semantica HTTP ed è soprattutto un'indicazione per proxy e browser.
«Perché restituire TypedResults invece di Results?» I tipi di risultato concreti offrono la verifica in compilazione degli esiti possibili, metadati OpenAPI automatici e handler testabili come semplici metodi. Il confronto approfondito con i controller si trova nell'articolo su architettura e prestazioni delle Minimal APIs.
«Dove conta l'ordine dei middleware in questa applicazione?» UseOutputCache va registrato prima degli endpoint che mette in cache, e dopo UseCors quando CORS è attivo. Un candidato capace di spiegare anche perché la policy predefinita non mette mai in cache le richieste autenticate, e cosa deve verificare una IOutputCachePolicy personalizzata prima di farlo, dimostra di comprendere la pipeline invece di ripetere un ordine imparato a memoria.
Costruire un blog C# con ASP.NET Core: i punti chiave
- Partire da
dotnet new websu .NET 10 e aggiungere solo Markdig, YamlDotNet eSystem.ServiceModel.Syndication: un blog tecnico non richiede CMS né database. - Analizzare gli articoli una sola volta in un
FrozenDictionaryimmutabile e sostituire l'intera istantanea a ogni ricaricamento, così i lettori non usano lock e un file difettoso non svuota mai il sito. - Renderizzare l'HTML con
RazorComponentResult<T>dagli handler Minimal API e dichiarare tipi di ritornoResults<T1, T2>, così OpenAPI e test unitari conoscono ogni esito. - Mettere tutti gli endpoint di contenuto dietro l'output caching con un tag condiviso e chiamare
EvictByTagAsyncdopo ogni ricaricamento, invece di affidarsi a scadenze brevi. - Costruire URL canonici e del feed dalla configurazione, mai dall'header
Host, e attivareDisableHtml()su ogni pipeline che renderizza Markdown proveniente dagli utenti. - Impostare
DOTNET_USE_POLLING_FILE_WATCHER=truequando la cartella degli articoli è montata in un container. - Usare il progetto come allenamento per i colloqui: saper spiegare a voce la thread safety del singleton, la scelta della cache e l'ordine dei middleware.
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Sapresti trovare il bug in .NET?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.
Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 17 novembre 2026
Tag
Condividi
Articoli correlati
.NET 10 nel 2026: Nuove Funzionalita, Native AOT e C# 14 per la Preparazione ai Colloqui
.NET 10 viene rilasciato come versione Long-Term Support con miglioramenti Native AOT, extension members di C# 14, la keyword field e app basate su file. Una guida completa sulle nuove funzionalita, i guadagni prestazionali e le conoscenze pronte per i colloqui per sviluppatori .NET nel 2026.
Ciclo di vita del DbContext in ASP.NET Core: Performance vs Thread Safety nelle Operazioni Async
Gestione ottimale del ciclo di vita del DbContext in ASP.NET Core: Scoped vs Transient, thread safety nelle operazioni async e ottimizzazione delle performance con DbContext pooling.
Clean Code Architecture C#: Guida Completa e Domande per Colloqui 2026
Guida completa alla Clean Code Architecture in C# con principi SOLID, architettura a strati e le domande più frequenti nei colloqui tecnici per sviluppatori .NET.