Domande Colloquio Django: ORM, Middleware e DRF in Profondità
Domande colloquio Django su ottimizzazione ORM con FETCH_PEERS, architettura middleware e performance serializer DRF. Esempi di codice con Django 6.1.
Le domande colloquio Django si concentrano su tre pilastri fondamentali che distinguono i candidati senior dagli altri: la padronanza dell'ORM, l'architettura middleware e i design pattern di Django REST Framework (DRF). Questa guida analizza le domande esatte che i responsabili delle assunzioni pongono nel 2026, con esempi di codice pronti per la produzione utilizzando Django 6.1 e DRF 3.18.
I colloqui Django raramente si soffermano sulle operazioni CRUD di base. L'attenzione si è spostata sull'ottimizzazione dei QuerySet (select_related vs prefetch_related, la nuova modalità FETCH_PEERS), sulla progettazione di middleware personalizzati e sulle performance dei serializer DRF. I candidati in grado di spiegare le query N+1 e scrivere viewset efficienti superano costantemente chi conosce solo le generic view.
Domande Colloquio Django ORM: Ottimizzazione dei QuerySet
La domanda più frequente sui colloqui Django ORM riguarda il problema N+1. Dato un modello con relazioni foreign key, i candidati devono dimostrare quando utilizzare select_related rispetto a prefetch_related.
# models.py
from django.db import models

class Company(models.Model):
    name = models.CharField(max_length=200)
    founded_year = models.IntegerField()

class Developer(models.Model):
    name = models.CharField(max_length=200)
    company = models.ForeignKey(Company, on_delete=models.CASCADE, related_name="developers")
    skills = models.ManyToManyField("Skill", related_name="developers")

class Skill(models.Model):
    name = models.CharField(max_length=100)
    category = models.CharField(max_length=50)
La distinzione tra i due metodi si basa sul tipo di relazione attraversata.
# queries.py — Correct approach for ForeignKey (single object)
developers = Developer.objects.select_related("company").all()
# Generates ONE SQL query with JOIN
# SELECT developer.*, company.* FROM developer INNER JOIN company ...

# Correct approach for ManyToMany (multiple objects)
developers = Developer.objects.prefetch_related("skills").all()
# Generates TWO SQL queries:
# 1. SELECT * FROM developer
# 2. SELECT * FROM skill INNER JOIN developer_skills WHERE developer_id IN (...)
select_related esegue un JOIN SQL e funziona con ForeignKey e OneToOneField. prefetch_related esegue una query separata e funziona con ManyToManyField e relazioni ForeignKey inverse. Confonderli causa JOIN non necessari su dataset di grandi dimensioni o il temuto pattern N+1.
Django 6.1: Modalità FETCH_PEERS per la Prevenzione Automatica N+1
Django 6.1 introduce un nuovo sistema di fetch mode che affronta le query N+1 a livello ORM. Quando si itera su un queryset e si accede a un campo correlato, FETCH_PEERS carica quel campo per tutte le istanze nel queryset con una singola query aggiuntiva.
# views.py — Django 6.1 FETCH_PEERS mode
from django.db import models
from .models import Book

# Traditional approach: requires explicit prefetch_related
books = Book.objects.prefetch_related("author").all()

# Django 6.1 approach: automatic peer fetching
books = Book.objects.fetch_mode(models.FETCH_PEERS)
for book in books:
    print(book.author.name)  # Only 2 queries total: books + all authors
Sono disponibili tre modalità di fetch:
FETCH_ONE(predefinita): Carica il campo mancante solo per l'istanza correnteFETCH_PEERS: Carica il campo per tutte le istanze dallo stesso QuerySetFETCH_RAISE: SollevaFieldFetchBlockedper codice critico dove il lazy loading deve essere impedito
Ai fini del colloquio, i candidati dovrebbero conoscere entrambi gli approcci: select_related/prefetch_related espliciti per un controllo dettagliato e FETCH_PEERS per l'ottimizzazione automatica quando si itera sui queryset.
ORM Avanzato: Manager Personalizzati e Concatenamento QuerySet
I selezionatori spesso chiedono ai candidati di scrivere un manager personalizzato che incapsuli la logica di business. L'obiettivo è verificare che il candidato comprenda il pattern del manager Django e sappia scrivere interfacce di query riutilizzabili.
# managers.py
from django.db import models
from django.utils import timezone

class ActiveDeveloperQuerySet(models.QuerySet):
    def active(self):
        """Filter developers who logged in within the last 30 days."""
        cutoff = timezone.now() - timezone.timedelta(days=30)
        return self.filter(last_login__gte=cutoff)

    def senior(self):
        """Filter developers with 5+ years of experience."""
        return self.filter(years_experience__gte=5)

    def by_skill(self, skill_name):
        """Filter developers by a specific skill."""
        return self.filter(skills__name=skill_name)

class ActiveDeveloperManager(models.Manager):
    def get_queryset(self):
        return ActiveDeveloperQuerySet(self.model, using=self._db)

    def active(self):
        return self.get_queryset().active()
La domanda di follow-up chiave: "Perché usare un QuerySet personalizzato invece di un semplice Manager?" La risposta è il concatenamento. I metodi dei QuerySet personalizzati possono essere concatenati tra loro, mentre i metodi del Manager non possono essere concatenati dopo la prima chiamata.
# usage.py — QuerySet chaining in action
# This works because each method returns a QuerySet
senior_python_devs = (
    Developer.active_objects  # custom manager
    .active()                 # ActiveDeveloperQuerySet method
    .senior()                 # chains another QuerySet method
    .by_skill("Python")       # chains a third method
    .select_related("company")  # standard QuerySet method still works
)
Django 6.0 ha introdotto CompositePrimaryKey per modelli che necessitano di chiavi primarie multi-colonna, più un framework integrato per i background task. Le domande su queste funzionalità stanno diventando più comuni, specialmente per candidati che lavorano con database legacy o requisiti di elaborazione asincrona.
Domande Colloquio Django Middleware: Pipeline Request-Response
Le domande sulla middleware testano la comprensione del candidato del ciclo di vita request-response di Django. La domanda standard: "Spiegare l'ordine in cui la middleware elabora una richiesta e una risposta."
La risposta segue uno schema rigoroso. Durante una richiesta, le classi middleware vengono eseguite dall'alto verso il basso come definito in MIDDLEWARE. Durante una risposta, vengono eseguite dal basso verso l'alto. Questa architettura a strati a cipolla significa che la prima middleware nella lista avvolge tutto.
# middleware.py
import time
import logging
from django.http import JsonResponse

logger = logging.getLogger(__name__)

class RequestTimingMiddleware:
    """Logs the time taken to process each request."""

    def __init__(self, get_response):
        self.get_response = get_response  # next middleware or view

    def __call__(self, request):
        start_time = time.monotonic()

        response = self.get_response(request)  # passes to next layer

        duration_ms = (time.monotonic() - start_time) * 1000
        logger.info(
            "method=%s path=%s status=%d duration=%.2fms",
            request.method,
            request.path,
            response.status_code,
            duration_ms,
        )
        return response
Una domanda di follow-up comune: "Come cortocircuitare la catena middleware?" Restituire una HttpResponse da __call__ prima di chiamare self.get_response(request) interrompe completamente la catena. Le middleware rimanenti e la view non vengono mai eseguite.
# middleware.py — Rate limiting with short-circuit
from django.core.cache import cache

class RateLimitMiddleware:
    """Blocks requests exceeding 100 per minute per IP."""

    def __init__(self, get_response):
        self.get_response = get_response

    def __call__(self, request):
        ip = request.META.get("REMOTE_ADDR")
        cache_key = f"rate_limit:{ip}"
        request_count = cache.get(cache_key, 0)

        if request_count >= 100:
            return JsonResponse(  # short-circuits — view never executes
                {"error": "Rate limit exceeded. Try again in 60 seconds."},
                status=429,
            )

        cache.set(cache_key, request_count + 1, timeout=60)
        return self.get_response(request)
Hook del Middleware: process_view, process_exception e process_template_response
Oltre a __call__, la middleware Django supporta tre metodi hook opzionali. I selezionatori li usano per valutare la profondità delle conoscenze.
# middleware.py — Full middleware with all hooks
class AuditMiddleware:
    def __init__(self, get_response):
        self.get_response = get_response

    def __call__(self, request):
        return self.get_response(request)

    def process_view(self, request, view_func, view_args, view_kwargs):
        """Called after URL resolution, before the view executes."""
        logger.info("Calling view: %s", view_func.__name__)
        return None  # returning None continues normal processing

    def process_exception(self, request, exception):
        """Called only if the view raises an exception."""
        logger.error("View exception: %s", exception, exc_info=True)
        return None  # returning None lets Django's default handling proceed

    def process_template_response(self, request, response):
        """Called if the response has a render() method (TemplateResponse)."""
        response.context_data["audit_timestamp"] = time.time()
        return response  # must return a response with render()
process_view viene eseguito dopo la risoluzione dell'URL ma prima della view. Restituire None continua l'esecuzione; restituire una HttpResponse cortocircuita. process_exception viene eseguito solo per eccezioni non gestite. process_template_response viene eseguito solo per oggetti TemplateResponse, non per HttpResponse regolari.
Pronto a superare i tuoi colloqui su Django?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Domande Colloquio DRF: Performance dei Serializer
Le domande sui serializer di Django REST Framework si concentrano sulla serializzazione annidata e sulle implicazioni di performance dei diversi approcci. La domanda più frequente: "Come gestire le relazioni annidate senza causare query N+1?"
# serializers.py
from rest_framework import serializers
from .models import Developer, Company, Skill

class SkillSerializer(serializers.ModelSerializer):
    class Meta:
        model = Skill
        fields = ["name", "category"]

class CompanySerializer(serializers.ModelSerializer):
    class Meta:
        model = Company
        fields = ["name", "founded_year"]

class DeveloperSerializer(serializers.ModelSerializer):
    company = CompanySerializer(read_only=True)   # nested FK
    skills = SkillSerializer(many=True, read_only=True)  # nested M2M

    class Meta:
        model = Developer
        fields = ["id", "name", "company", "skills"]
Il serializer da solo non risolve le performance. Il ViewSet deve ottimizzare il queryset.
# views.py
from rest_framework import viewsets
from .models import Developer
from .serializers import DeveloperSerializer

class DeveloperViewSet(viewsets.ReadOnlyModelViewSet):
    serializer_class = DeveloperSerializer

    def get_queryset(self):
        return (
            Developer.objects
            .select_related("company")       # JOIN for FK
            .prefetch_related("skills")      # separate query for M2M
            .order_by("-id")
        )
Senza select_related e prefetch_related nel ViewSet, ogni sviluppatore serializzato attiva query individuali per la sua azienda e competenze. Su una lista di 50 sviluppatori, questo significa 1 + 50 + 50 = 101 query invece di 3.
DRF: Permessi Personalizzati e Autenticazione
Una domanda frequente nei colloqui DRF: "Scrivere un permesso personalizzato che limiti l'accesso in base al ruolo dell'utente e al proprietario dell'oggetto."
# permissions.py
from rest_framework.permissions import BasePermission

class IsOwnerOrAdmin(BasePermission):
    """
    Object-level permission:
    - Admin users can access any object
    - Regular users can only access objects they own
    """
    message = "Access restricted to the object owner or admin users."

    def has_object_permission(self, request, view, obj):
        if request.user.is_staff:
            return True
        # Assumes the model has an 'owner' field pointing to User
return obj.owner == request.user# views.py — Applying custom permissions
from rest_framework import viewsets, permissions
from .permissions import IsOwnerOrAdmin
class ProjectViewSet(viewsets.ModelViewSet):
permission_classes = [permissions.IsAuthenticated, IsOwnerOrAdmin]
def get_queryset(self):
# Non-admin users only see their own projects
if self.request.user.is_staff:
return Project.objects.all()
return Project.objects.filter(owner=self.request.user)
def perform_create(self, serializer):
serializer.save(owner=self.request.user) # auto-assign ownerLa sfumatura che i selezionatori cercano: has_permission viene eseguito su ogni richiesta (livello lista), mentre has_object_permission viene eseguito solo quando viene chiamato get_object() (livello dettaglio). Dimenticare di sovrascrivere get_queryset per le view lista crea una falla di sicurezza dove gli utenti possono vedere oggetti che non possiedono.
Affidarsi esclusivamente a has_object_permission senza filtrare il queryset lascia l'endpoint lista non protetto. Combinare sempre i permessi object-level con un get_queryset filtrato per applicare il controllo accessi sia sulle view lista che su quelle di dettaglio.
DRF: Pattern di Throttling e Paginazione
Throttling e paginazione sono domande di follow-up standard. I selezionatori vogliono vedere che i candidati comprendano la configurazione API production-ready.
# settings.py — Production DRF configuration
REST_FRAMEWORK = {
    "DEFAULT_THROTTLE_CLASSES": [
        "rest_framework.throttling.AnonRateThrottle",
        "rest_framework.throttling.UserRateThrottle",
    ],
    "DEFAULT_THROTTLE_RATES": {
        "anon": "20/minute",    # unauthenticated users
        "user": "200/minute",   # authenticated users
    },
    "DEFAULT_PAGINATION_CLASS": "rest_framework.pagination.CursorPagination",
    "PAGE_SIZE": 25,
}# pagination.py — Custom cursor pagination for consistent ordering
from rest_framework.pagination import CursorPagination
class CreatedAtCursorPagination(CursorPagination):
page_size = 25
ordering = "-created_at" # must be a unique, sequential field
cursor_query_param = "cursor" # ?cursor=abc123La paginazione basata su cursore supera la paginazione offset su dataset di grandi dimensioni perché non richiede il conteggio delle righe totali. Il compromesso: i client non possono saltare a pagine arbitrarie. Questa è la risposta attesa quando i selezionatori chiedono "Perché scegliere la paginazione cursor rispetto alla paginazione per numero di pagina?"
Fonti
- Django 6.1 Release Notes — Modalità fetch FETCH_PEERS per la prevenzione automatica N+1
- Django 6.0 Release Notes — CompositePrimaryKey e Background Tasks framework
- Django REST Framework Documentation — Pattern Serializer e ViewSet
Punti Chiave per la Preparazione ai Colloqui Django
- Ottimizzazione ORM: Abbinare il metodo di query al tipo di relazione.
select_relatedper ForeignKey/OneToOne,prefetch_relatedper ManyToMany e FK inverse. La modalitàFETCH_PEERSdi Django 6.1 fornisce prevenzione automatica N+1 quando si itera sui queryset. - QuerySet personalizzati: Abilitano logica di business concatenabile e riutilizzabile. I metodi del Manager personalizzato non possono essere concatenati dopo la prima chiamata, ma i metodi QuerySet sì.
- Architettura middleware: La richiesta fluisce dall'alto verso il basso, la risposta dal basso verso l'alto. Cortocircuitare restituendo una risposta prima di
get_response()è un pattern fondamentale per rate limiting, controlli auth e validazione delle richieste. - Performance serializer DRF: I serializer annidati richiedono ottimizzazione esplicita del queryset nel ViewSet. Senza
select_related/prefetch_related, la serializzazione causa query N+1 su larga scala. - Permessi DRF: Combinare
has_object_permissioncon unget_querysetfiltrato per applicare il controllo accessi sia sugli endpoint lista che dettaglio. I permessi object-level da soli lasciano le view lista non protette. - Throttling e paginazione: La paginazione cursor scala meglio dell'offset su tabelle di grandi dimensioni. Configurare i rate di throttling separatamente per utenti anonimi e autenticati.
Esercitarsi con questi pattern usando domande colloquio Django ORM e domande Django middleware su SharpSkill per acquisire sicurezza prima del colloquio reale.
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Sapresti trovare il bug in Django?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.

Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 13 settembre 2026
Tag
Condividi
Articoli correlati
Django Middleware Avanzato nel 2026: Middleware Personalizzato, Logging e Domande da Colloquio
Guida completa al Django Middleware nel 2026: ciclo request-response, classi middleware personalizzate, middleware asincrono, integrazione logging e domande tecniche frequenti nei colloqui.
Django 5.2: Custom Middleware e Gestione dei Segnali per Colloqui Tecnici
Padroneggiare middleware e segnali in Django 5.2: pipeline middleware, middleware asincrono, pre_save/post_save signals e pattern comuni nei colloqui tecnici.
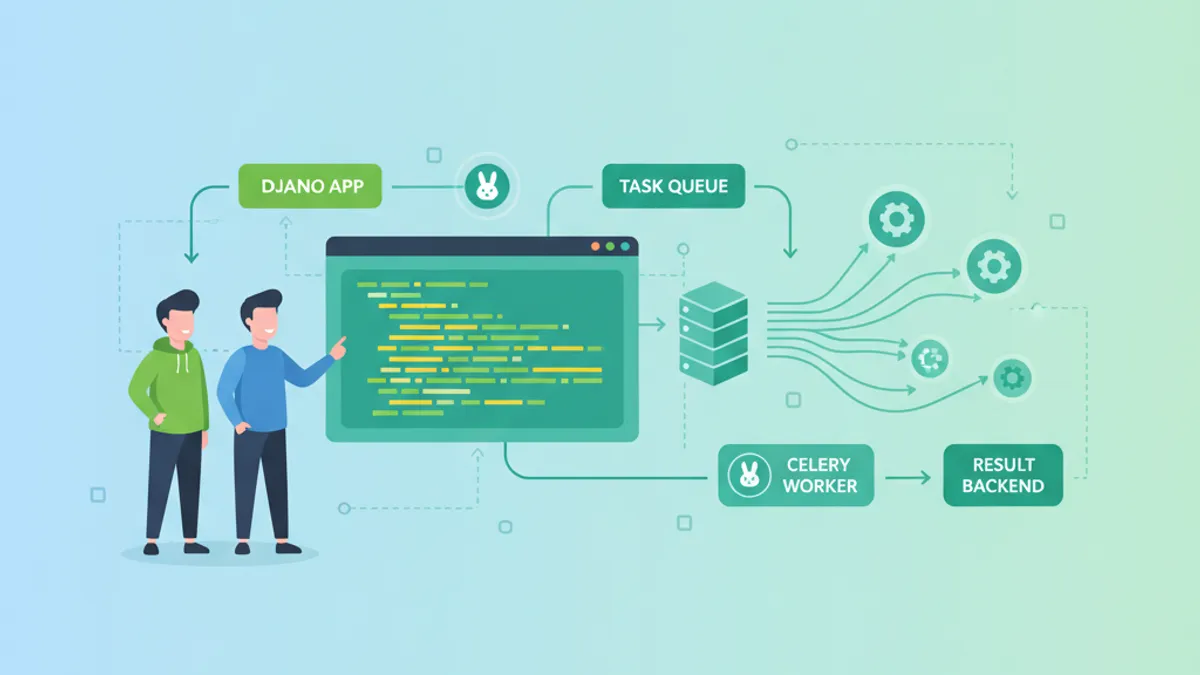
Django e Celery: Elaborazione Asincrona dei Task e Domande da Colloquio 2026
Guida completa a Django e Celery: configurazione, task asincroni, code, Celery Beat, monitoraggio e domande frequenti nei colloqui tecnici 2026.