Principi SRE nel 2026: ingegneria dell'affidabilità, SLO e domande di colloquio
I principi SRE spiegati per il 2026: come scegliere gli SLI, fissare gli SLO, calcolare l'error budget, scrivere alert di burn rate multi-finestra in Prometheus e rispondere alle domande di colloquio SRE più ricorrenti.
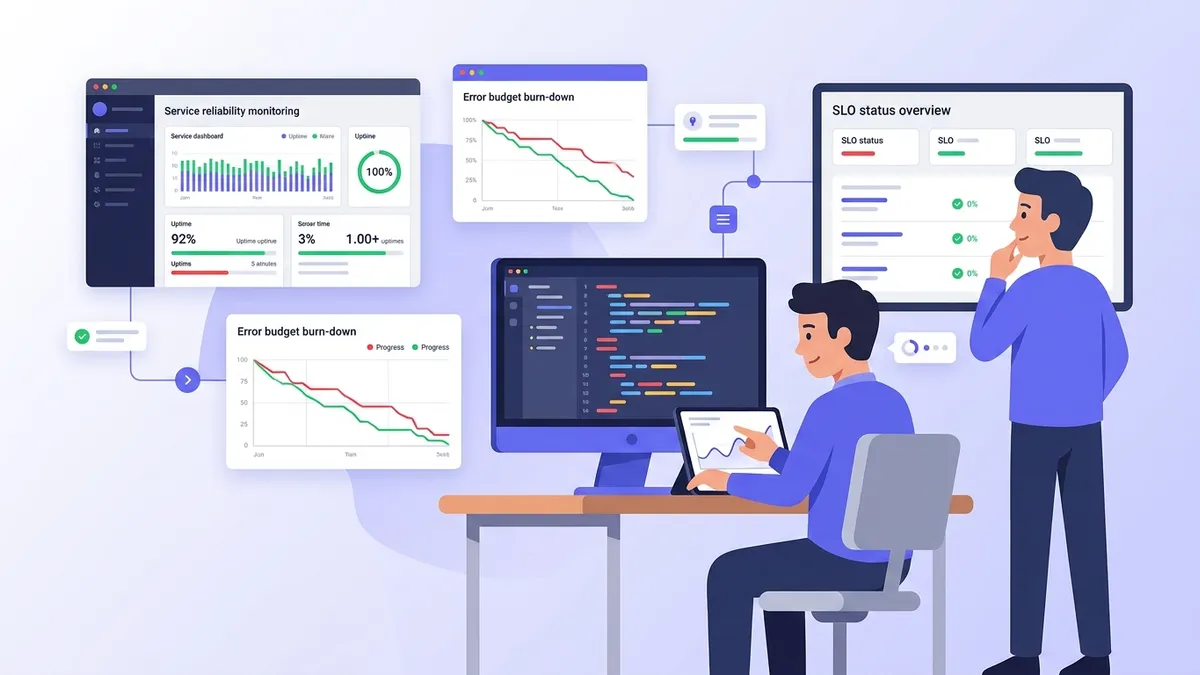
In molte aziende l'affidabilità resta un obiettivo generico: il servizio deve "funzionare sempre", finché un incidente non dimostra il contrario. I principi SRE trasformano questo obiettivo in un numero condiviso da sviluppo e prodotto, e usano quel numero per decidere quando rilasciare e quando fermarsi. La site reliability engineering, nata in Google e oggi adottata dalla maggior parte dei team di piattaforma, si fonda su poche idee: misurare ciò che l'utente percepisce davvero (SLI), fissare un obiettivo inferiore al 100% (SLO), spendere la differenza come error budget e limitare il lavoro manuale necessario a tenere in piedi i sistemi. Le domande di colloquio SRE del 2026 verificano proprio questi concetti, spesso chiedendo al candidato di definire uno SLO per un servizio reale e di scrivere l'alert che lo protegge.
Uno SLI è una misura: il rapporto tra eventi buoni ed eventi validi, ad esempio le richieste riuscite sul totale delle richieste. Uno SLO è l'obiettivo interno per quel rapporto su una finestra temporale, ad esempio il 99,9% su 30 giorni. Uno SLA è l'impegno contrattuale verso i clienti, con penali, ed è sempre meno severo dello SLO.
I principi fondamentali della site reliability engineering
Il libro SRE di Google tratta l'affidabilità come una funzionalità che ha un costo. Ogni nove in più richiede tempo di ingegneria e rallenta i rilasci, mentre gli utenti difficilmente distinguono il 99,99% dal 99,999%: la loro rete domestica, l'operatore mobile e il dispositivo sono meno affidabili di così. L'obiettivo è quindi il giusto livello di affidabilità, non il massimo possibile.
Da questa premessa derivano alcuni principi:
- L'affidabilità si misura dal lato dell'utente. L'uso della CPU e i riavvii dei pod sono cause. Un checkout fallito o una pagina lenta sono ciò che l'utente vive, ed è questo che uno SLI cattura.
- Il 100% è l'obiettivo sbagliato. Uno SLO al 100% vieta qualsiasi modifica, perché ogni deploy comporta un rischio. Lo scarto sotto il 100% è l'error budget, e va speso in rilasci, esperimenti e migrazioni.
- Il toil ha un tetto. La linea guida di Google nel capitolo sull'eliminazione del toil mantiene il lavoro operativo sotto il 50% del tempo di un SRE. Il toil è manuale, ripetitivo, automatizzabile e cresce linearmente con il servizio. Il resto del tempo va all'ingegneria che lo elimina.
- I postmortem sono blameless. L'analisi di un incidente si chiede cosa, nel sistema, abbia reso possibile il guasto, non chi abbia digitato il comando. Un ingegnere colpevolizzato nasconde informazioni; una revisione senza colpe le fa emergere.
- Il monitoraggio allerta sui sintomi. Una chiamata di reperibilità parte quando gli utenti subiscono un danno, o stanno per subirlo, non quando un singolo nodo ha un comportamento insolito.
Durante un colloquio, il punto che distingue un SRE esperto da chi ha solo letto il libro è il secondo. Una risposta junior vede l'error budget come una tolleranza al guasto. Una risposta senior lo descrive come uno strumento di gestione dei rilasci: il meccanismo che permette a prodotto e affidabilità di discutere sulla base dei dati e non delle opinioni.
Scegliere SLI che riflettano l'esperienza dell'utente
Un buon SLI è un rapporto compreso tra 0 e 1, calcolato su eventi che l'utente riconoscerebbe. Il workbook SRE propone un breve elenco in base al tipo di servizio:
| Tipo di servizio | SLI tipici | Dove misurare |
|---|---|---|
| API a richieste | Disponibilità, latenza | Log del load balancer o dell'ingress, metriche server |
| Pipeline di dati | Freschezza, correttezza, copertura | Timestamp dell'output, job di validazione |
| Sistema di storage | Durabilità, latenza di lettura e scrittura | Livello di storage, sonde sintetiche |
| Frontend | Tempo di caricamento, tasso di errori nel browser | Real user monitoring |
Misurare sul load balancer intercetta i guasti che l'applicazione non vede mai, come un pod andato in crash che non risponde affatto. Misurare nel browser rileva i problemi di CDN e DNS, ma introduce rumore dovuto alle connessioni mobili scadenti. La maggior parte dei team parte dal load balancer o dall'ingress, perché i dati sono già disponibili.
Con Prometheus, i due SLI classici di un servizio HTTP sono un rapporto di disponibilità e un rapporto di latenza. Lo SLI di latenza considera buone le richieste più veloci di una soglia: in questo modo diventa un rapporto come gli altri e non un percentile.
# checkout-sli.promql
# Availability SLI: share of requests that did not fail with a 5xx
sum(rate(http_requests_total{job="checkout-api", code!~"5.."}[5m]))
/
sum(rate(http_requests_total{job="checkout-api"}[5m]))

# Latency SLI: share of requests served in under 300 ms
# Uses the histogram bucket with le="0.3", so 0.3 must be a configured bucket boundary
sum(rate(http_request_duration_seconds_bucket{job="checkout-api", le="0.3"}[5m]))
/
sum(rate(http_request_duration_seconds_count{job="checkout-api"}[5m]))
Due dettagli tornano spesso nei colloqui. Primo, le risposte 4xx vengono di norma considerate valide e buone, perché un 404 o un errore di validazione dipendono dal client; contarle come fallimenti permetterebbe a un client mal configurato di consumare da solo il budget. Secondo, la soglia di latenza deve coincidere con un limite di bucket dell'istogramma, altrimenti la query non restituisce nulla o usa in silenzio il bucket sbagliato. Prometheus 3.16, rilasciato il 5 novembre 2026, supporta gli istogrammi nativi, che eliminano il vincolo dei bucket fissi ma vanno abilitati lato scrape.
Fissare gli obiettivi SLO e calcolare l'error budget
Uno SLO combina uno SLI, un obiettivo e una finestra temporale. La finestra è di solito mobile, 28 o 30 giorni, così il budget si ricostituisce gradualmente invece di azzerarsi il primo del mese. L'obiettivo si sceglie in base alle prestazioni storiche e alle aspettative degli utenti, non in base a ciò che fa bella figura in una slide.
La tabella seguente mostra cosa consente ciascun obiettivo su una finestra di 30 giorni. Si tratta di semplice aritmetica: il budget vale (1 - SLO) × 30 giorni.
| Obiettivo SLO | Error budget | Indisponibilità totale ammessa in 30 giorni |
|---|---|---|
| 99% | 1% | 7 h 12 min |
| 99,5% | 0,5% | 3 h 36 min |
| 99,9% | 0,1% | 43 min 12 s |
| 99,95% | 0,05% | 21 min 36 s |
| 99,99% | 0,01% | 4 min 19 s |
Per gli SLO basati sulle richieste, il budget si esprime in richieste anziché in minuti: con un 99,9% e 12 milioni di richieste nella finestra, sono ammesse 12.000 richieste fallite. Questa formulazione è più equa per i servizi con traffico irregolare, perché un'interruzione alle 3 di notte consuma meno budget della stessa interruzione nell'ora di punta.
Un esercizio frequente al colloquio consiste nel calcolare il budget residuo e la velocità con cui viene consumato. Lo script seguente rappresenta il tipo di risposta attesa quando la domanda richiede codice.
# error_budget.py
from dataclasses import dataclass

@dataclass
class SloWindow:
    objective: float      # 0.999 for a 99.9% SLO
    window_days: int      # rolling window, usually 28 or 30
    total_requests: int   # valid events seen in the window so far
    failed_requests: int  # bad events seen in the window so far

    @property
    def budget_fraction(self) -> float:
        return 1 - self.objective  # 0.001 for 99.9%

    def budget_remaining(self) -> float:
        """1.0 means untouched, 0 means spent, negative means SLO breached."""
        allowed_failures = self.budget_fraction * self.total_requests
        return 1 - self.failed_requests / allowed_failures

    def burn_rate(self, recent_errors: int, recent_total: int) -> float:
        """1.0 means the budget lasts exactly the window; 10 means ten times too fast."""
        return (recent_errors / recent_total) / self.budget_fraction

    def hours_to_exhaustion(self, burn: float) -> float:
        # Remaining share of budget, consumed at `burn` times the sustainable pace
        return self.budget_remaining() * self.window_days * 24 / burn

slo = SloWindow(objective=0.999, window_days=30, total_requests=12_000_000, failed_requests=7_800)
burn = slo.burn_rate(recent_errors=240, recent_total=16_000)
print(f"budget left: {slo.budget_remaining():.0%}")             # 35%
print(f"burn rate: {burn:.1f}")                                 # 15.0
print(f"exhausted in: {slo.hours_to_exhaustion(burn):.1f} h")   # 16.8 h
Un burn rate pari a 15 significa che il servizio fallisce l'1,5% delle richieste mentre lo SLO ne tollera lo 0,1%. A questo ritmo, il 35% di budget rimasto si esaurisce in meno di 17 ore: un motivo sufficiente per svegliare il reperibile.
Pronto a superare i tuoi colloqui su DevOps?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Alert sul burn rate con finestre multiple
Un alert costruito direttamente sullo SLI ("tasso di errore oltre lo 0,1%") genera chiamate per ogni picco breve e ignora le perdite lente. Il capitolo del workbook sugli alert basati sugli SLO raccomanda invece alert multi-finestra e multi-burn-rate. Ogni alert risponde a una sola domanda: il budget si sta consumando così in fretta da esaurirsi prima che qualcuno intervenga?
Le soglie di riferimento per una finestra di 30 giorni sono:
| Gravità | Finestra lunga | Finestra corta | Burn rate | Budget consumato allo scatto |
|---|---|---|---|---|
| Page | 1 h | 5 min | 14,4 | 2% |
| Page | 6 h | 30 min | 6 | 5% |
| Ticket | 3 giorni | 6 h | 1 | 10% |
La finestra lunga garantisce significatività: un singolo minuto negativo non fa partire la chiamata. La finestra corta, pari a un dodicesimo di quella lunga, fa rientrare rapidamente l'alert una volta risolto l'incidente, evitando che continui a scattare per un'ora dopo la correzione. Le due condizioni devono essere vere contemporaneamente.
Il primo blocco registra il rapporto di errore per ciascuna finestra, così le espressioni degli alert restano leggere. Il secondo definisce i due alert di reperibilità per uno SLO al 99,9%, dove la frazione di budget vale 0,001.
# checkout-slo-recording.rules.yml
groups:
  - name: checkout-slo-recording
    interval: 30s
    rules:
      - record: slo:sli_error:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[5m]))
          / sum(rate(http_requests_total{job="checkout-api"}[5m]))
      - record: slo:sli_error:ratio_rate1h
        expr: |
          sum(rate(http_requests_total{job="checkout-api", code=~"5.."}[1h]))
          / sum(rate(http_requests_total{job="checkout-api"}[1h]))
# Same pattern for 30m and 6h, omitted for brevity# checkout-slo-alerts.rules.yml
groups:
- name: checkout-slo-alerts
rules:
- alert: CheckoutErrorBudgetFastBurn
# 2% of the monthly budget spent in one hour
expr: |
slo:sli_error:ratio_rate1h > (14.4 * 0.001)
and slo:sli_error:ratio_rate5m > (14.4 * 0.001)
labels:
severity: page
annotations:
summary: "checkout-api burns its error budget 14x too fast"
- alert: CheckoutErrorBudgetSlowBurn
# 5% of the monthly budget spent in six hours
expr: |
slo:sli_error:ratio_rate6h > (6 * 0.001)
and slo:sli_error:ratio_rate30m > (6 * 0.001)
labels:
severity: pageScrivere queste regole a mano per ogni servizio diventa presto ripetitivo. Sloth, un generatore open source di SLO, parte da una specifica sintetica e produce le recording rule e gli alert multi-burn-rate visti sopra. Il segnaposto {{.window}} viene sostituito da ciascuna finestra di cui Sloth ha bisogno.
# checkout-slo.sloth.yml
version: "prometheus/v1"
service: "checkout-api"
labels:
  owner: "payments-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "Checkout requests that do not fail with a 5xx"
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="checkout-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="checkout-api"}[{{.window}}]))
    alerting:
      name: CheckoutHighErrorRate
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
I team che preferiscono un formato indipendente dal fornitore si orientano sulla specifica OpenSLO, che descrive gli SLO in YAML a prescindere dal backend di monitoraggio.
Error budget policy e decisioni di rilascio
Un error budget senza una policy è una dashboard che nessuno usa per agire. La policy di esempio del workbook SRE stabilisce cosa accade quando il budget è esaurito, e chi lo ha approvato in anticipo.
Una policy tipica contiene:
- Il fattore scatenante. Il servizio ha superato il proprio error budget sulla finestra mobile.
- La conseguenza. I rilasci di nuove funzionalità si fermano, salvo correzioni di sicurezza e modifiche che migliorano l'affidabilità, finché il servizio non rientra nel suo SLO.
- Il percorso di eccezione. Un singolo incidente causato da una dipendenza fuori dal controllo del team può essere escluso, documentando la decisione.
- L'escalation. I disaccordi vengono risolti da un ruolo designato, come il CTO, e non da chi alza di più la voce.
La policy viene firmata da prodotto e ingegneria prima della prima violazione, ed è proprio questo il suo valore: il blocco dei rilasci diventa una regola concordata in anticipo invece di uno scontro nel mezzo di un incidente. Gli intervistatori chiedono spesso cosa fare se il budget resta costantemente intatto. La risposta attesa è che lo SLO potrebbe essere troppo permissivo, oppure il team rilascia con eccessiva prudenza, e che il budget andrebbe speso in rilasci più frequenti o in migrazioni più ambiziose.
Far coincidere lo SLO interno con lo SLA verso il cliente non lascia alcun margine: la prima violazione dello SLO è già una penale contrattuale. Lo SLO deve essere più severo dello SLA, in modo che gli alert scattino e il blocco dei rilasci parta quando il contratto è ancora rispettato.
Riduzione del toil, reperibilità e postmortem senza colpe
Il tempo di un SRE si divide tra operatività e ingegneria. L'operatività comprende reperibilità, ticket e interventi manuali; l'ingegneria comprende automazione, capacity planning e funzionalità di affidabilità. Quando il toil supera la soglia del 50%, il team SRE restituisce lavoro al team di sviluppo o investe in automazione, altrimenti diventa un team operativo con un nome nuovo.
La salute della reperibilità si misura, non si presume. Gli indicatori utili sono il numero di chiamate per turno, la quota di chiamate che hanno richiesto un'azione e il tempo di presa in carico. Una chiamata che non richiede alcuna azione è un difetto dell'alerting e va corretta o eliminata. Gli alert basati sui sintomi e sul consumo dello SLO, come nelle regole precedenti, riducono il volume delle chiamate rispetto agli alert su CPU, memoria o riavvii dei singoli pod.
Dopo un incidente, il capitolo sulla cultura del postmortem del libro SRE descrive la revisione da condurre. Un postmortem registra l'impatto in termini di SLO (quanto budget è stato consumato), la cronologia, i fattori contributivi e le azioni correttive con responsabili e scadenze. Non indica mai una persona come causa. Due domande di approfondimento sono frequenti: come garantire che le azioni vengano davvero completate (tracciarle nello stesso backlog delle funzionalità e rivederle in una riunione periodica) e quando un postmortem è obbligatorio (ogni incidente che ha consumato una quota significativa di budget, ogni chiamata notturna, ogni perdita di dati).
I quattro golden signal del libro SRE, ovvero latenza, traffico, errori e saturazione, completano il quadro del monitoraggio. Latenza ed errori diventano di solito SLI. Traffico e saturazione alimentano il capacity planning e le dashboard più che le chiamate di reperibilità.
Domande di colloquio SRE con le risposte attese
Queste sono le domande che ricorrono nei colloqui per ruoli SRE e DevOps senior, con il nucleo di una risposta solida. Il modulo di colloquio sui principi SRE approfondisce gli stessi temi, mentre il modulo su alerting e incident response copre la parte di reperibilità.
D: Qual è la differenza tra SLI, SLO e SLA?
Lo SLI è il rapporto misurato, lo SLO è l'obiettivo interno su una finestra, lo SLA è il contratto esterno con penali. Lo SLO è più severo dello SLA, così il team reagisce prima di perdere denaro.
D: Perché non fissare lo SLO al 100%?
Perché ogni modifica comporta un rischio, quindi un obiettivo al 100% vieta i rilasci. Inoltre gli utenti non percepiscono un'affidabilità superiore a quella della propria rete. Lo scarto sotto il 100% è l'error budget, che finanzia i rilasci.
D: Definire uno SLO per un'API di checkout.
Una risposta solida sceglie due SLI (disponibilità escludendo i 4xx, latenza sotto una soglia misurata sul load balancer), una finestra mobile di 30 giorni, obiettivi basati sui dati dell'ultimo trimestre, e spiega come ne derivano gli alert e la error budget policy. Citare soltanto "99,99% di uptime" senza dire cosa si misura è la classica risposta debole.
D: Perché gli alert sulla latenza p99 sono un cattivo alert di SLO?
Un p99 calcolato su una finestra breve è rumoroso e non si può aggregare tra istanze. Esprimere la latenza come quota di richieste sotto una soglia la rende additiva, confrontabile con lo SLI di disponibilità e compatibile con gli alert di burn rate.
D: Cos'è il burn rate e perché gli alert usano due finestre?
Il burn rate è il tasso di errore osservato diviso per la frazione di budget; un valore pari a 1 significa che il budget dura esattamente quanto la finestra. La finestra lunga filtra i picchi brevi, quella corta fa rientrare rapidamente l'alert dopo il ripristino.
D: Cos'è il toil e come lo si tiene sotto controllo?
Lavoro manuale, ripetitivo, automatizzabile, privo di valore duraturo e che cresce insieme al servizio. Lo si misura, gli si impone un tetto (Google usa il 50%) e lo si riduce con l'automazione o restituendo il lavoro al team proprietario.
D: Cosa rende un postmortem blameless?
Si concentra sulle condizioni del sistema che hanno permesso il guasto, presume che le persone abbiano agito in modo ragionevole con le informazioni disponibili e produce azioni tracciate. La prova del nove: l'ingegnere coinvolto condividerebbe ogni dettaglio senza timore?
Nello stesso colloquio, alle domande sugli SLO seguono spesso quelle sul monitoraggio. La guida alle domande di colloquio su Prometheus tratta PromQL, tipi di metriche e cardinalità, e la pagina della tecnologia DevOps elenca tutti i moduli per una preparazione più ampia.
SLO ed error budget nella pratica: cosa ricordare
- Definire ogni SLI come rapporto tra eventi buoni ed eventi validi, misurato il più vicino possibile all'utente, escludendo i 4xx dai fallimenti per la maggior parte delle API
- Scegliere lo SLO sulla base dei dati storici e di una finestra mobile di 28 o 30 giorni, mantenendolo più severo di qualsiasi SLA verso i clienti
- Convertire l'obiettivo in un budget di minuti o di richieste e conoscere i numeri a memoria: il 99,9% su 30 giorni corrisponde a 43 minuti
- Allertare sul burn rate con finestre accoppiate (14,4 su 1 h e 5 min, 6 su 6 h e 30 min), non sul tasso di errore grezzo o sulla CPU
- Generare le regole con Sloth o uno strumento simile non appena più di un paio di servizi hanno degli SLO, per mantenere coerenti le soglie
- Scrivere e firmare la error budget policy prima della prima violazione, includendo la regola di blocco dei rilasci e il percorso di escalation
- Tracciare toil, volume delle chiamate e azioni dei postmortem con lo stesso rigore riservato alle funzionalità
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Sapresti trovare il bug in DevOps?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.

Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 7 novembre 2026
Tag
Condividi
Articoli correlati

Domande di colloquio su Prometheus 2026: Prometheus vs Grafana vs Datadog a confronto
Domande di colloquio su Prometheus per ruoli DevOps e SRE, con risposte su PromQL, tipi di metrica, cardinalità e HA, più un confronto Prometheus vs Grafana vs Datadog su architettura, alerting e prezzi.
Ansible vs Terraform 2026: Infrastructure as Code e Domande per Colloqui DevOps
Confronto completo tra Ansible e Terraform per colloqui DevOps. Gestione dello state, approcci dichiarativi vs procedurali e best practice per Infrastructure as Code.
Domande sui colloqui Terraform: Guida completa all'Infrastructure as Code 2026
Guida completa alle domande sui colloqui Terraform con gestione dello state, progettazione di moduli, pipeline CI/CD e concetti avanzati di IaC per il 2026.