Excel Power Query nel 2026: ETL per Data Analyst e Domande di Colloquio
Guida completa a Excel Power Query per workflow ETL, linguaggio M e domande frequenti nei colloqui per data analyst.
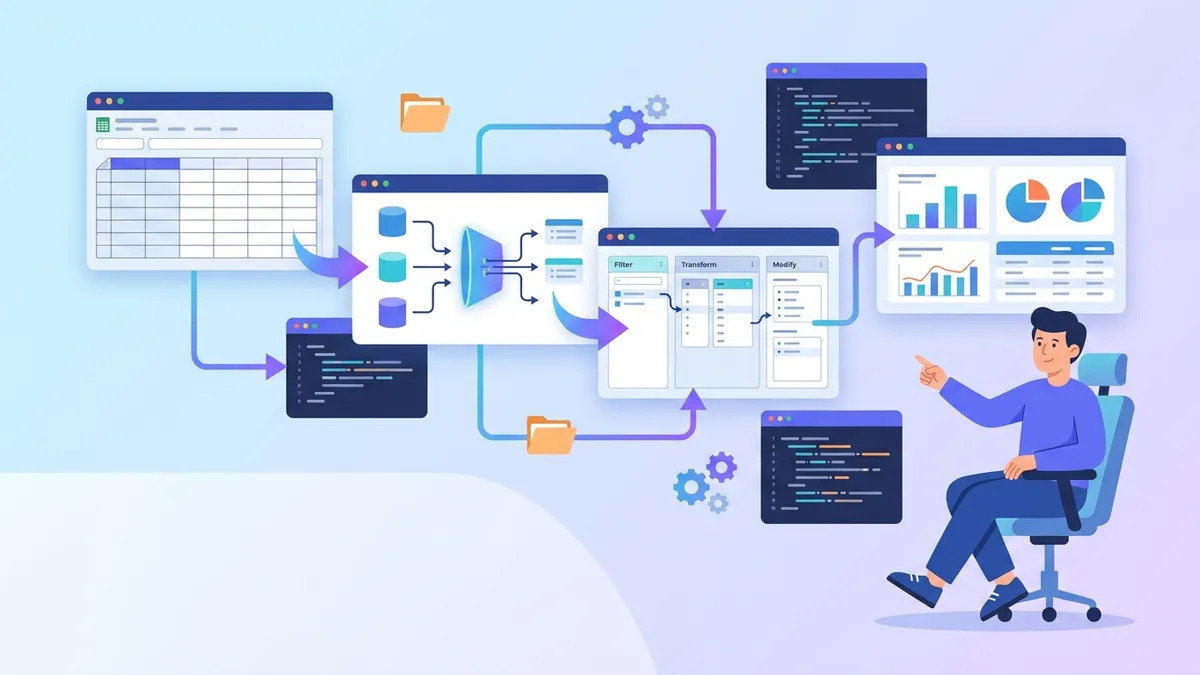
Excel Power Query trasforma il modo in cui i data analyst gestiscono i workflow ETL (Extract, Transform, Load) direttamente in Excel. A differenza del copia-incolla manuale o delle macro VBA complesse, Power Query fornisce un'interfaccia visuale supportata dal linguaggio M, consentendo trasformazioni dei dati ripetibili che si aggiornano con un solo clic.
Power Query è integrato in Excel 365, Excel 2021, Excel 2019 ed Excel 2016. Nelle versioni precedenti era disponibile come add-in gratuito chiamato "Power Query per Excel". Lo stesso motore alimenta i dataflow di Power BI Desktop.
Quali problemi risolve Power Query per i data analyst
I data analyst dedicano tempo significativo alla preparazione dei dati: unire file da fonti diverse, pulire formati inconsistenti, filtrare righe irrilevanti e rimodellare tabelle per l'analisi. Power Query affronta questi compiti attraverso un editor di query che registra ogni passaggio di trasformazione. Quando i dati di origine cambiano, l'intera pipeline viene rieseguita automaticamente.
Il workflow segue tre fasi: connessione alle sorgenti dati, applicazione delle trasformazioni e caricamento dei risultati in tabelle Excel o nel modello dati. Ogni passaggio viene registrato in una barra delle formule utilizzando la sintassi del linguaggio M, che può essere modificata direttamente per scenari avanzati.
Questo approccio differisce dalle tradizionali formule Excel. Mentre le formule ricalcolano le celle, Power Query opera su intere tabelle prima che raggiungano il foglio di lavoro. Una query che consolida 50 file CSV, rimuove duplicati e de-pivota colonne viene eseguita una sola volta e produce una tabella pulita, invece di costruire formule nidificate complesse che rallentano la cartella di lavoro.
Connessione alle sorgenti dati con Recupera Dati
Power Query supporta connessioni a file (CSV, Excel, JSON, XML), database (SQL Server, MySQL, PostgreSQL, Oracle), servizi cloud (SharePoint, Azure, Salesforce) e pagine web. Il tipo di connessione determina quali opzioni di autenticazione e importazione appaiono.
// Sorgenti dati comuni in Power Query
Dati > Recupera Dati > Da File > Da CSV
Dati > Recupera Dati > Da Database > Da Database SQL Server
Dati > Recupera Dati > Da Altre Origini > Dal Web
Dati > Recupera Dati > Da Cartella (file multipli)
L'opzione "Da Cartella" è particolarmente utile per consolidare file multipli. Invece di importare ogni file separatamente, Power Query scansiona una cartella, elenca tutti i file corrispondenti e li combina in una singola query. Aggiungere un nuovo file alla cartella lo include automaticamente al prossimo aggiornamento.
Quando ci si connette a un database SQL, Power Query può trasferire la logica di trasformazione al server attraverso il query folding. Filtri e selezioni di colonne vengono tradotti in clausole SQL WHERE e SELECT, riducendo i dati trasferiti a Excel. La barra delle formule mostra un'opzione "Visualizza Query Nativa" quando il folding è attivo.
Trasformazioni principali nell'Editor di Query
L'Editor di Query fornisce comandi ribbon per operazioni comuni, ma comprendere il codice M sottostante aiuta quando sono necessarie personalizzazioni. Ogni trasformazione aggiunge un passaggio al pannello "Passaggi Applicati", creando una sequenza verificabile.
Filtraggio e ordinamento delle righe
Il filtraggio rimuove le righe che non soddisfano i criteri. Il menu a discesa dell'intestazione di colonna fornisce filtri rapidi, mentre la finestra di dialogo "Filtra Righe" supporta condizioni complesse con logica AND/OR.
// Passaggio FilteredRows nel linguaggio M
let
    Source = Excel.CurrentWorkbook(){[Name="SalesData"]}[Content],
    FilteredRows = Table.SelectRows(Source, each [Region] = "EMEA" and [Amount] > 1000)
in
    FilteredRows
La funzione Table.SelectRows accetta una tabella e una condizione. La keyword each crea una funzione dove _ rappresenta la riga corrente, e l'accesso ai campi usa la notazione tra parentesi [Region]. Condizioni multiple si combinano con operatori and o or.
Rimozione e ridenominazione delle colonne
Le sorgenti dati spesso includono colonne non necessarie per l'analisi. Rimuoverle presto riduce l'utilizzo di memoria e semplifica i passaggi successivi.
// Rimuovere colonne, poi rinominare quelle rimanenti
let
    Source = Excel.CurrentWorkbook(){[Name="RawData"]}[Content],
    RemovedColumns = Table.RemoveColumns(Source, {"TempID", "InternalNotes", "Debug"}),
    RenamedColumns = Table.RenameColumns(RemovedColumns, {{"Cust_Name", "CustomerName"}, {"Amt", "Amount"}})
in
    RenamedColumns
L'elenco delle colonne usa parentesi graffe {} per elementi multipli. La ridenominazione richiede un elenco di coppie, dove ogni coppia contiene il vecchio nome e il nuovo nome. Convenzioni di denominazione consistenti tra query facilitano la combinazione di dataset.
Divisione e unione delle colonne
Le colonne di testo richiedono frequentemente parsing. Una colonna "FullName" potrebbe necessitare la divisione in nome e cognome, oppure colonne separate di data e ora potrebbero dover essere unite.
// Dividere FullName per delimitatore in due colonne
let
    Source = Excel.CurrentWorkbook(){[Name="Contacts"]}[Content],
    SplitColumn = Table.SplitColumn(Source, "FullName", Splitter.SplitTextByDelimiter(" ", QuoteStyle.Csv), {"FirstName", "LastName"})
in
    SplitColumn
La funzione Splitter.SplitTextByDelimiter gestisce la logica di parsing. Per pattern più complessi, Splitter.SplitTextByEachDelimiter o Splitter.SplitTextByPositions offrono controllo aggiuntivo. Quando il numero di colonne risultanti varia, Power Query crea colonne dinamicamente.
Conversioni di tipo e qualità dei dati
Power Query inferisce i tipi di colonna all'importazione, ma l'assegnazione esplicita del tipo rileva errori in anticipo. Una colonna di testo contenente ID numerici dovrebbe rimanere testo se gli zeri iniziali sono importanti. Le colonne di data importate come testo causano problemi di ordinamento.
// Assegnazioni di tipo esplicite
let
    Source = Csv.Document(File.Contents("C:\\Data\\transactions.csv")),
    TypedColumns = Table.TransformColumnTypes(Source, {
        {"TransactionID", type text},
        {"Date", type date},
        {"Amount", type number},
        {"IsProcessed", type logical}
    })
in
    TypedColumns
La keyword type specifica il tipo di destinazione. I tipi disponibili includono text, number, date, datetime, datetimezone, time, duration, logical e binary. Gli errori di tipo appaiono come valori "Error" nelle celle, rendendo visibili i problemi di qualità dei dati prima dell'analisi.
La gestione dei valori null richiede logica esplicita. La funzione Table.ReplaceValue sostituisce i null con valori predefiniti, mentre Table.SelectRows con [Column] <> null li filtra.
Raggruppamento e aggregazione con Raggruppa per
Aggregare i dati per categorie è un requisito frequente. La trasformazione "Raggruppa per" comprime le righe che condividono gli stessi valori chiave e applica funzioni aggregate.
// Raggruppare vendite per regione e anno, calcolare somma e conteggio
let
    Source = Excel.CurrentWorkbook(){[Name="Sales"]}[Content],
    Grouped = Table.Group(Source, {"Region", "Year"}, {
        {"TotalSales", each List.Sum([Amount]), type number},
        {"OrderCount", each Table.RowCount(_), Int64.Type},
        {"AvgOrderValue", each List.Average([Amount]), type number}
    })
in
    Grouped
Le colonne di raggruppamento appaiono per prime, seguite dalle definizioni di aggregazione. Ogni aggregazione specifica un nuovo nome di colonna, una funzione di aggregazione e un tipo di risultato opzionale. La keyword each rappresenta la sotto-tabella per ogni gruppo, permettendo qualsiasi funzione di tabella o lista.
Le aggregazioni nidificate consentono calcoli come "percentuale del totale di gruppo" referenziando sia il valore della riga che l'aggregato del gruppo in un passaggio successivo.
Pronto a superare i tuoi colloqui su Data Analytics?
Pratica con i nostri simulatori interattivi, flashcards e test tecnici.
Pivot e unpivot per la rimodellazione dei dati
Il pivot converte i valori delle righe in colonne, creando un layout a tabella incrociata. L'unpivot fa il contrario, convertendo le colonne in righe per strutture normalizzate.
// Unpivot delle colonne mese in righe
let
    Source = Excel.CurrentWorkbook(){[Name="MonthlySales"]}[Content],
    // Originale: Product, Jan, Feb, Mar, Apr colonne
    Unpivoted = Table.UnpivotOtherColumns(Source, {"Product"}, "Month", "Sales")
    // Risultato: Product, Month, Sales colonne
in
    Unpivoted
La funzione Table.UnpivotOtherColumns mantiene fisse le colonne specificate e de-pivota il resto. Questo è più sicuro che elencare tutte le colonne da de-pivotare, perché l'aggiunta di nuove colonne mese le include automaticamente. I due parametri finali nominano la colonna attributo ("Month") e la colonna valore ("Sales").
Il pivot usa Table.Pivot con una funzione di aggregazione per i casi in cui esistono valori multipli per la stessa combinazione riga-colonna:
// Pivot delle vendite per regione
let
    Source = Excel.CurrentWorkbook(){[Name="DetailedSales"]}[Content],
    Pivoted = Table.Pivot(Source, List.Distinct(Source[Region]), "Region", "Amount", List.Sum)
in
    Pivoted
Merge e append delle query
Combinare dati da fonti multiple è dove Power Query riduce lo sforzo manuale. Il merge esegue un join tra due tabelle basato su colonne corrispondenti. L'append impila le tabelle verticalmente.
// Left Join: Ordini con dettagli Cliente
let
    Orders = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    Customers = Excel.CurrentWorkbook(){[Name="Customers"]}[Content],
    Merged = Table.NestedJoin(Orders, {"CustomerID"}, Customers, {"ID"}, "CustomerDetails", JoinKind.LeftOuter),
    Expanded = Table.ExpandTableColumn(Merged, "CustomerDetails", {"Name", "Email"})
in
    Expanded
La funzione Table.NestedJoin crea una colonna di tabella nidificata contenente le righe corrispondenti. La funzione Table.ExpandTableColumn poi appiattisce la struttura nidificata in colonne regolari. I tipi di join includono Inner, LeftOuter, RightOuter, FullOuter, LeftAnti e RightAnti.
L'append con Table.Combine richiede nomi di colonna corrispondenti. Quando gli schemi differiscono, Table.SelectColumns su ogni sorgente prima della combinazione assicura consistenza:
// Append di due tabelle vendite con colonne consistenti
let
    Sales2024 = Table.SelectColumns(Source2024, {"Date", "Product", "Amount"}),
    Sales2025 = Table.SelectColumns(Source2025, {"Date", "Product", "Amount"}),
    Combined = Table.Combine({Sales2024, Sales2025})
in
    Combined
Colonne personalizzate e logica condizionale
La funzionalità "Aggiungi Colonna > Colonna Personalizzata" permette campi calcolati usando espressioni M. La logica condizionale usa la sintassi if-then-else.
// Aggiungere una colonna calcolata con logica condizionale
let
    Source = Excel.CurrentWorkbook(){[Name="Orders"]}[Content],
    AddedColumn = Table.AddColumn(Source, "OrderCategory", each
        if [Amount] >= 10000 then "Enterprise"
        else if [Amount] >= 1000 then "Business"
        else "Consumer",
        type text
    )
in
    AddedColumn
L'espressione if deve includere sia il ramo then che else. Le condizioni nidificate si concatenano con else if. Il parametro finale specifica il tipo di colonna, migliorando le prestazioni e prevenendo problemi di inferenza del tipo.
Per trasformazioni complesse, le funzioni helper definite nel blocco let mantengono il codice leggibile:
let
    // Funzione helper per il trimestre fiscale
    GetFiscalQuarter = (date as date) as text =>
        let
            month = Date.Month(date),
            fiscalQ = if month >= 4 and month <= 6 then "Q1"
                     else if month >= 7 and month <= 9 then "Q2"
                     else if month >= 10 and month <= 12 then "Q3"
                     else "Q4"
        in
            fiscalQ,

    Source = Excel.CurrentWorkbook(){[Name="Transactions"]}[Content],
    AddedQuarter = Table.AddColumn(Source, "FiscalQuarter", each GetFiscalQuarter([Date]), type text)
in
    AddedQuarter
Gestione degli errori in Power Query
Gli errori di trasformazione appaiono come valori "Error" nelle celle invece di far fallire l'intera query. Il costrutto try-otherwise gestisce gli errori in modo elegante:
// Gestire potenziali errori di divisione
let
    Source = Excel.CurrentWorkbook(){[Name="Metrics"]}[Content],
    AddedRatio = Table.AddColumn(Source, "Ratio", each
        try [Value1] / [Value2] otherwise null,
        type number
    )
in
    AddedRatio
La keyword try tenta l'espressione e restituisce un record con campi HasError e Value. La clausola otherwise fornisce un fallback quando HasError è true. Per maggior controllo, accedere ai dettagli dell'errore con try Expression:
// Catturare i dettagli dell'errore
let
    result = try SomeRiskyFunction(),
    output = if result[HasError] then "Error: " & result[Error][Message] else result[Value]
in
    output
Domande di colloquio su Power Query per data analyst
I selezionatori valutano sia le competenze pratiche che la comprensione di quando Power Query si adatta a un workflow. Queste domande appaiono frequentemente nei colloqui per data analyst.
Cos'è il query folding e perché è importante?
Il query folding traduce le trasformazioni Power Query in query native per la sorgente dati. Quando ci si connette a SQL Server, un passaggio di filtro diventa una clausola WHERE eseguita sul server, riducendo il trasferimento di rete. Non tutte le trasformazioni vengono foldate: funzioni M personalizzate, certe manipolazioni di date e operazioni dopo un passaggio non-folding interrompono la catena. Verificare lo stato del folding cliccando con il tasto destro su un passaggio e cercando "Visualizza Query Nativa".
Come si differenzia Power Query dalle formule Excel per la trasformazione dei dati?
Le formule Excel operano cella per cella all'interno del foglio di lavoro e ricalcolano ad ogni modifica. Power Query opera sulle tabelle prima che raggiungano il foglio di lavoro, elaborando i dati in blocco durante l'aggiornamento. Per trasformazioni come unpivot, deduplicazione o unione di file, Power Query esprime la logica più direttamente rispetto a INDEX-MATCH nidificati o colonne helper.
Quando si sceglierebbe Power Query invece di Power BI per ETL?
Power Query in Excel è adatto per scenari in cui gli analyst necessitano di dati trasformati in formato foglio di calcolo per analisi ad-hoc, tabelle pivot o condivisione con utenti che non hanno accesso a Power BI. Power BI fornisce visualizzazione più ricca, maggiore capacità dati e funzionalità di condivisione enterprise. Lo stesso codice M funziona in entrambi gli strumenti, quindi le query sviluppate in Excel possono migrare a Power BI Desktop senza riscrittura.
Come si gestiscono i conflitti di tipo dati quando si appendono tabelle?
Impostare tipi espliciti su ogni tabella sorgente prima di combinare con Table.Combine. Se una colonna è testo in una sorgente e numero in un'altra, l'append fallisce o produce errori. Usare Table.TransformColumnTypes su entrambe le sorgenti per forzare tipi consistenti. Il pattern try-otherwise gestisce i casi limite dove la conversione fallisce per valori specifici.
Spiega la differenza tra Merge e Append in Power Query.
Merge esegue un join orizzontale basato su colonne chiave corrispondenti, simile a SQL JOIN. Append esegue un'unione verticale di righe da tabelle multiple, simile a SQL UNION ALL. Merge richiede almeno una colonna comune per il matching. Append richiede colonne con gli stessi nomi per allinearsi correttamente.
Per una preparazione più approfondita sui concetti SQL che complementano le competenze Power Query, il modulo SQL window functions copre pattern di ranking e aggregazione, mentre il modulo SQL subqueries e CTEs affronta tecniche di strutturazione delle query.
Opzioni di caricamento e strategie di aggiornamento
Dopo le trasformazioni, il pulsante "Chiudi & Carica" offre scelte di caricamento: caricare in una tabella del foglio di lavoro, caricare solo nel modello dati (Power Pivot) o creare una query di sola connessione. Le query di sola connessione servono come passaggi di staging per altre query senza occupare spazio nel foglio di lavoro.
Il comportamento di aggiornamento dipende dalla destinazione di caricamento. Le tabelle del foglio di lavoro si aggiornano con il pulsante "Aggiorna Tutto" o possono essere impostate per aggiornarsi all'apertura del file. Le tabelle del modello dati partecipano al ciclo di aggiornamento del modello dati della cartella di lavoro. Per query connesse a database esterni, potrebbero apparire richieste di credenziali all'aggiornamento se non esistono credenziali salvate.
L'aggiornamento in background permette alla cartella di lavoro di rimanere utilizzabile durante il caricamento dei dati, ma crea complessità quando formule downstream dipendono dai dati aggiornati. L'opzione "Abilita aggiornamento in background" nelle proprietà della query controlla questo comportamento. Per report critici, disabilitare l'aggiornamento in background assicura l'esecuzione sequenziale.
Considerazioni sulle prestazioni per dataset di grandi dimensioni
Power Query può gestire milioni di righe, ma la reattività della cartella di lavoro dipende da come i dati vengono caricati. Caricare nel modello dati invece che nelle tabelle del foglio di lavoro evita il limite di righe di Excel e migliora le prestazioni delle tabelle pivot. Rimuovere le colonne non necessarie presto riduce l'impronta di memoria.
Per query che richiedono diversi minuti, l'"Anteprima Dati" nell'Editor di Query mostra solo un campione. Le trasformazioni si applicano al dataset completo durante l'aggiornamento. Gli errori visibili nell'anteprima indicano problemi, ma alcuni errori appaiono solo con i dati completi. Eseguire un aggiornamento di test su un sottoinsieme valida la query prima di elaborare tutto.
Quando si consolidano molti file, la funzionalità di combinazione binaria di Power Query elabora i file in parallelo. Definire una funzione che trasforma un file, poi invocarla per ogni riga nell'elenco file, fornisce più controllo rispetto all'approccio di combinazione predefinito.
La documentazione Microsoft sulle best practice di Power Query dettaglia tecniche di ottimizzazione incluse strutture di dipendenza delle query e utilizzo del buffer.
Power Query per pipeline ETL ripetibili
I passaggi registrati in Power Query creano documentazione della logica di trasformazione. Quando i requisiti cambiano, modificare un passaggio aggiorna automaticamente tutti i passaggi downstream. Questo contrasta con le manipolazioni Excel ad-hoc che richiedono di ricreare da zero quando i dati sorgente cambiano.
I team possono condividere query esportando connessioni o memorizzando il codice M delle query nel controllo versione. L'Editor Avanzato (Visualizza > Editor Avanzato) mostra lo script M completo, che può essere copiato e incollato in un'altra cartella di lavoro. Per scenari enterprise, Power BI dataflows e Fabric forniscono gestione centralizzata delle query.
- Power Query gestisce ETL all'interno di Excel usando passaggi di trasformazione registrati e ripetibili
- Il linguaggio M sottostante all'interfaccia visuale consente personalizzazioni oltre i comandi ribbon
- Il query folding trasferisce filtri e proiezioni ai database sorgente per migliori prestazioni
- Merge esegue join tra tabelle, Append impila tabelle verticalmente
- Le assegnazioni di tipo e la gestione degli errori prevengono problemi silenziosi di qualità dei dati
- Le query di sola connessione creano passaggi di staging riutilizzabili senza output nel foglio di lavoro
- Le domande di colloquio si concentrano su query folding, confronto con formule e distinzioni tra merge e append
Inizia a praticare!
Metti alla prova le tue conoscenze con i nostri simulatori di colloquio e test tecnici.
Sapresti trovare il bug in Data Analytics?
Uno snippet reale, un bug nascosto, un tentativo al giorno. Senza account per provare.
Scritto da
Anthony Fillion-MailletFondatore di SharpSkill
Sviluppatore fullstack da oltre 10 anni. Guida SharpSkill e risponde di tutto ciò che vi viene pubblicato.
Aggiornato il 20 settembre 2026
Condividi
Articoli correlati
Domande Colloquio Data Analyst 2026: Guida Completa SQL, Python e Analytics
Le domande più frequenti nei colloqui per Data Analyst nel 2026 con SQL window functions, esercizi Python Pandas e casi aziendali pratici per prepararsi al meglio.
Domande Colloquio Data Analyst Italia 2026: SQL Avanzato, Python e Case Study
Guida completa per prepararsi ai colloqui da Data Analyst in Italia nel 2026. SQL Window Functions, Python Pandas con formati italiani e case study delle aziende milanesi.
Polars vs Pandas 2026: Performance, Sintassi e Domande da Colloquio per Data Analyst
Un confronto completo tra Polars e Pandas nel 2026. Risultati dei benchmark, differenze di sintassi e domande tipiche nei colloqui per Data Analyst e Data Engineer.